

在 Langflow 工作流中同步网页数据
安装 Firecrawl 组件包
Firecrawl 封禁随lfx-firecrawl 组件包提供,而 Langflow 默认安装并不包含该组件包。请将其安装到 Langflow 所在的环境中,然后重启 Langflow:
Data 形式返回。如需了解全部参数,请参见 Langflow Firecrawl 组件包文档。
使用 Firecrawl 封禁进行抓取
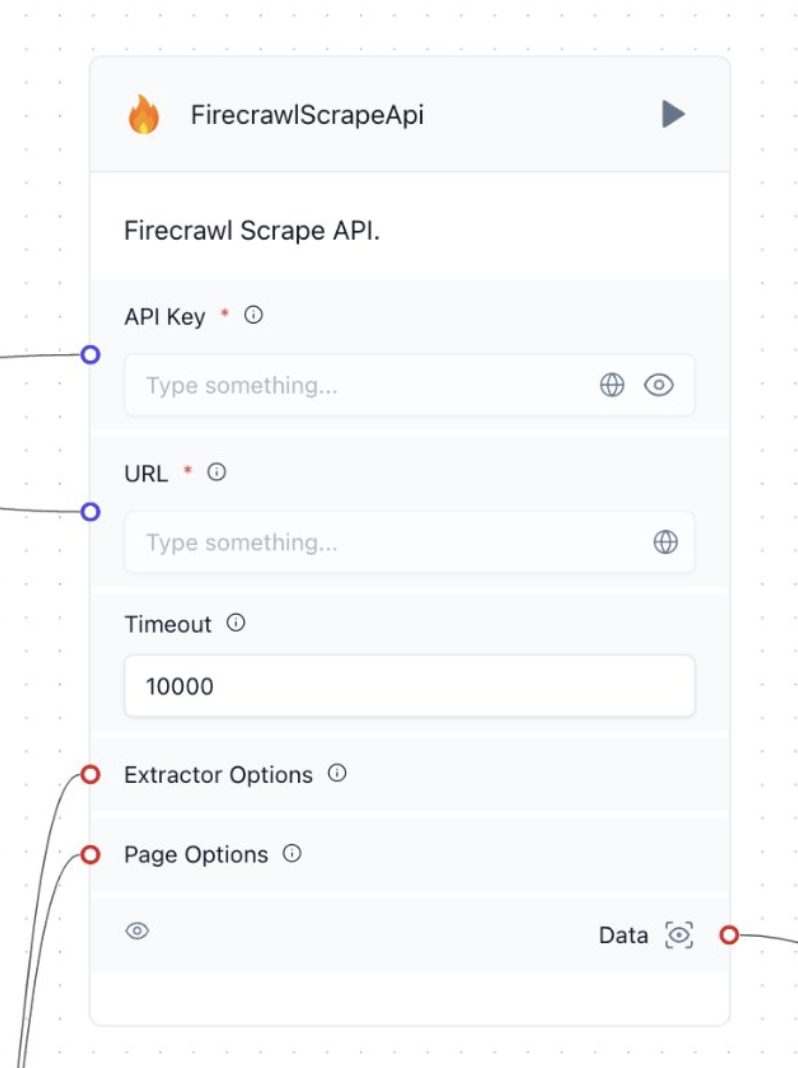
- 登录你的 Firecrawl 账户获取 API Key,然后在封禁中填写,或从工作流的其他环节传入。
- 添加 Firecrawl Scrape API 封禁,用于采集单个页面。
- 输入要抓取的目标 URL,或从工作流的其他环节传入。
- 根据目标网站和所需数据设置抓取选项,例如输出格式以及是否仅返回主要内容。你也可以从工作流的其他环节传入这些选项。
- (可选) 设置 提取器选项,从页面中获取结构化 JSON。
- 在你的工作流中使用这些数据。
爬取、映射与搜索
- Firecrawl Crawl API 会爬取指定 URL 及其子页面。可在 Crawler Options (爬取选项) 中设置数量限制和路径,并在 Scrape Options (抓取选项) 中配置 per-page 设置。
- Firecrawl Map API 返回一个或多个站点的 URL 列表。
- Firecrawl Search API 根据 query 在网页上进行搜索,可选设置结果数量上限 Limit 和 Location (位置) 。