

Introduction à Firecrawl et n8n
Firecrawl est l’API de contexte pour les agents IA, et le nœud Firecrawl intègre Search, Scrape, Crawl, Map, Interact et Agent à vos workflows n8n. Surveillez des prix, agrégez du contenu, générez des prospects ou fournissez un contexte propre à vos agents IA, le tout sans écrire de code.
Pourquoi utiliser Firecrawl avec n8n ?
Le scraping web traditionnel présente plusieurs défis. Les scripts personnalisés cessent de fonctionner lorsque les sites web modifient leur structure. Les sites complexes et fortement dépendants de JavaScript ne s’affichent pas correctement. L’infrastructure nécessite une maintenance constante. Firecrawl gère ces complexités techniques liées au scraping, tandis que n8n fournit le cadre d’automatisation. Ensemble, ils vous permettent de créer des workflows prêts pour la production qui :- Extraient des données de manière fiable depuis n’importe quel site web
- Connectent les données scrapées à d’autres outils métier
- S’exécutent selon une planification ou sont déclenchés par des événements
- Passent de tâches simples à des pipelines complexes
Étape 1 : Créez votre compte Firecrawl
Firecrawl fournit des fonctionnalités de recherche, de scraping et d’interaction avec le navigateur pour vos agents IA et vos workflows. Configurez votre compte et obtenez vos identifiants d’API.Créez un compte Firecrawl
- Accédez à firecrawl.dev dans votre navigateur web
- Cliquez sur le bouton « Get Started » ou « Sign Up »
- Créez un compte avec votre adresse e-mail ou votre identifiant GitHub
- Vérifiez votre adresse e-mail si vous y êtes invité
Obtenez votre clé API
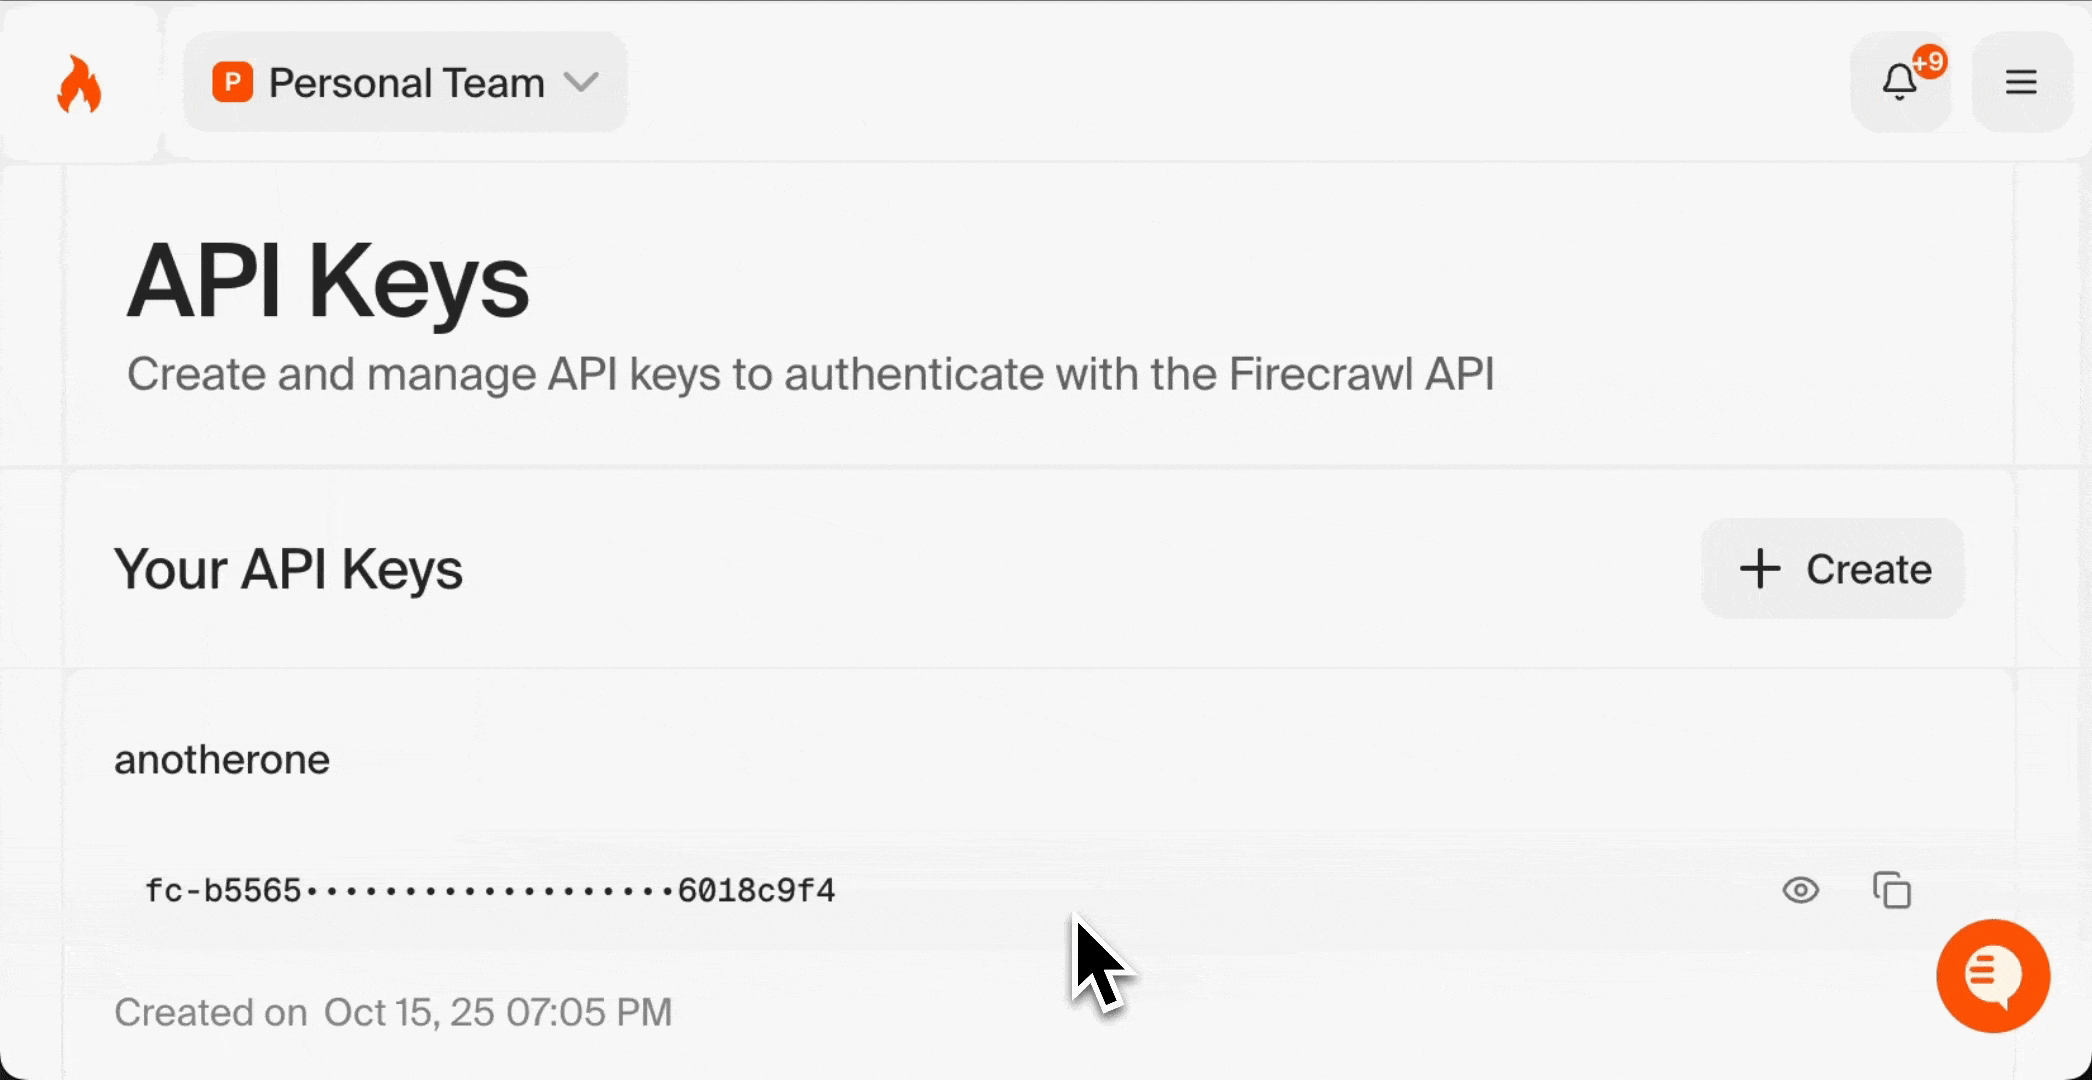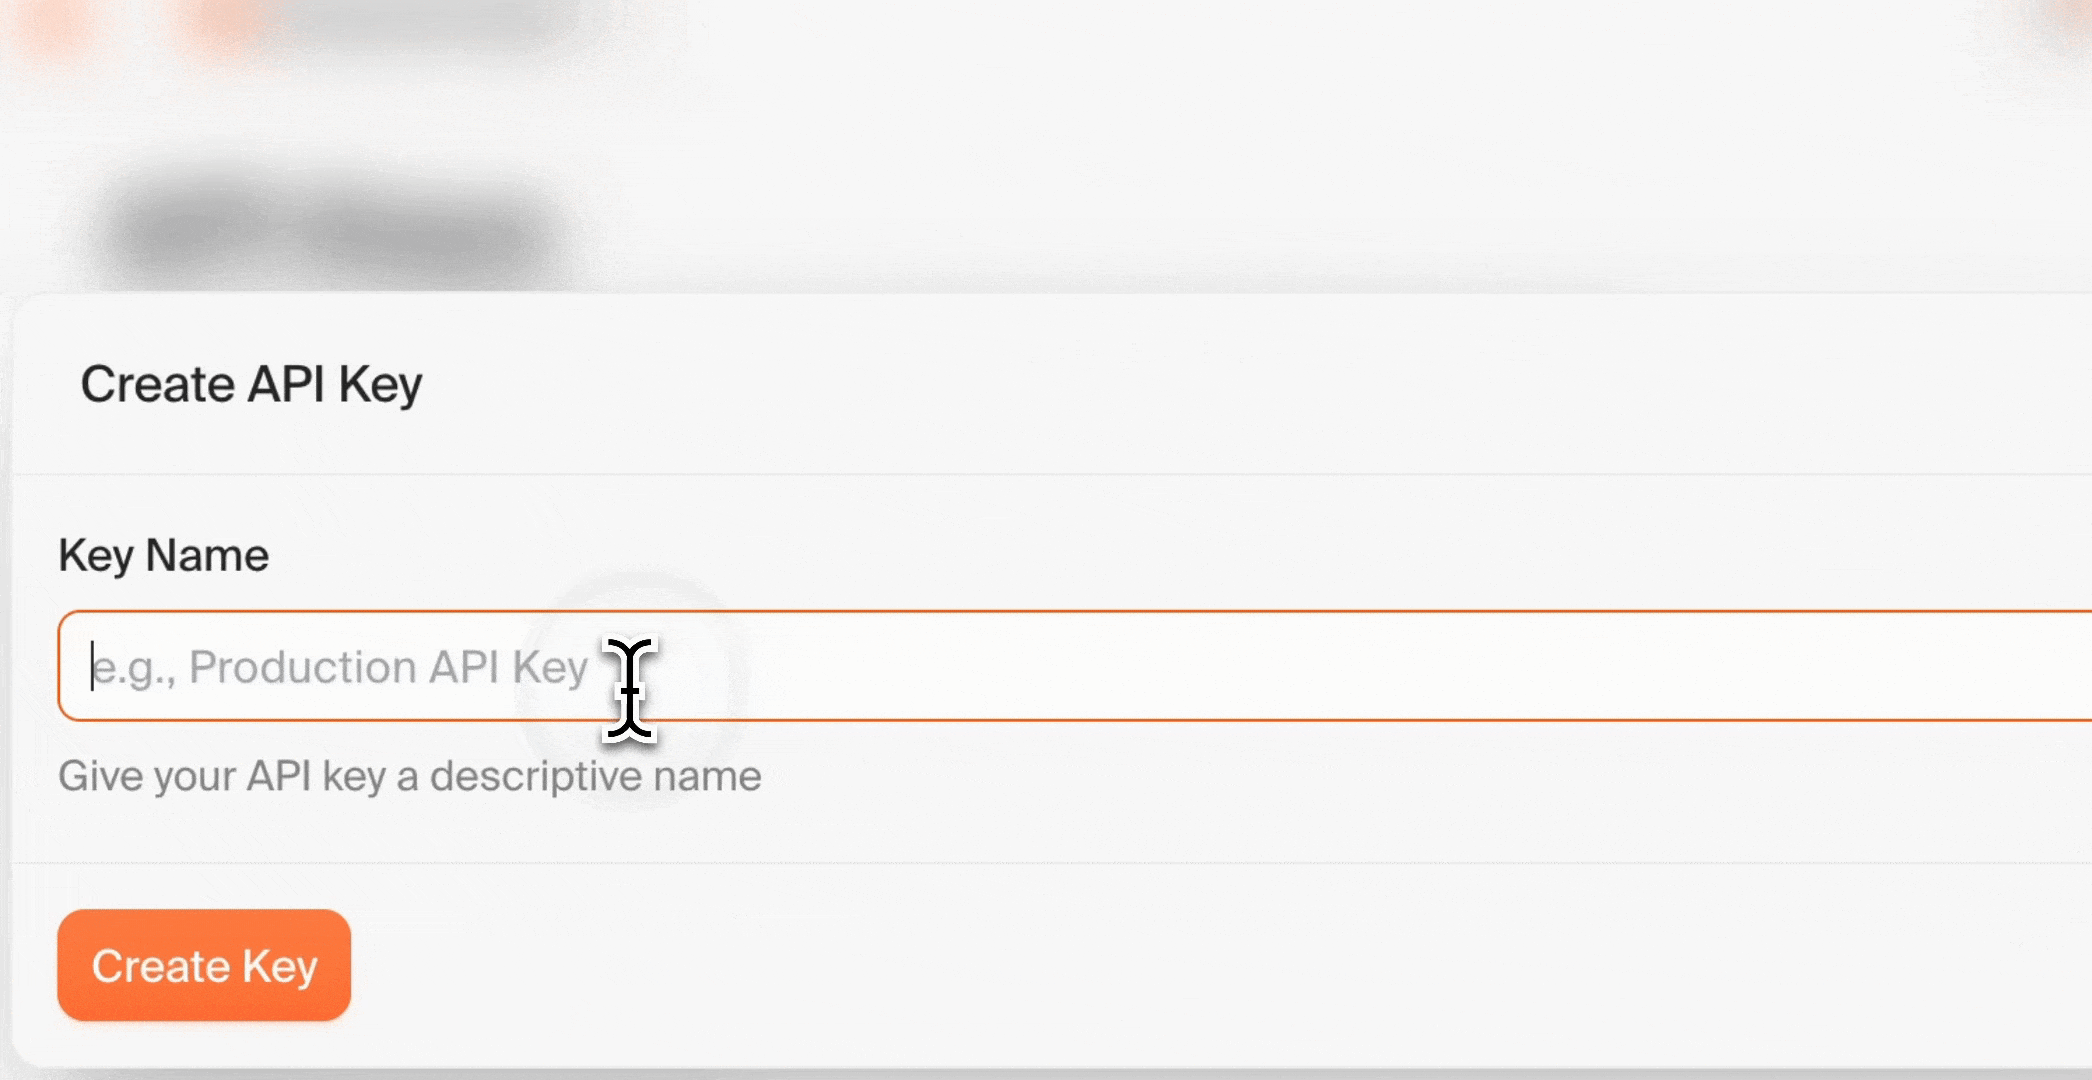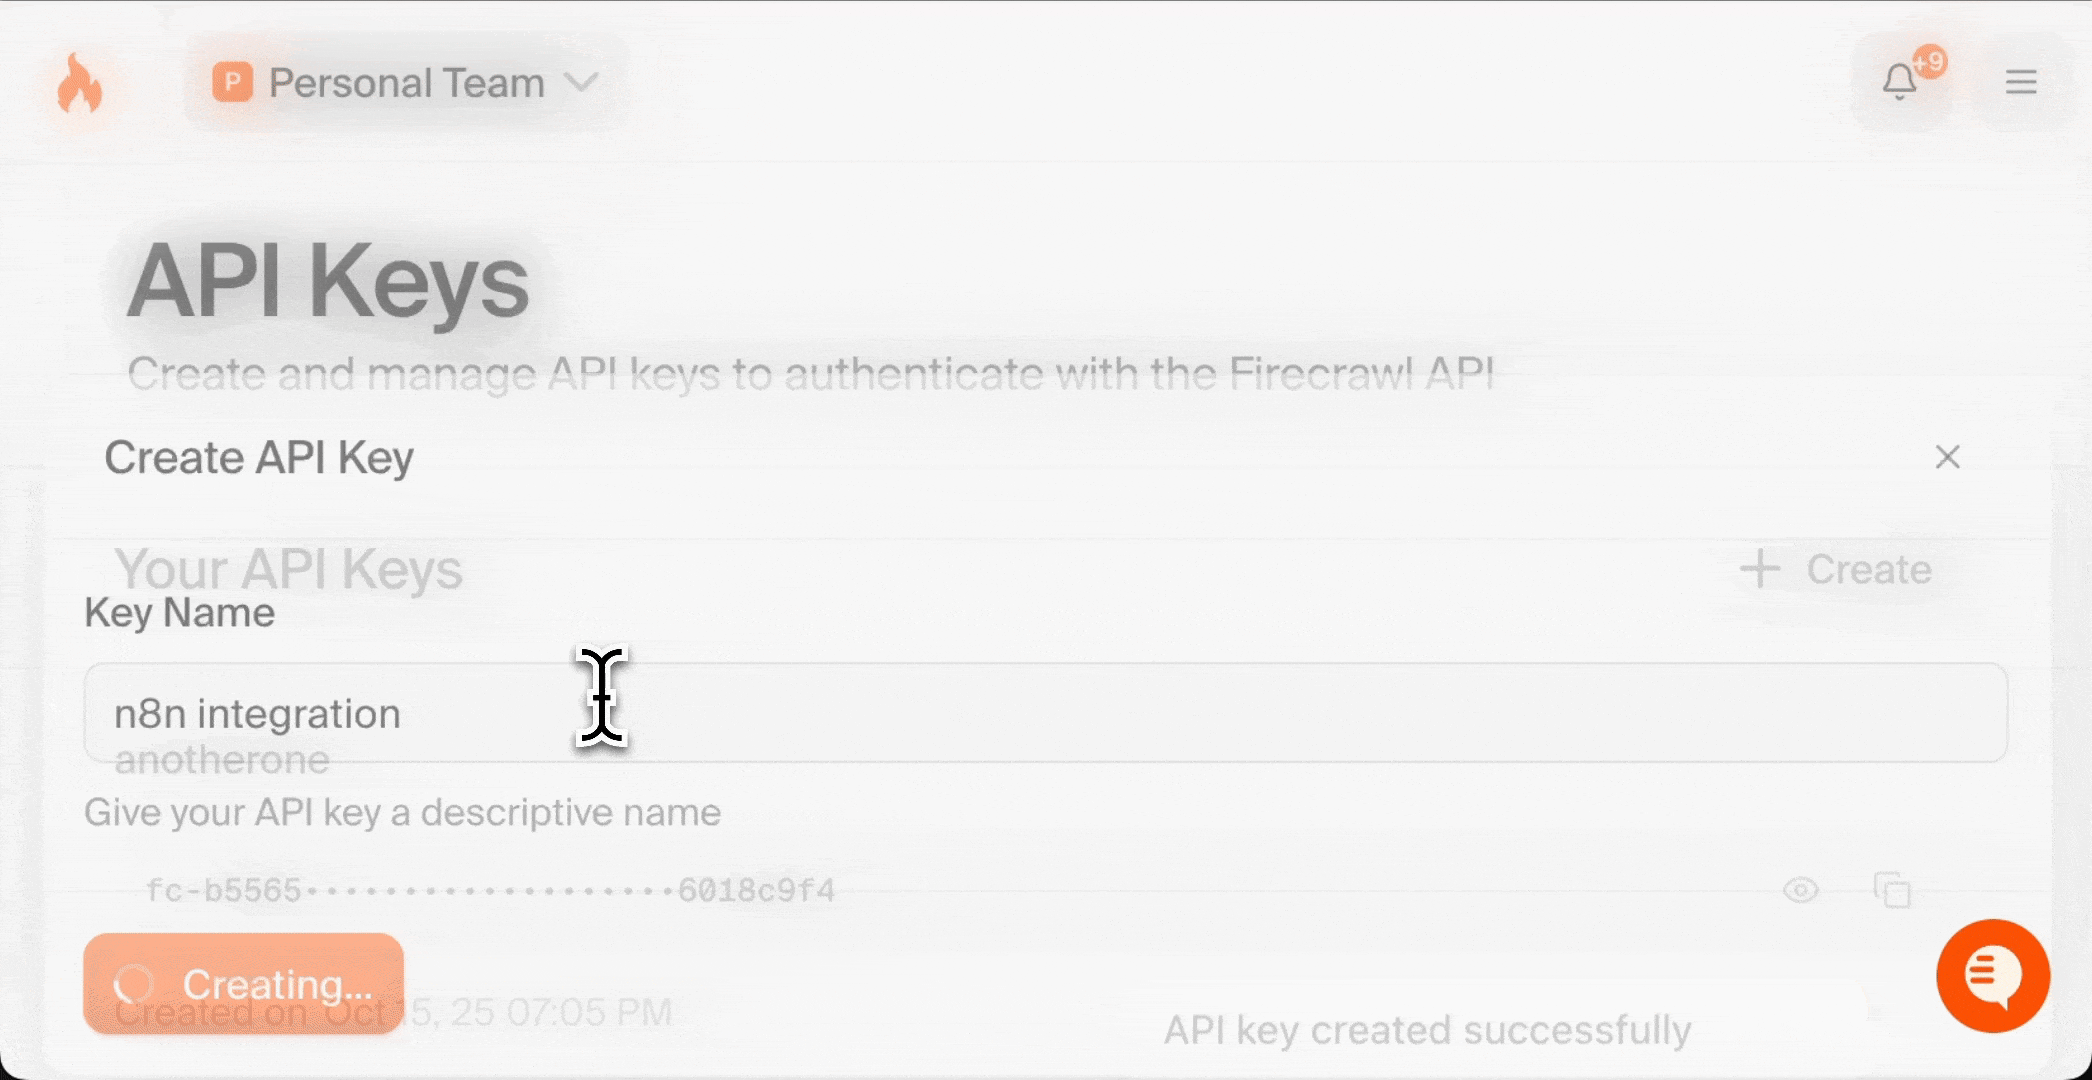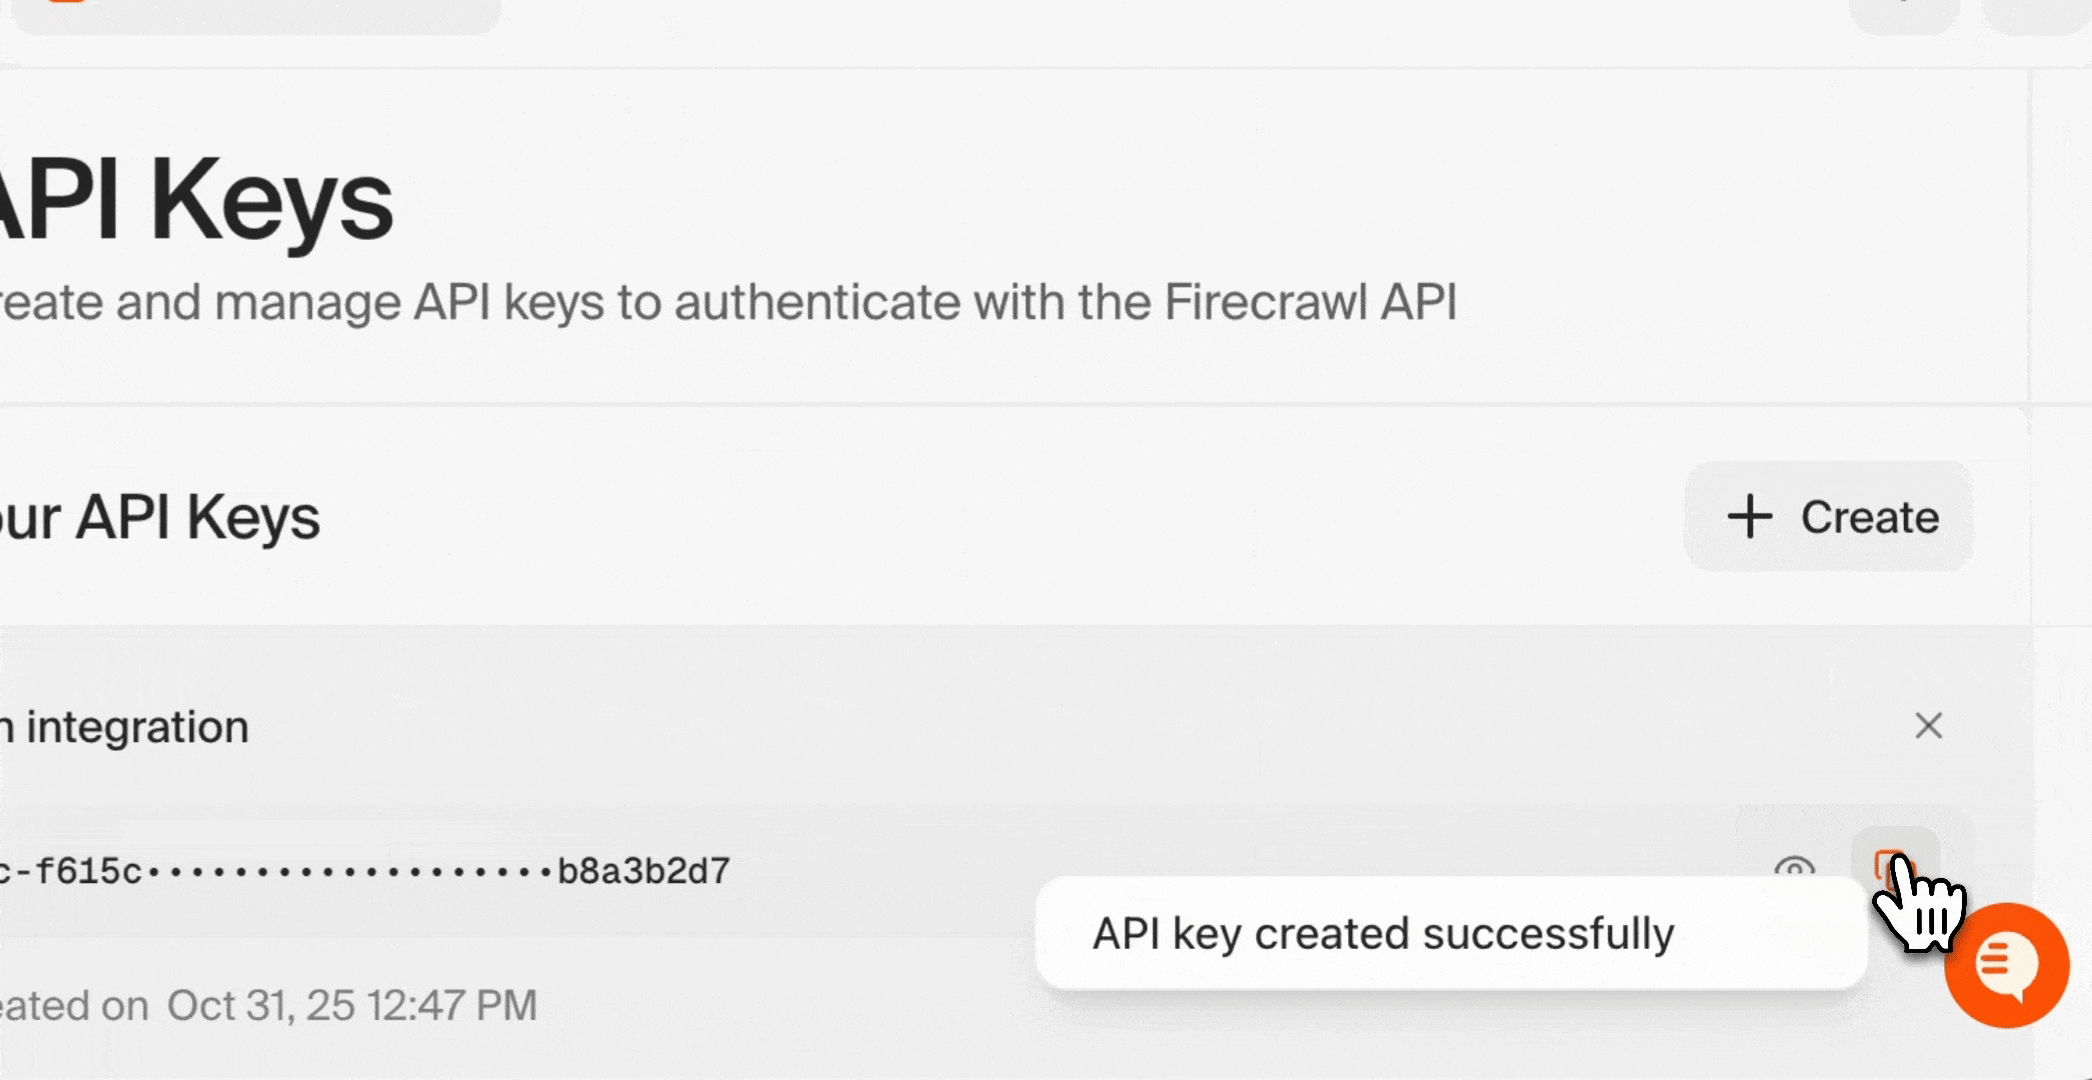
Après vous être connecté, vous aurez besoin d’une clé API pour connecter Firecrawl à n8n :- Accédez à votre tableau de bord Firecrawl
- Ouvrez la page API Keys
- Cliquez sur « Create New API Key »
- Donnez à votre clé un nom descriptif (par exemple, « n8n Integration »)
- Copiez la clé API générée et conservez-la dans un endroit sûr
Votre clé API est comme un mot de passe. Gardez-la en lieu sûr et ne la partagez jamais publiquement. Vous en aurez besoin dans la section suivante.
Étape 2 : Configurer n8n
n8n propose deux options de déploiement : hébergée dans le cloud ou auto-hébergée. Pour les débutants, la version cloud est le moyen le plus rapide de démarrer.Choisissez votre version de n8n
n8n Cloud (recommandé pour les débutants) :- Aucune installation requise
- Offre Free disponible
- Infrastructure gérée
- Mises à jour automatiques
- Contrôle total de vos données
- Fonctionne sur vos propres serveurs
- Nécessite l’installation de Docker
- Adapté aux utilisateurs avancés ayant des exigences spécifiques en matière de sécurité
Option A : n8n Cloud (recommandé pour les débutants)
- Rendez-vous sur n8n.cloud
- Cliquez sur « Start Free » ou « Sign Up »
- Inscrivez-vous avec votre adresse e-mail ou votre compte GitHub
- Terminez le processus de vérification
- Vous serez redirigé vers votre tableau de bord n8n
Option B : Auto-hébergé avec Docker
Si vous préférez exécuter n8n sur votre propre infrastructure, vous pouvez le configurer rapidement avec Docker. Prérequis :- Docker Desktop installé sur votre ordinateur
- Connaissances de base de la ligne de commande ou du terminal
- Ouvrez votre terminal ou votre invite de commandes
- Créez un volume Docker pour conserver les données de votre workflow :
- Démarrez le conteneur Docker n8n :
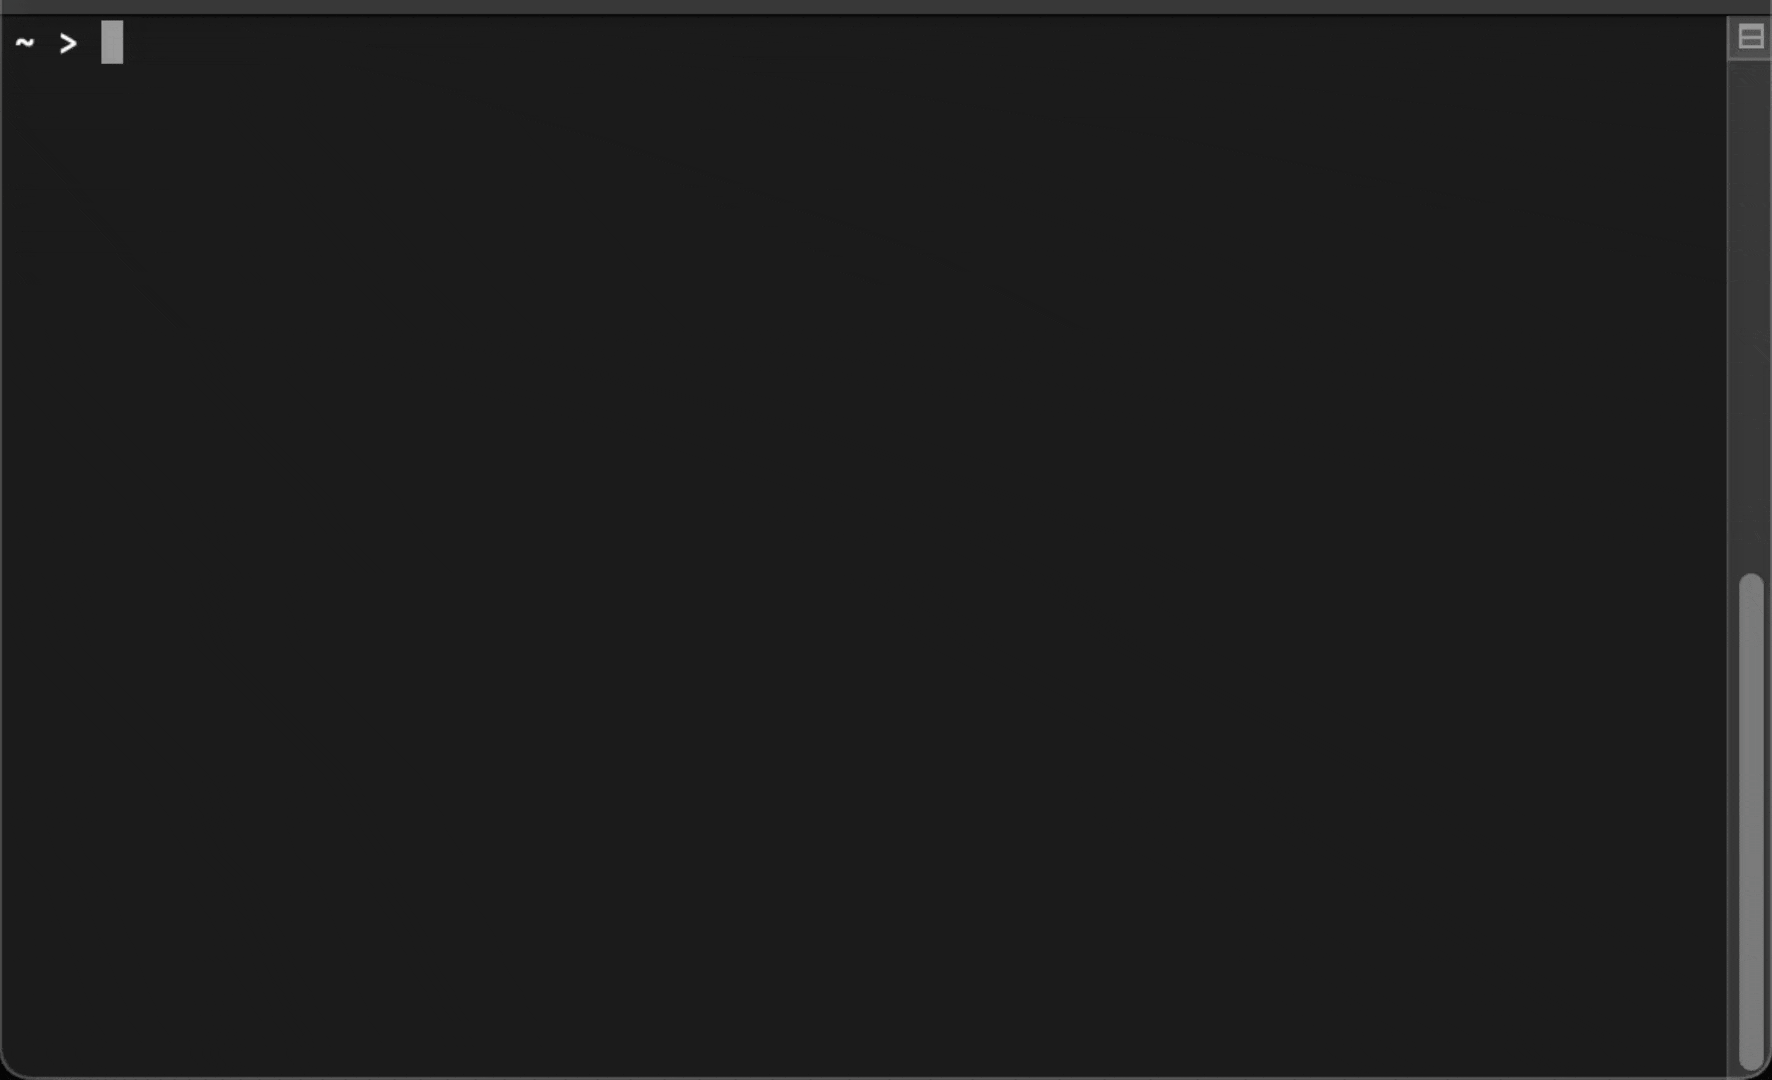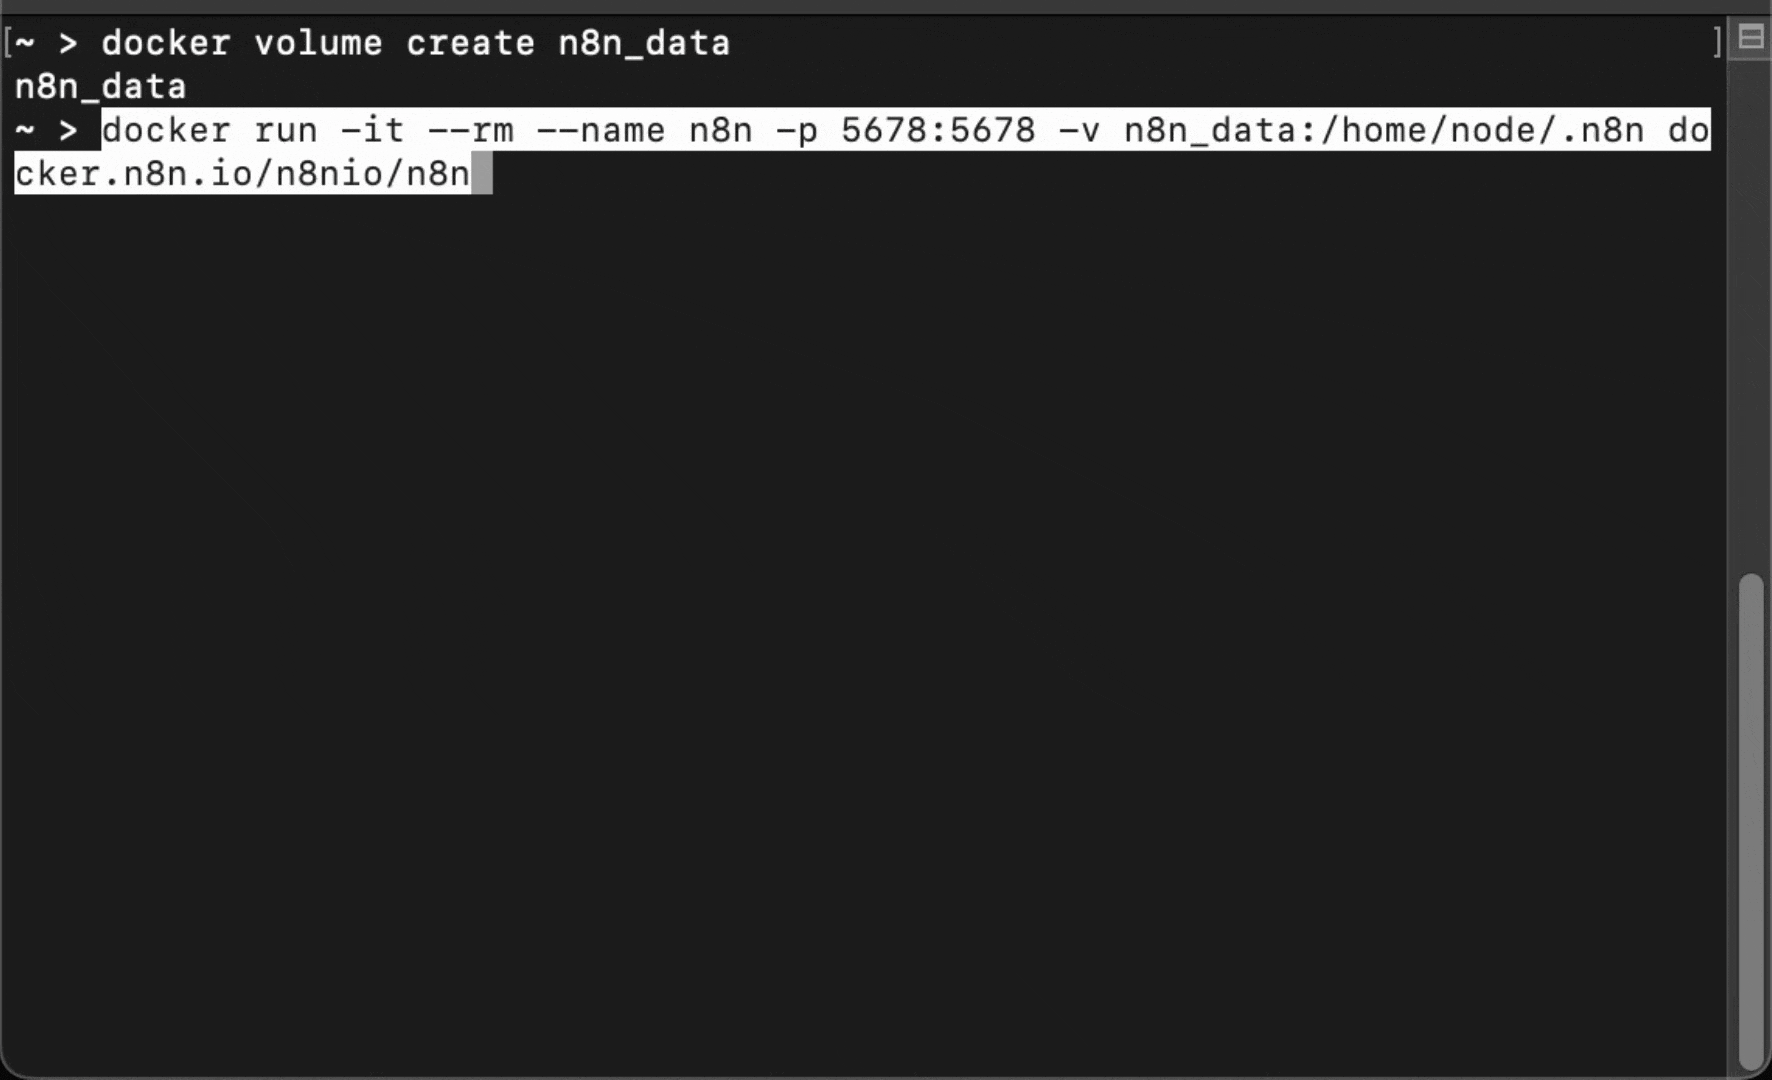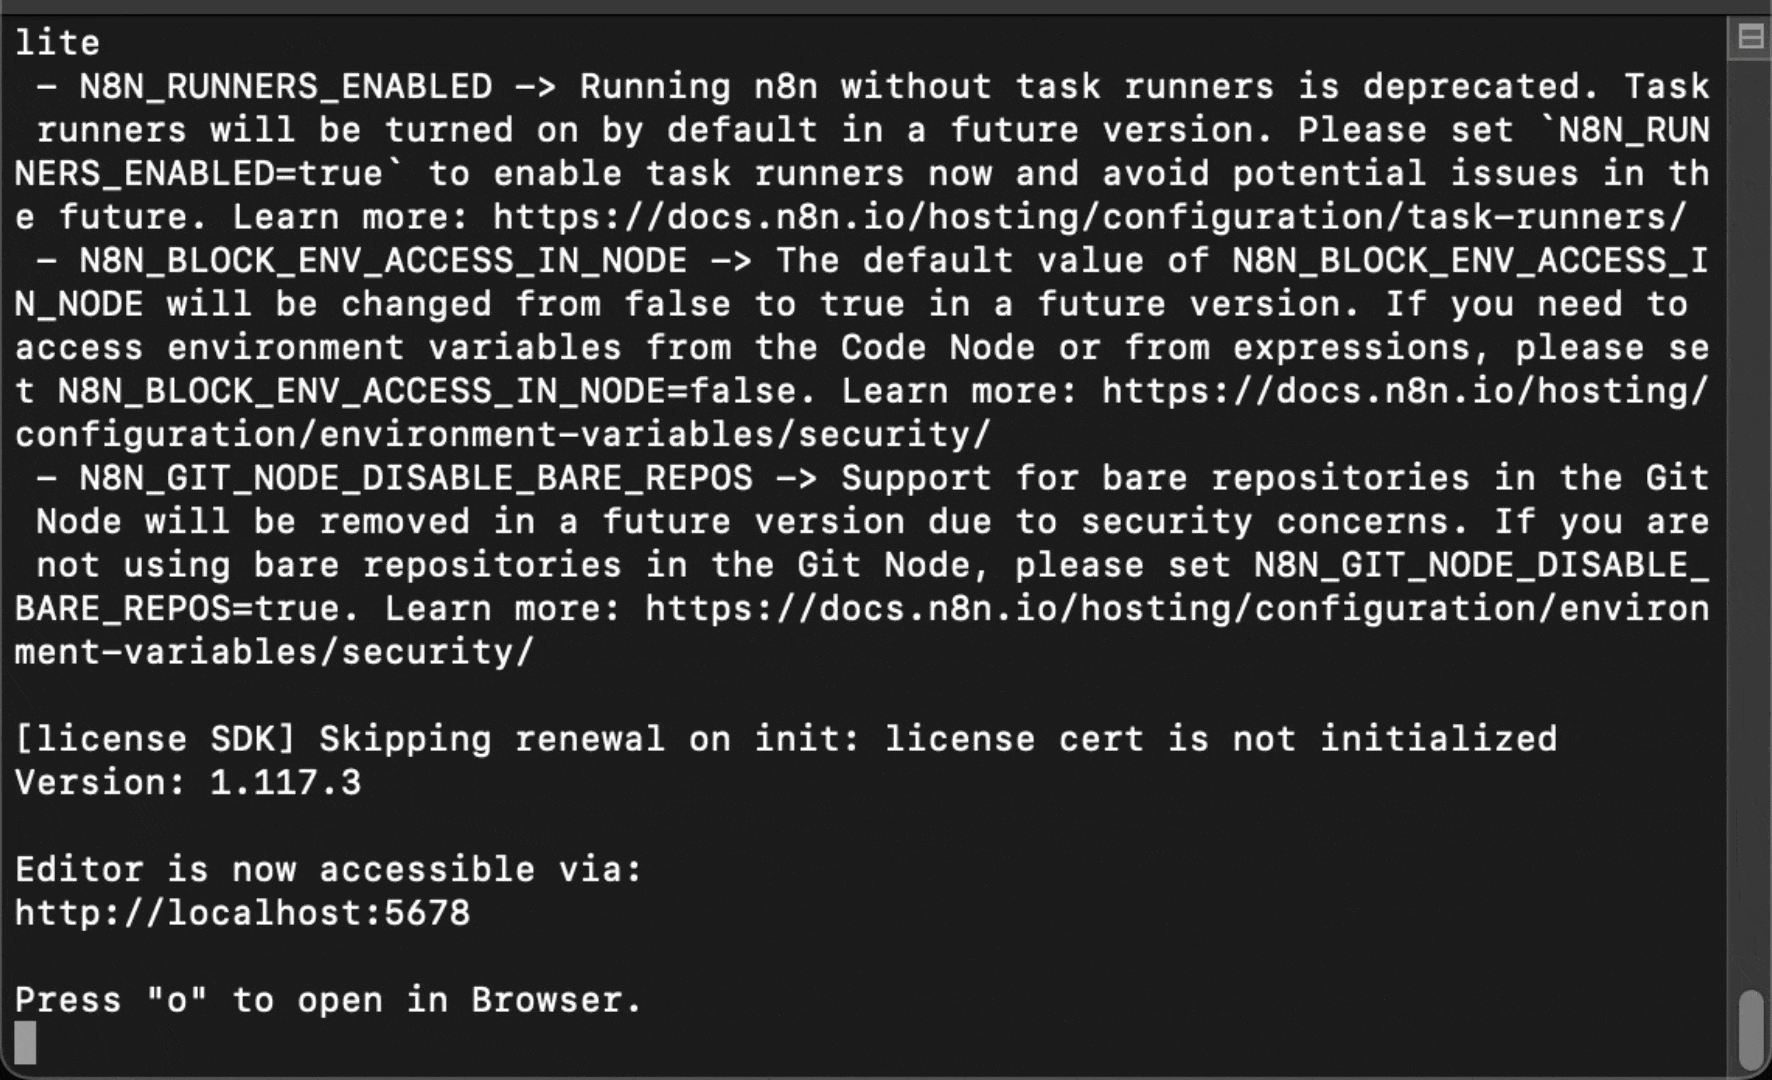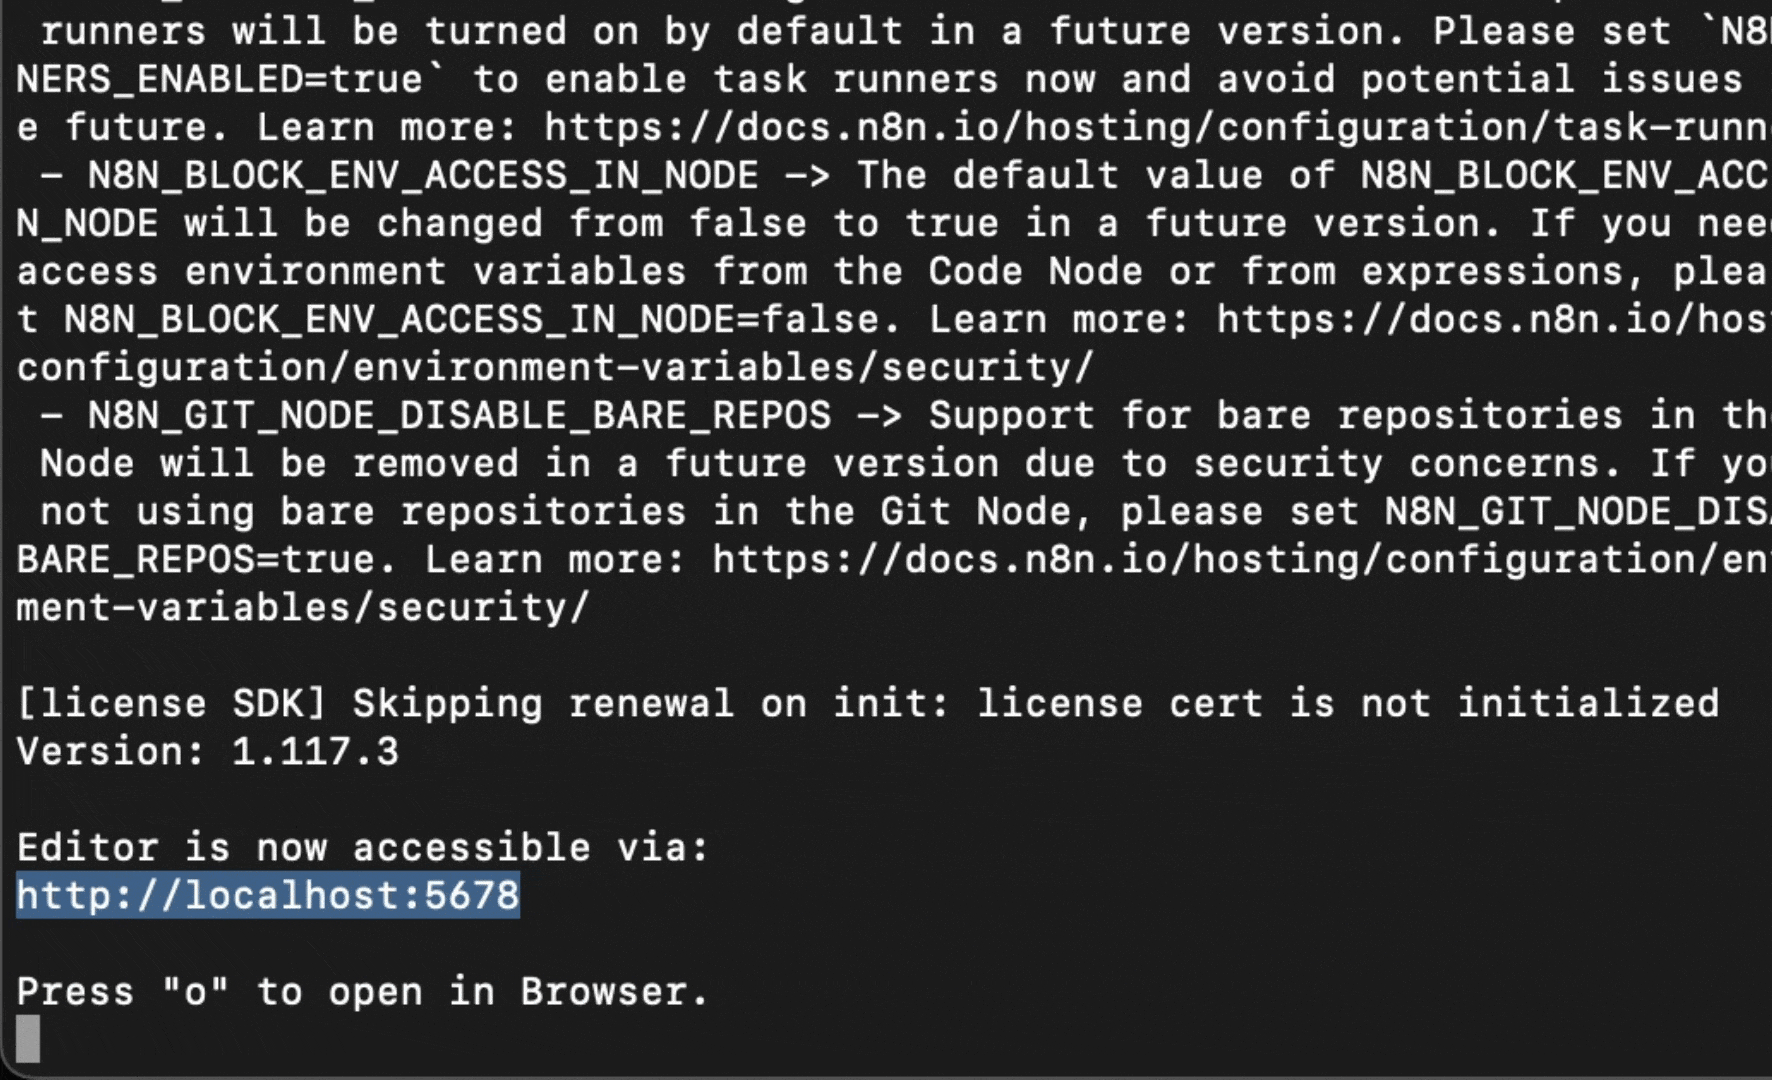
- Attendez que n8n démarre. Une sortie indiquera que le serveur est en cours d’exécution.
- Ouvrez votre navigateur web et accédez à
http://localhost:5678 - Créez votre compte n8n en vous inscrivant avec une adresse e-mail
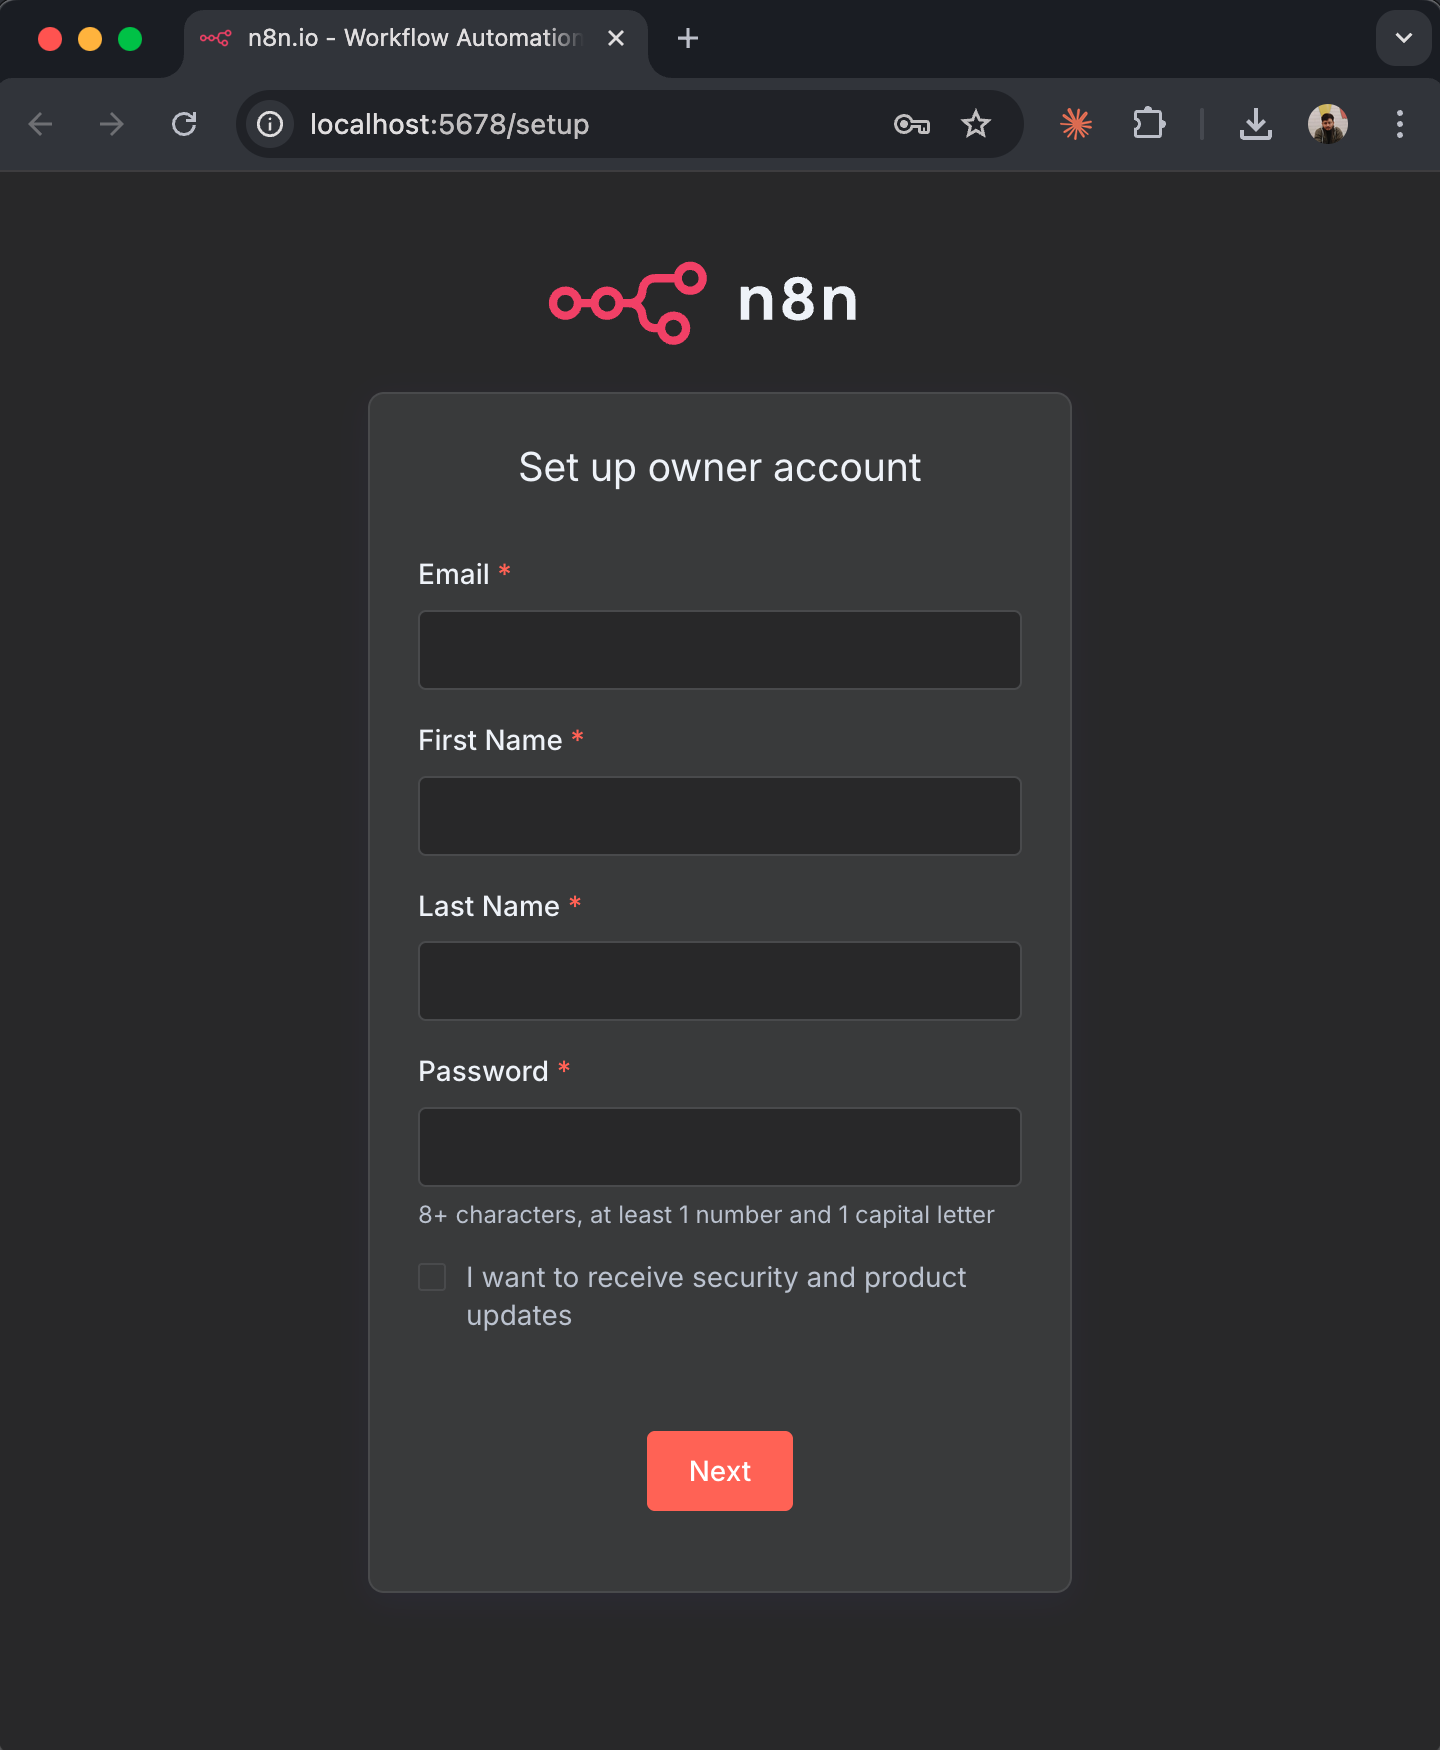
L’indicateur
--rm supprime automatiquement le conteneur lorsque vous l’arrêtez, mais vos données restent en sécurité dans le volume n8n_data. Pour les déploiements en production, consultez la documentation sur l’auto-hébergement de n8n afin de découvrir des options de configuration plus avancées.Comprendre l’interface n8n
Lorsque vous vous connectez à n8n pour la première fois, vous voyez le tableau de bord principal :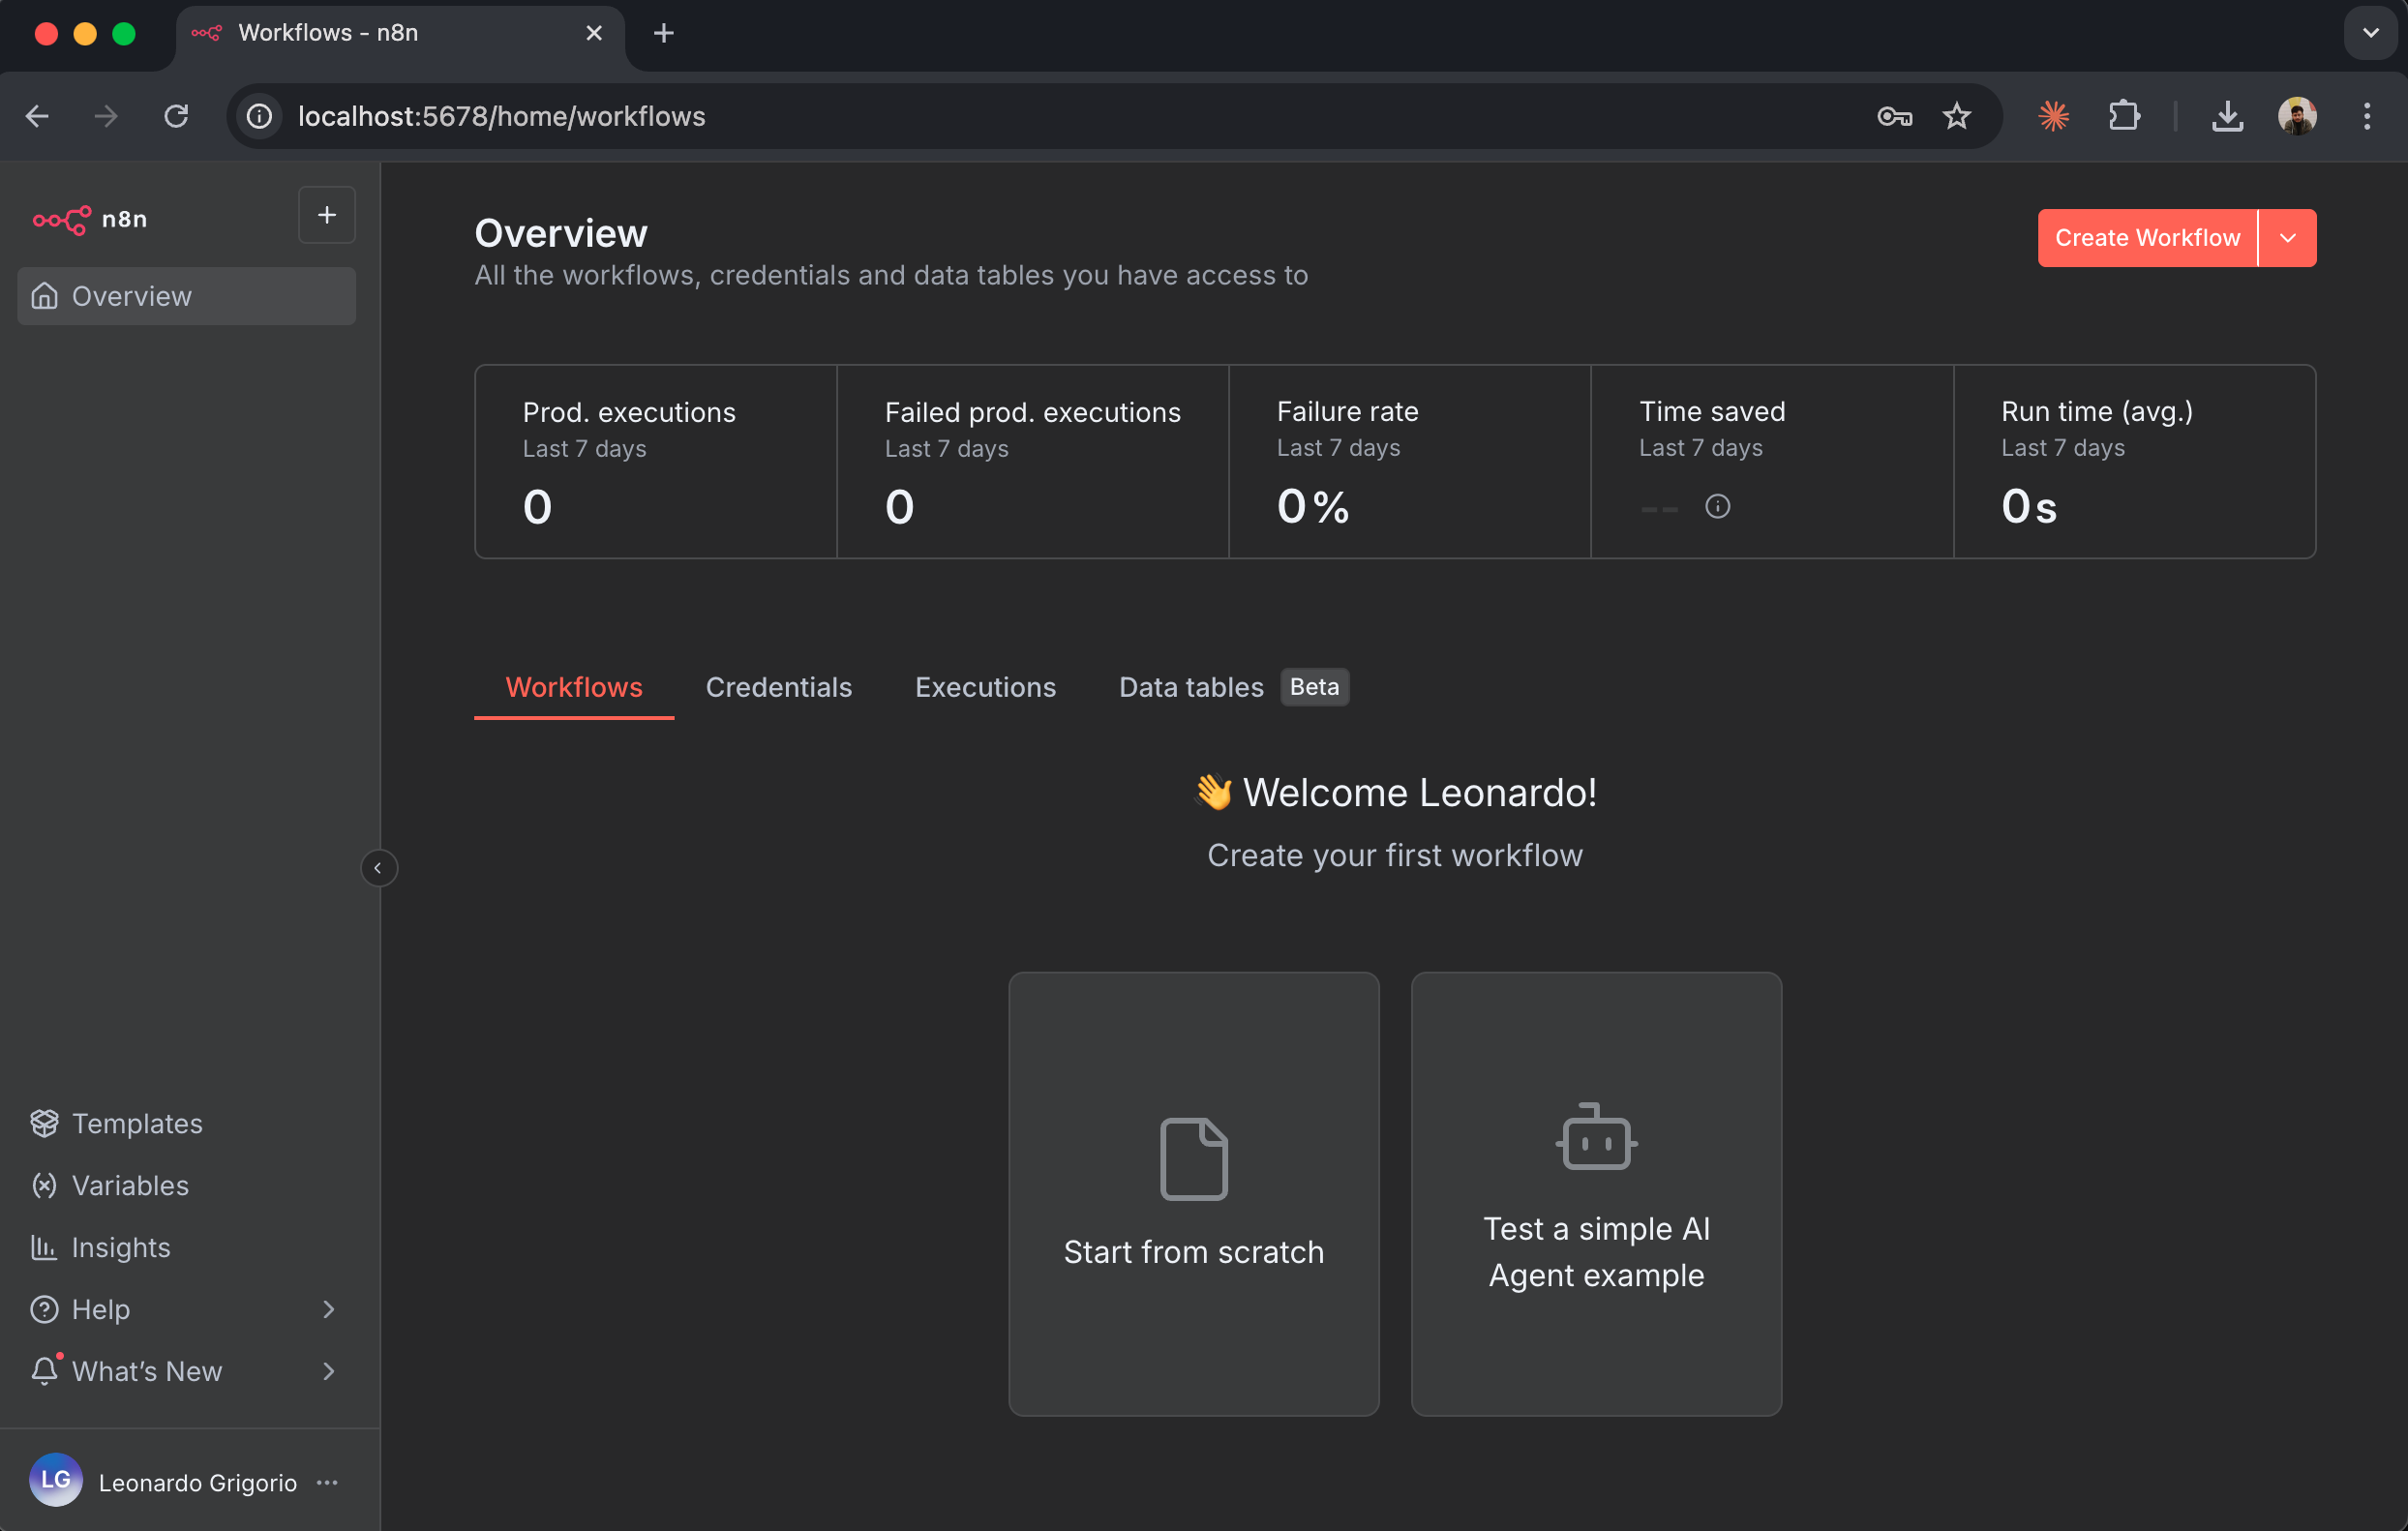
- Workflows : vos automatisations enregistrées apparaissent ici
- Executions : historique des exécutions de workflows
- Credentials : clés API et jetons d’authentification enregistrés
- Settings : configuration du compte et de l’espace de travail
Le canevas du workflow
L’éditeur de workflows vous permet de créer vos automatisations :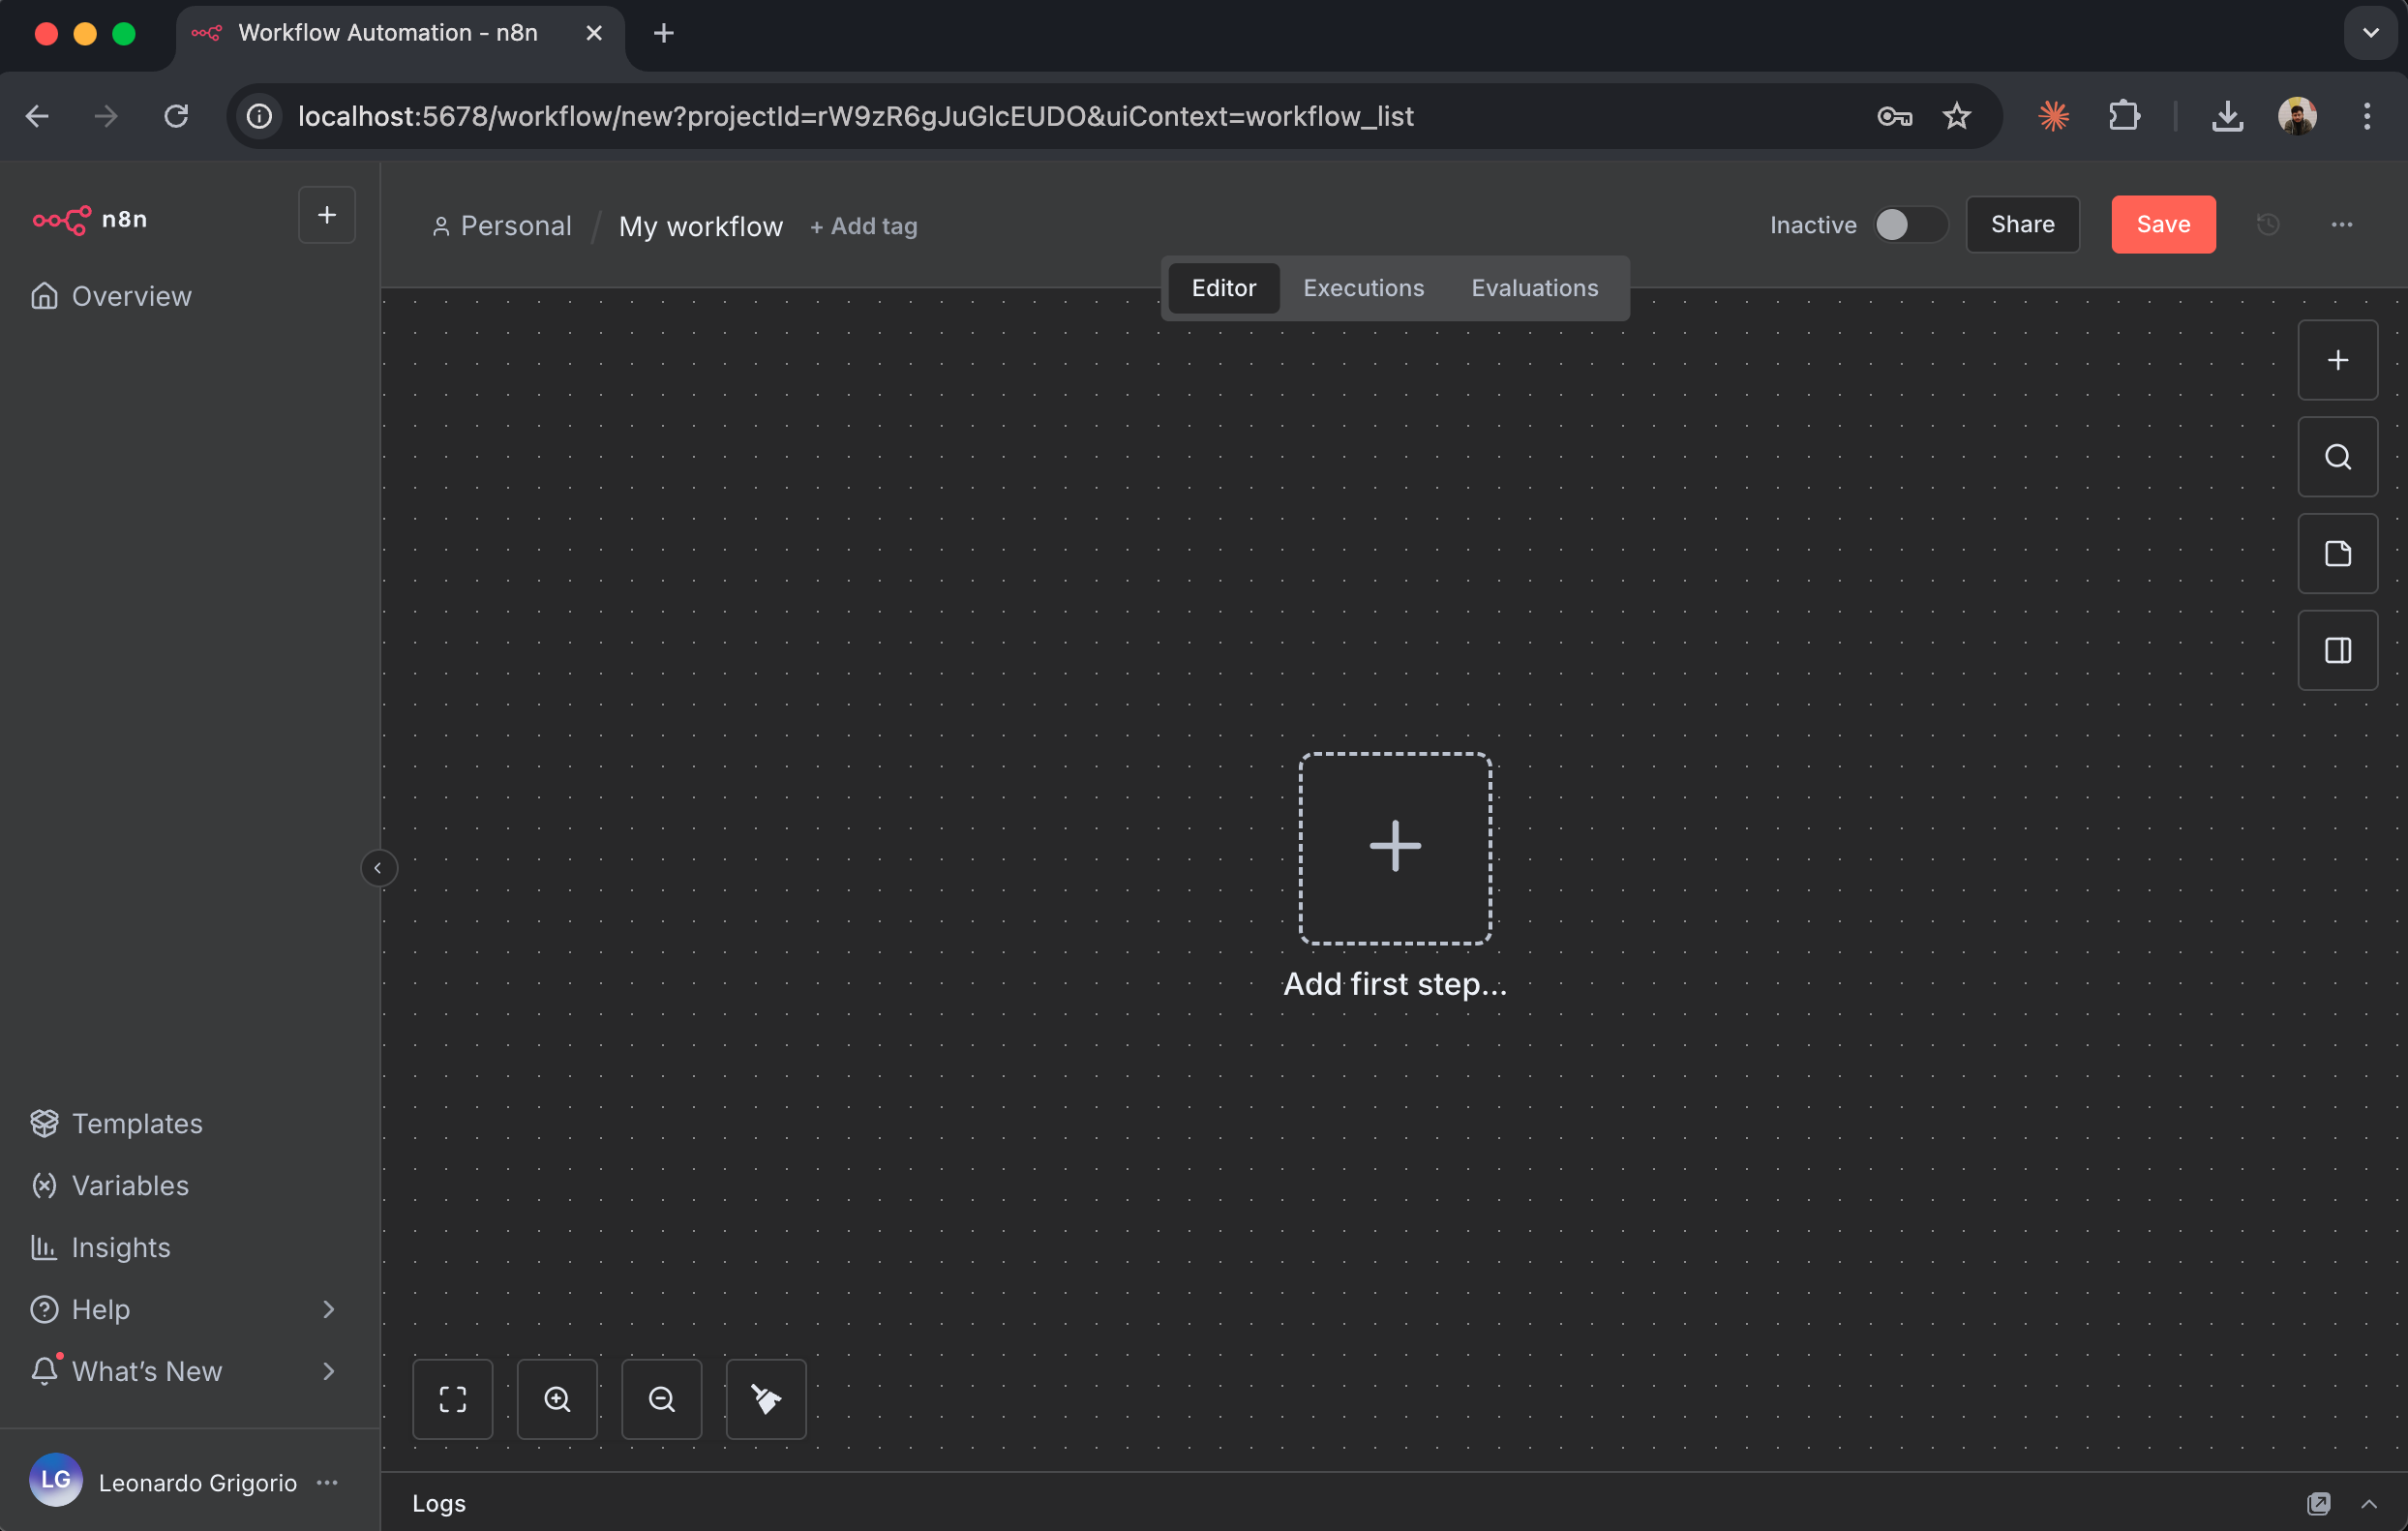
- Canevas : zone principale où vous placez et reliez les nœuds
- Bouton Ajouter un nœud (+) : cliquez dessus pour ajouter de nouveaux nœuds à votre workflow
- Panneau des nœuds : s’ouvre lorsque vous cliquez sur « + » et affiche tous les nœuds disponibles
- Exécuter le workflow : exécute manuellement votre workflow à des fins de test
- Save : enregistre la configuration de votre workflow
Étape 3 : Installer et configurer le nœud Firecrawl
Firecrawl est disponible dans n8n sous forme de nœud vérifié (@mendable/n8n-nodes-firecrawl), développé et maintenu par Firecrawl. Installez le nœud et connectez-le à votre compte Firecrawl à l’aide de la clé API créée précédemment. Sur une instance n8n self-hosted, il suffit qu’un propriétaire de l’instance installe les nœuds vérifiés une seule fois pour que tous les utilisateurs de l’instance puissent les utiliser.
Ajoutez le nœud Firecrawl à votre workflow
- Dans le canevas de votre nouveau workflow, cliquez sur le bouton ”+” au centre
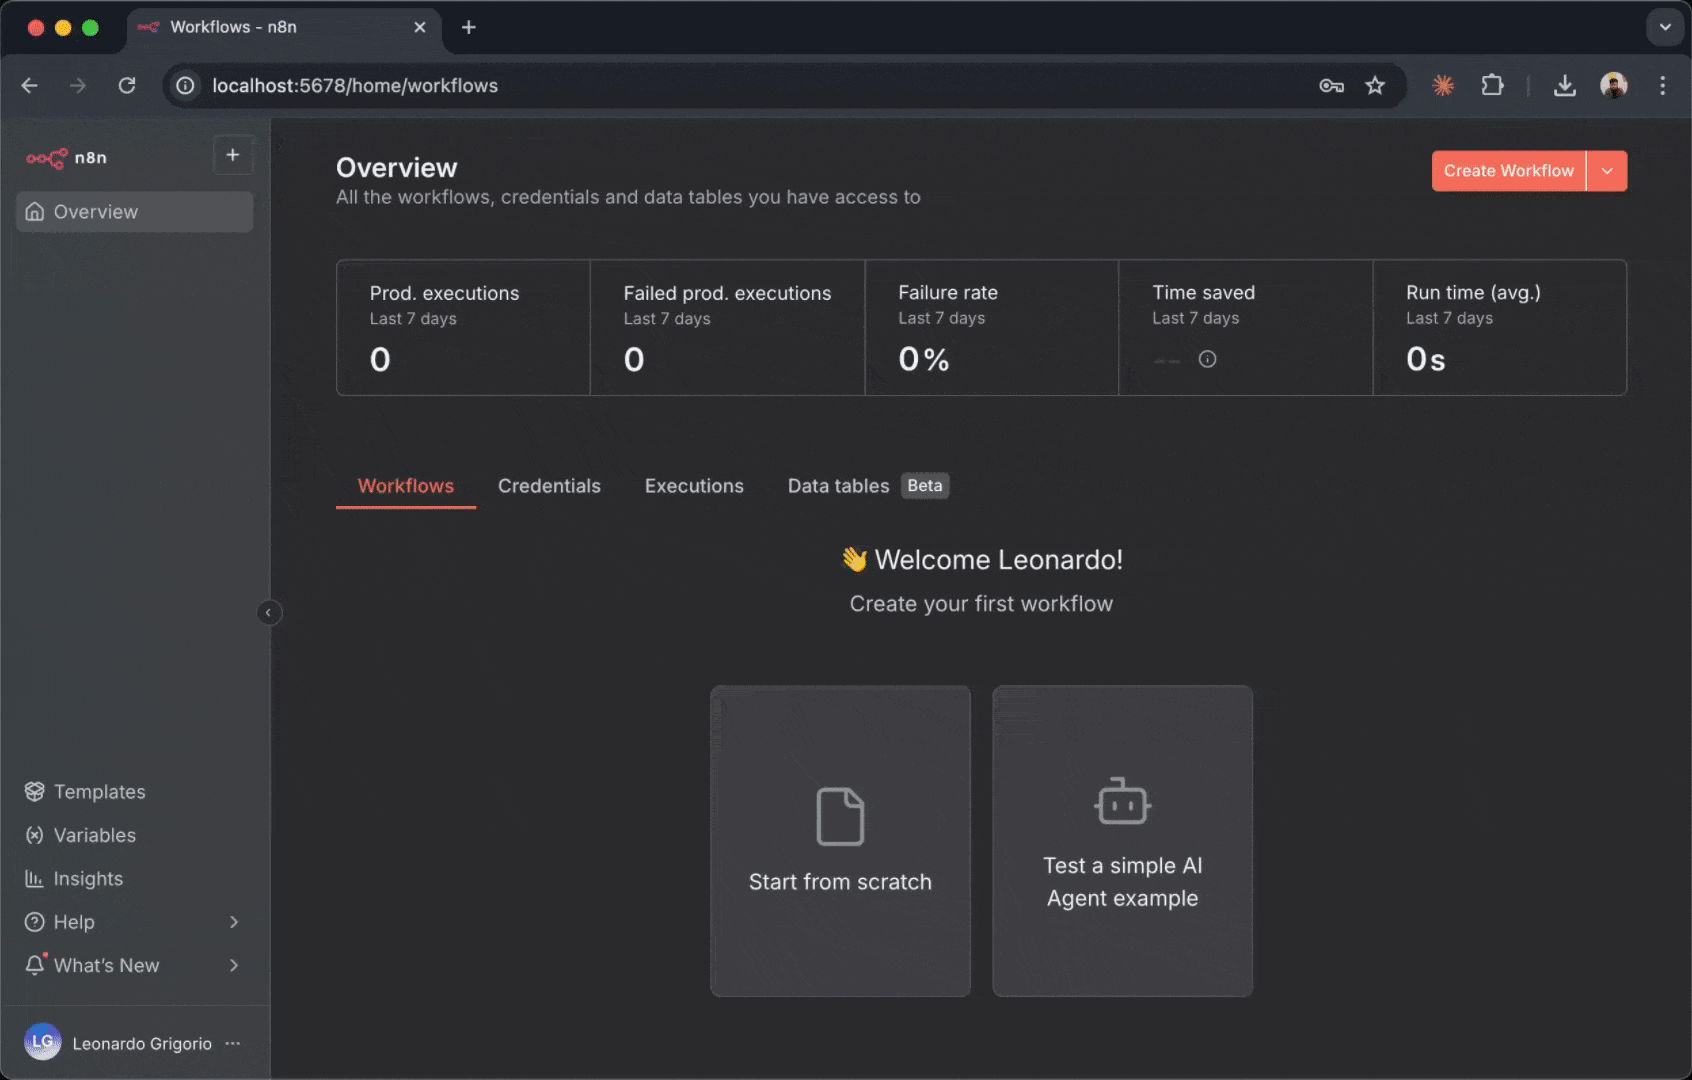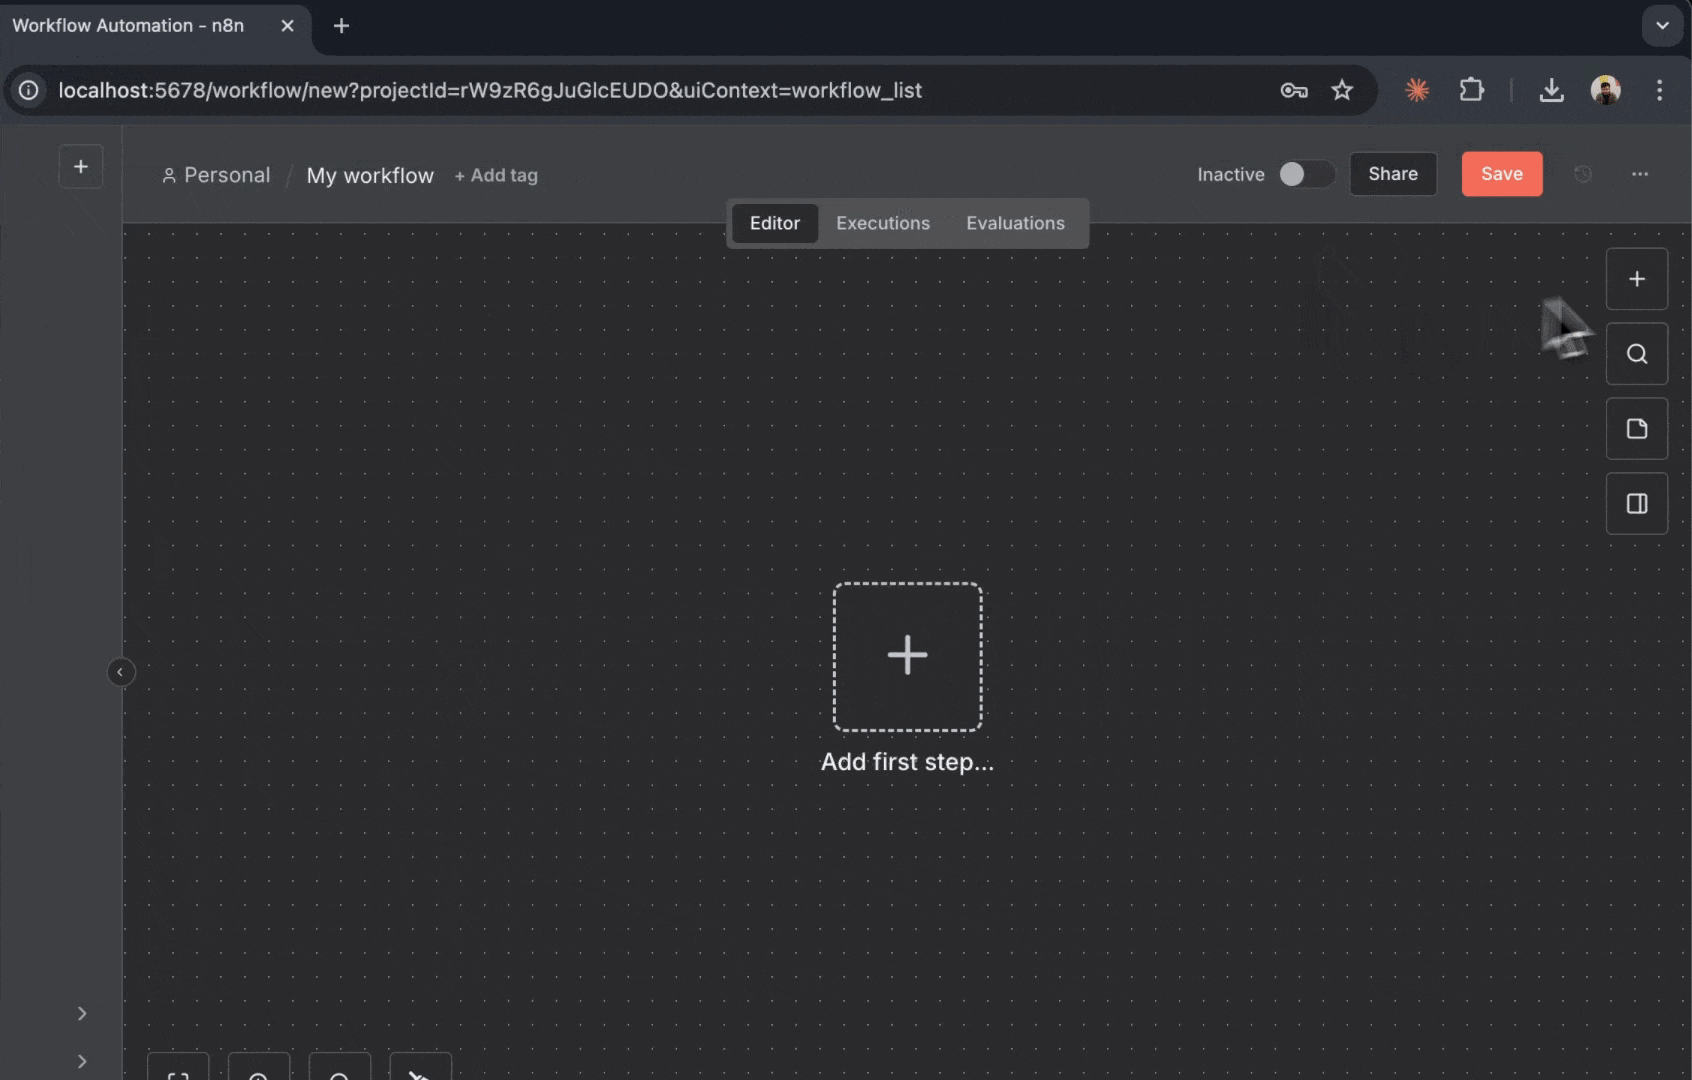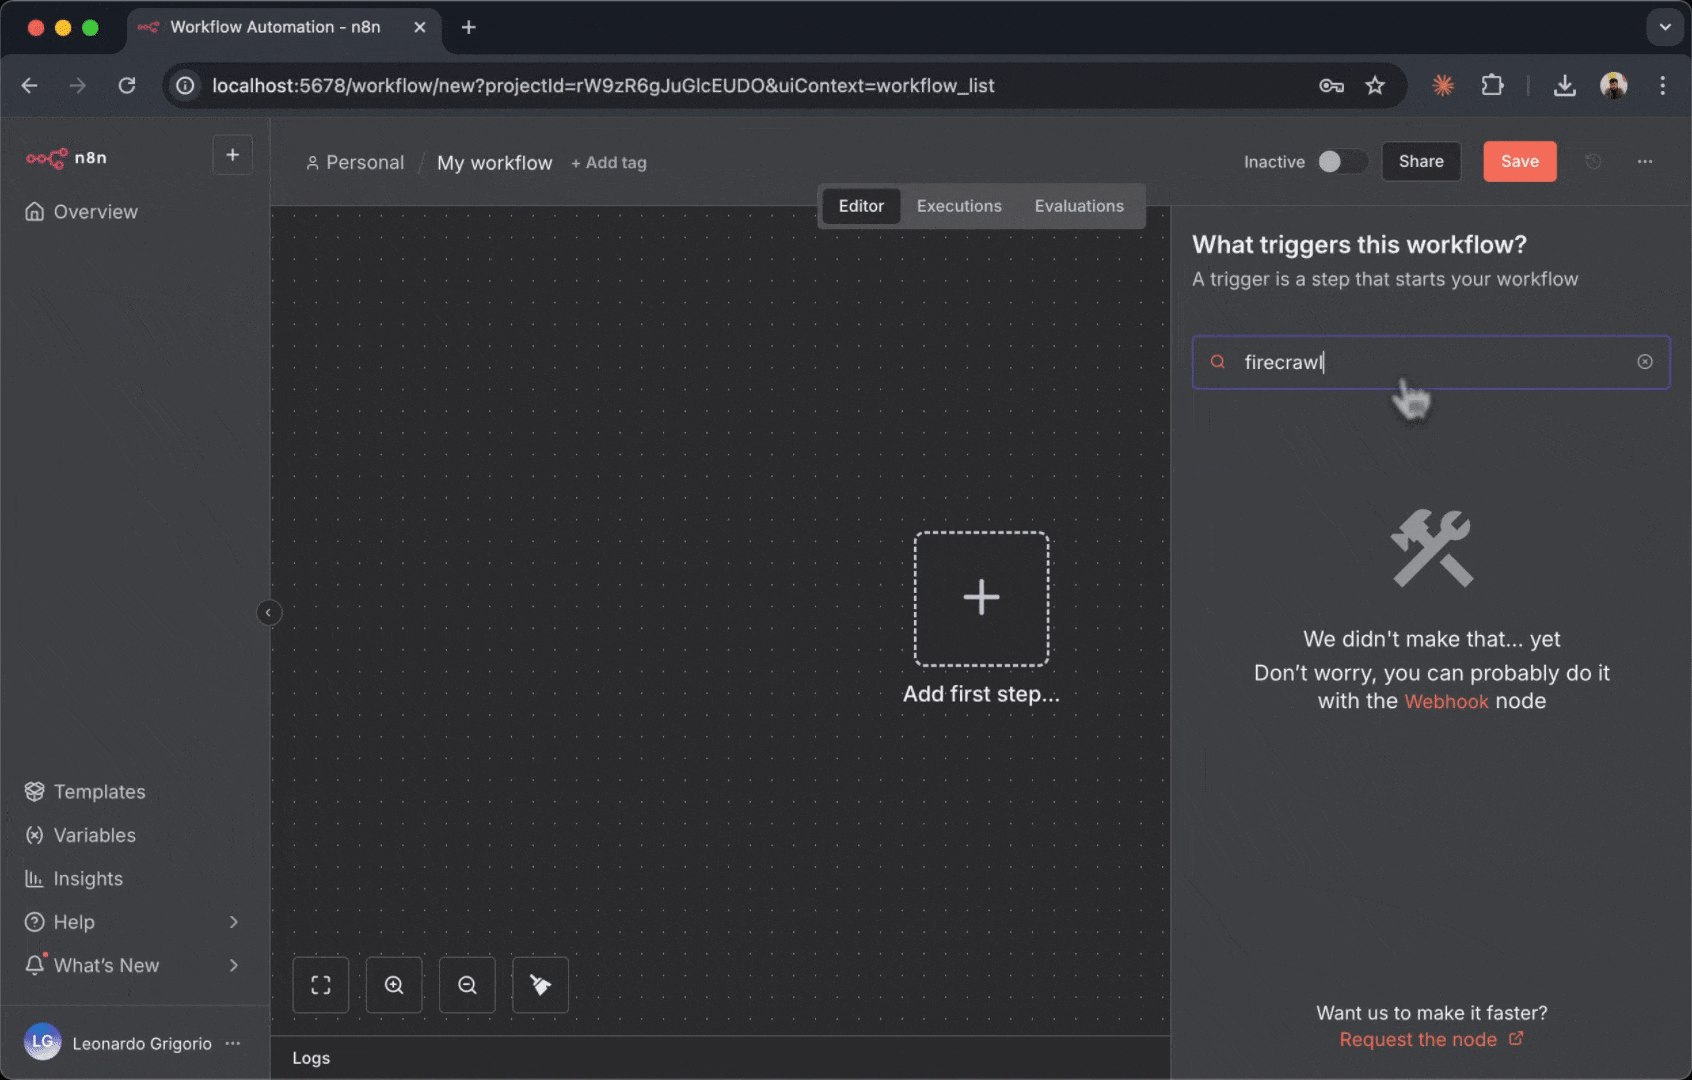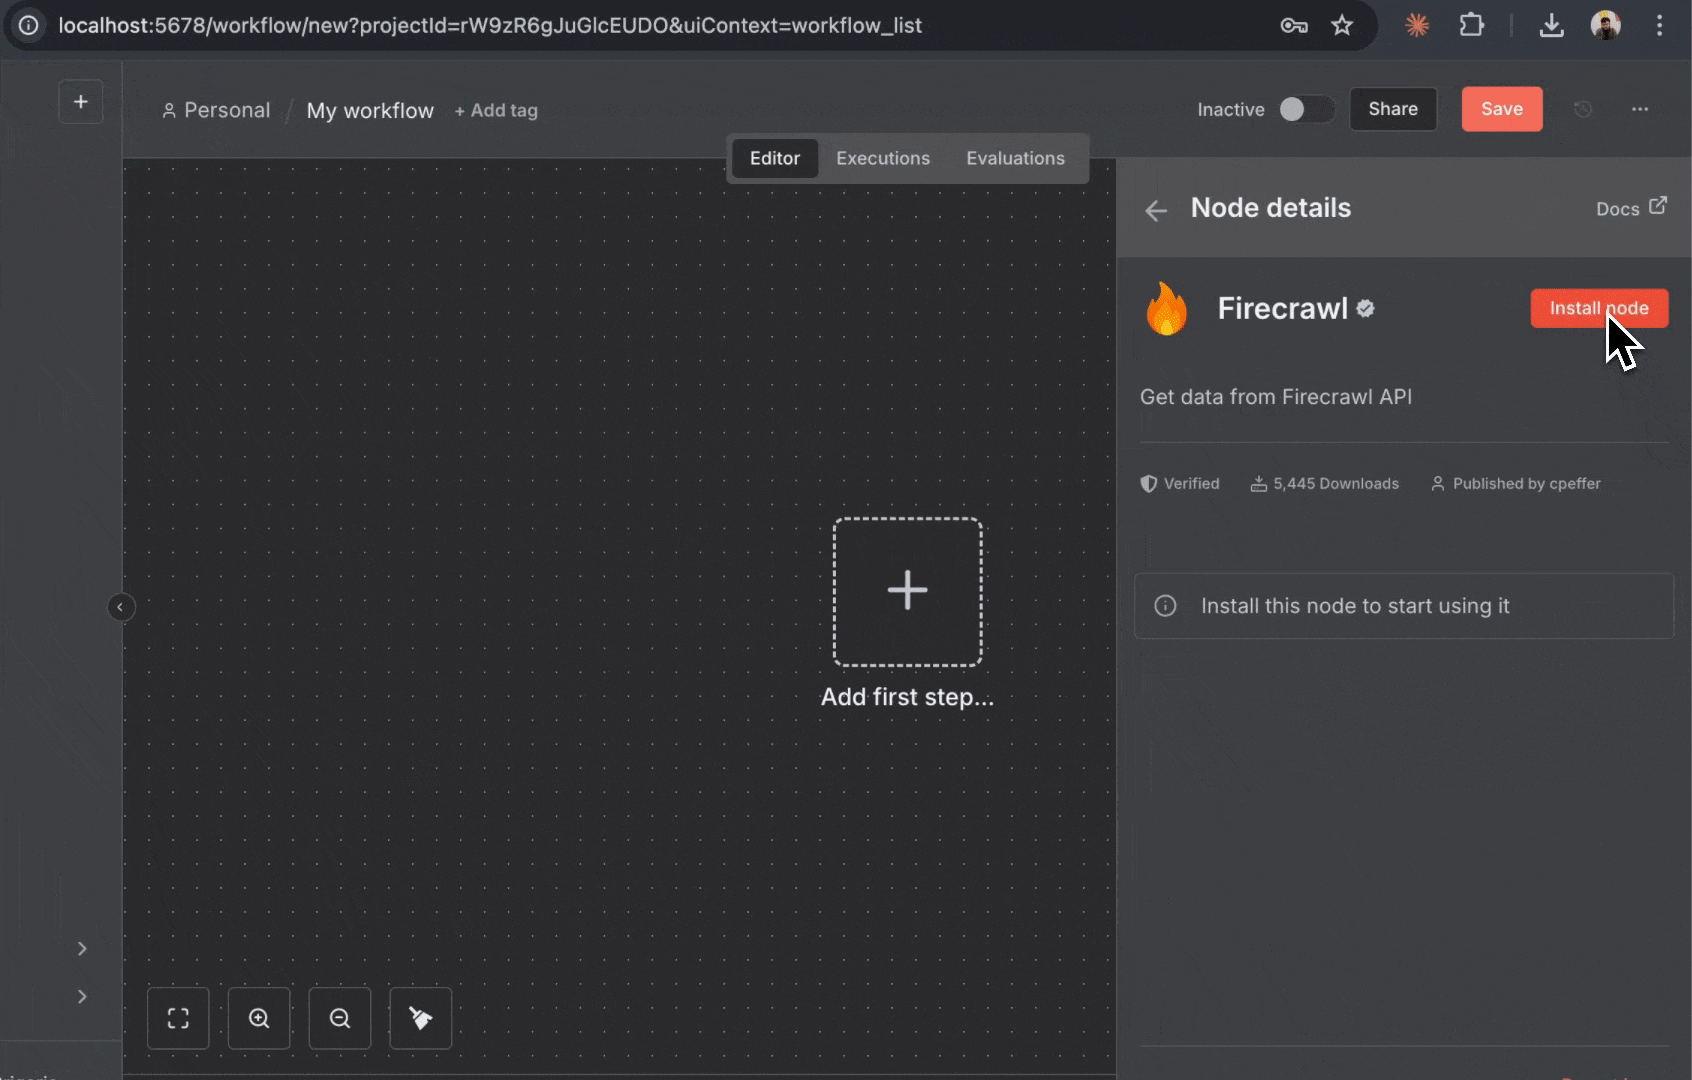
- Le panneau de sélection des nœuds s’ouvre à droite
- Dans le champ de recherche en haut, saisissez “Firecrawl”
- Le nœud Firecrawl apparaît dans les résultats de recherche
- Cliquez sur “Install” à côté du nœud Firecrawl
- Attendez la fin de l’installation (cela prend quelques secondes)
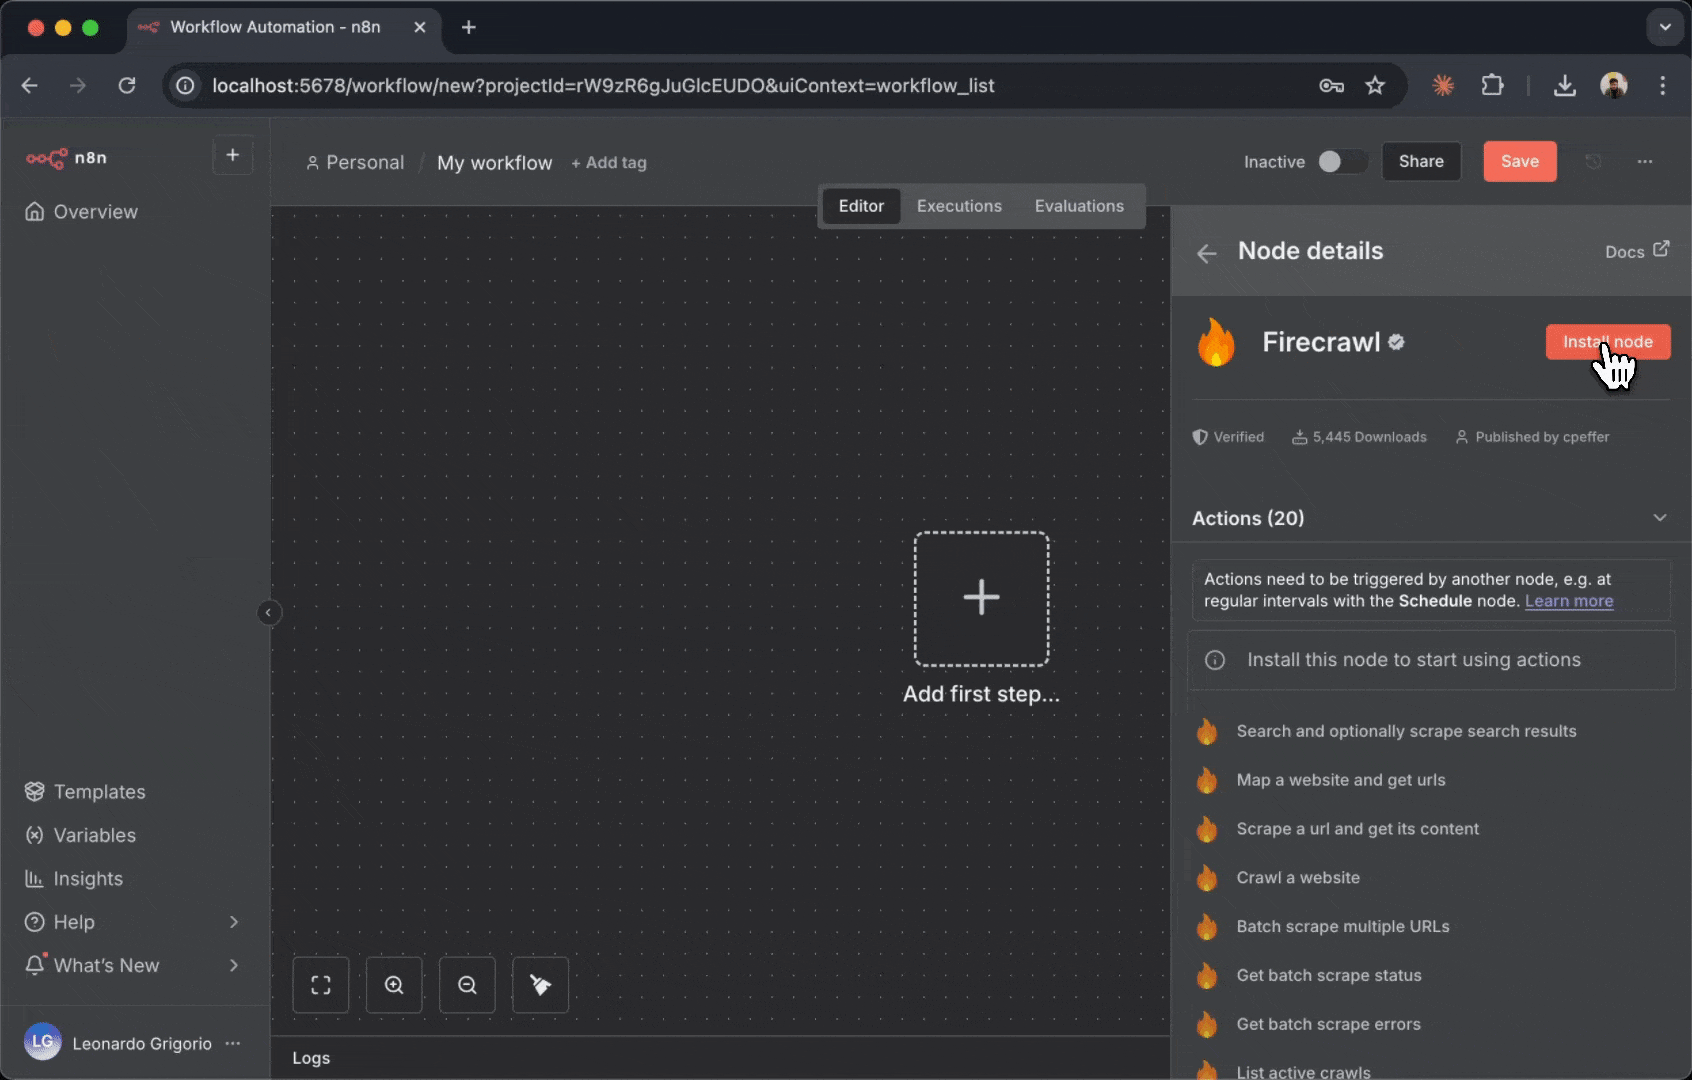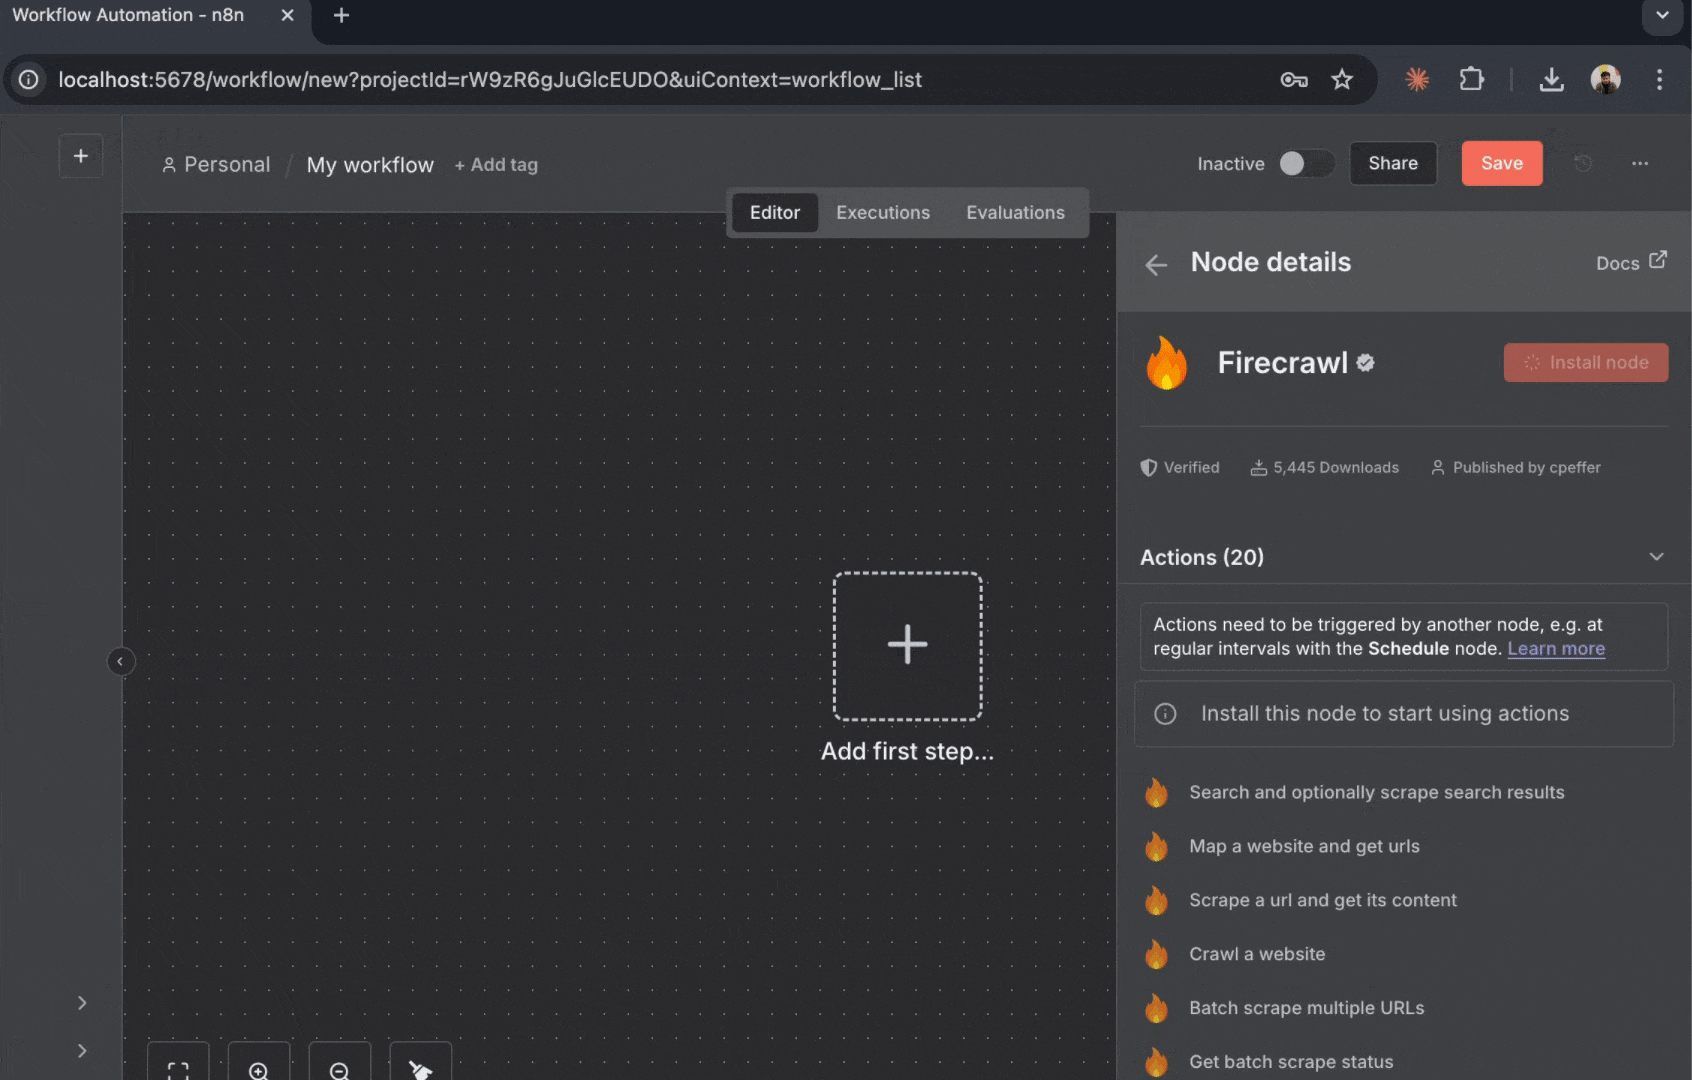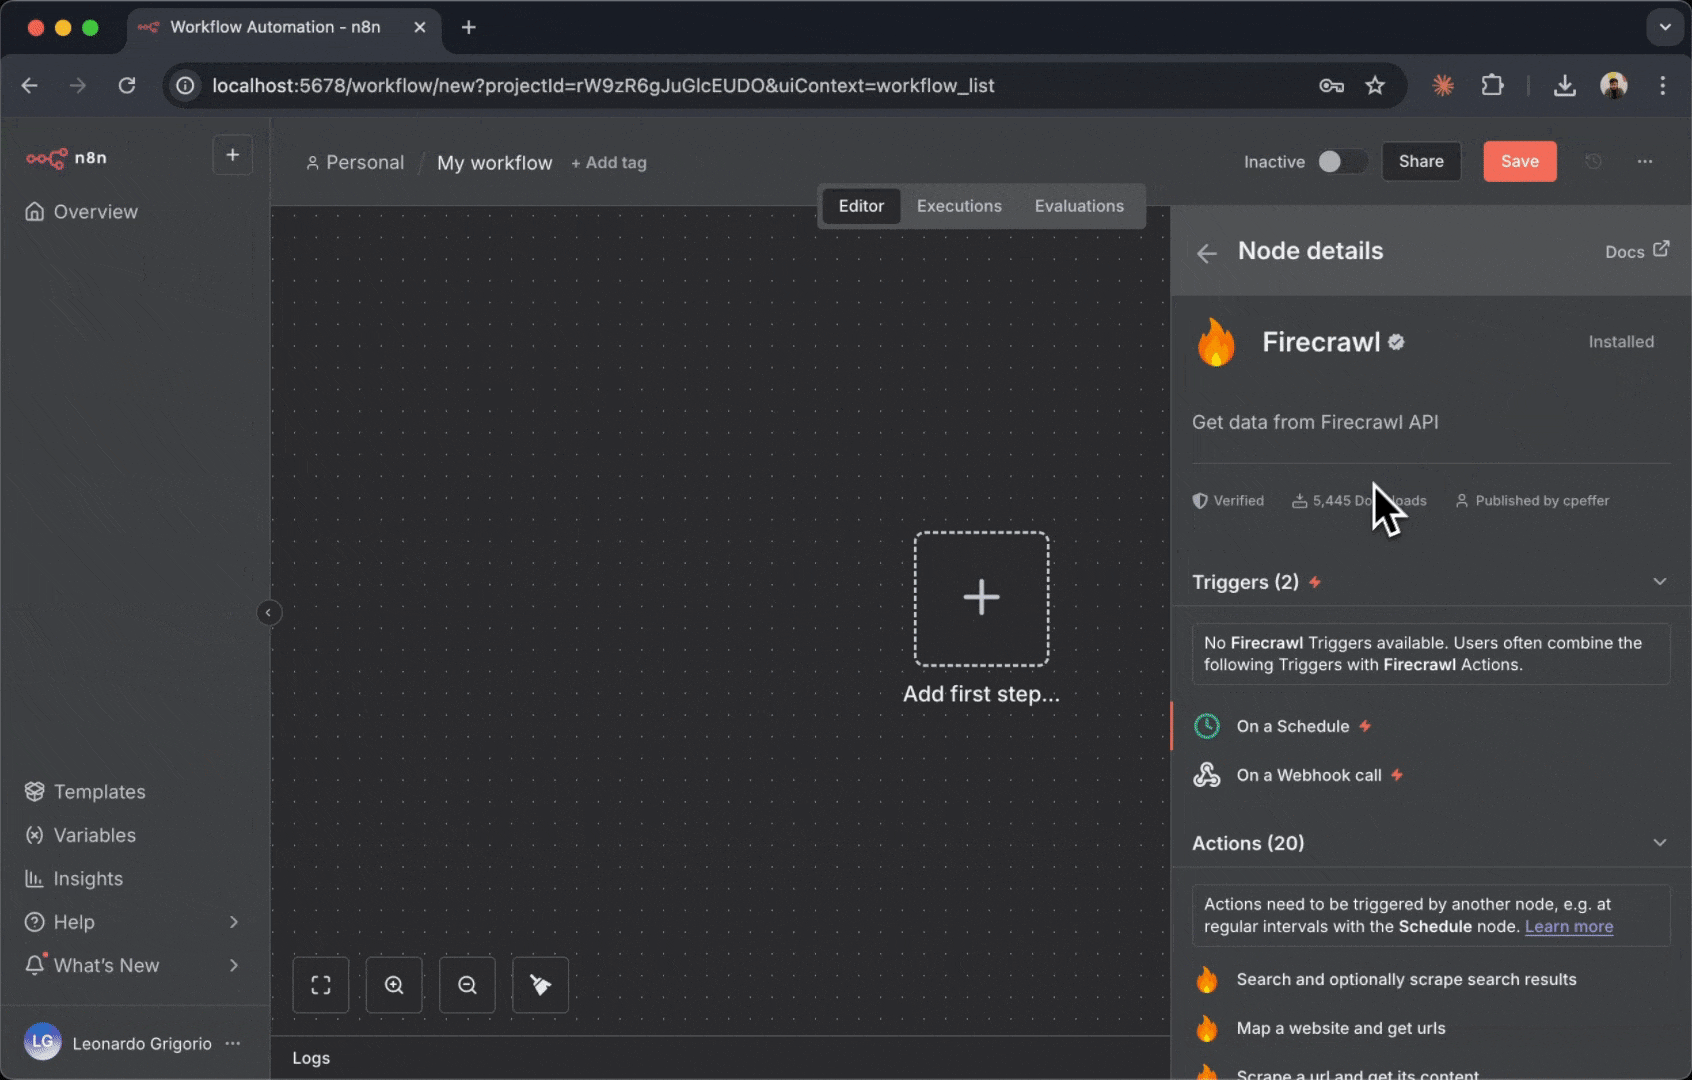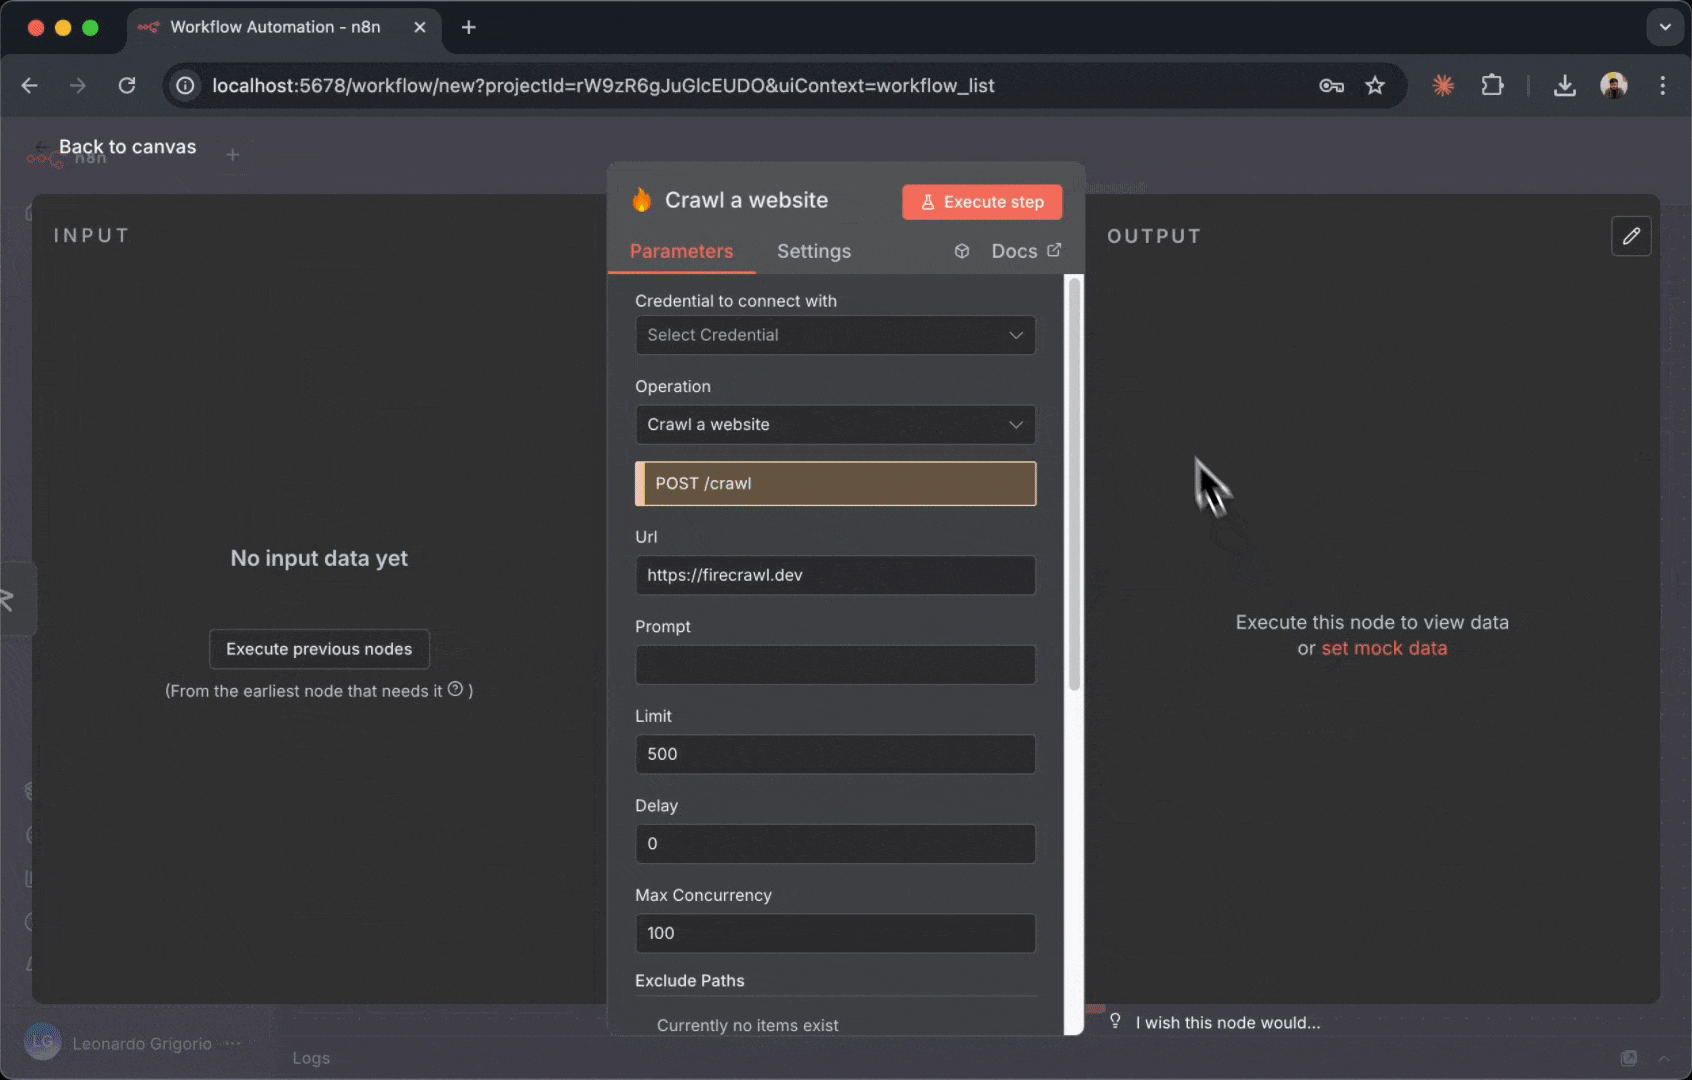
- Une fois l’installation terminée, cliquez sur le nœud Firecrawl pour l’ajouter à votre canevas
Connectez votre clé API Firecrawl
Avant de pouvoir utiliser le nœud Firecrawl, vous devez l’authentifier avec votre clé API :- Cliquez sur le bloc du nœud Firecrawl pour ouvrir son panneau de configuration à droite.
- En haut, vous verrez la liste déroulante « Credential to connect with ».
- Comme il s’agit de votre première utilisation, cliquez sur « Create New Credential ».
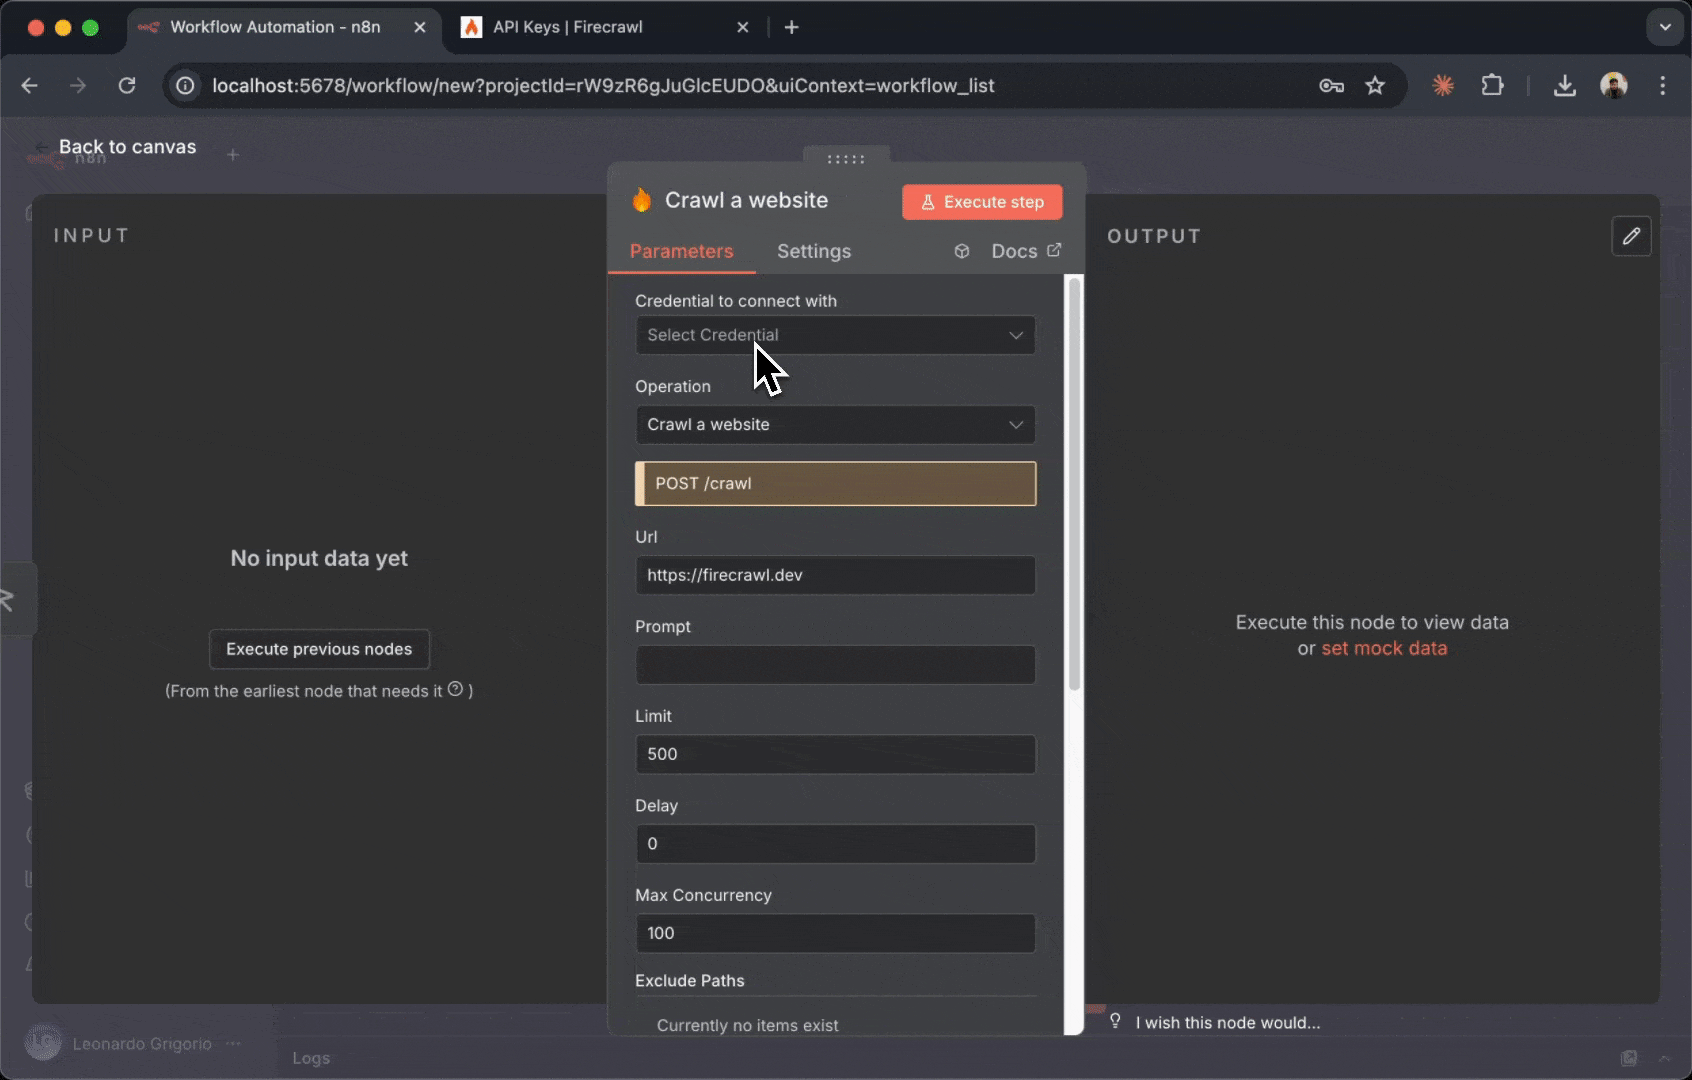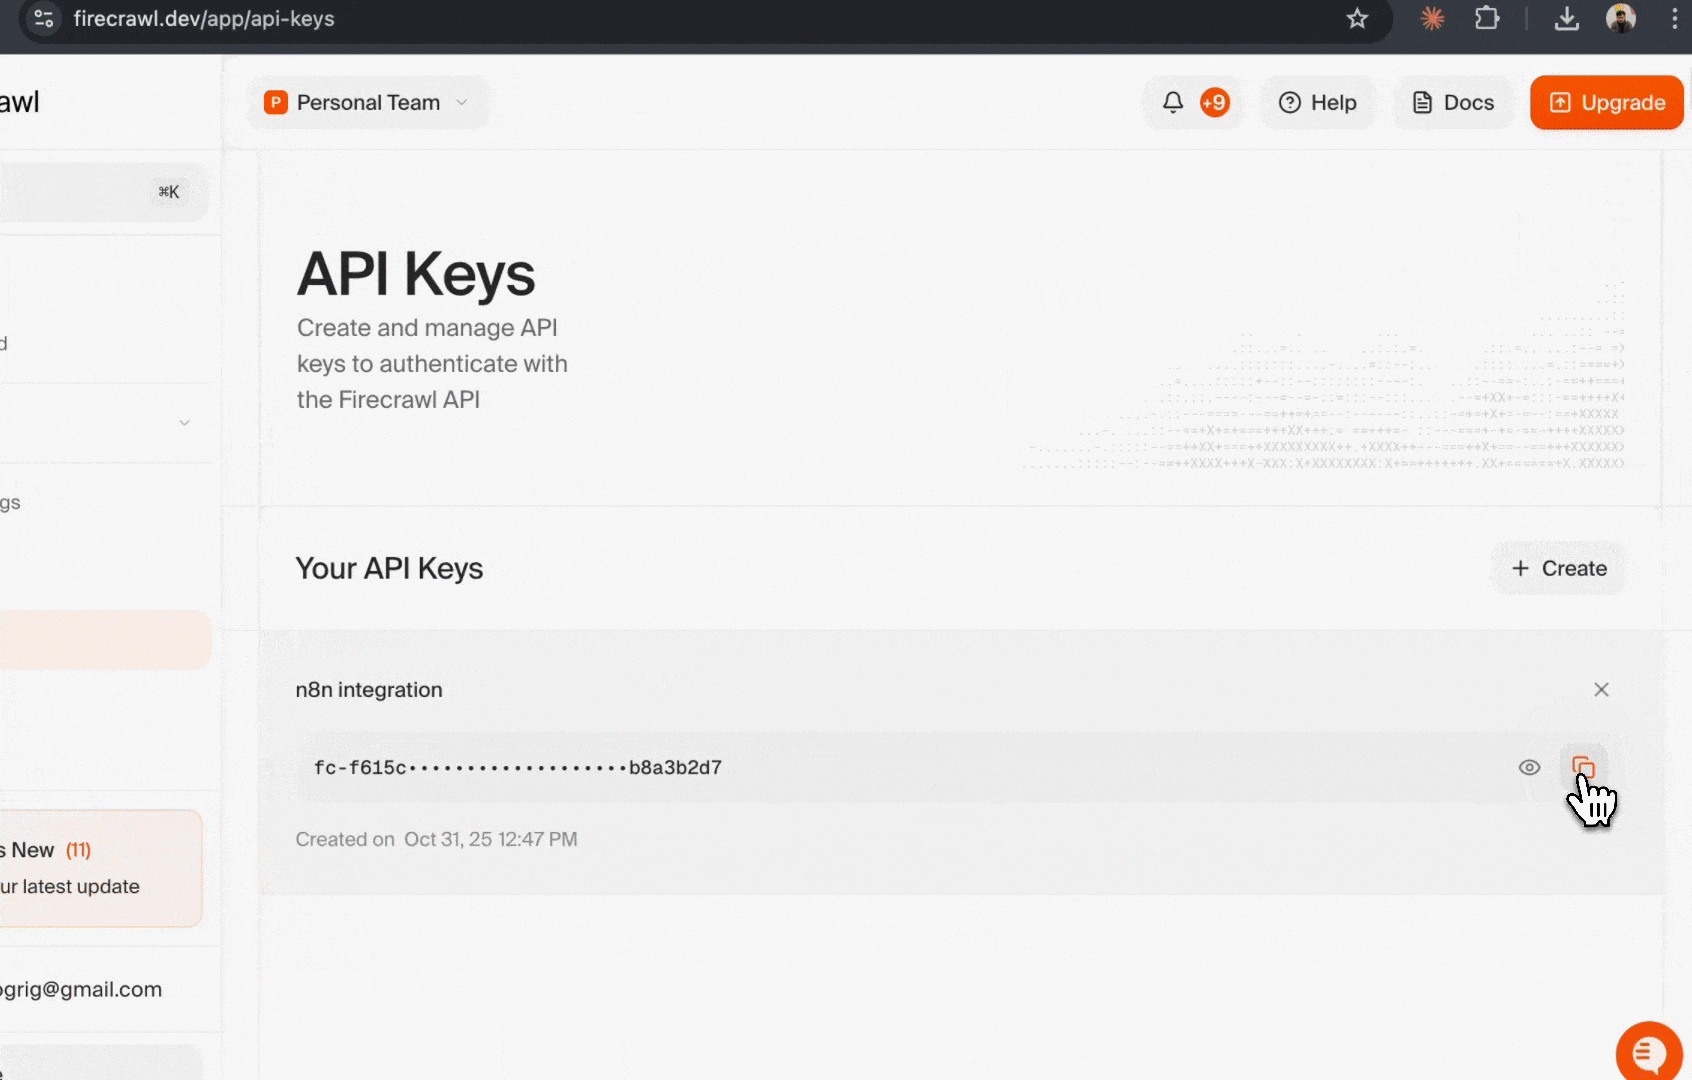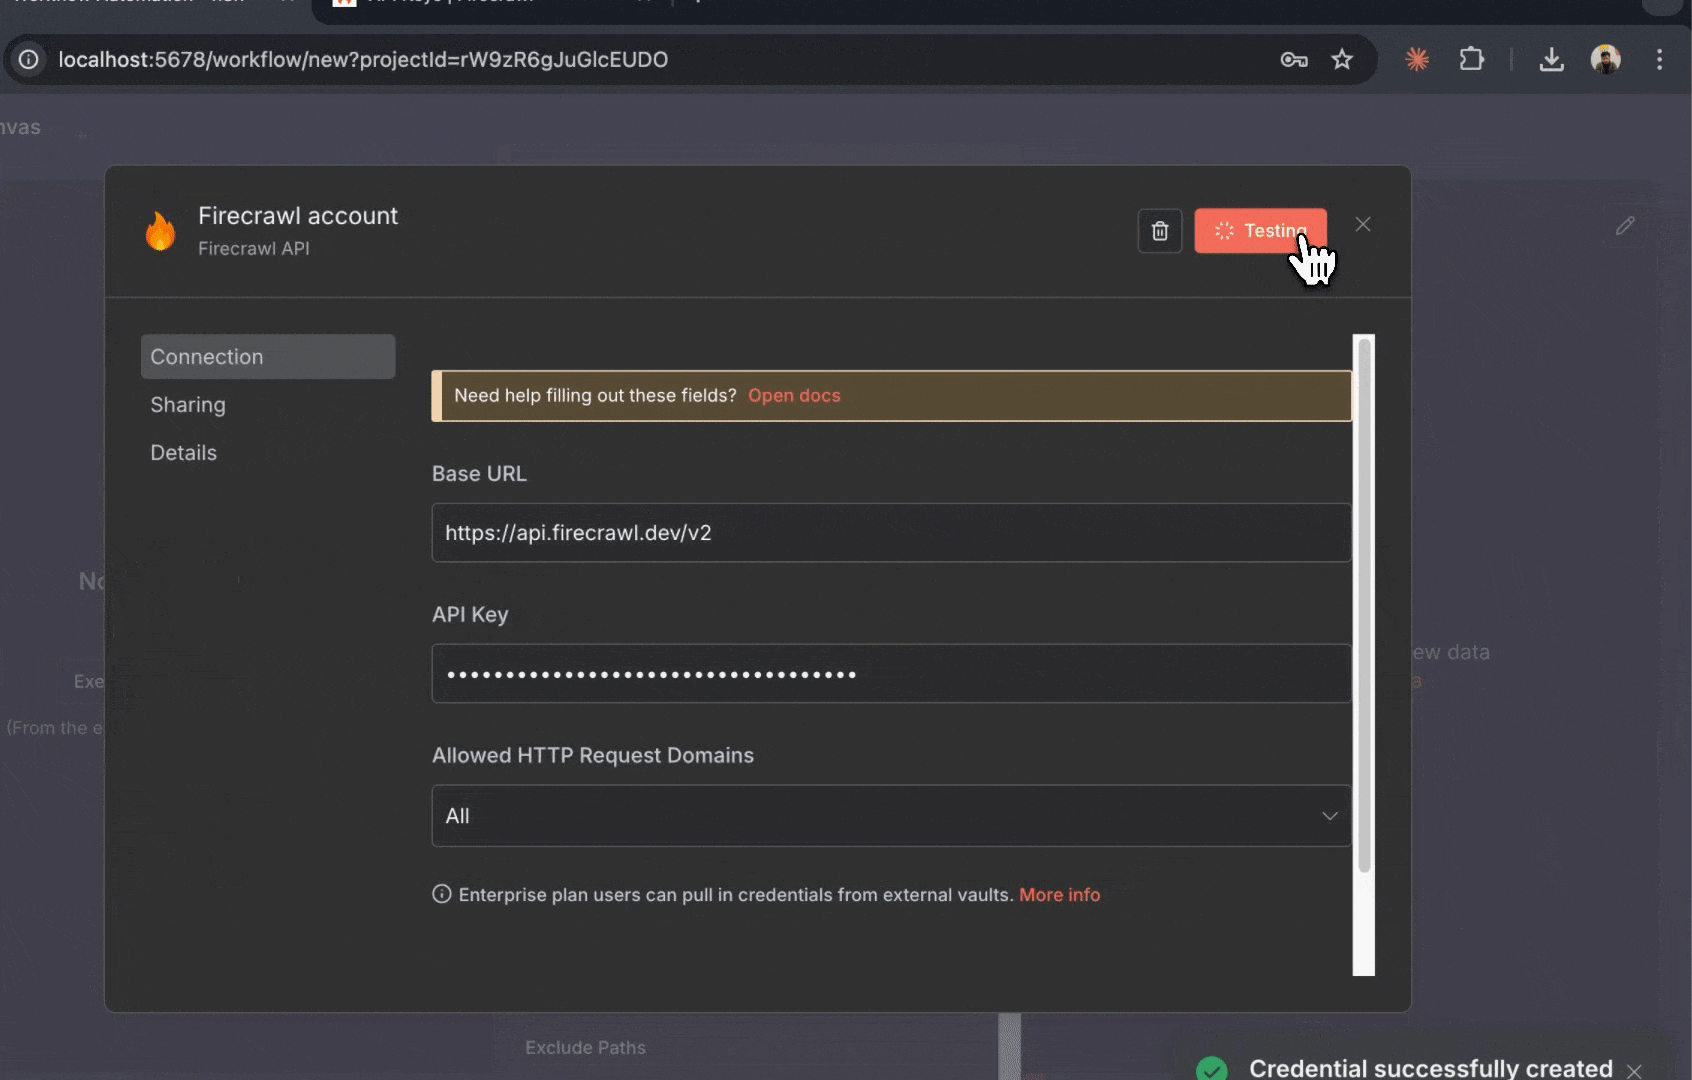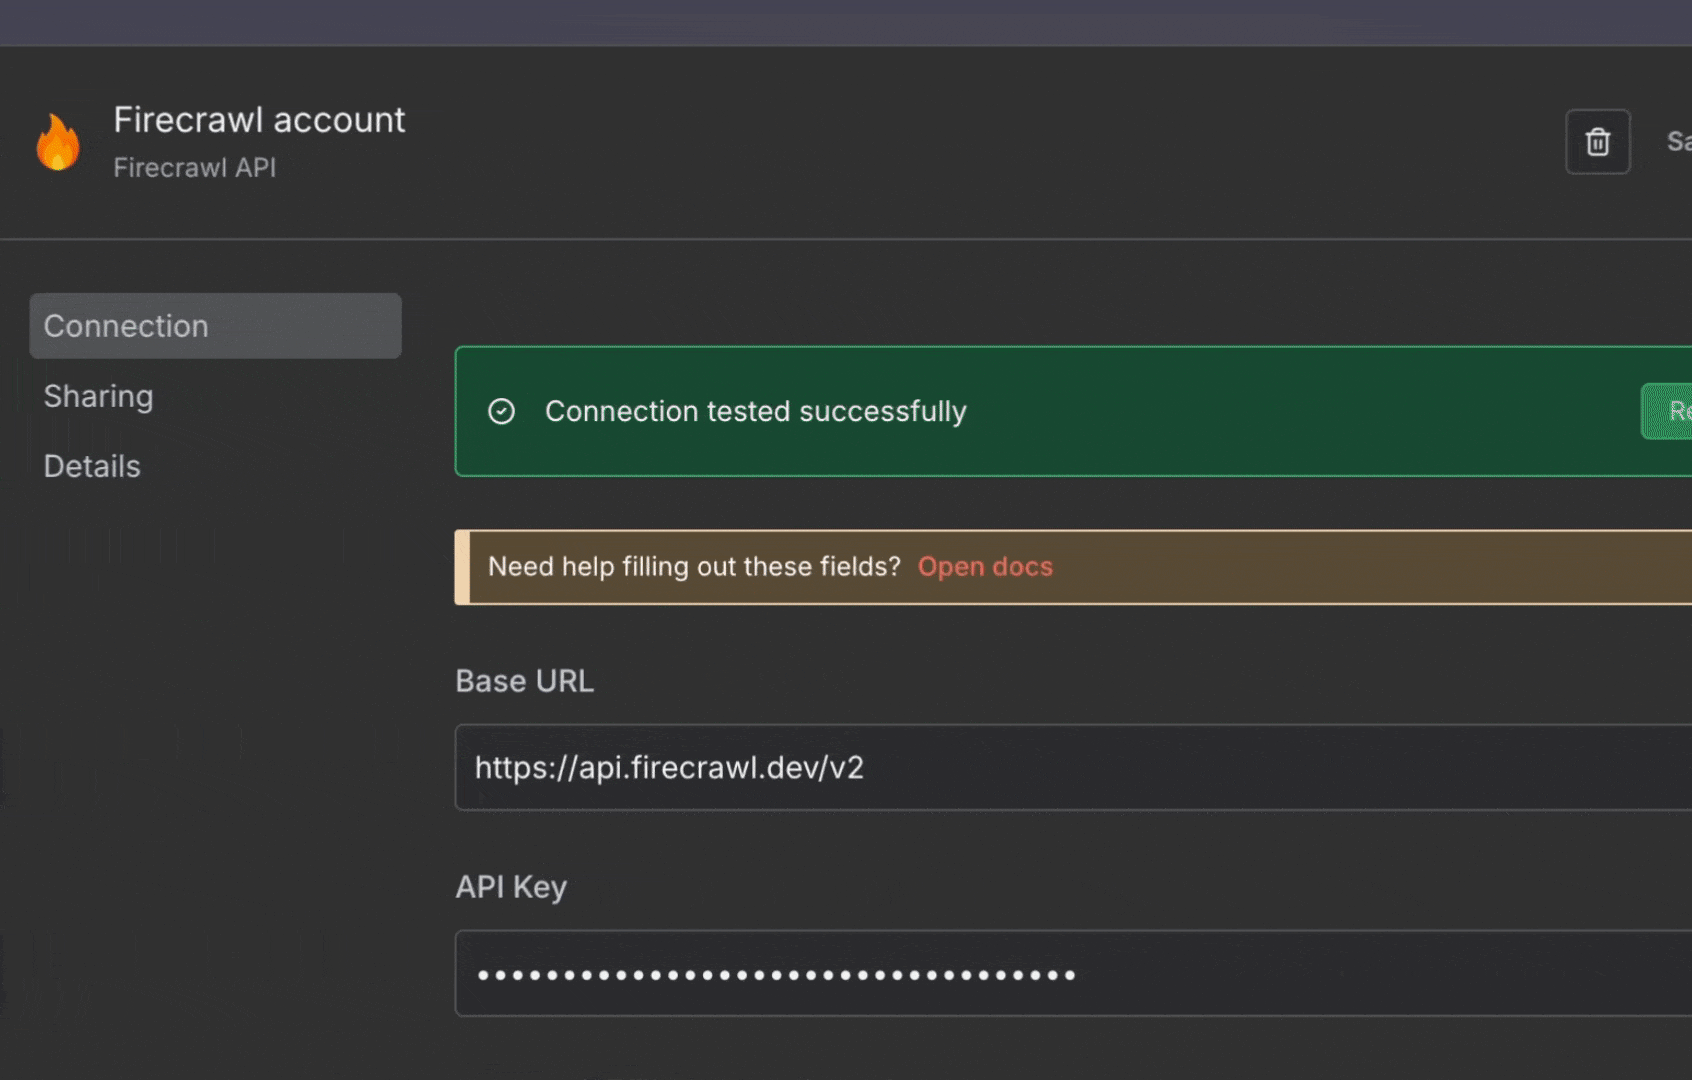
- Une fenêtre de configuration des identifiants s’ouvre.
- Saisissez un nom pour cet identifiant (par exemple, « Mon compte Firecrawl »).
- Collez votre clé API Firecrawl dans le champ « API Key ».
- Cliquez sur « Save » en bas.
L’identifiant comporte également un champ Base URL, dont la valeur par défaut est
https://api.firecrawl.dev/v2. Les identifiants créés avec d’anciennes versions du nœud peuvent encore pointer vers https://api.firecrawl.dev/v1. Avec une Base URL en v1, les opérations propres à la v2, comme Agent, Browser et Interact, échouent avec une erreur 404 (« The resource you are requesting could not be found »). Dans ce cas, ouvrez l’identifiant et définissez Base URL sur https://api.firecrawl.dev/v2.Testez votre connexion
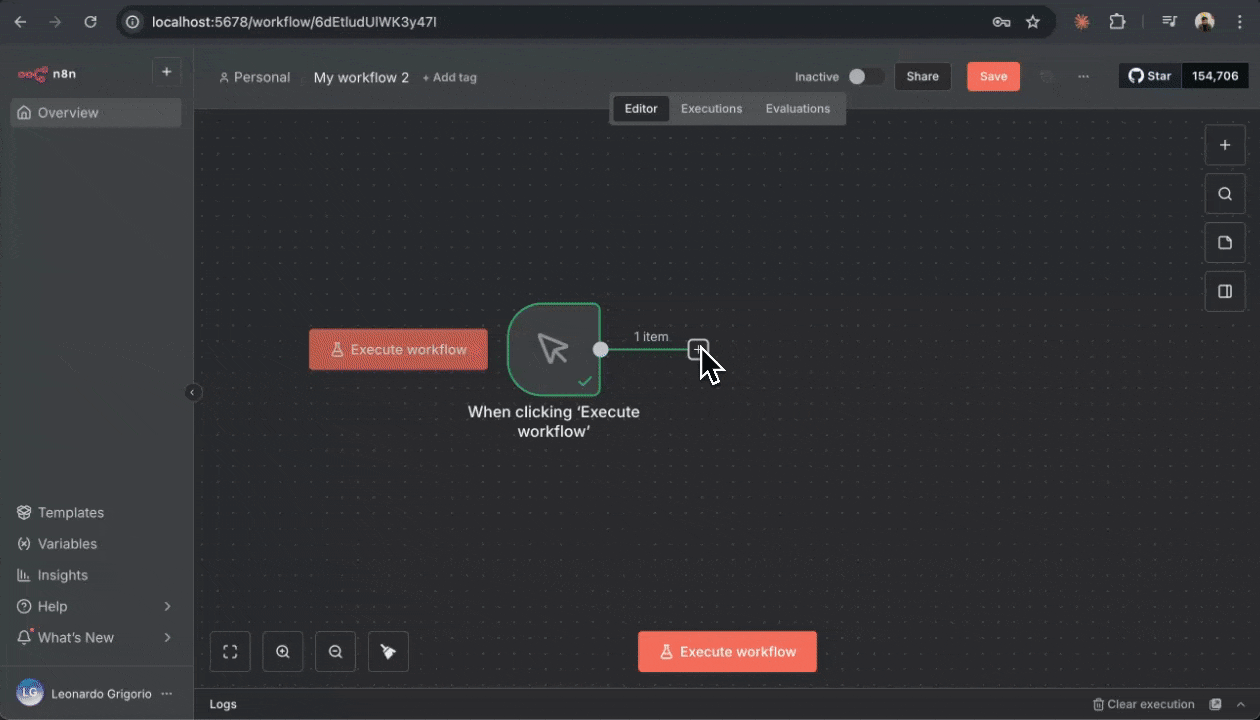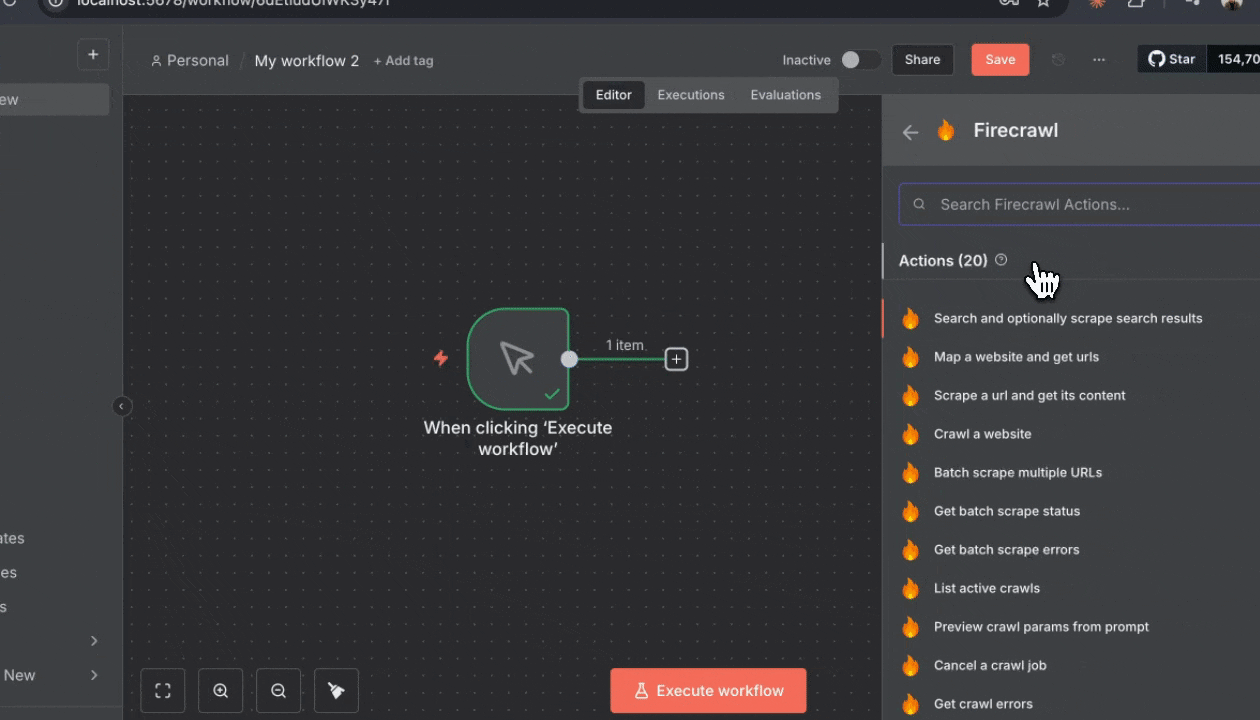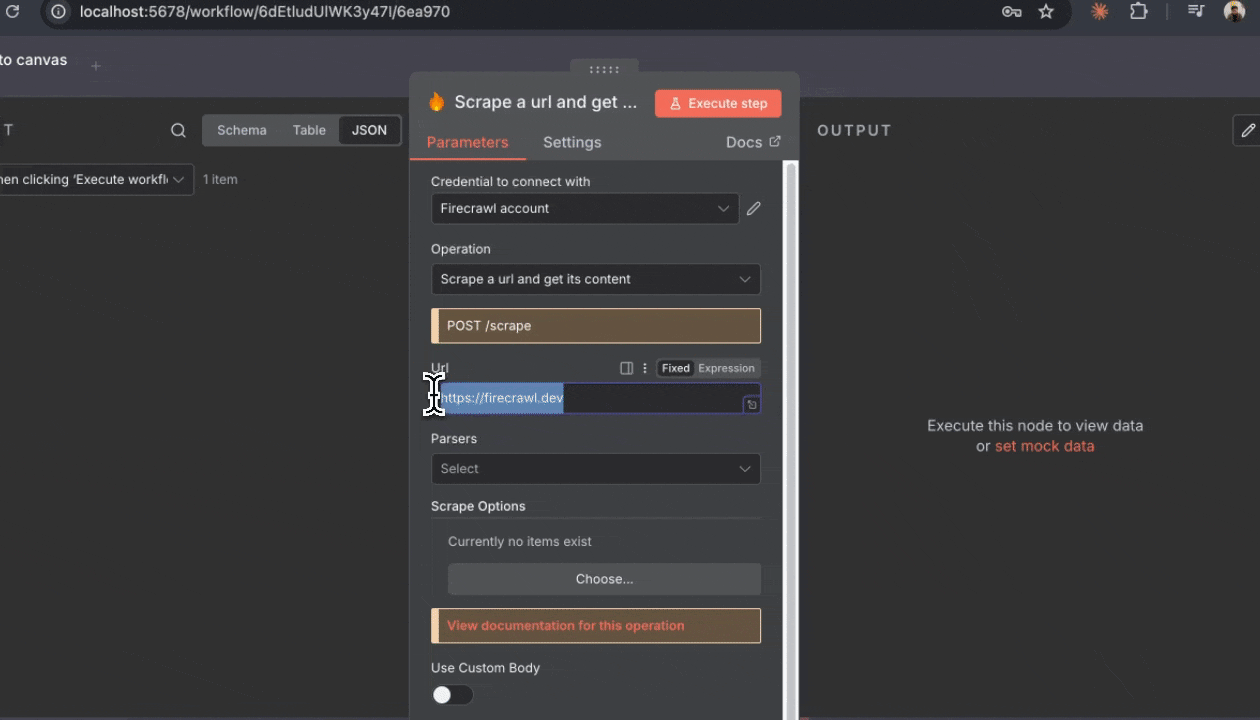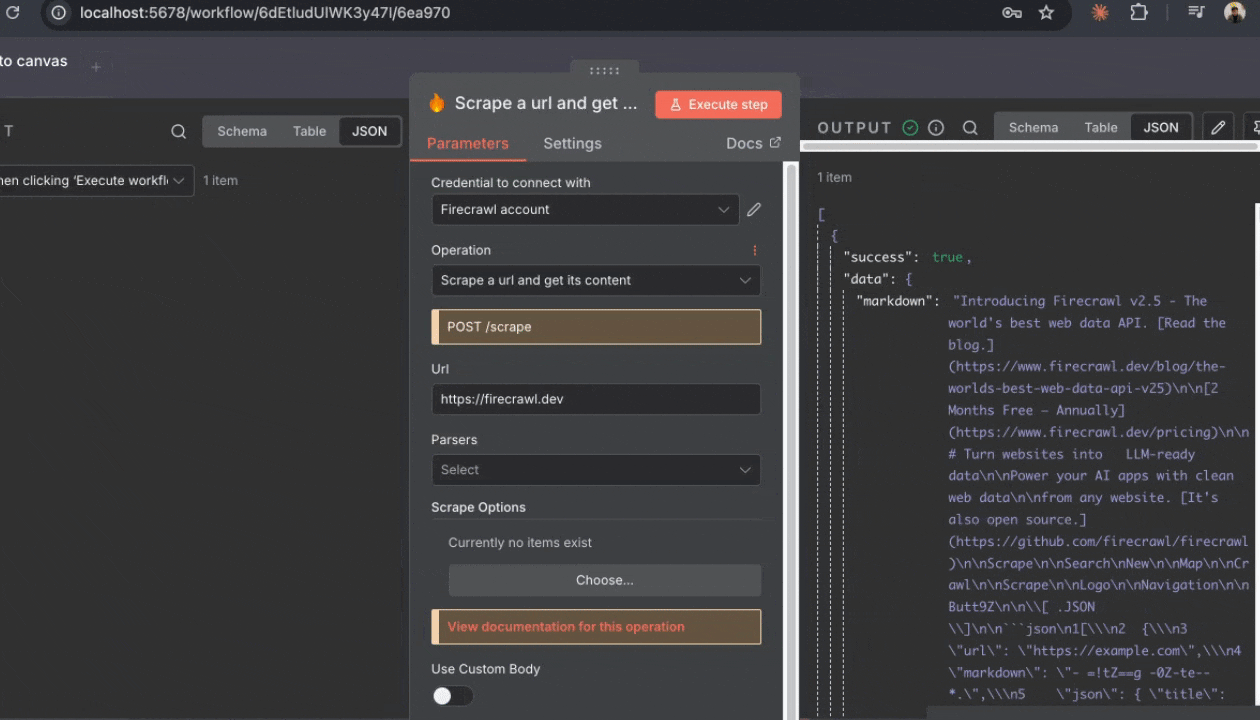
Vérifions que votre nœud Firecrawl est correctement connecté :- Le nœud Firecrawl étant toujours sélectionné, consultez le panneau de configuration.
- Définissez Resource sur « Scraping » et Operation sur « Scrape URL ».
- Dans le champ « URL », saisissez :
https://firecrawl.dev. - Laissez les autres paramètres sur leurs valeurs par défaut pour le moment.
- Cliquez sur le bouton « Execute step ».
Étape 4 : Créez votre bot Telegram
Avant de créer votre premier workflow, vous aurez besoin d’un bot Telegram pour recevoir des notifications. Les bots Telegram sont gratuits et faciles à créer via le BotFather de Telegram.Créer un bot avec BotFather
- Ouvrez Telegram sur votre téléphone ou votre ordinateur
- Recherchez “@BotFather” (le bot officiel de Telegram)
- Démarrez une conversation avec BotFather en cliquant sur “Start”
- Envoyez la commande
/newbotpour créer un nouveau bot - BotFather vous demandera de choisir un nom pour votre bot (il s’agit du nom d’affichage que les utilisateurs verront)
- Saisissez un nom tel que “Mon bot Firecrawl”
- Choisissez ensuite un nom d’utilisateur pour votre bot. Il doit se terminer par « bot » (par exemple, “my_firecrawl_updates_bot”)
- Si le nom d’utilisateur est disponible, BotFather créera votre bot et vous enverra un message contenant son jeton
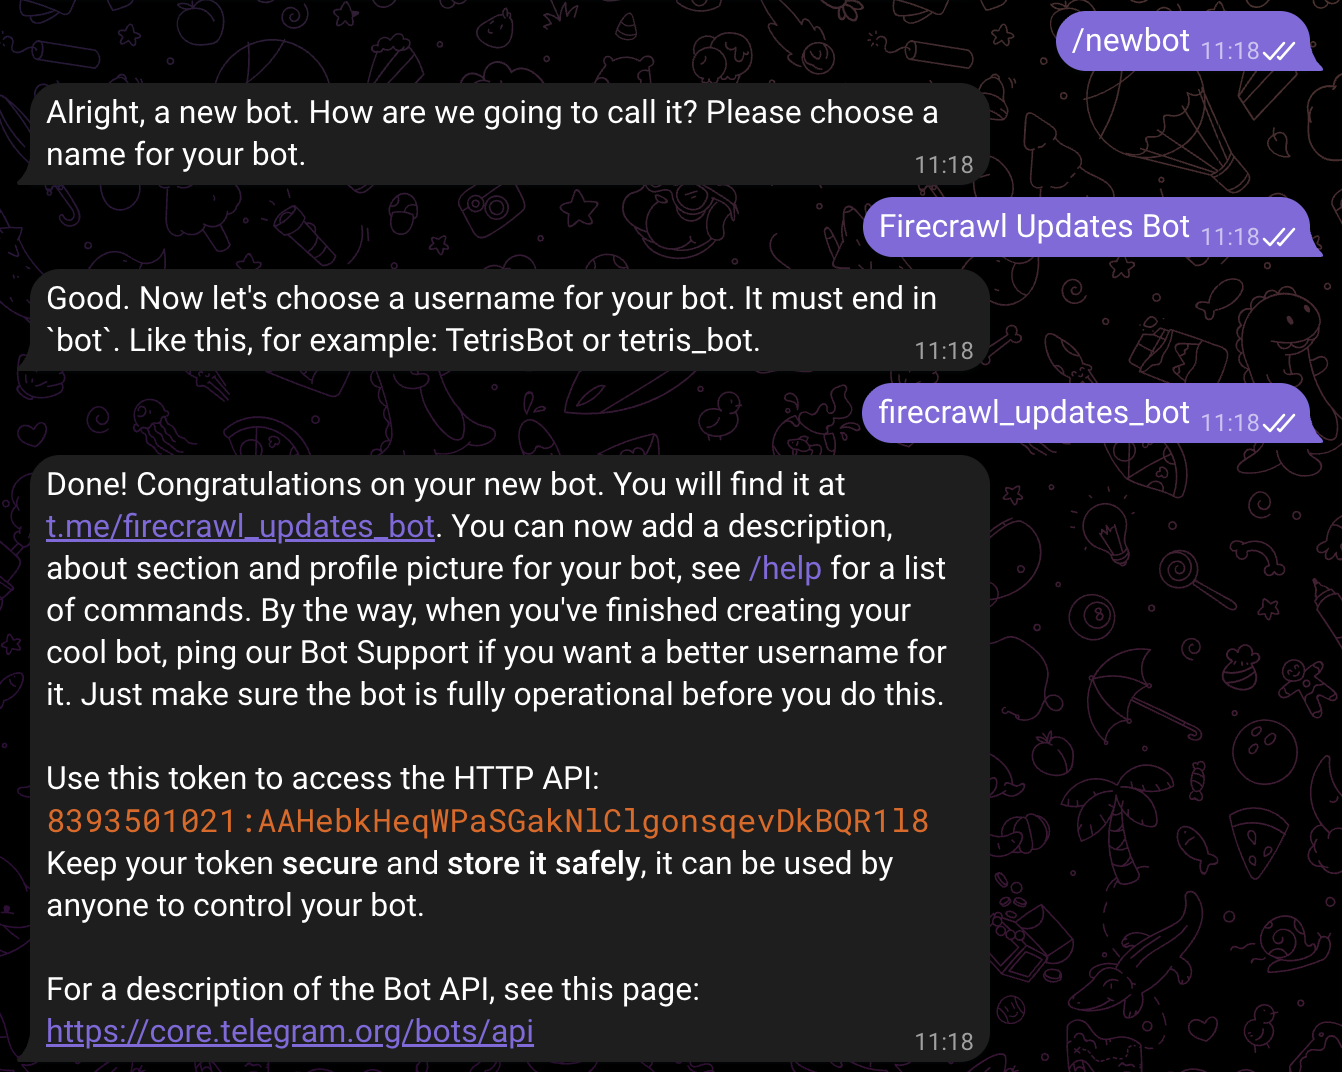
Conservez le jeton de votre bot en lieu sûr. Ce jeton est comme un mot de passe qui permet à n8n d’envoyer des messages au nom de votre bot. Ne le partagez jamais publiquement.
Obtenir votre ID de chat
Pour vous envoyer des messages, vous avez besoin de votre ID de chat Telegram :- Ouvrez votre navigateur web et accédez à cette URL (remplacez
YOUR_BOT_TOKENpar le jeton réel de votre bot) : - Gardez cet onglet ouvert
- Recherchez maintenant le nom d’utilisateur de votre bot dans Telegram (celui que vous venez de créer)
- Démarrez une conversation avec votre bot en cliquant sur « Start »
- Envoyez un message quelconque à votre bot (par exemple, « bonjour »)
- Revenez à l’onglet du navigateur et actualisez la page
- Recherchez le champ
"chat":{"id":dans la réponse JSON - Le nombre à côté de
"id":est votre ID de chat (par exemple,123456789) - Conservez cet ID de chat pour plus tard
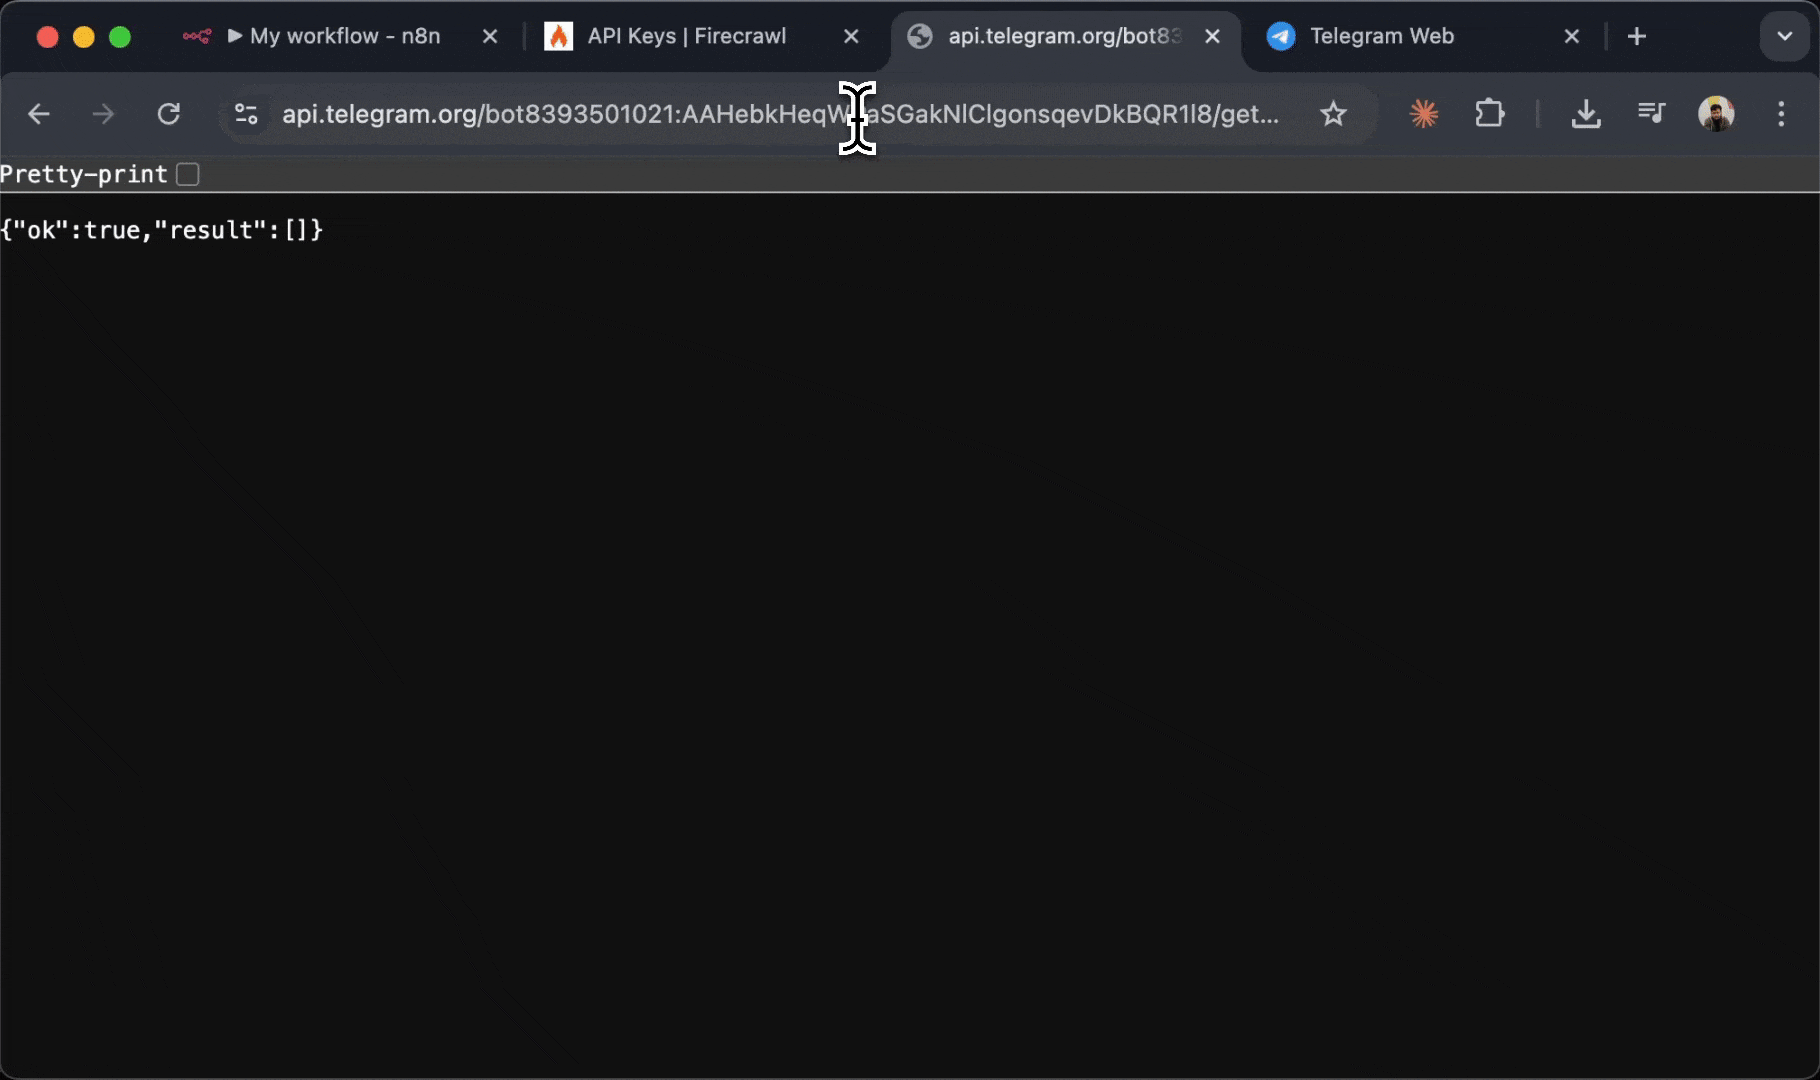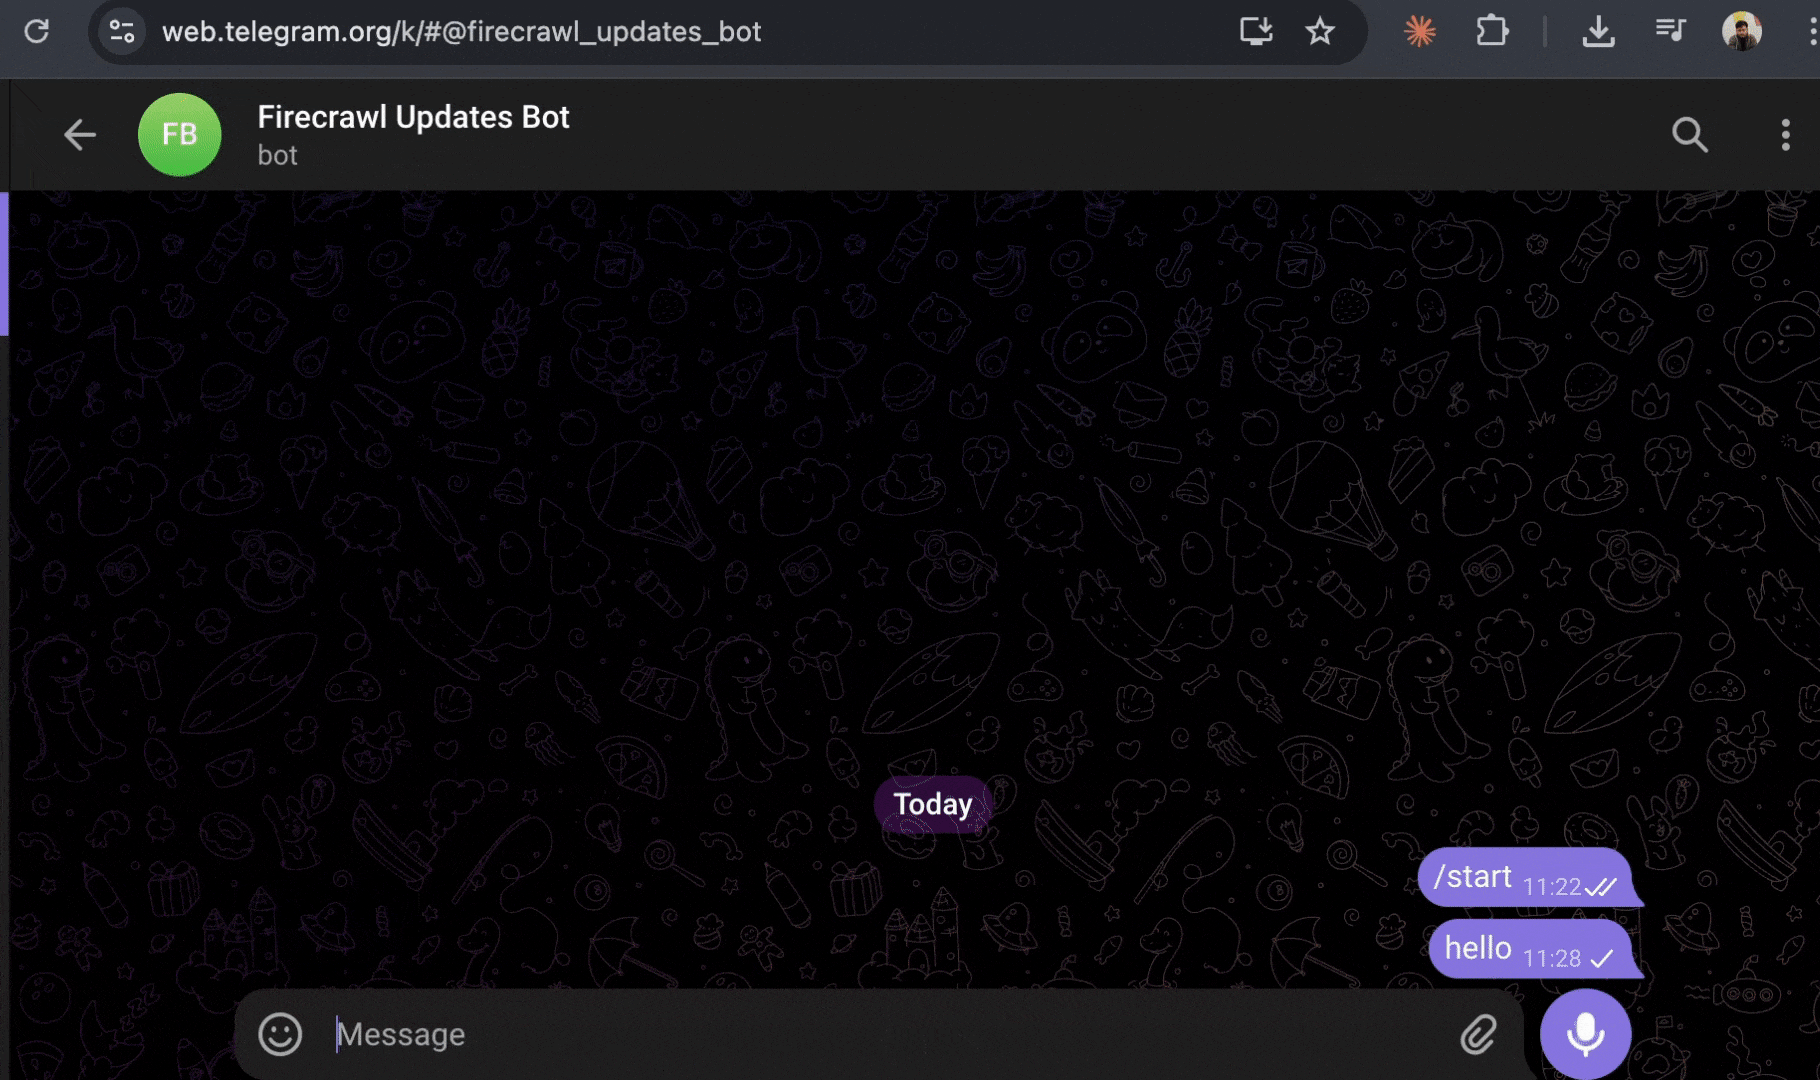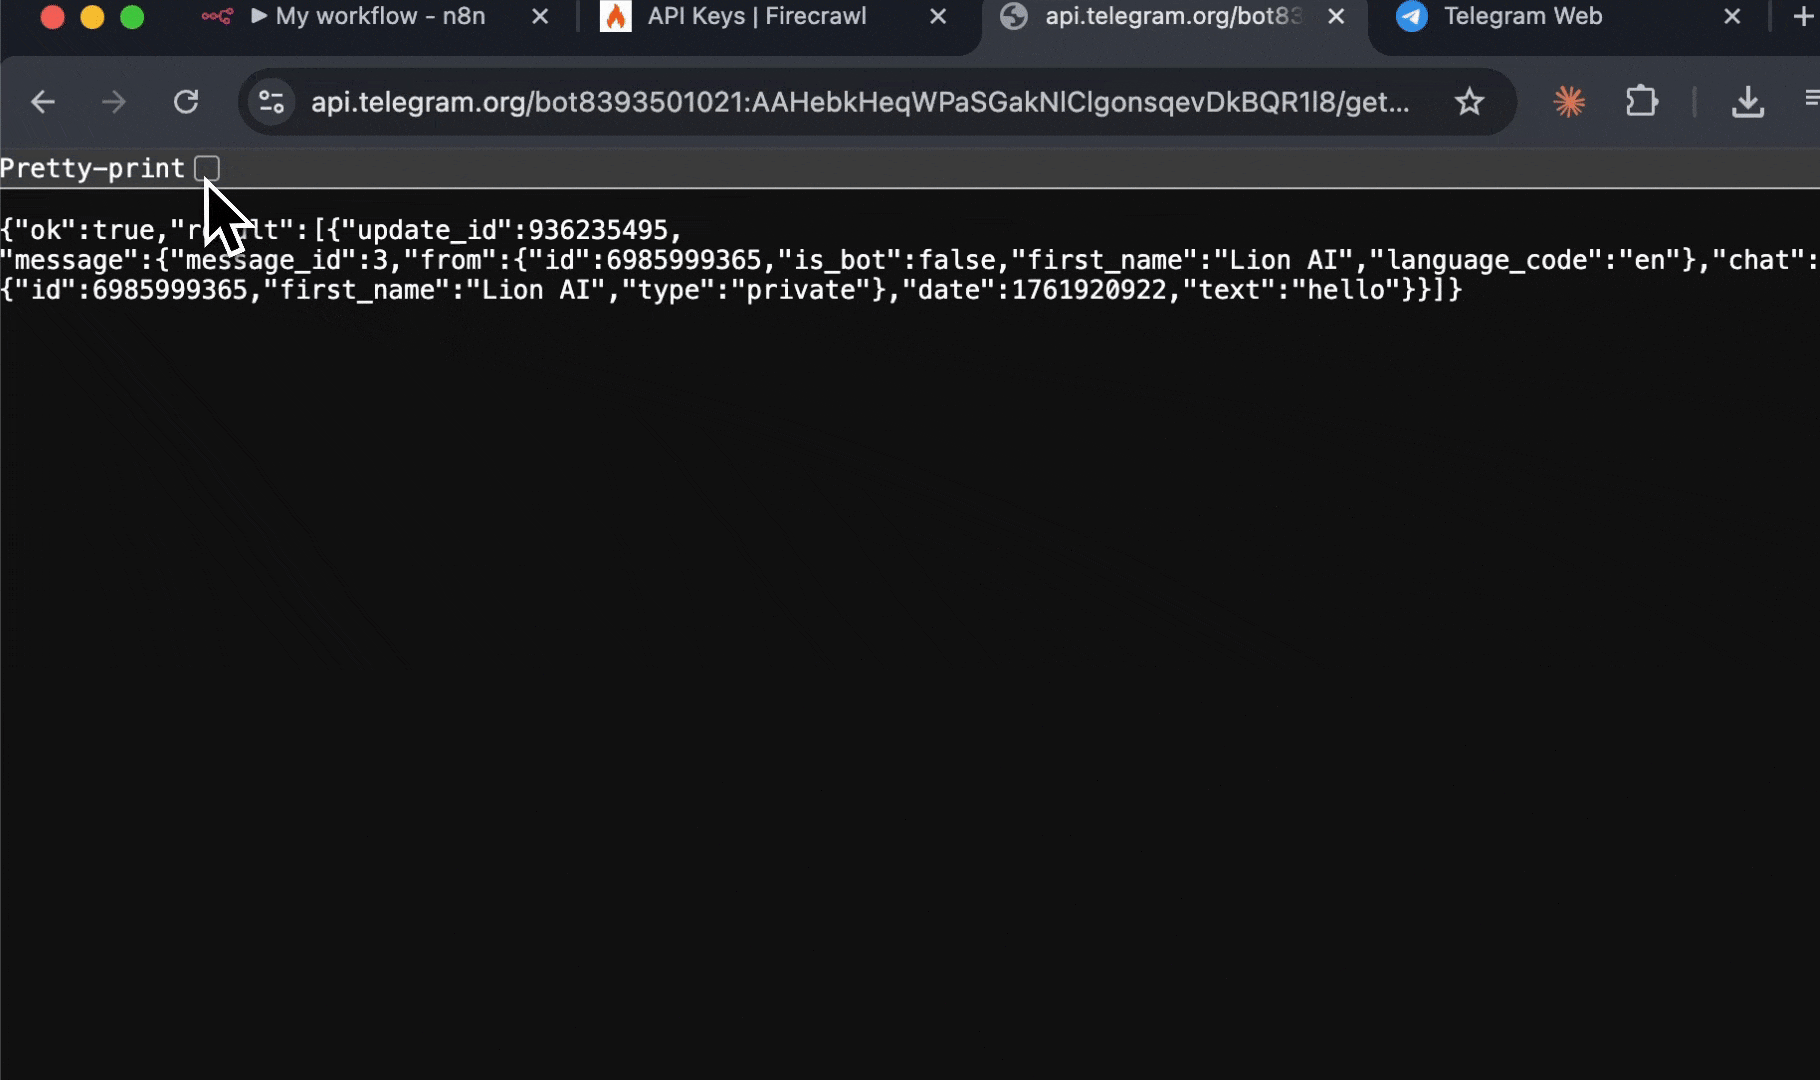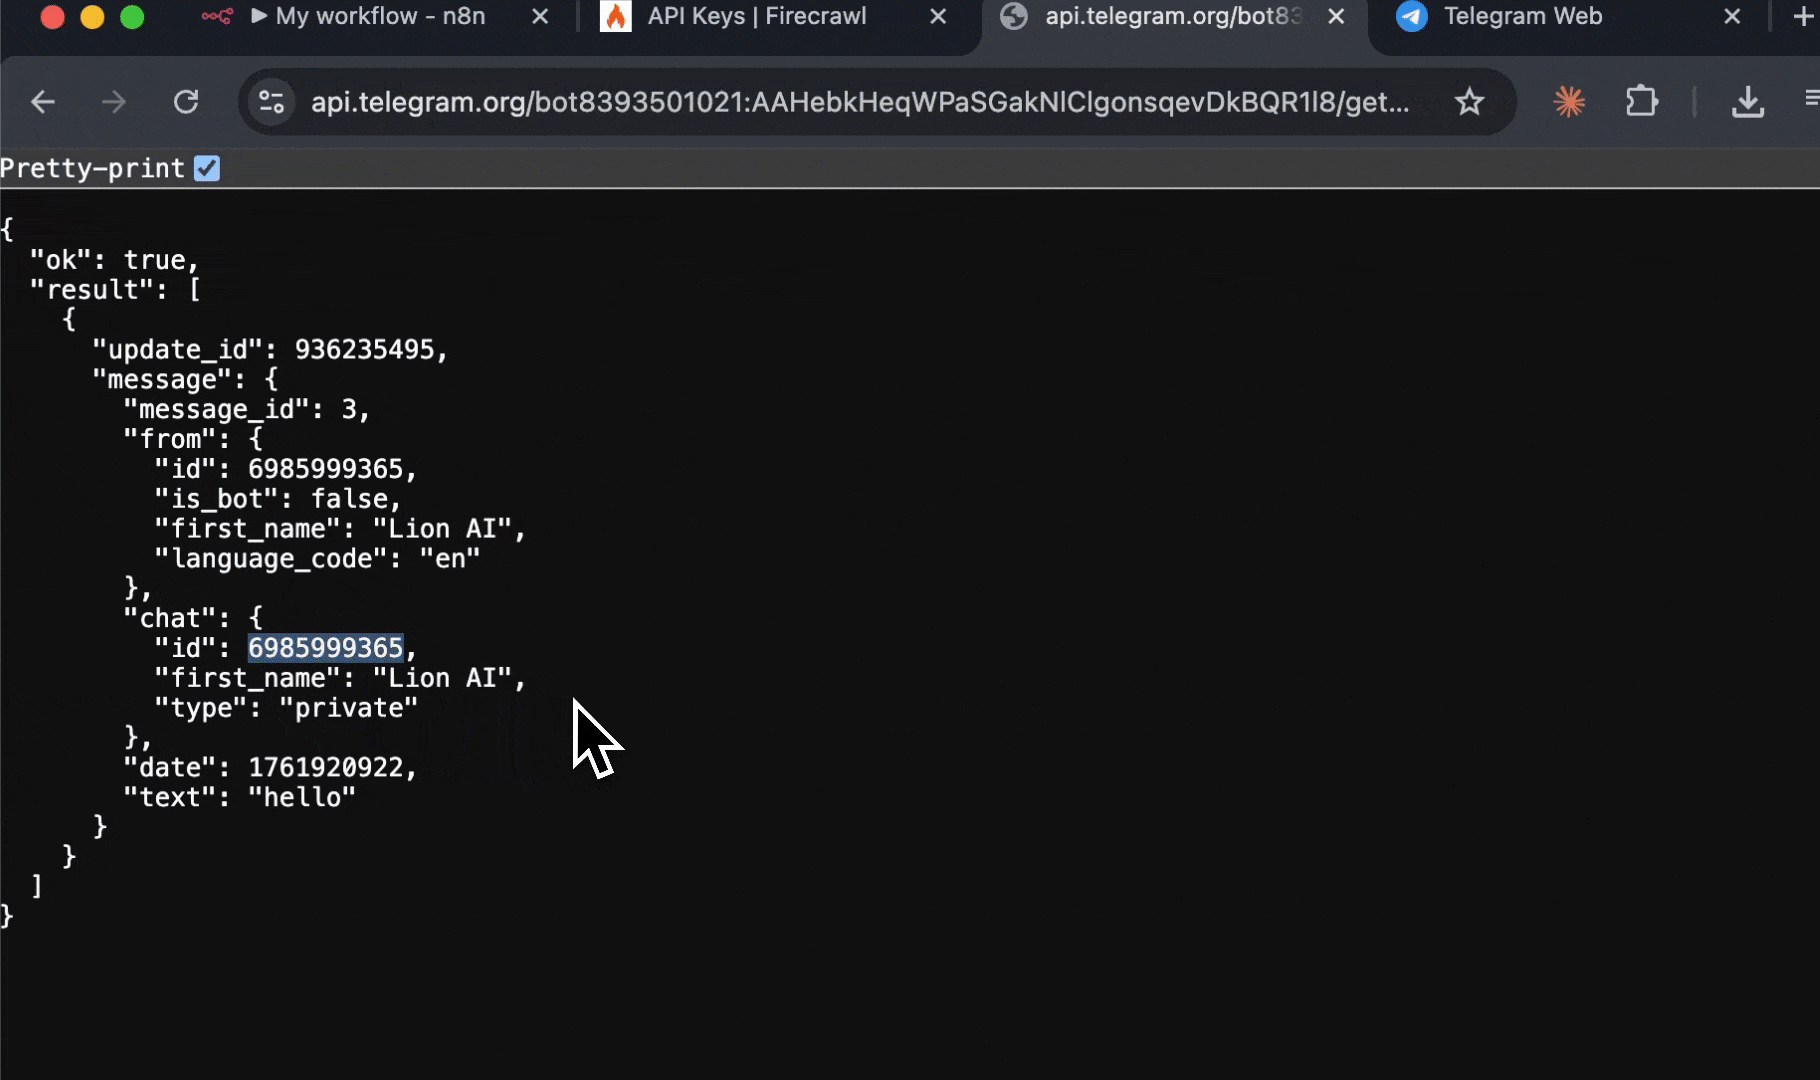
Votre ID de chat est l’identifiant unique de votre conversation avec le bot. Vous l’utiliserez pour indiquer à n8n où envoyer les messages.
Étape 5 : Créer des workflows pratiques avec Telegram
Créons maintenant trois workflows concrets qui envoient des informations directement sur Telegram. Ces exemples présentent différentes opérations Firecrawl et montrent comment les intégrer aux notifications Telegram.Exemple 1 : résumé quotidien des mises à jour de Firecrawl
Recevez chaque matin sur Telegram un résumé des mises à jour de Firecrawl. Ce que vous allez créer :- Extrait chaque jour à 9 h les articles du blog de Firecrawl consacrés aux mises à jour produit
- Utilise l’IA pour générer un résumé du contenu
- Envoie le résumé sur Telegram
- Créez un nouveau workflow dans n8n
- Ajoutez un nœud Déclencheur planifié :
- Cliquez sur le bouton ”+” sur le canevas
- Recherchez “Déclencheur planifié”
- Configurez : tous les jours à 9 h 00
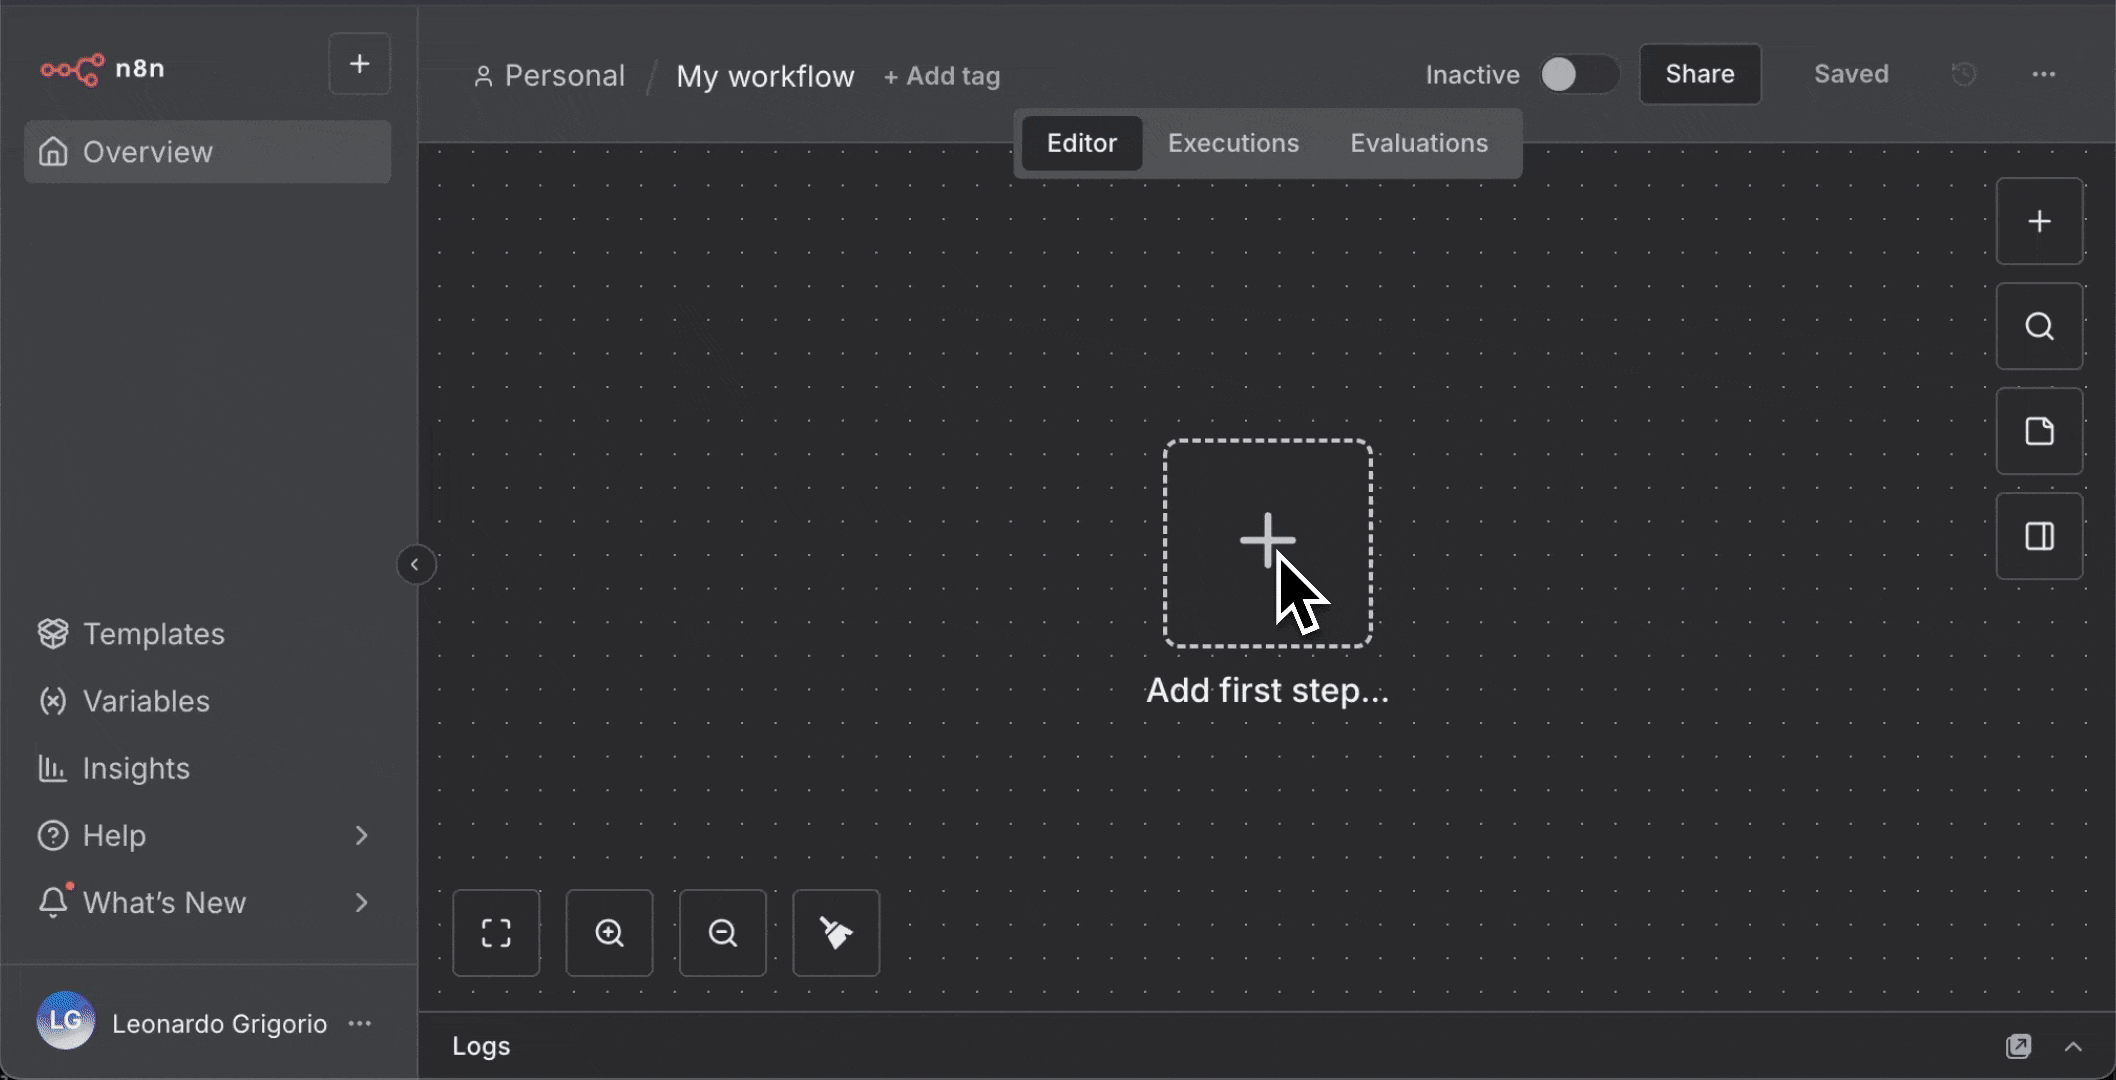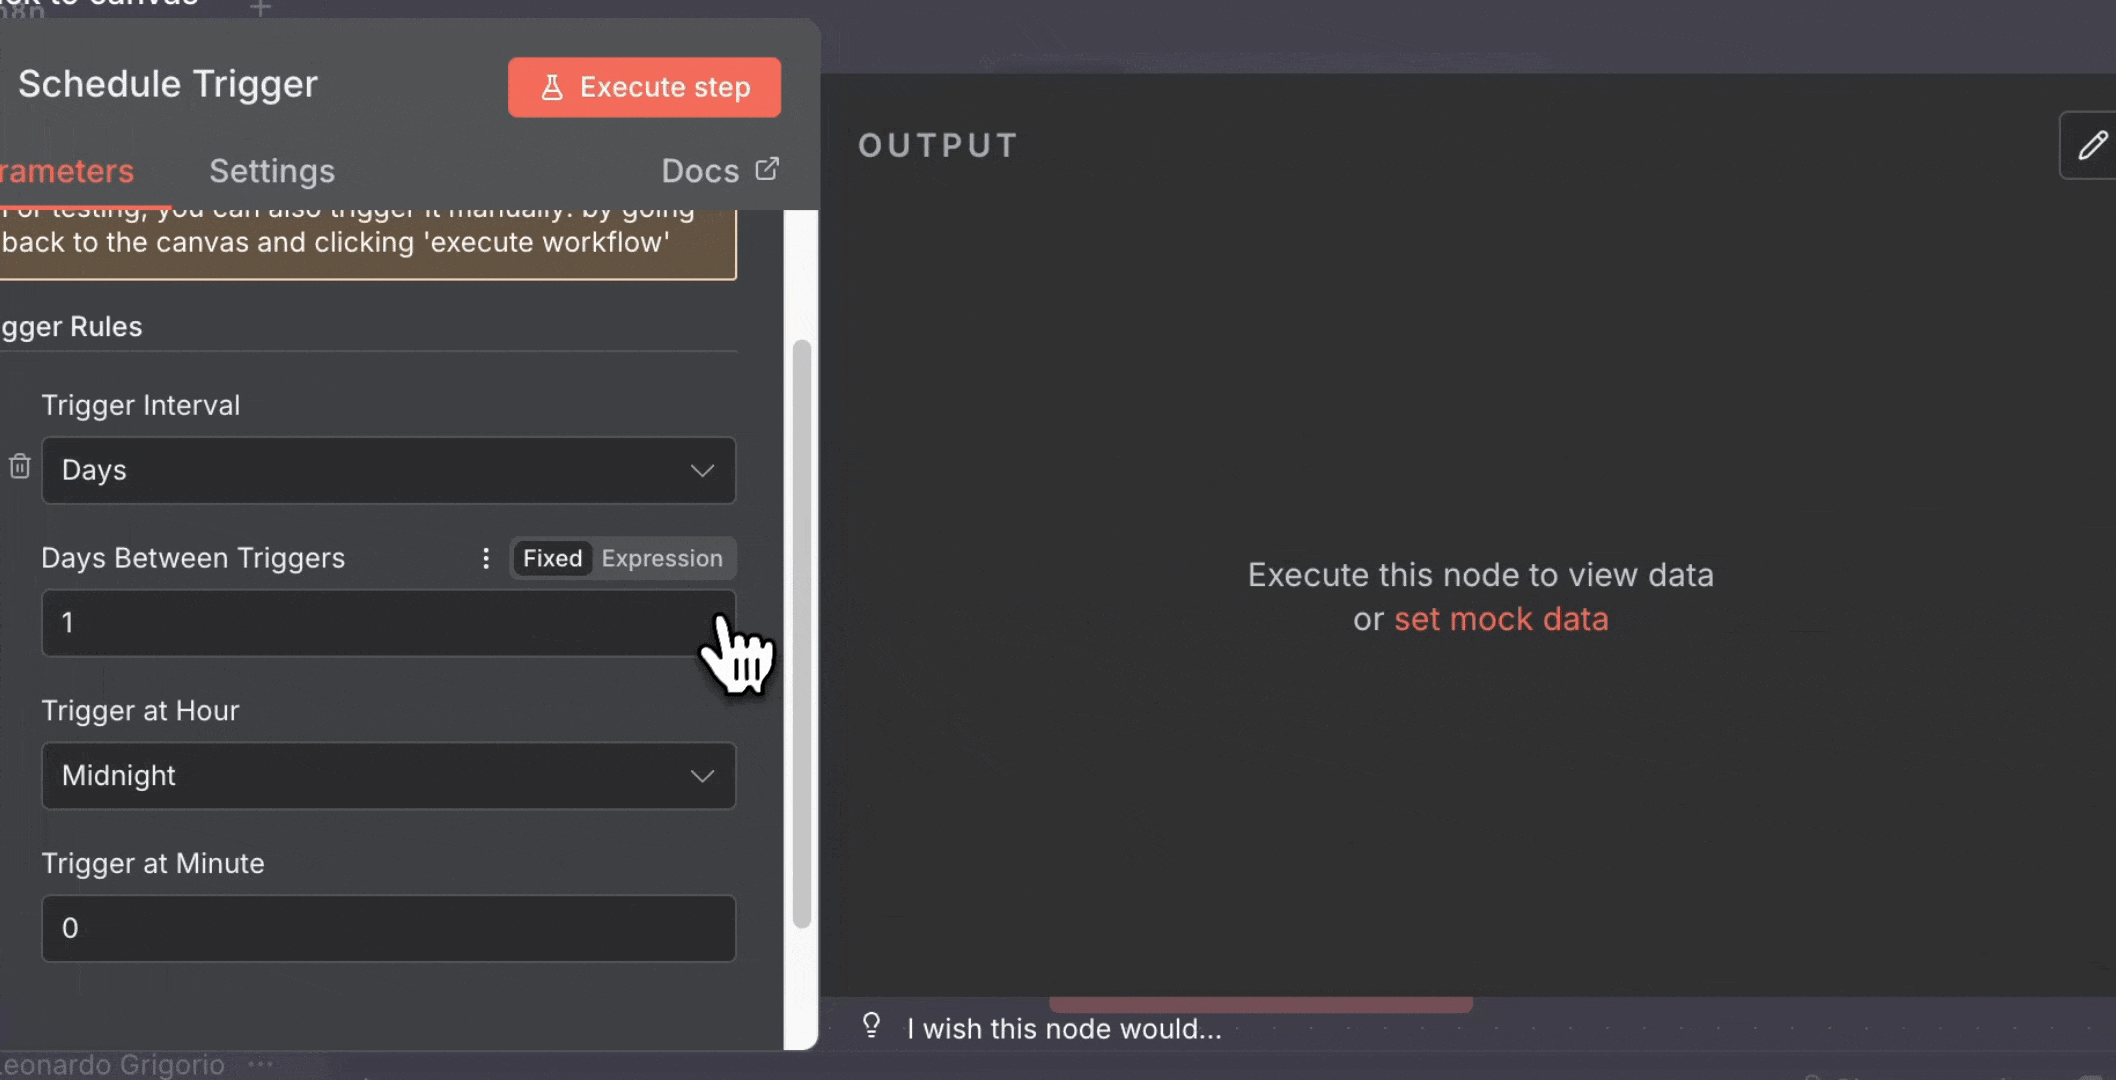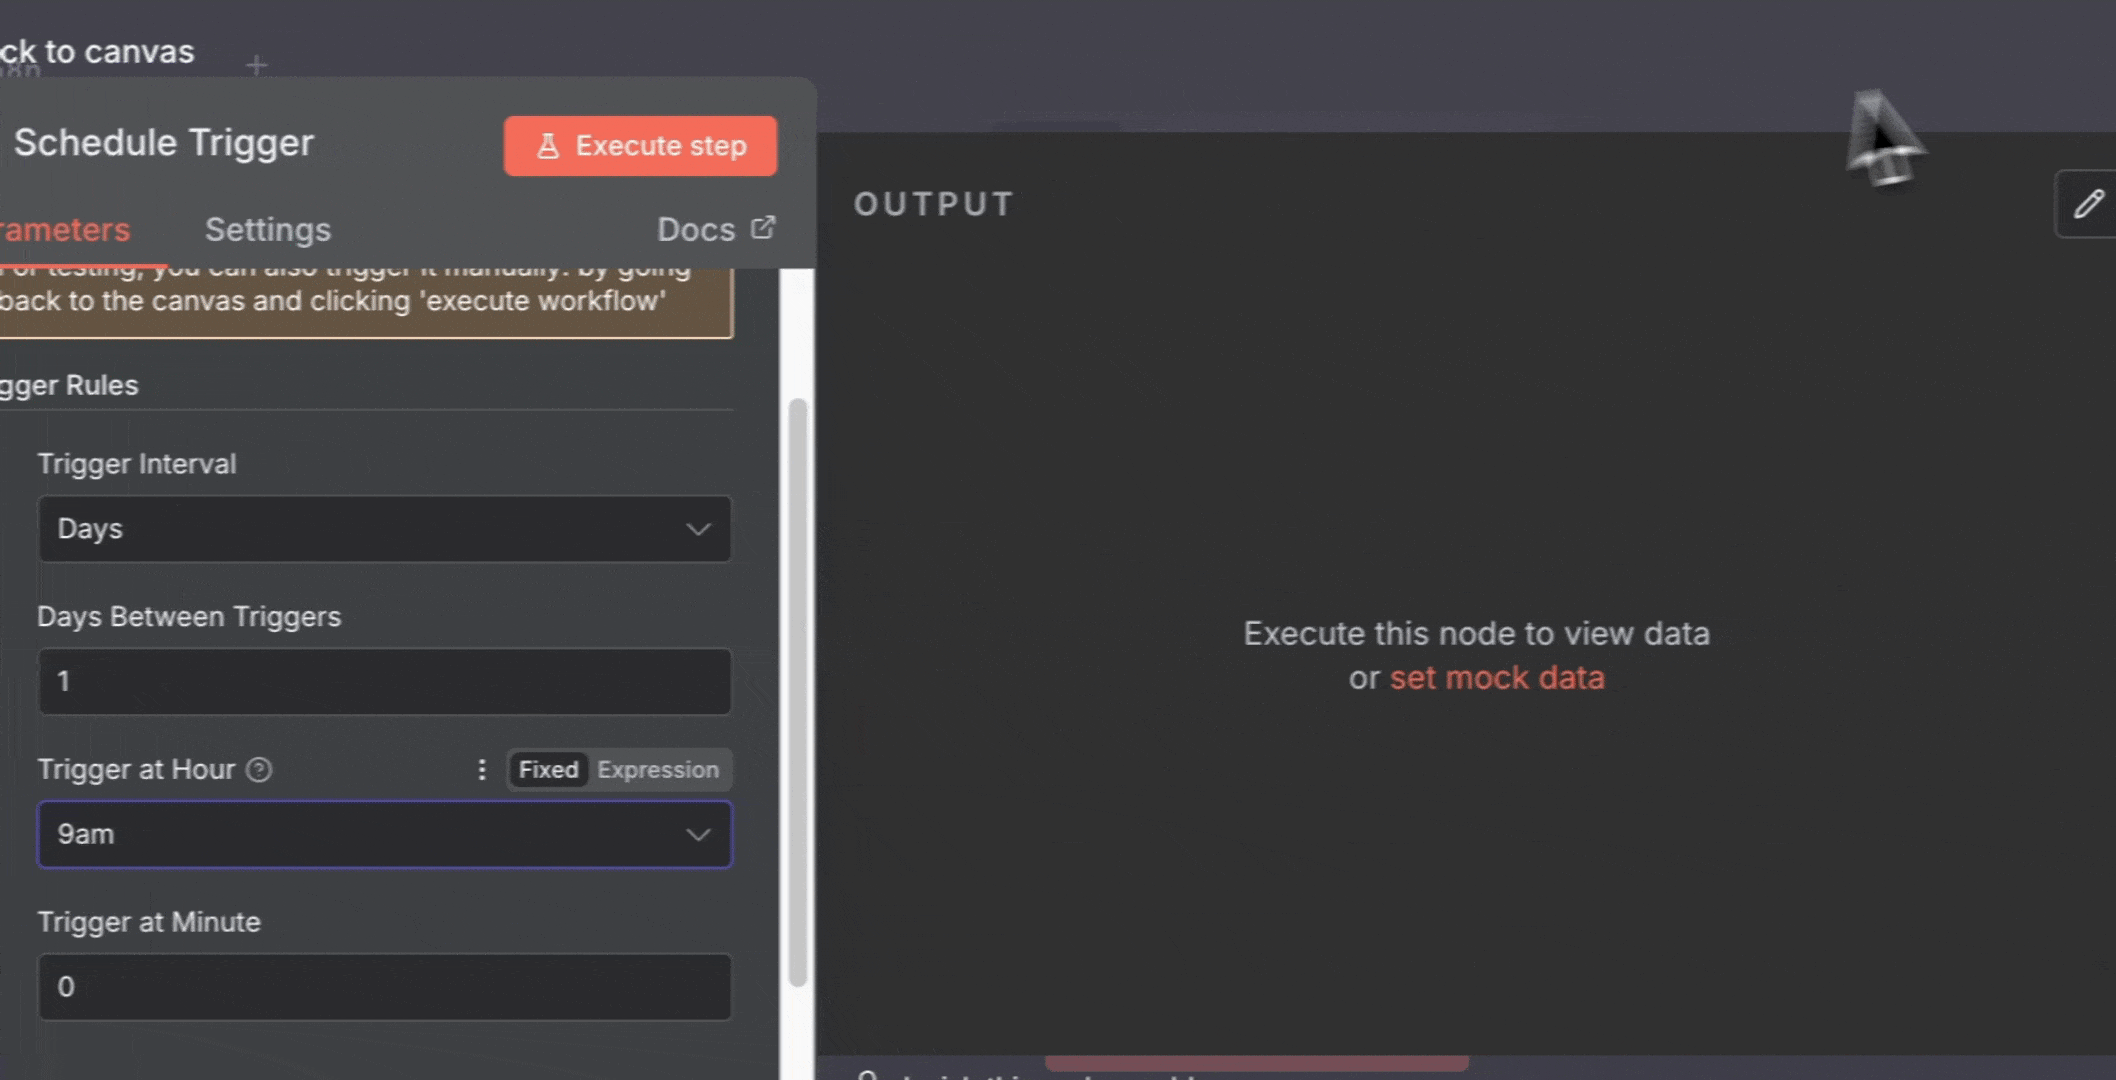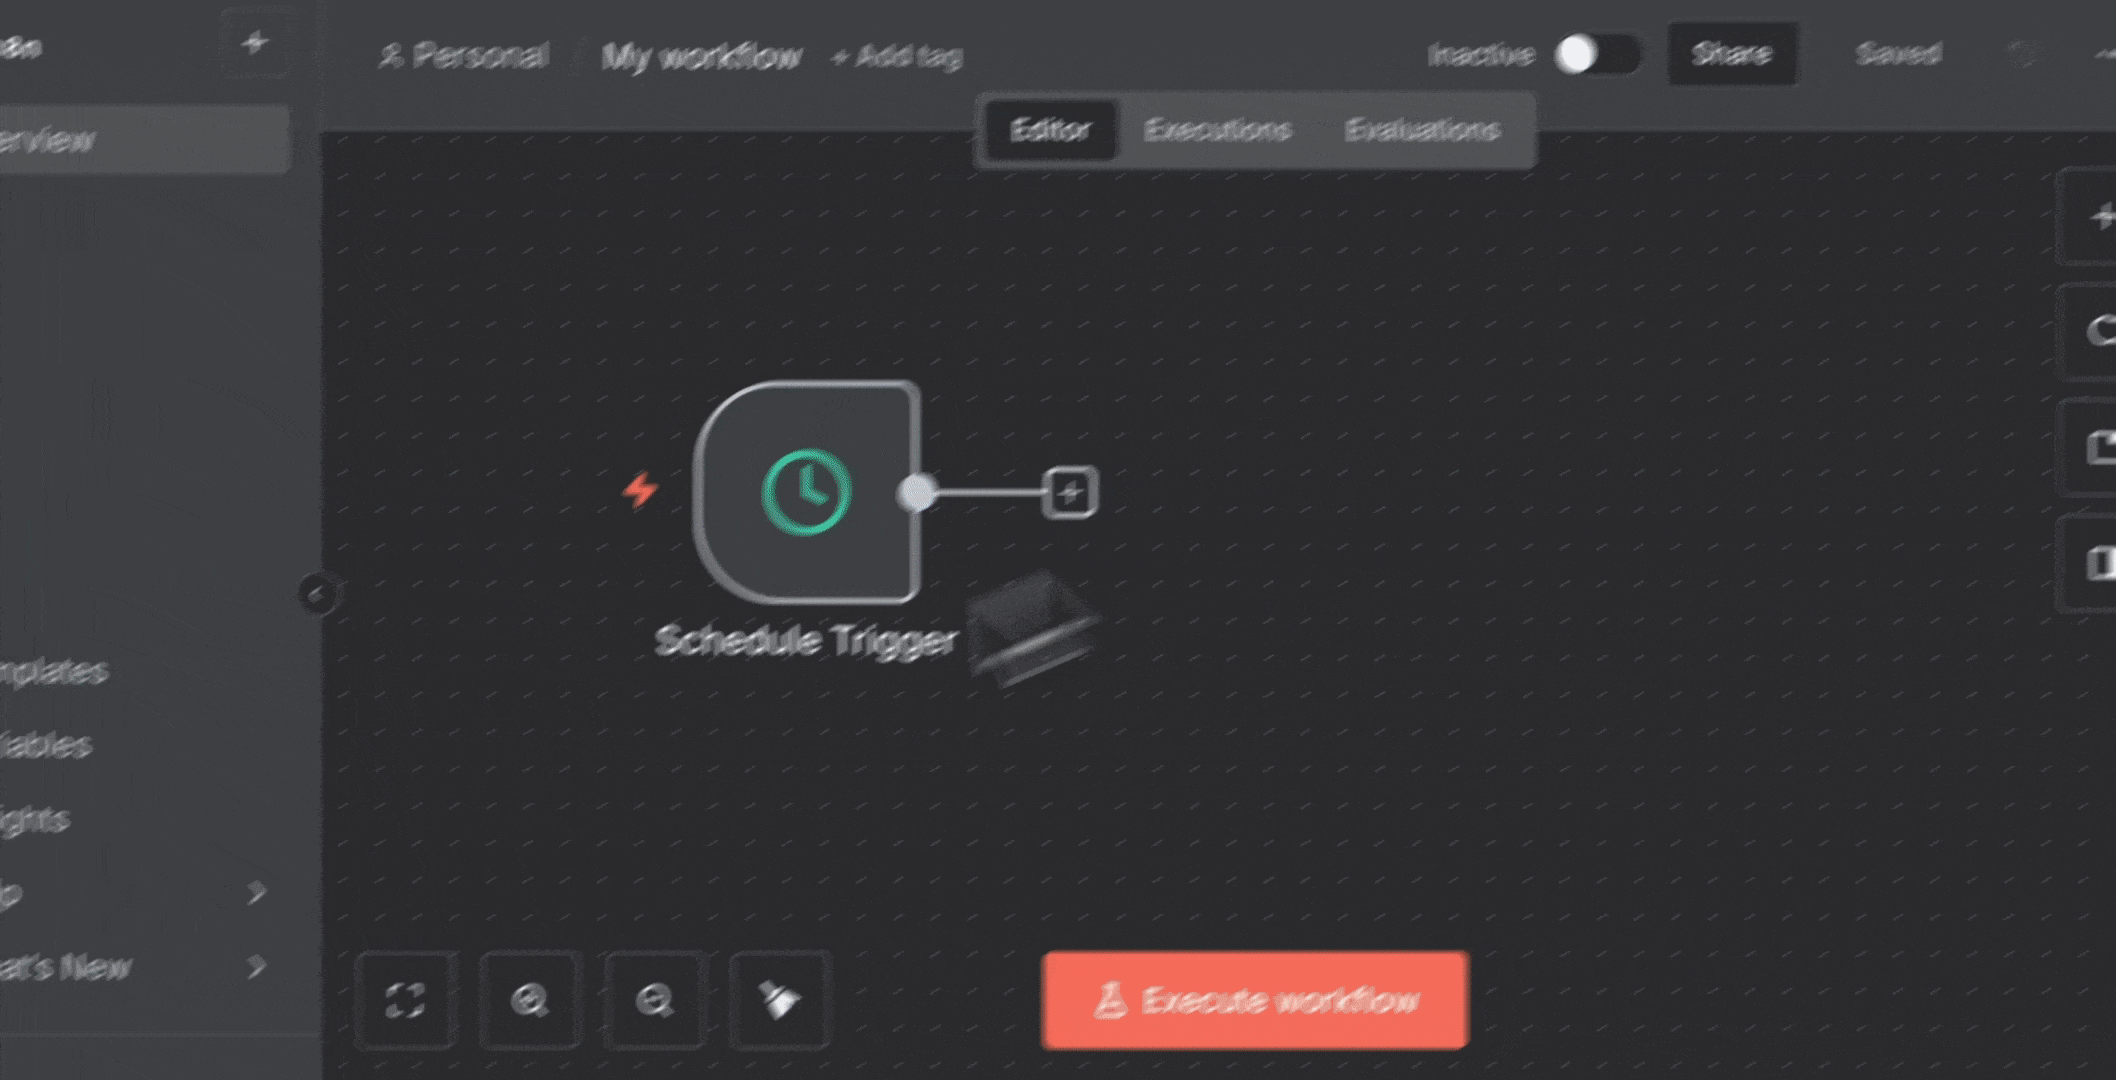
- Ajoutez le nœud Firecrawl :
- Cliquez sur ”+” à côté du Déclencheur planifié
- Recherchez et ajoutez “Firecrawl”
- Sélectionnez vos identifiants Firecrawl
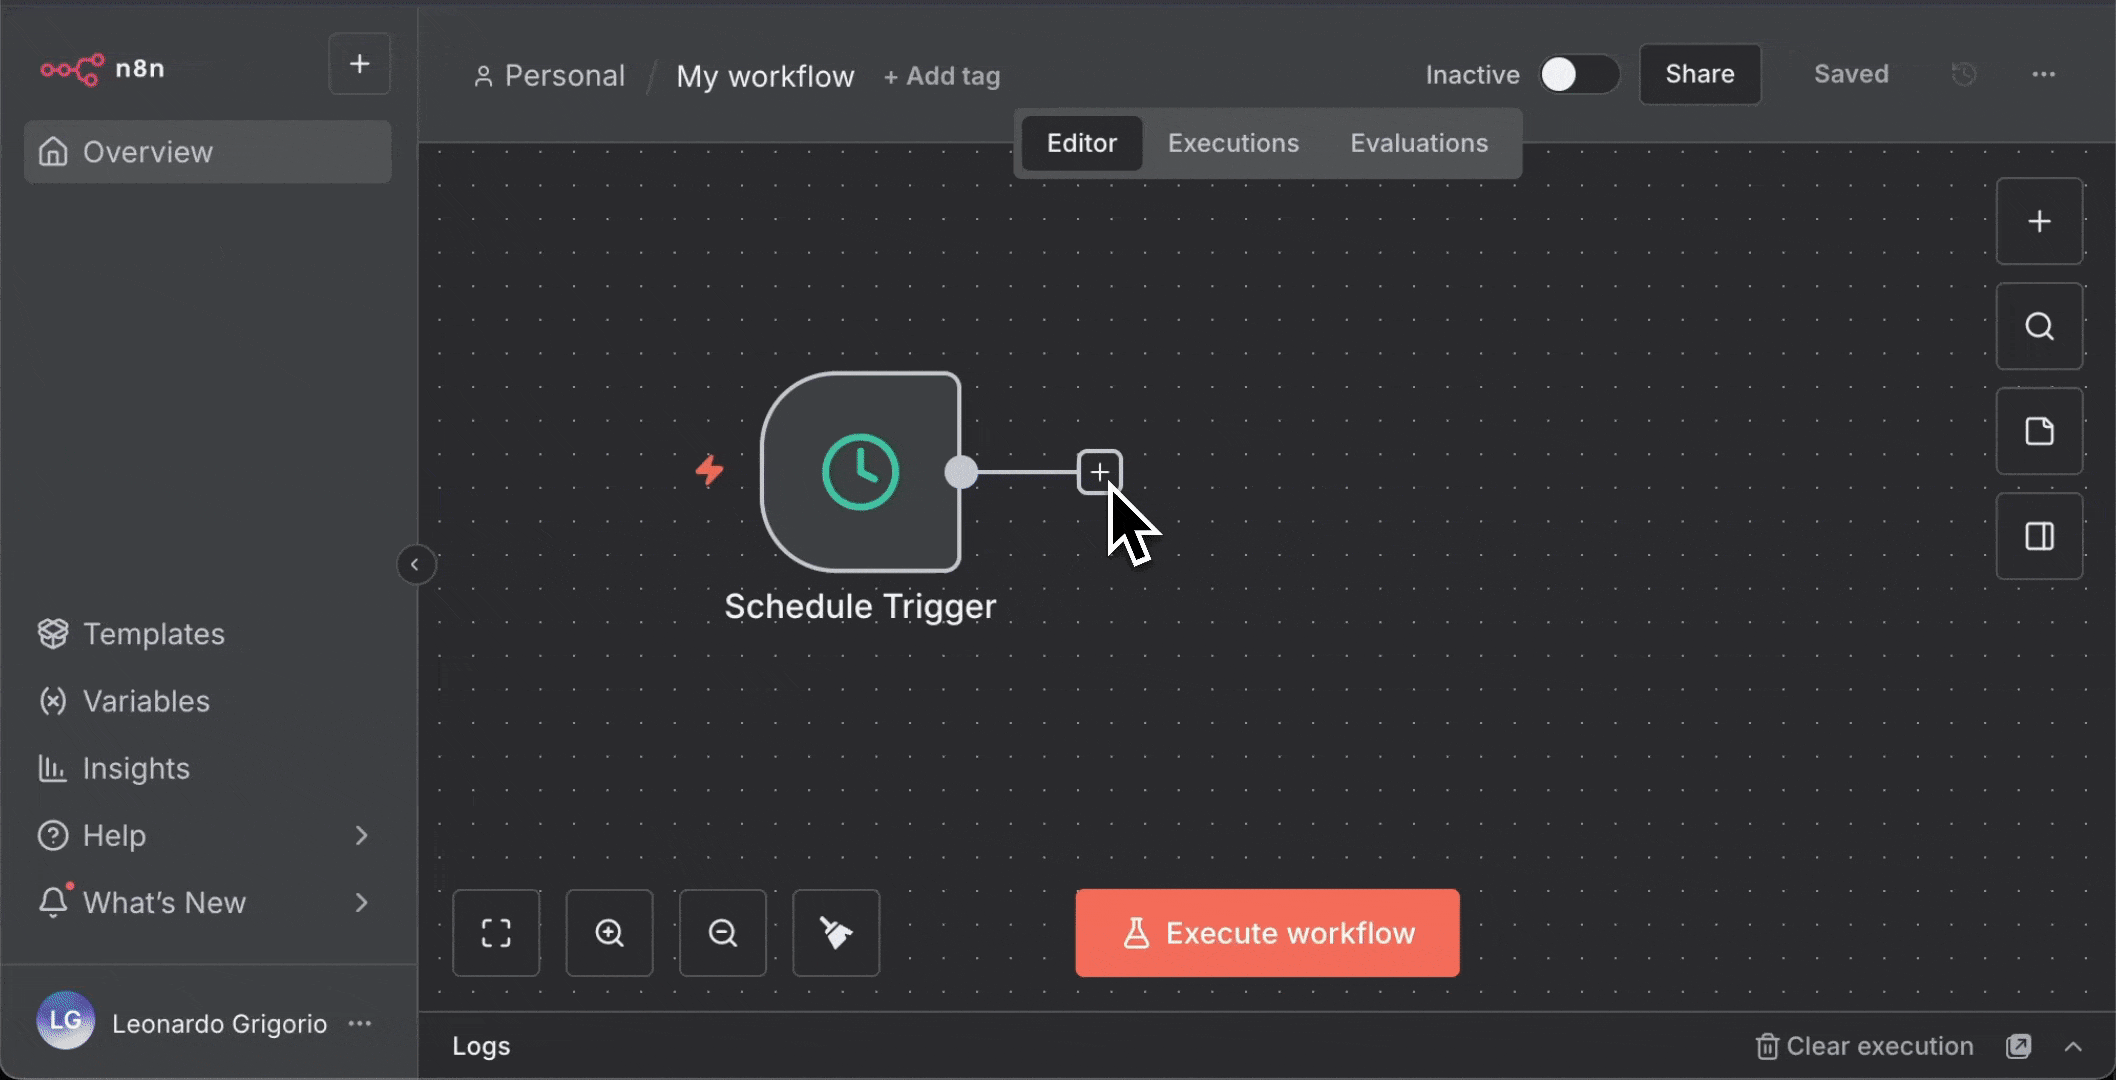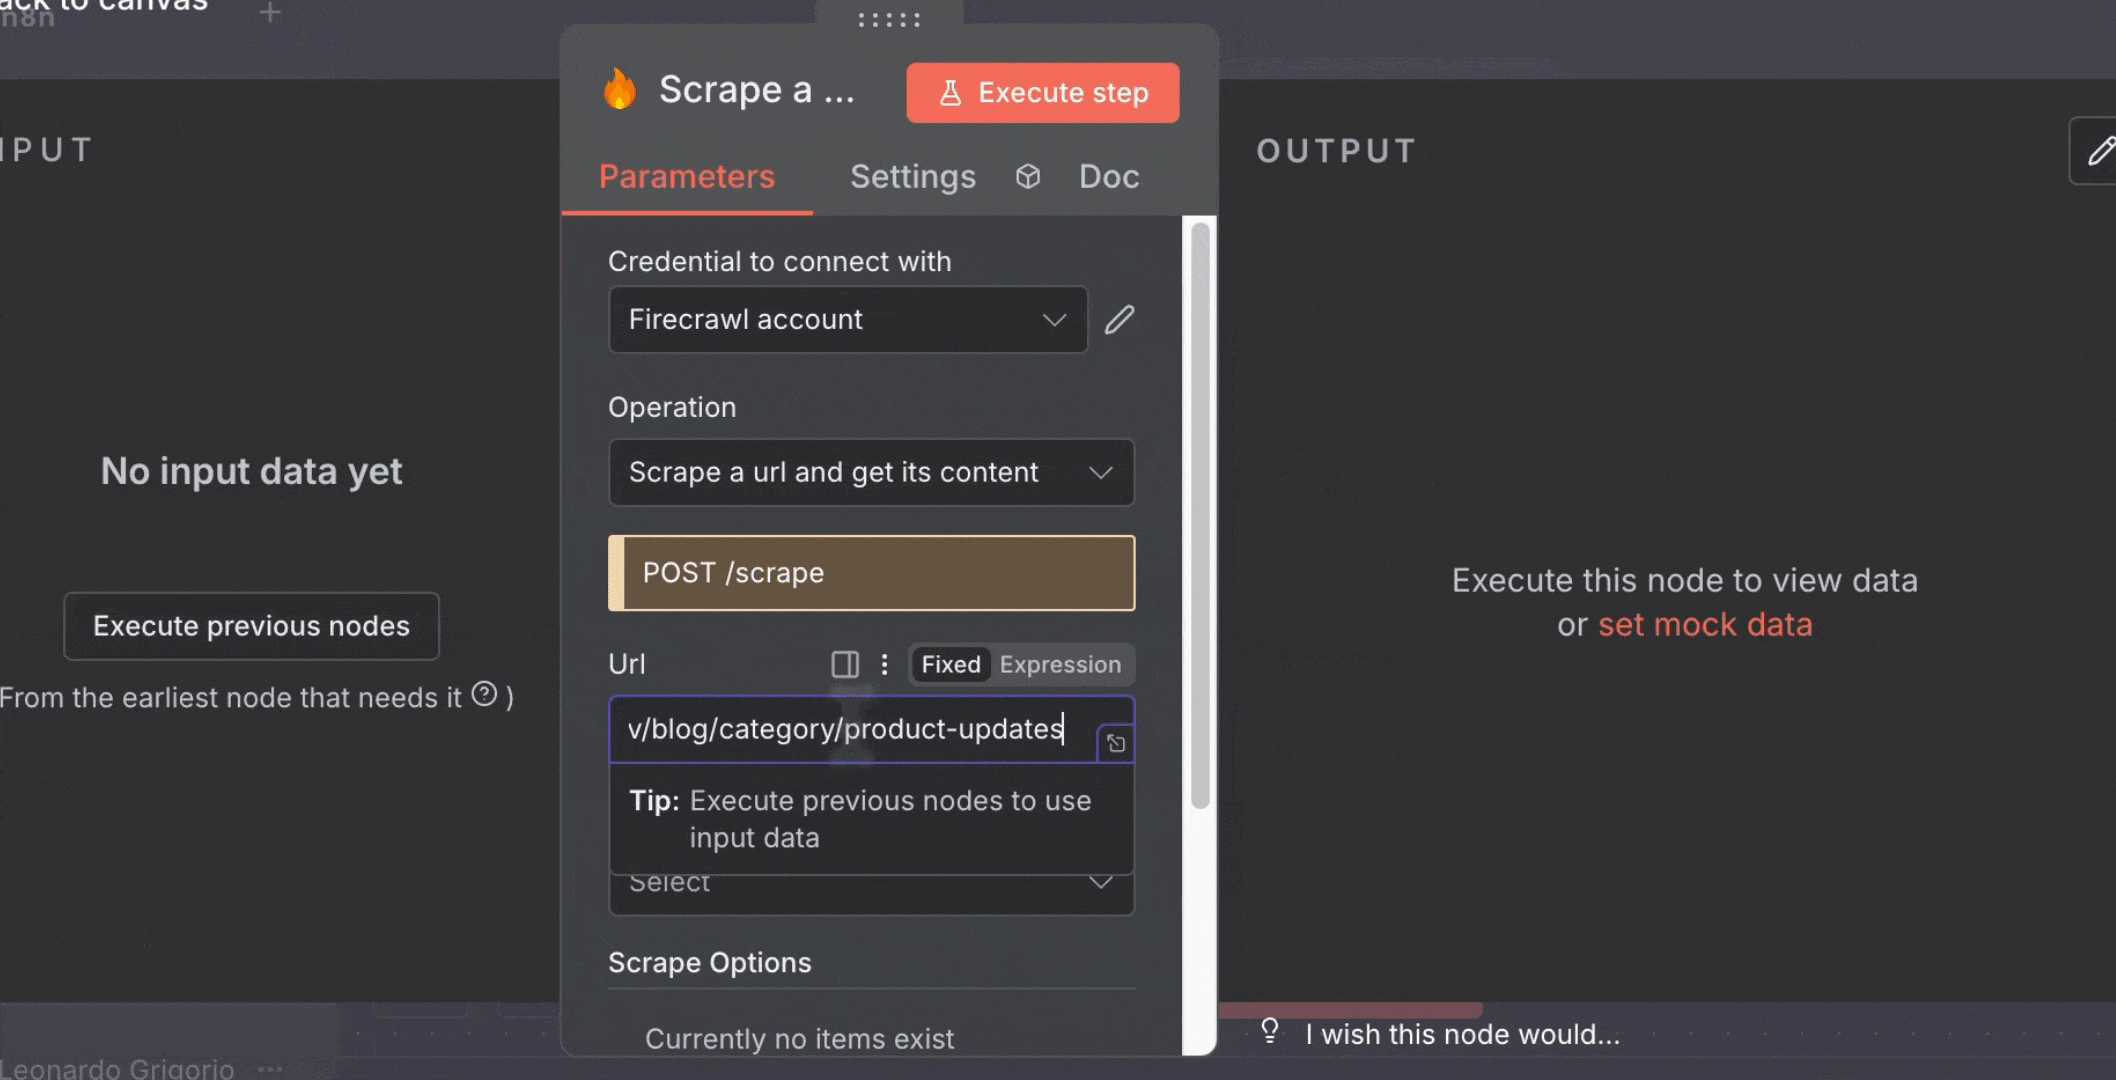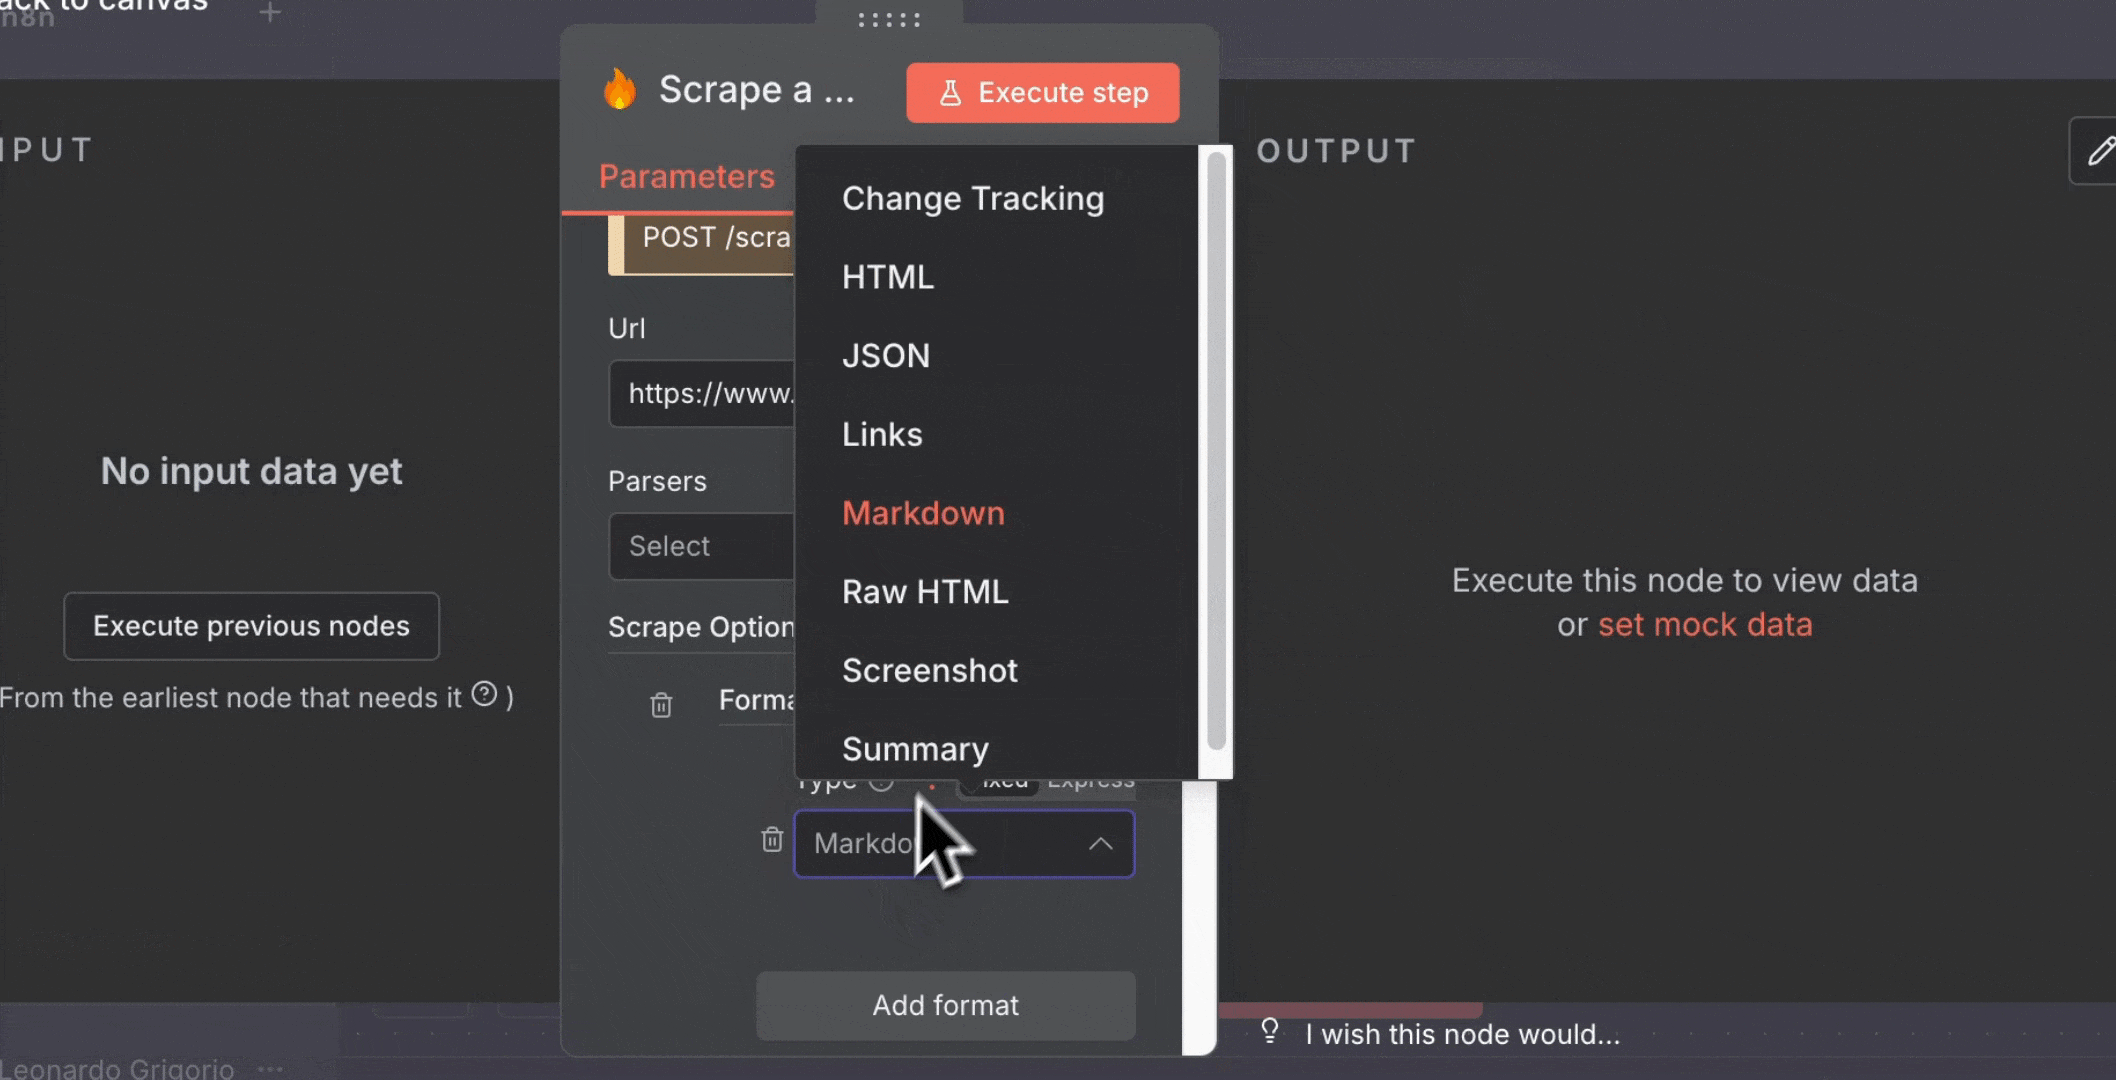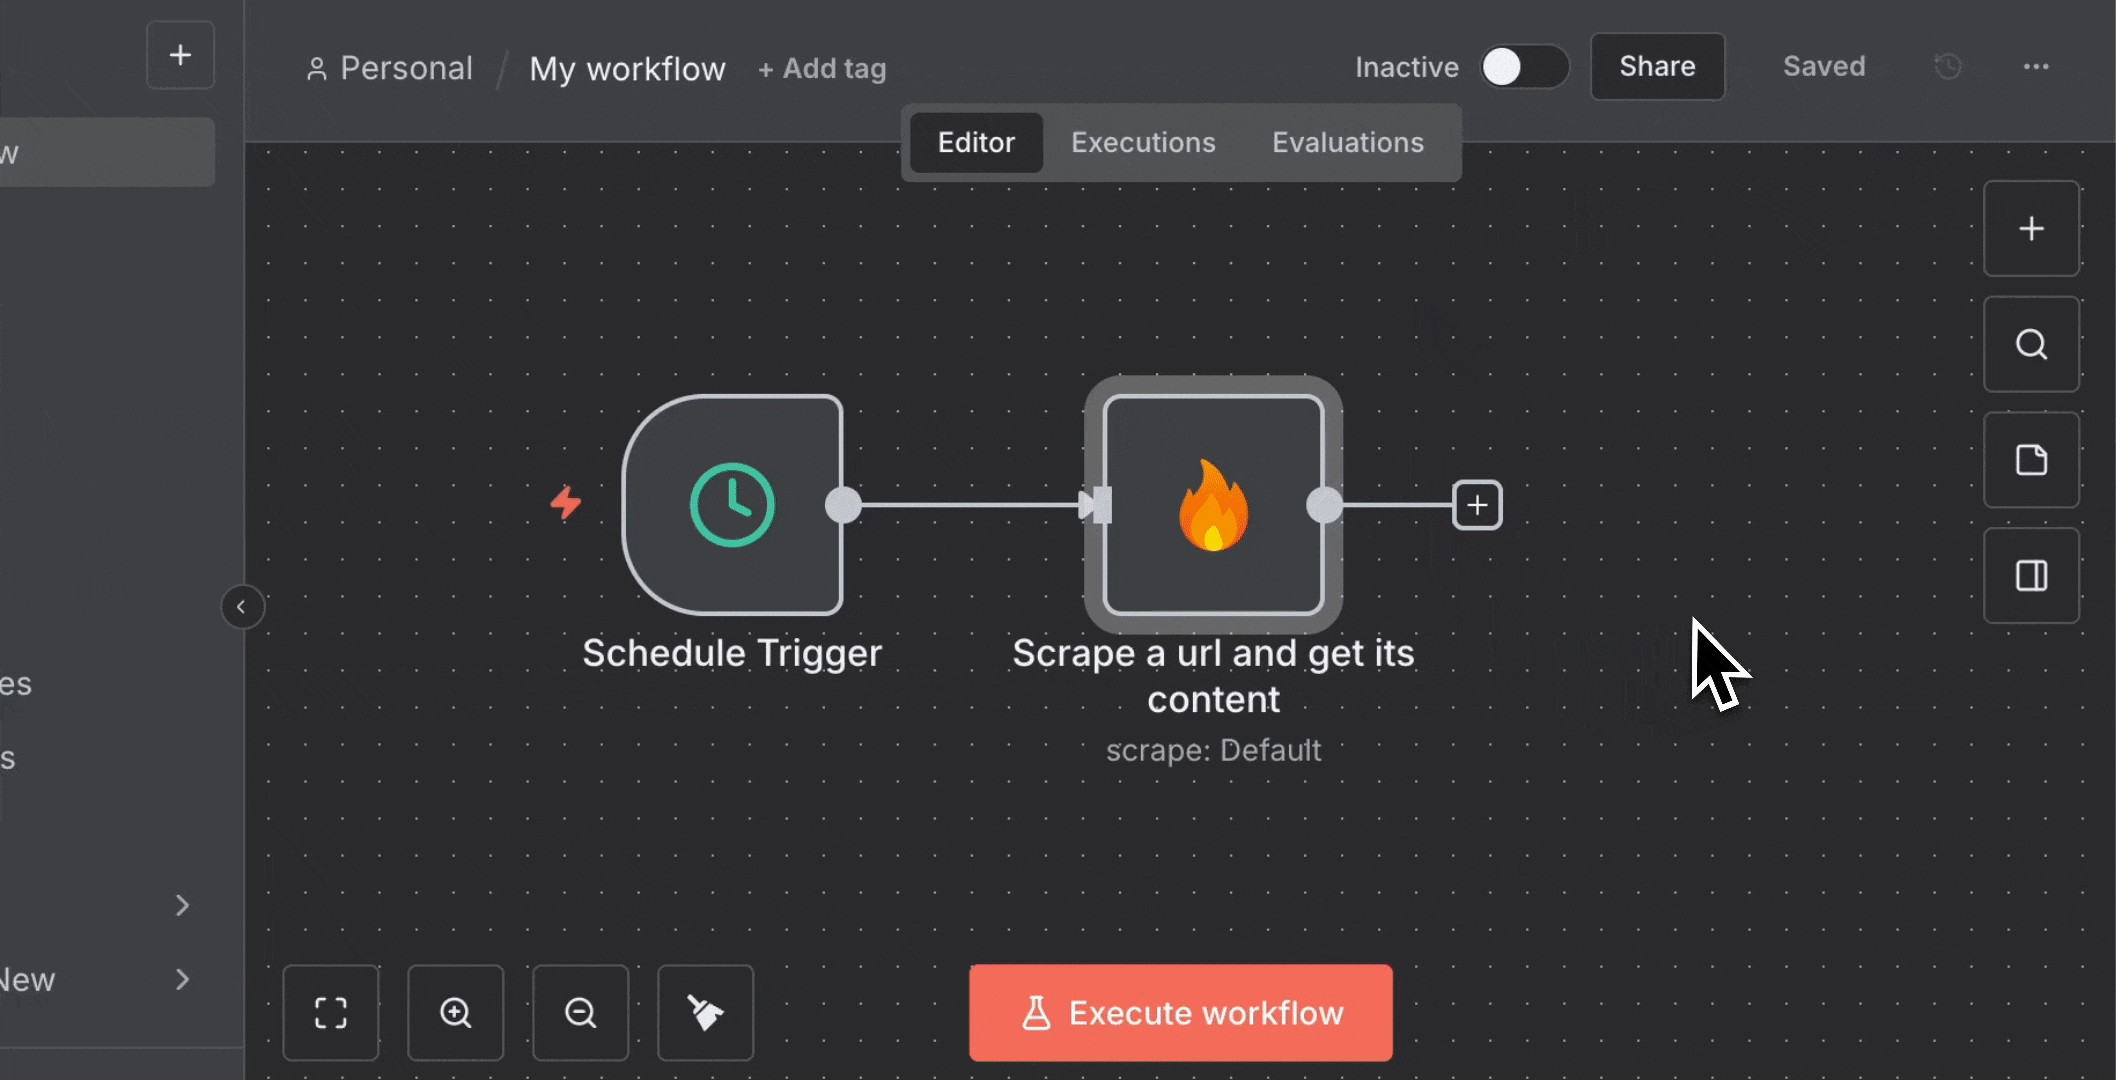
- Configurez :
- Ressource : Scraping
- Opération : Extraire le contenu d’une URL
- URL :
https://www.firecrawl.dev/blog/category/product-updates - Options d’extraction : ajoutez Formats et sélectionnez “Summary”
-
Ajoutez le nœud Telegram :
- Cliquez sur ”+” à côté de Firecrawl
- Recherchez “Telegram”
- Cliquez sur “Envoyer un message texte” pour l’ajouter au canevas
-
Configurez les identifiants Telegram :
- Cliquez sur le nœud Telegram pour ouvrir sa configuration
- Dans la liste déroulante “Credential to connect with”, cliquez sur “Create New Credential”
- Collez le jeton de votre bot fourni par BotFather
- Cliquez sur “Save”

- Configurez le message Telegram :
- Opération : envoyer un message
- ID de chat : saisissez votre ID de chat
- Texte : laissez pour l’instant le message “hello”
- Cliquez sur Exécuter l’étape pour tester l’envoi d’un message et récupérer le résumé de Firecrawl.

- Une fois la structure du résumé de Firecrawl disponible, ajoutez-le au texte du message en faisant glisser le champ
summary(sousdata) depuis la sortie du nœud Firecrawl.
- Testez le workflow :
- Cliquez sur “Exécuter le workflow”
- Vérifiez sur Telegram que vous avez reçu le message de résumé
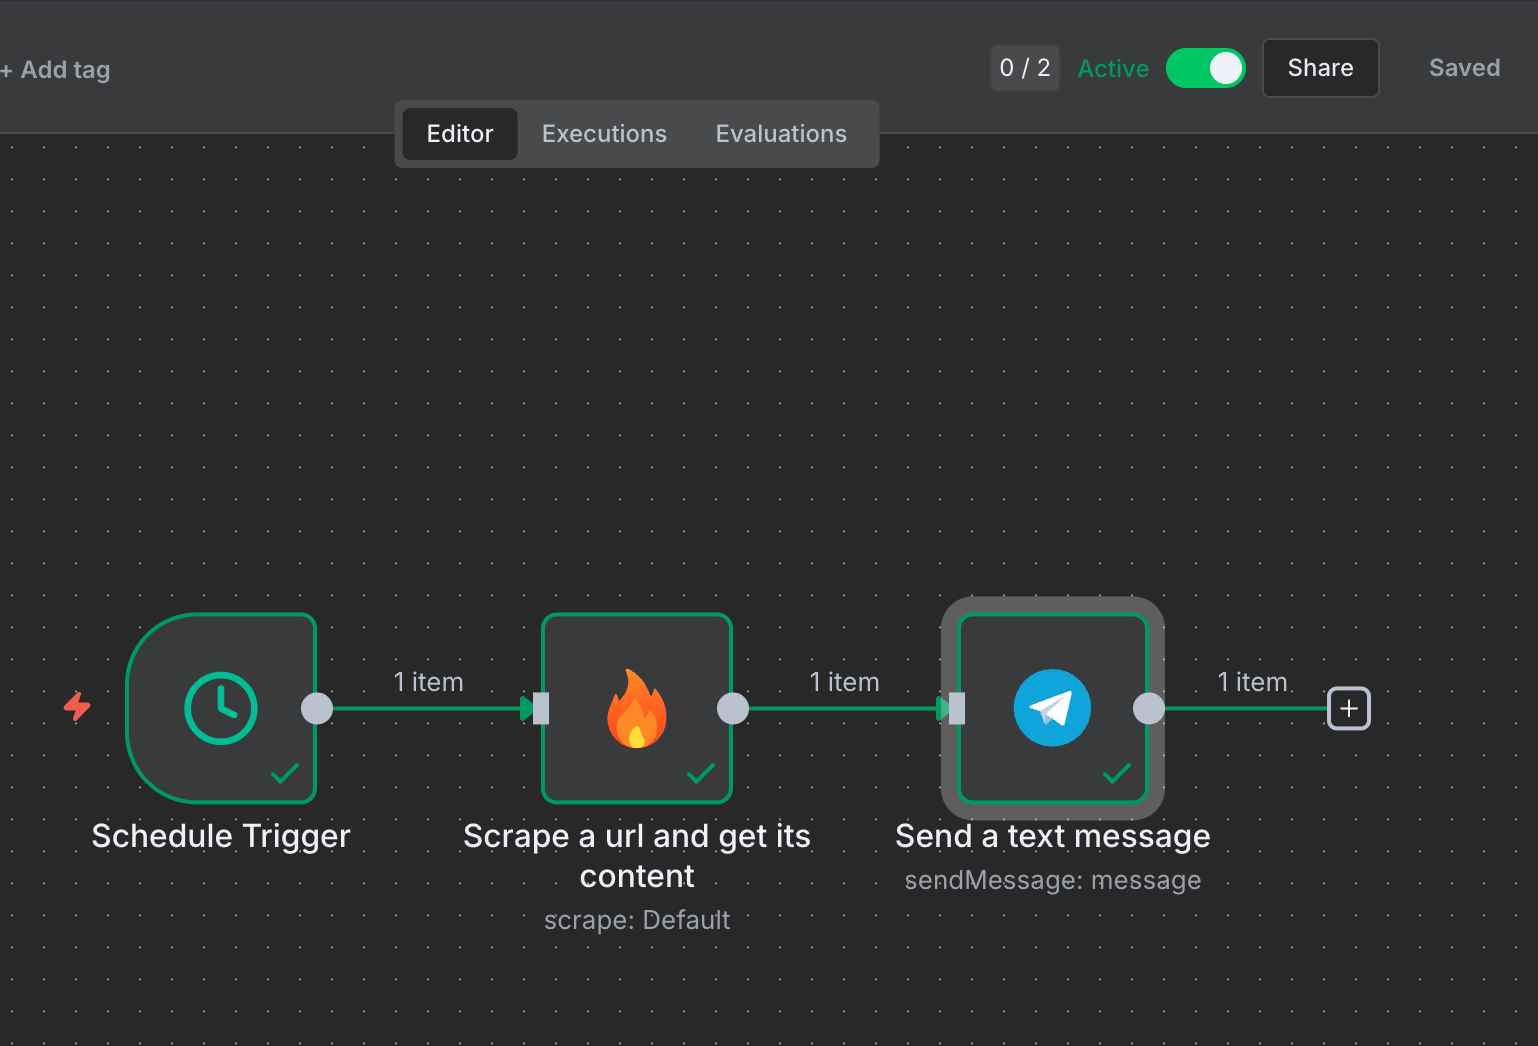
- Activez le workflow en basculant l’interrupteur “Active”
Exemple 2 : Envoyer les actualités sur l’IA à Telegram
Ce workflow utilise l’opération Search de Firecrawl pour rechercher des actualités sur l’IA et envoyer les résultats formatés vers Telegram. Principales différences par rapport à l’exemple 1 :- Utilise un Manual Trigger au lieu de Schedule (exécution à la demande)
- Utilise l’opération Search au lieu de Scrape
- Inclut un nœud Code pour formater plusieurs résultats
- Créez un workflow et ajoutez un nœud Manual Trigger
-
Ajoutez un nœud Firecrawl avec les paramètres suivants :
- Resource : Map & Search
- Operation : Search Web
- Query :
ai news - Limit : 5
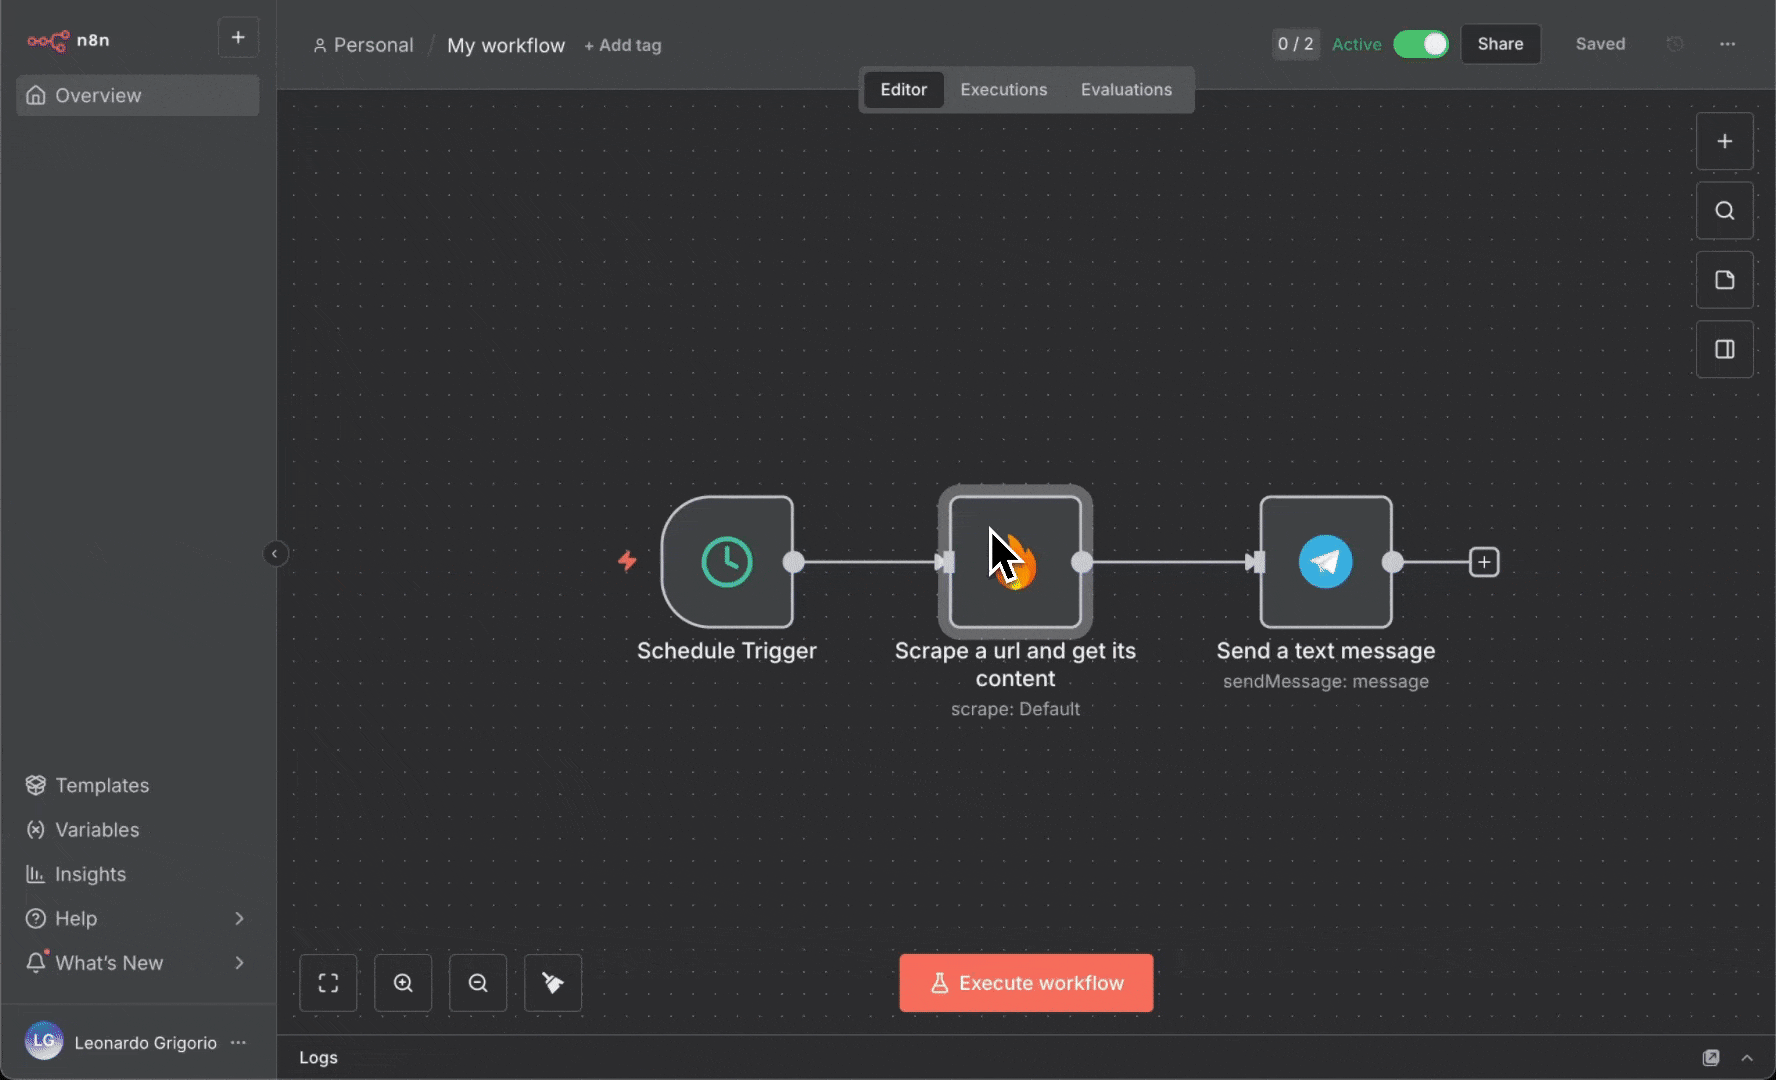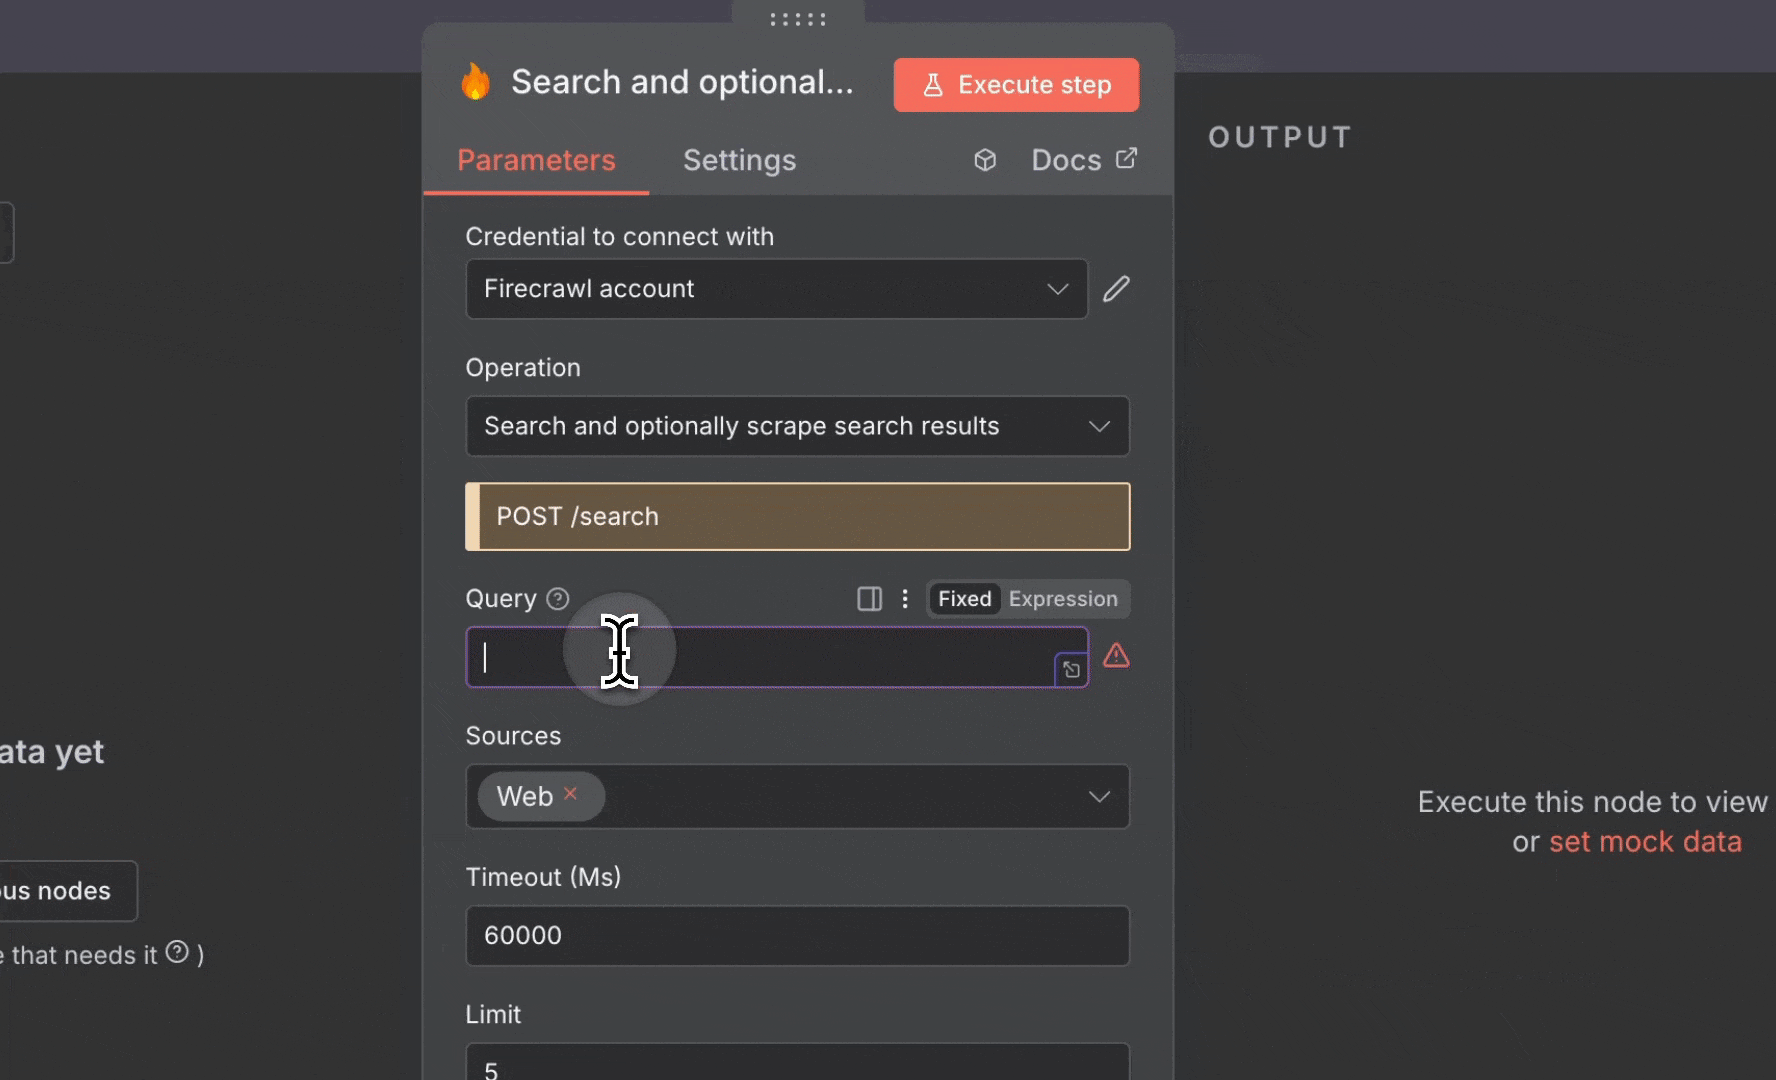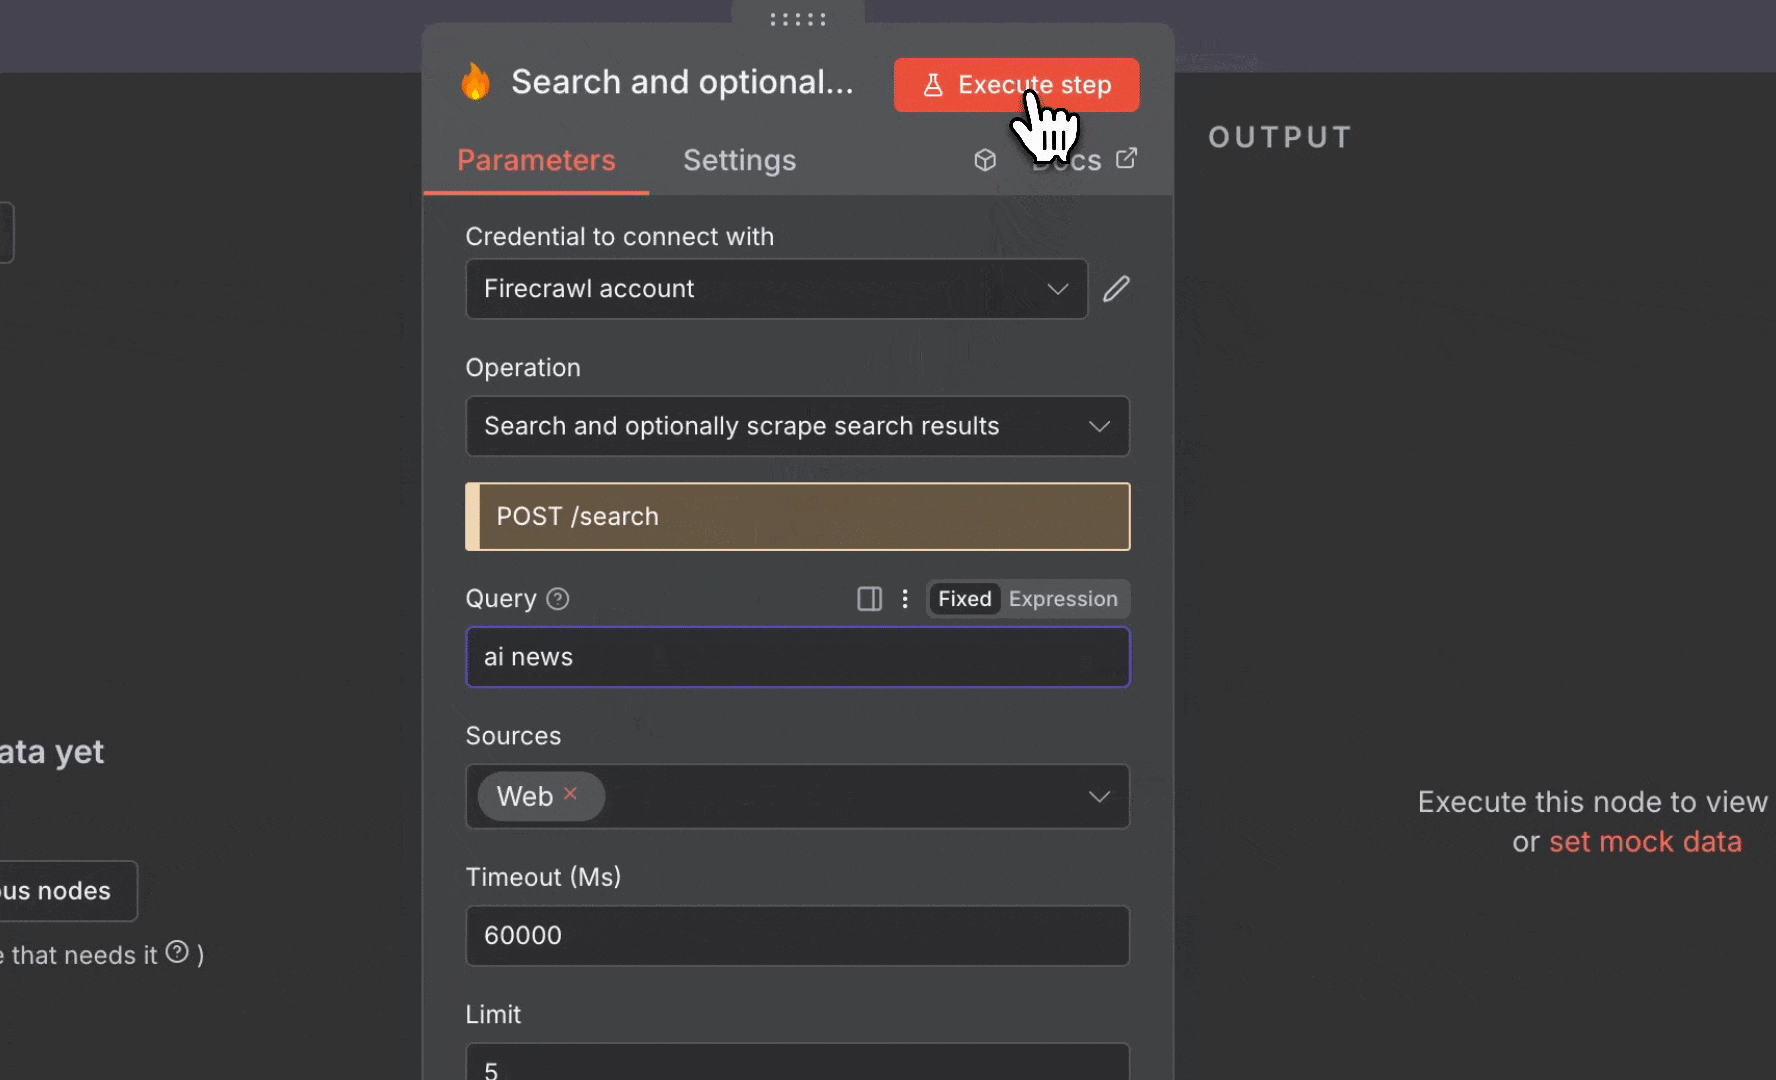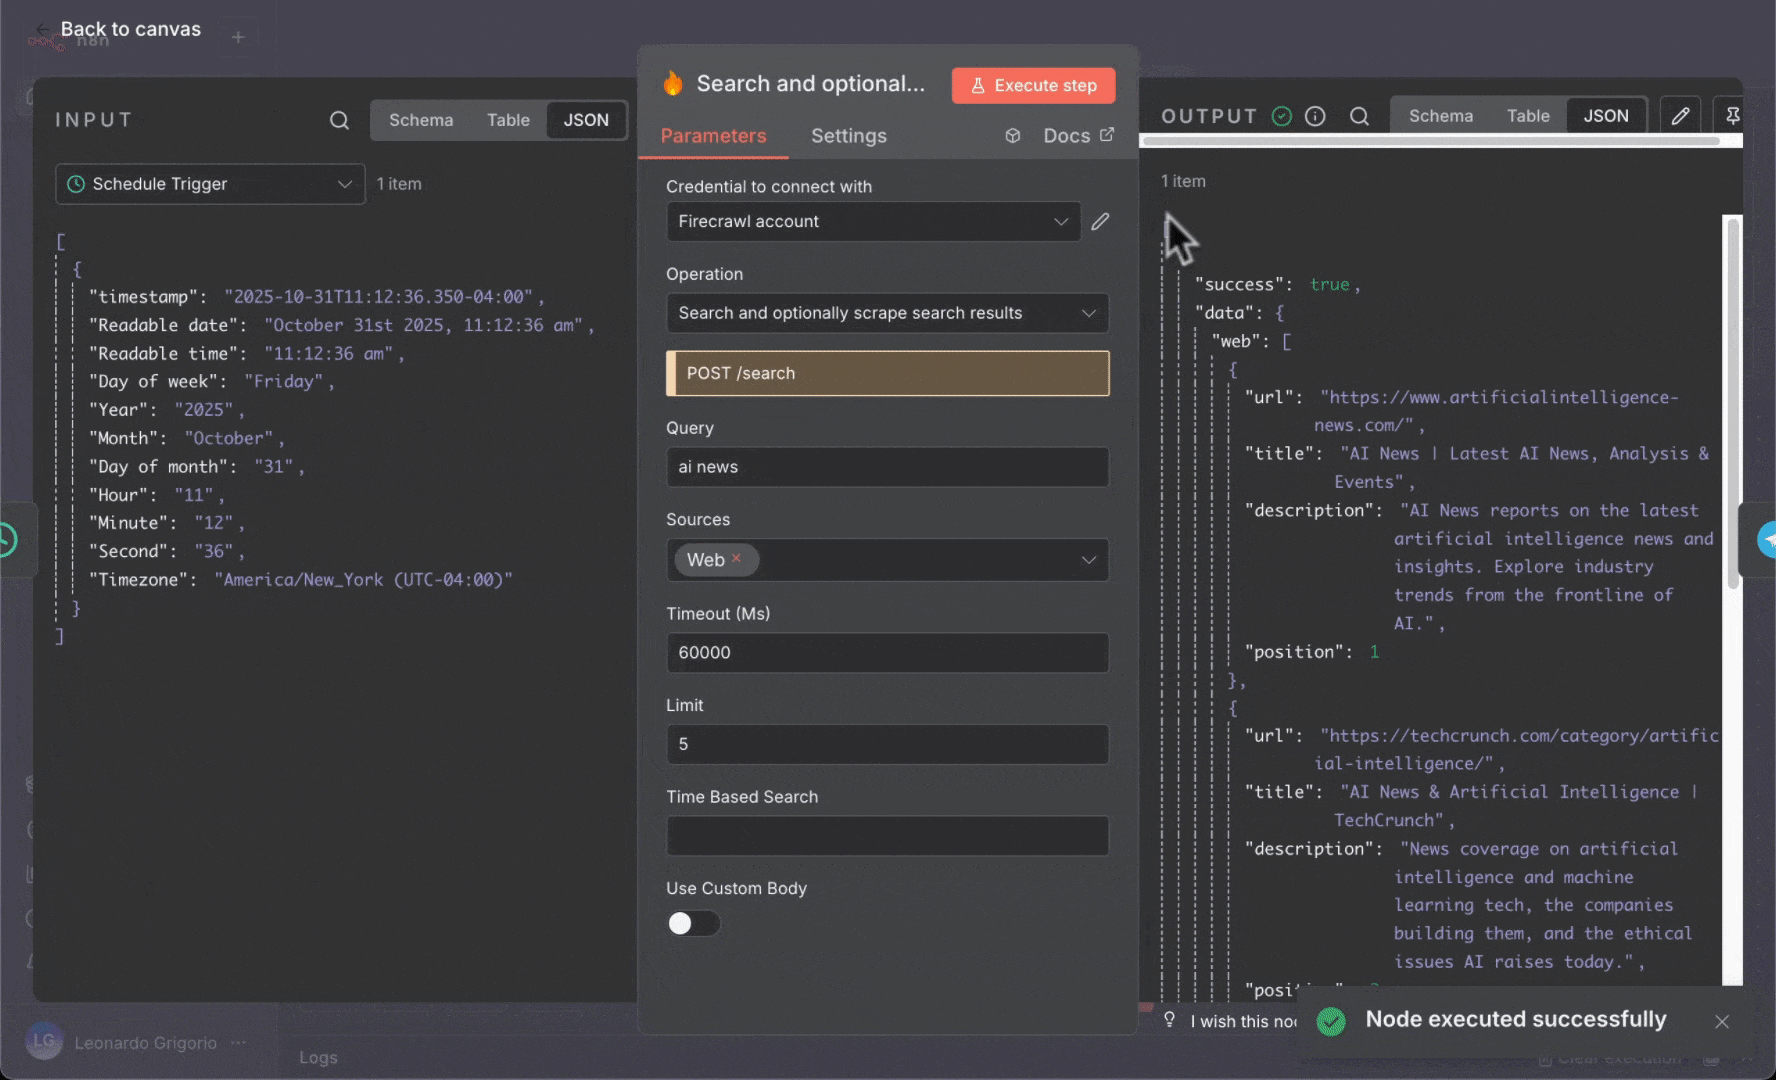
- Ajoutez un nœud Code pour formater les résultats de recherche :
- Sélectionnez “Run Once for All Items”
- Collez ce code :
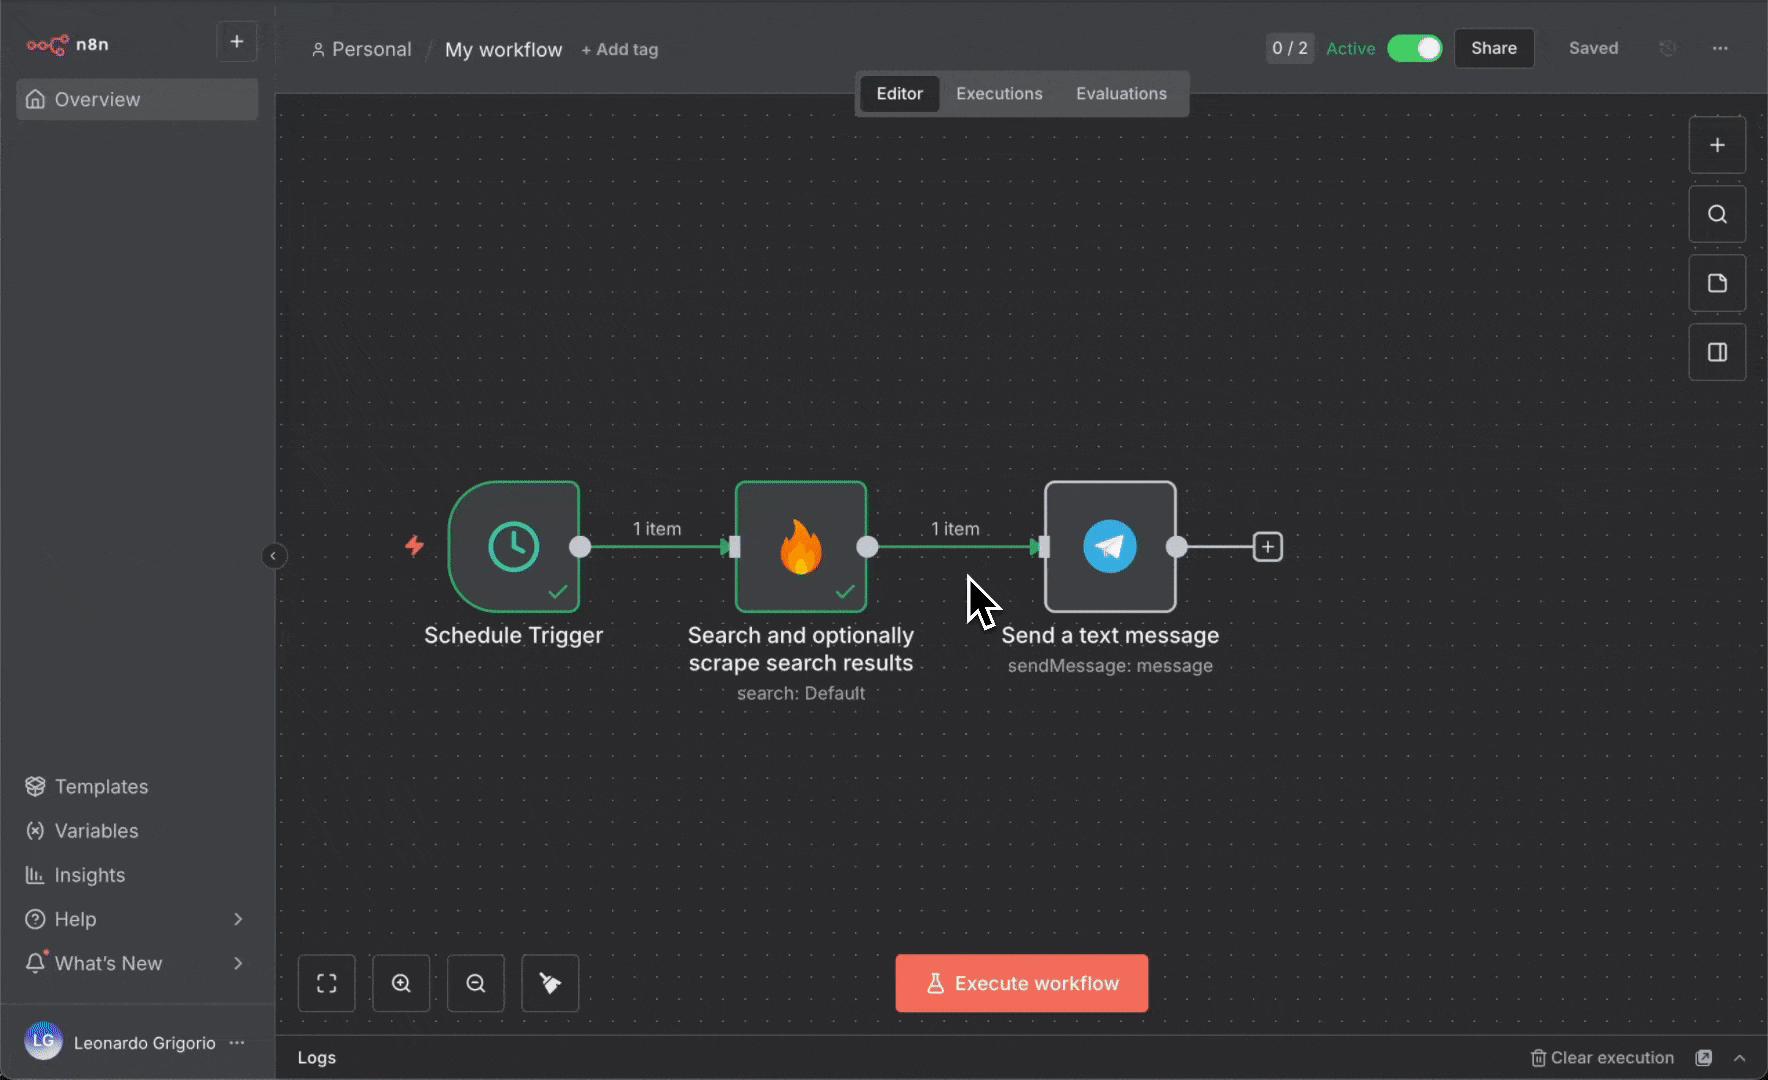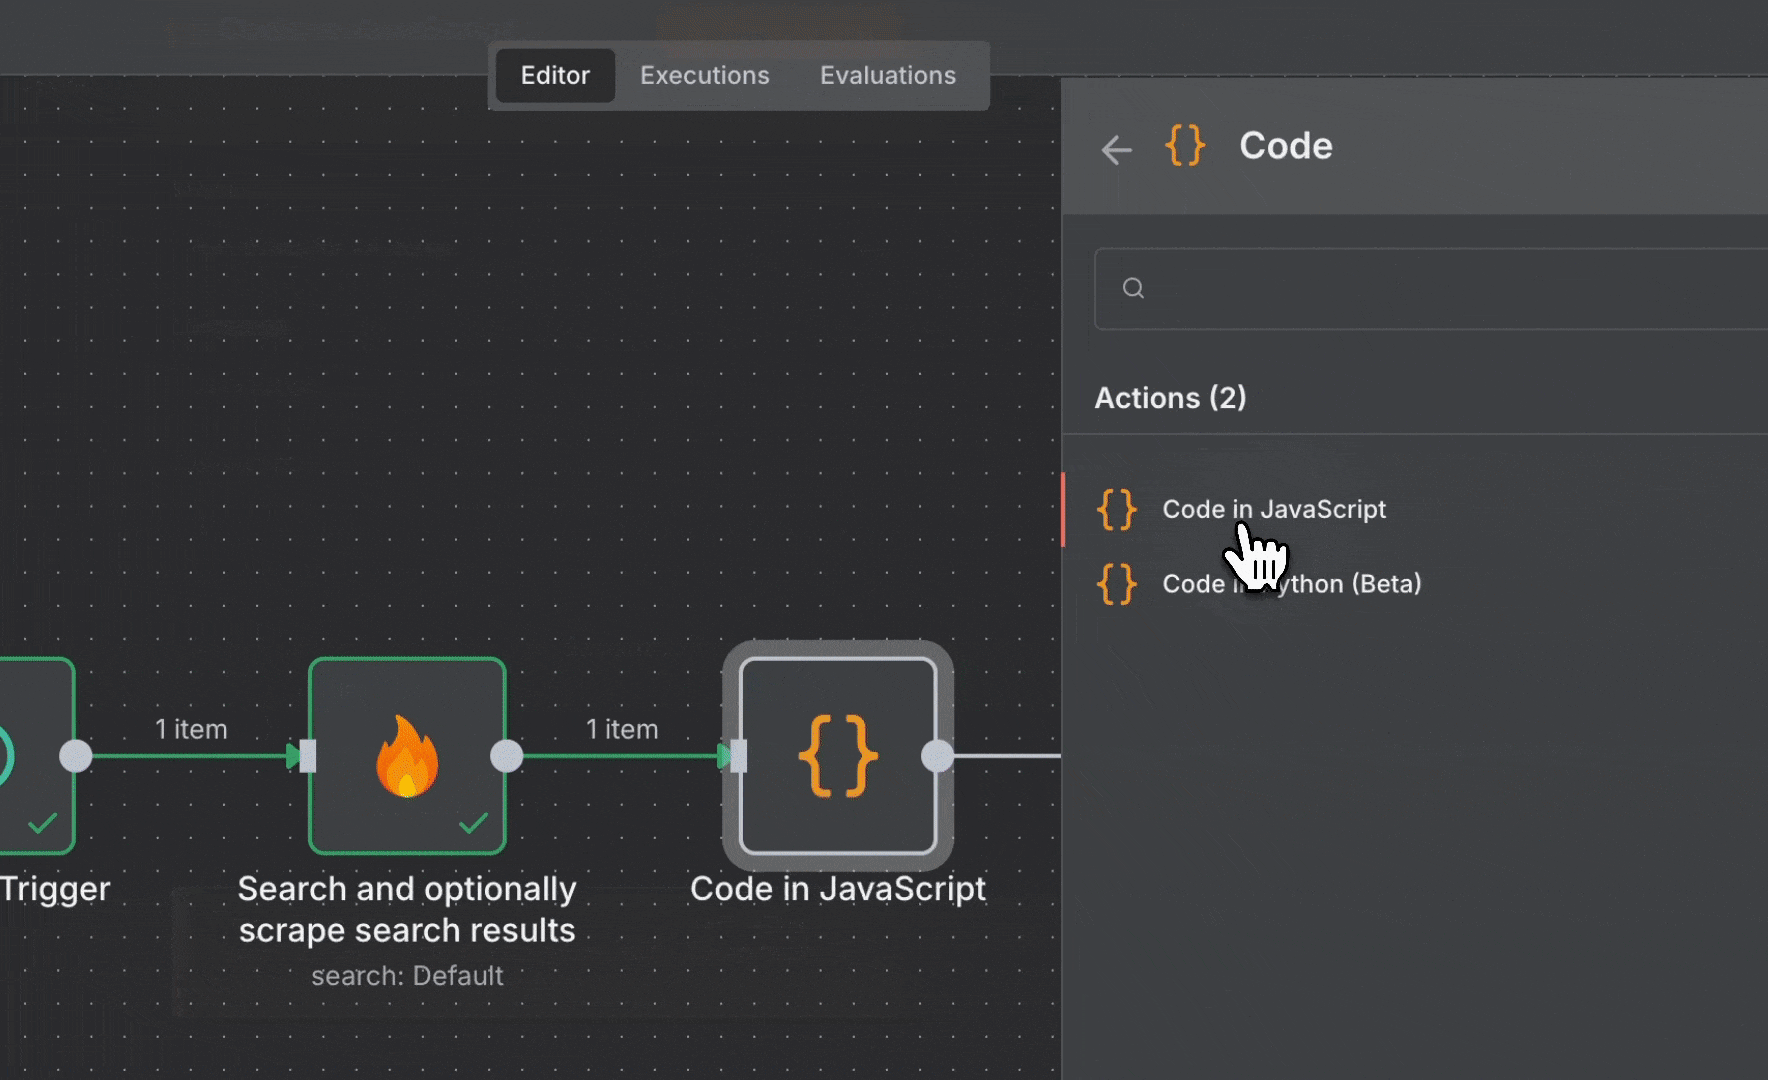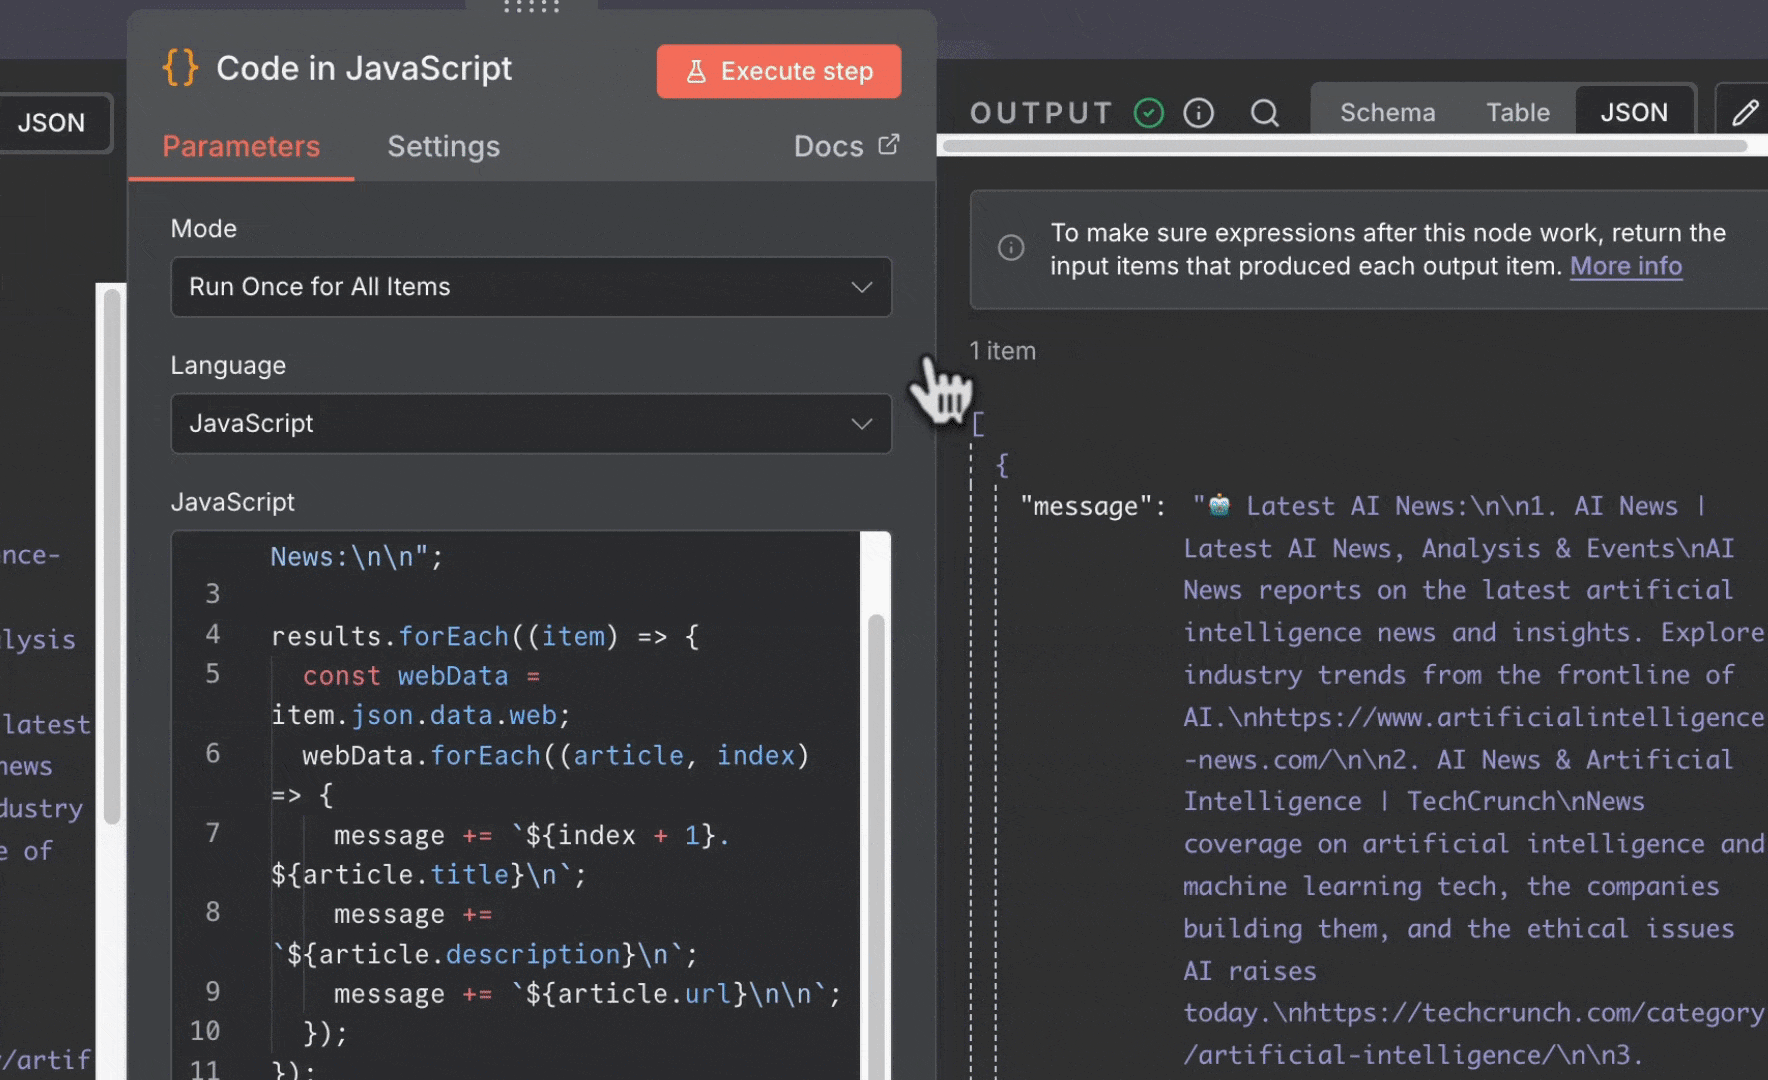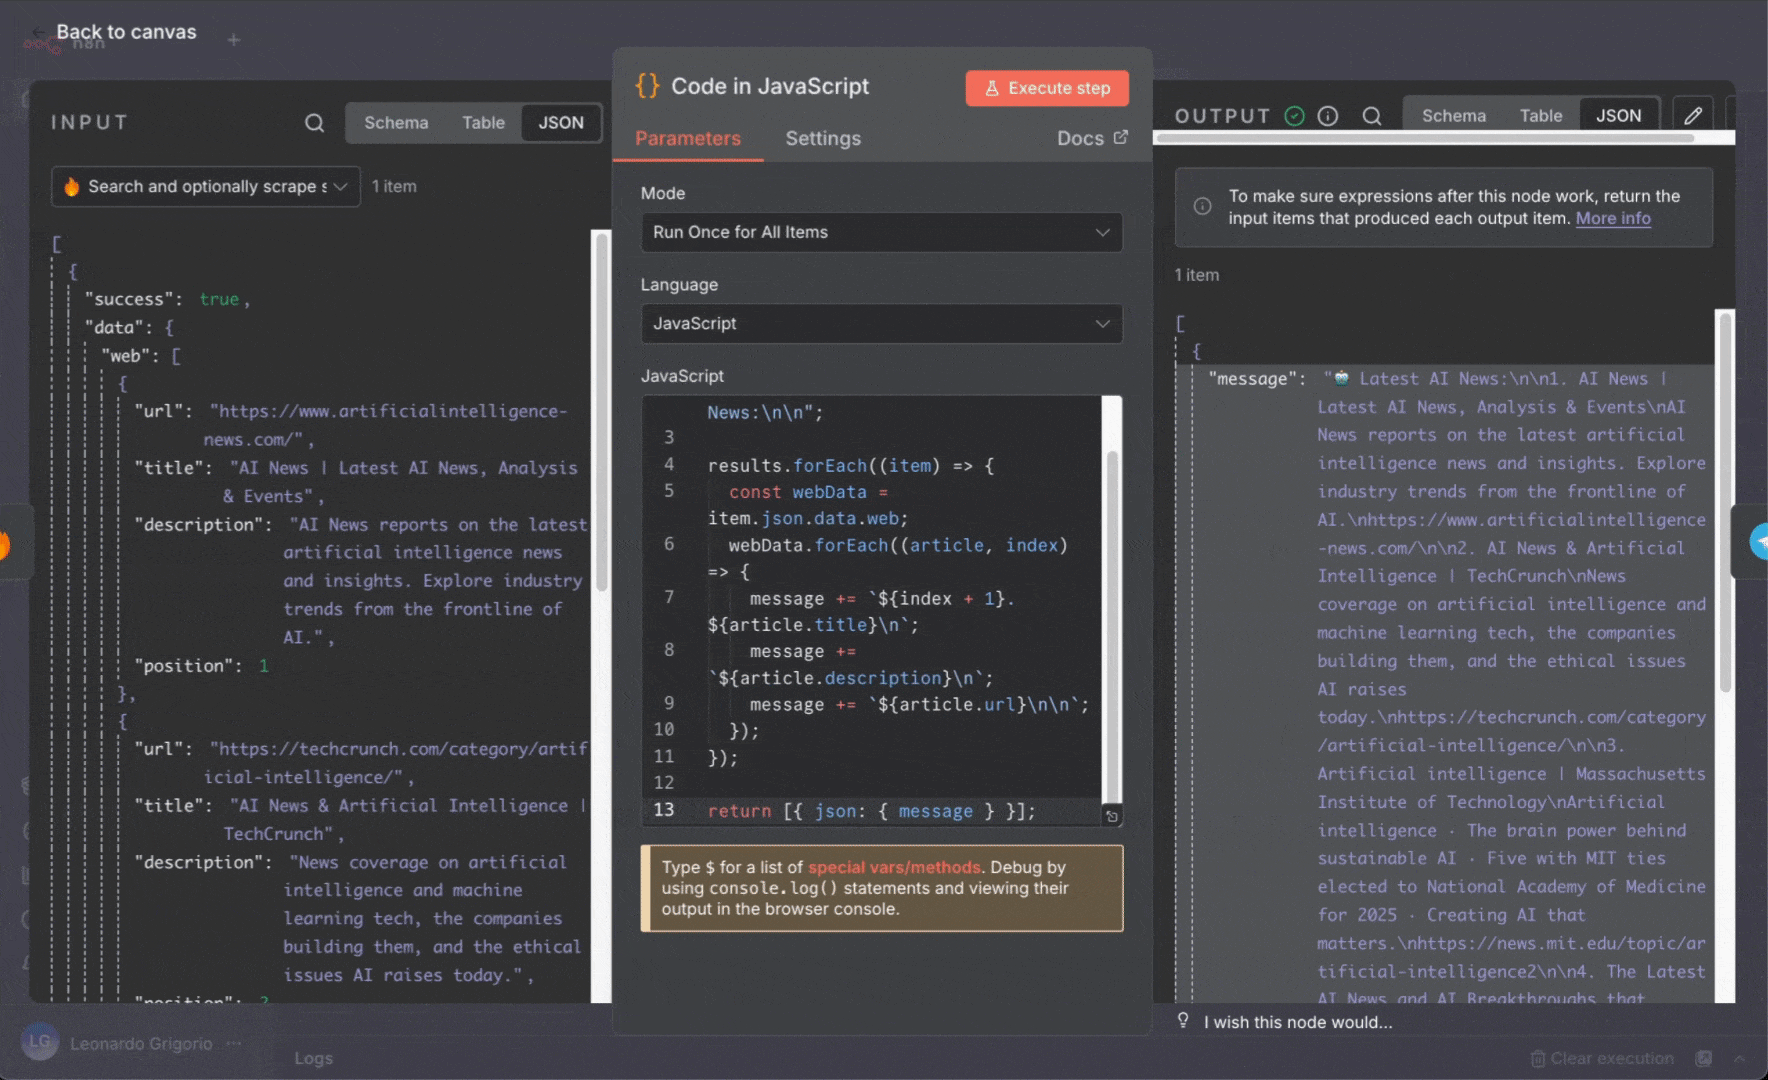
- Mettez à jour le nœud Telegram (avec vos identifiants enregistrés) :
- Texte : faites glisser le champ
messagedepuis le nœud Code
- Texte : faites glisser le champ

Exemple 3 : Résumé des actualités par l’IA
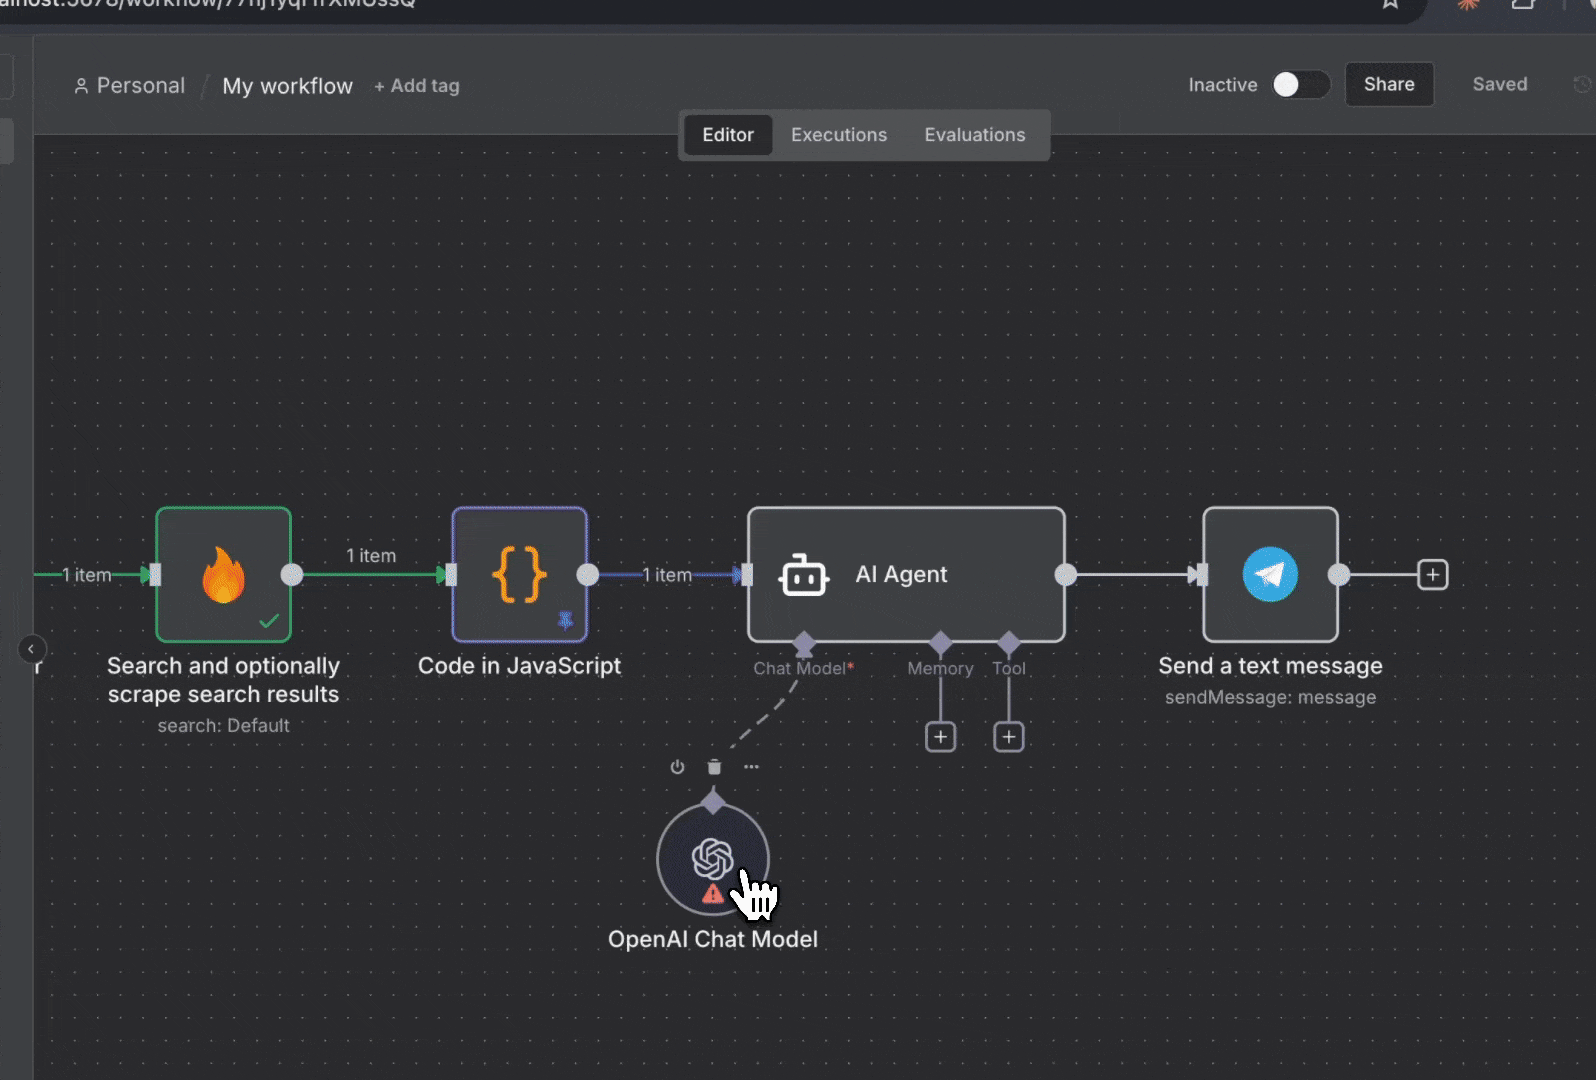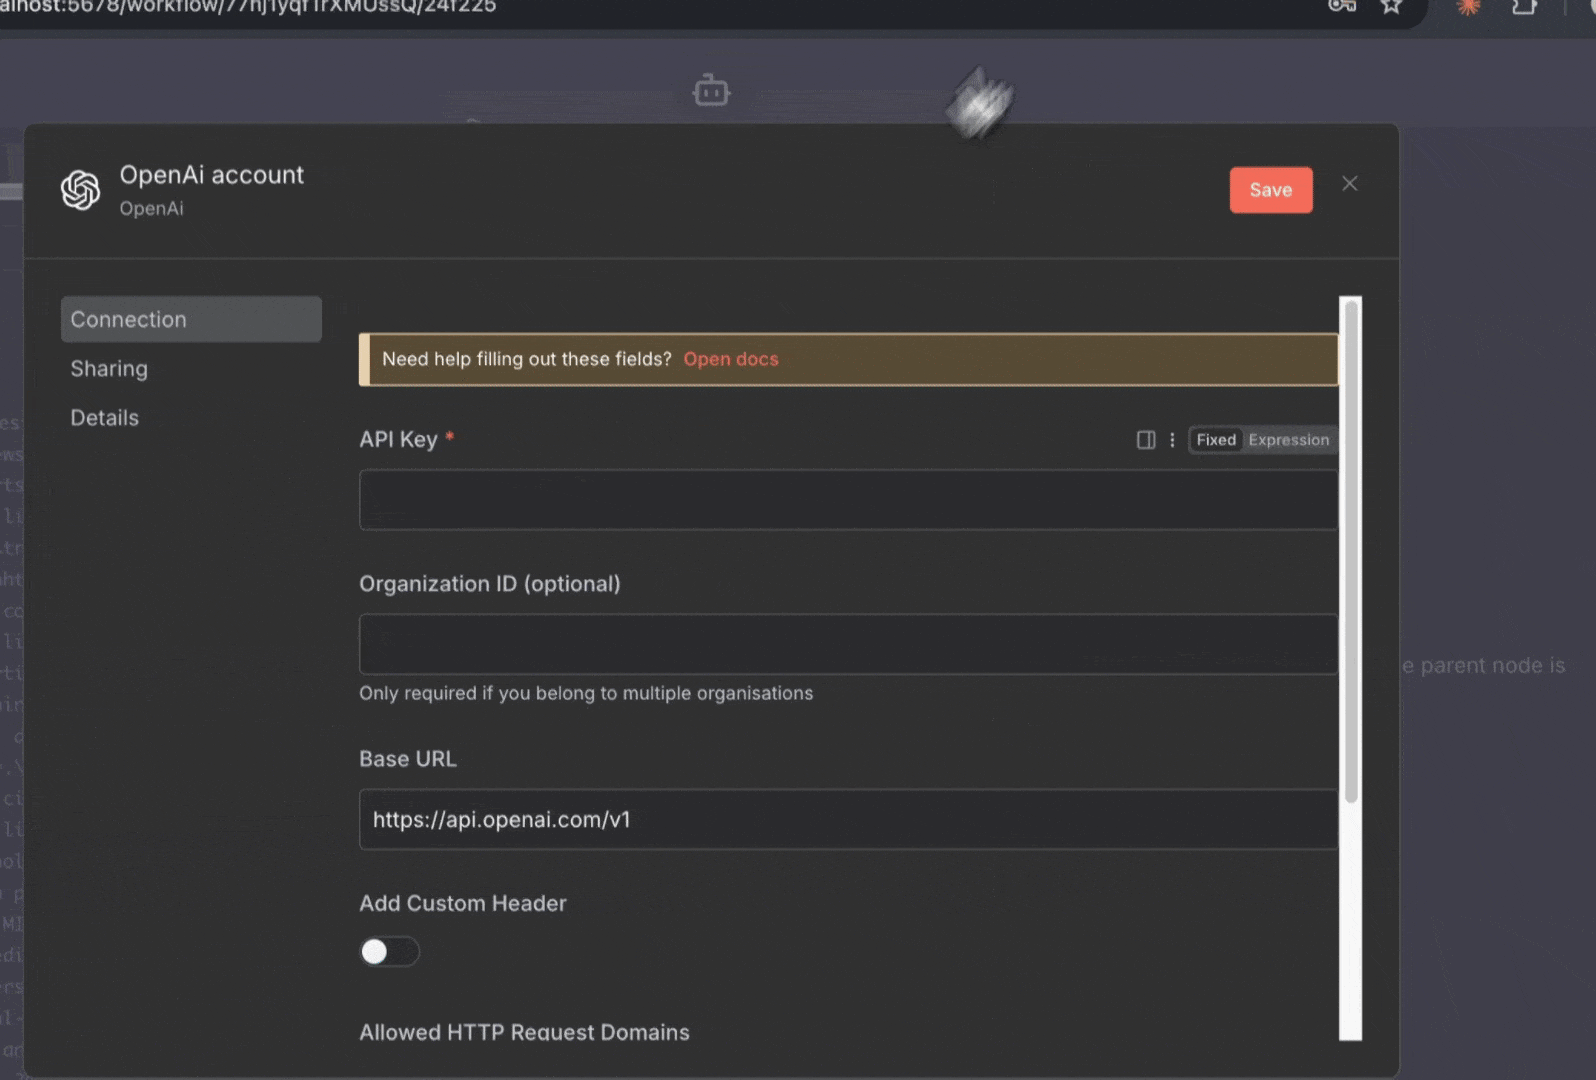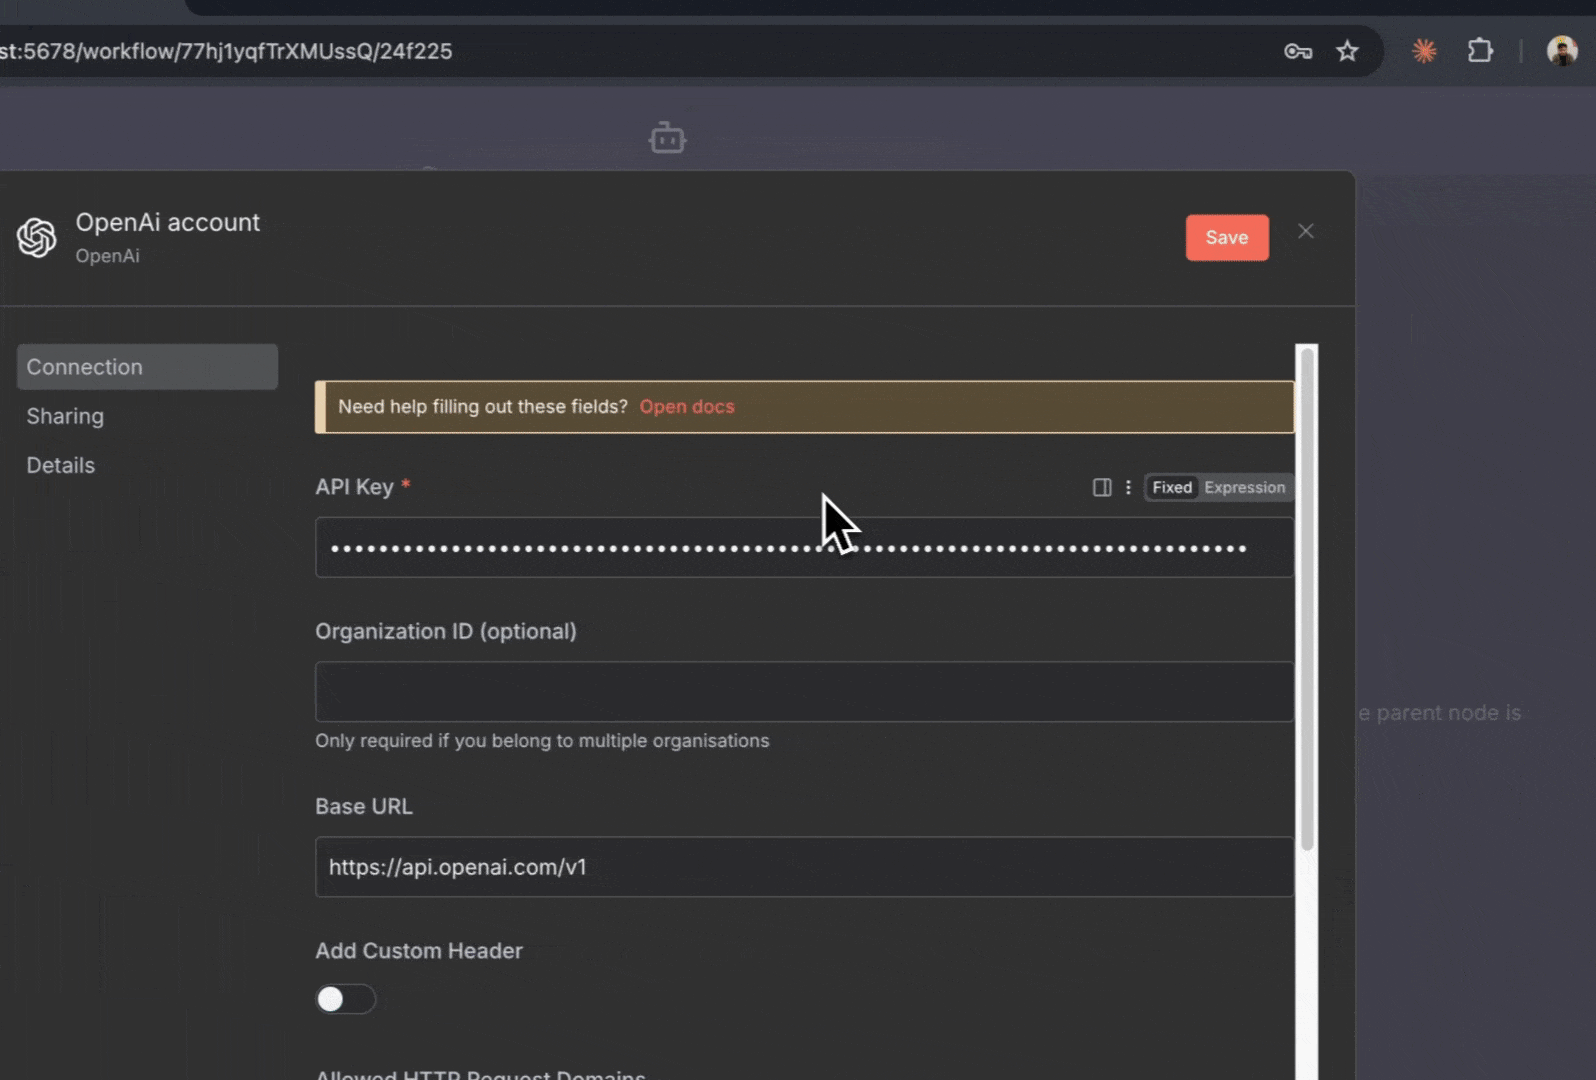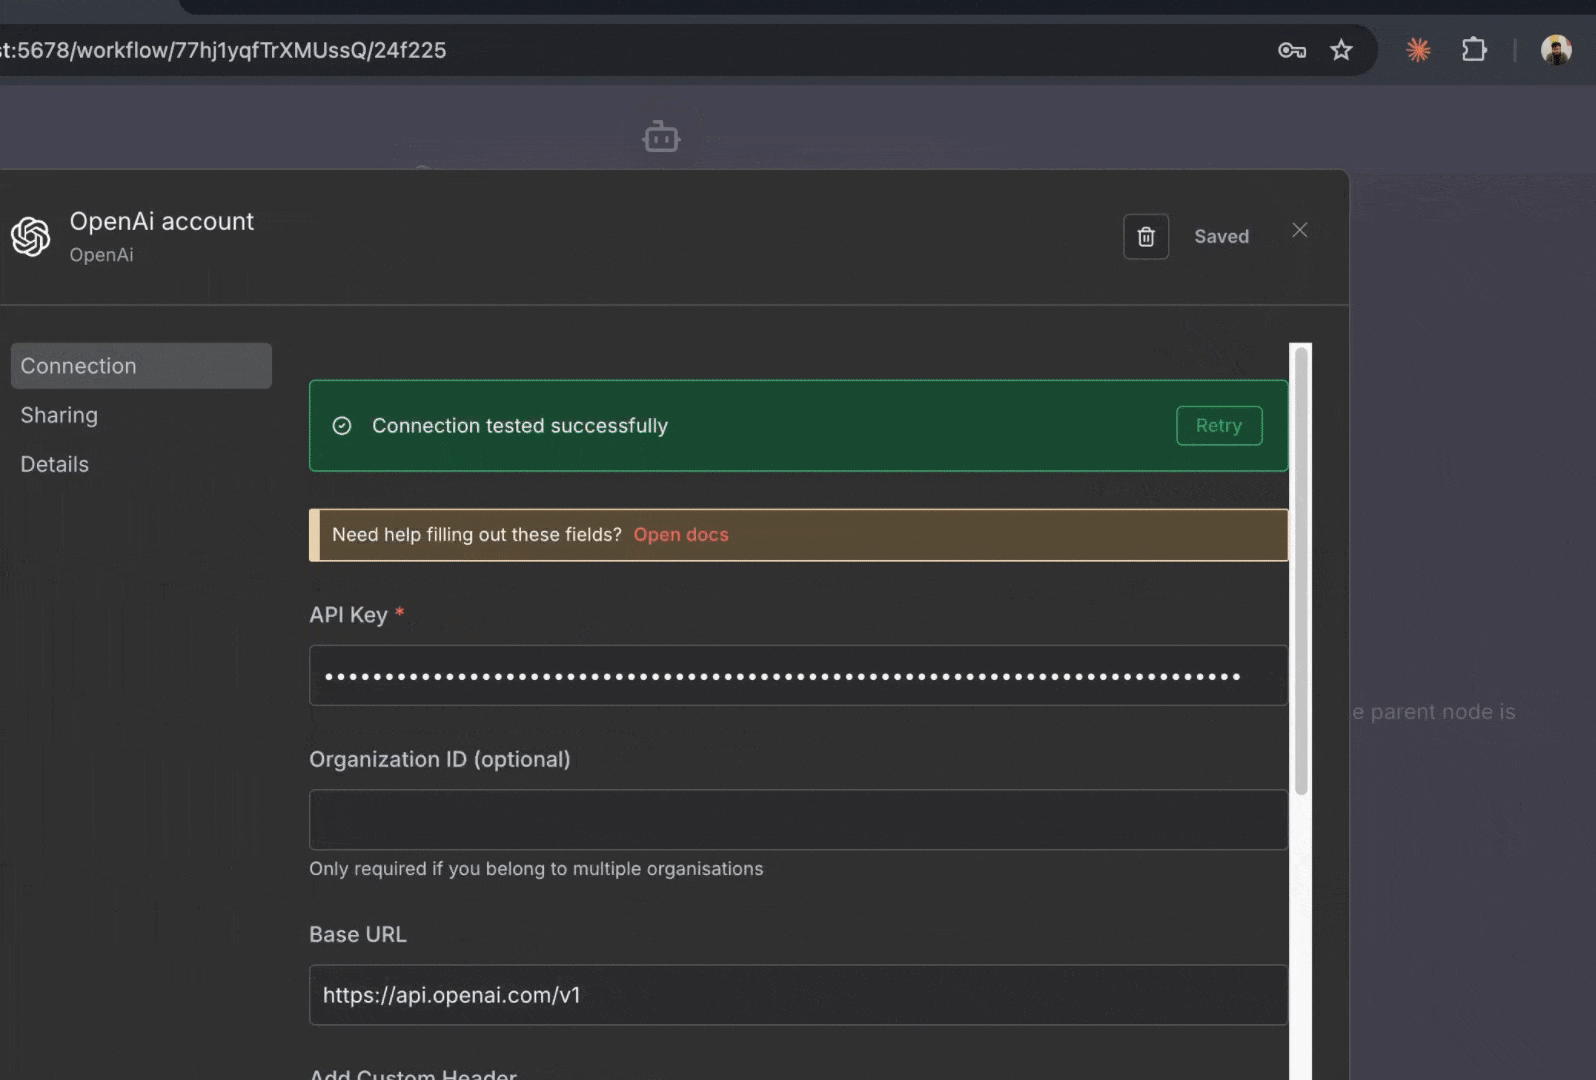
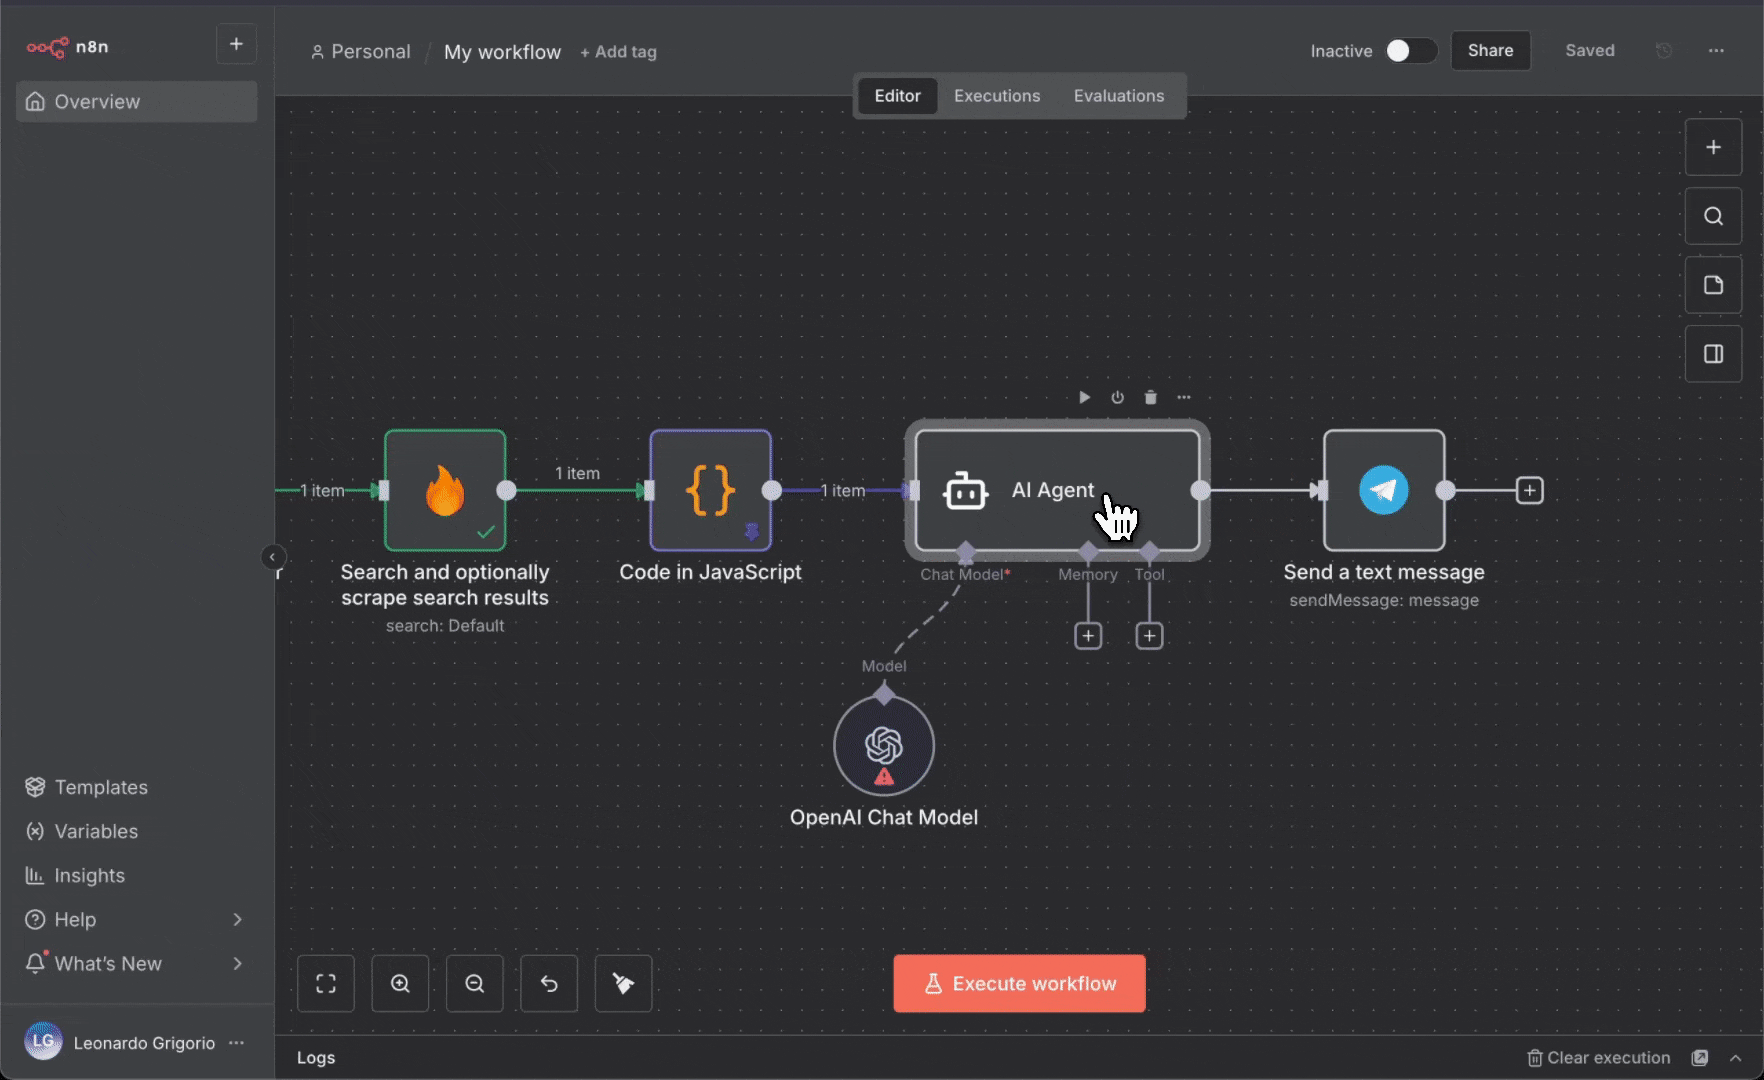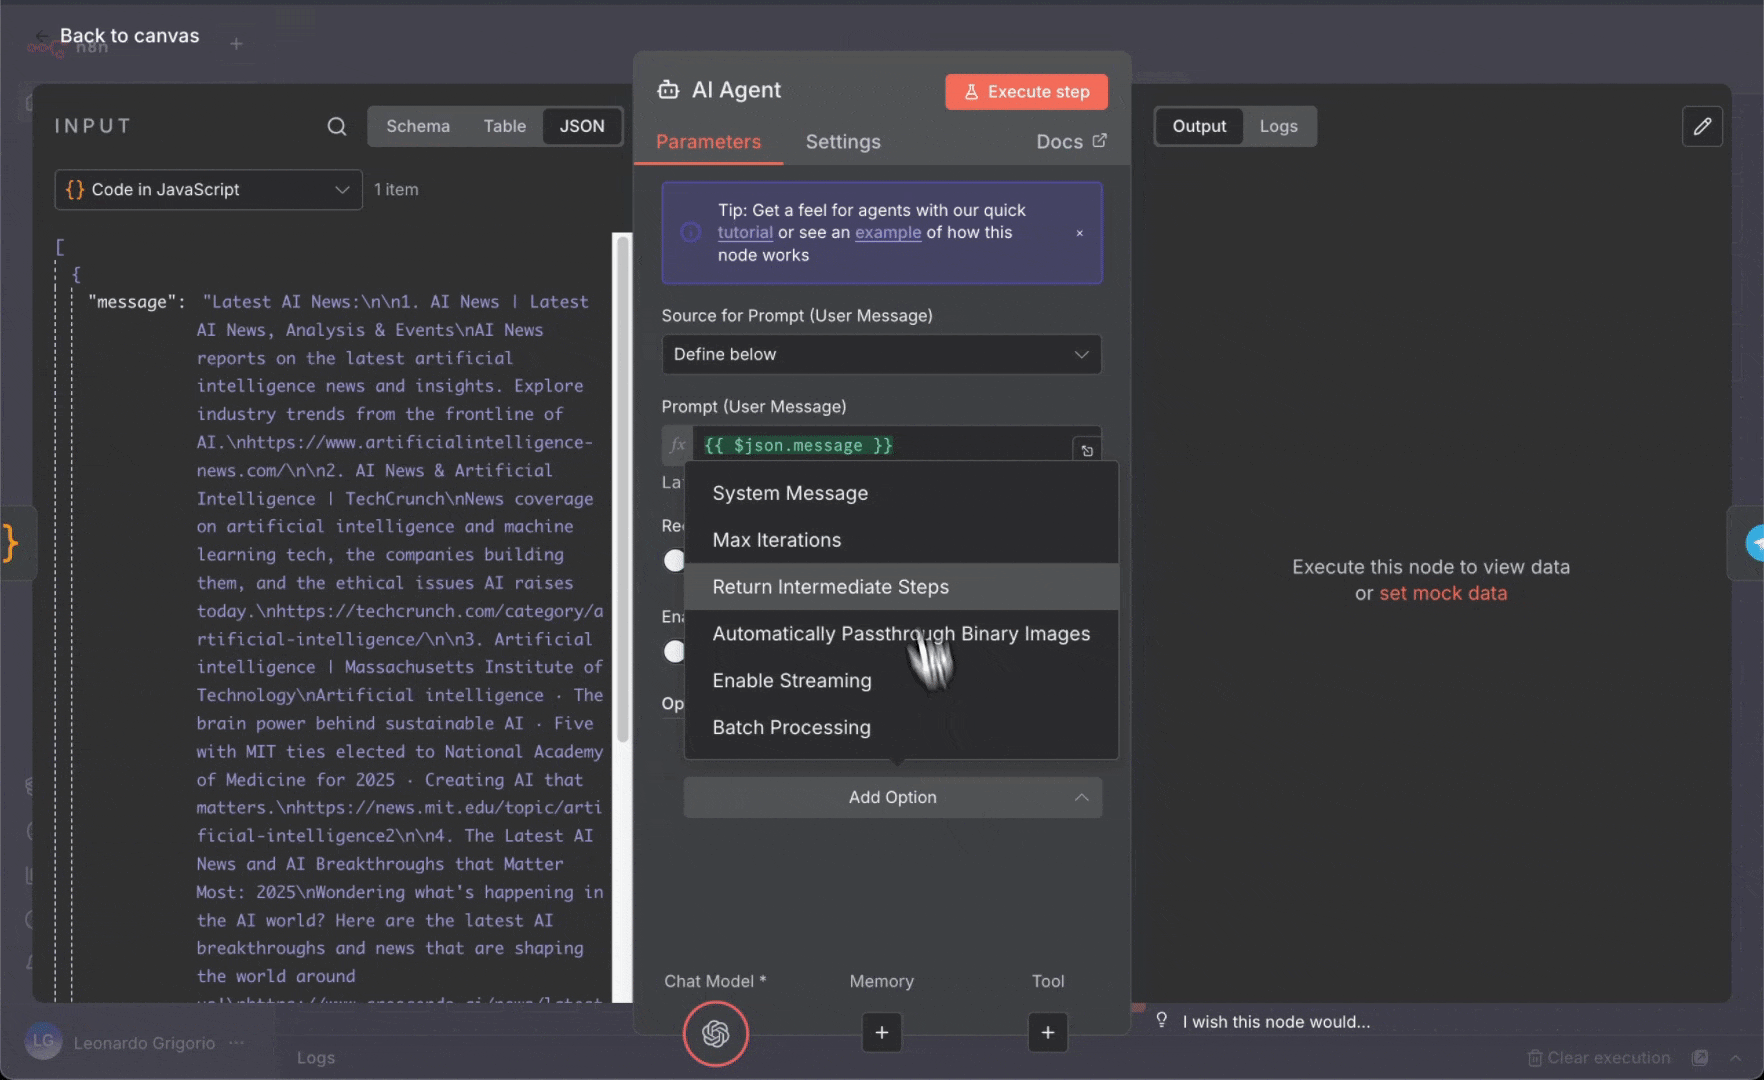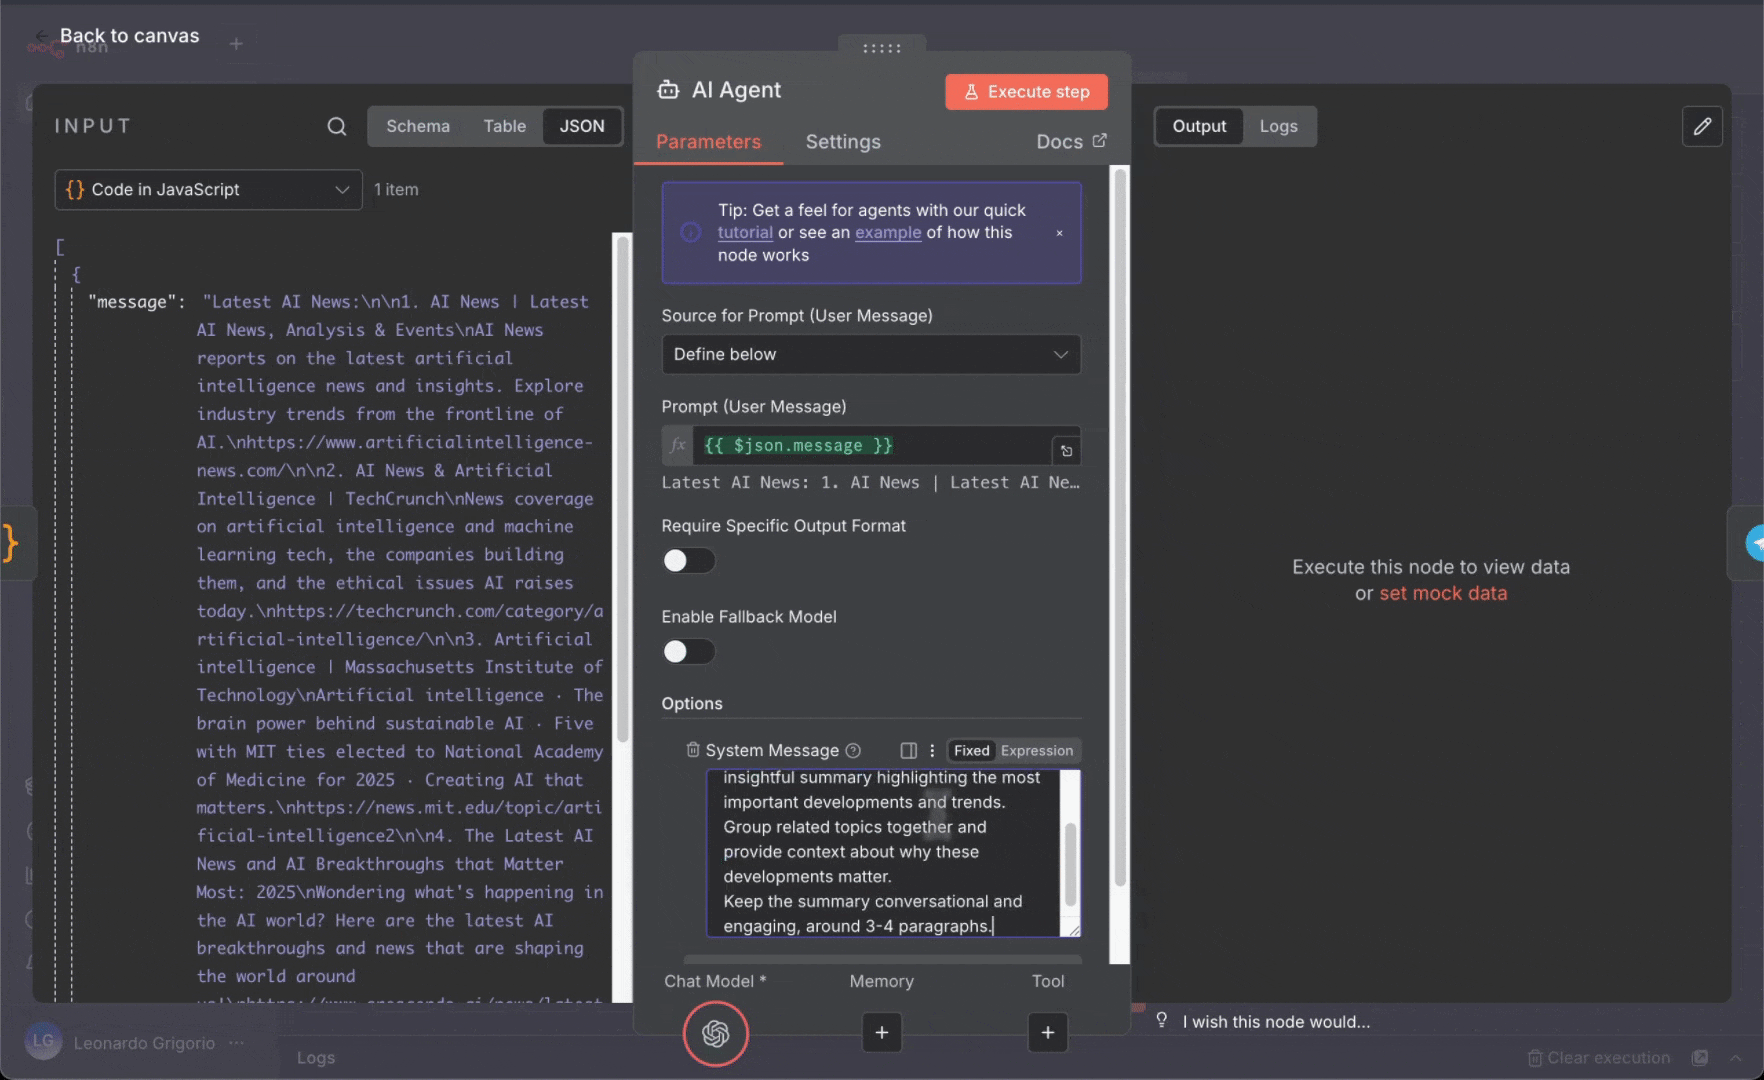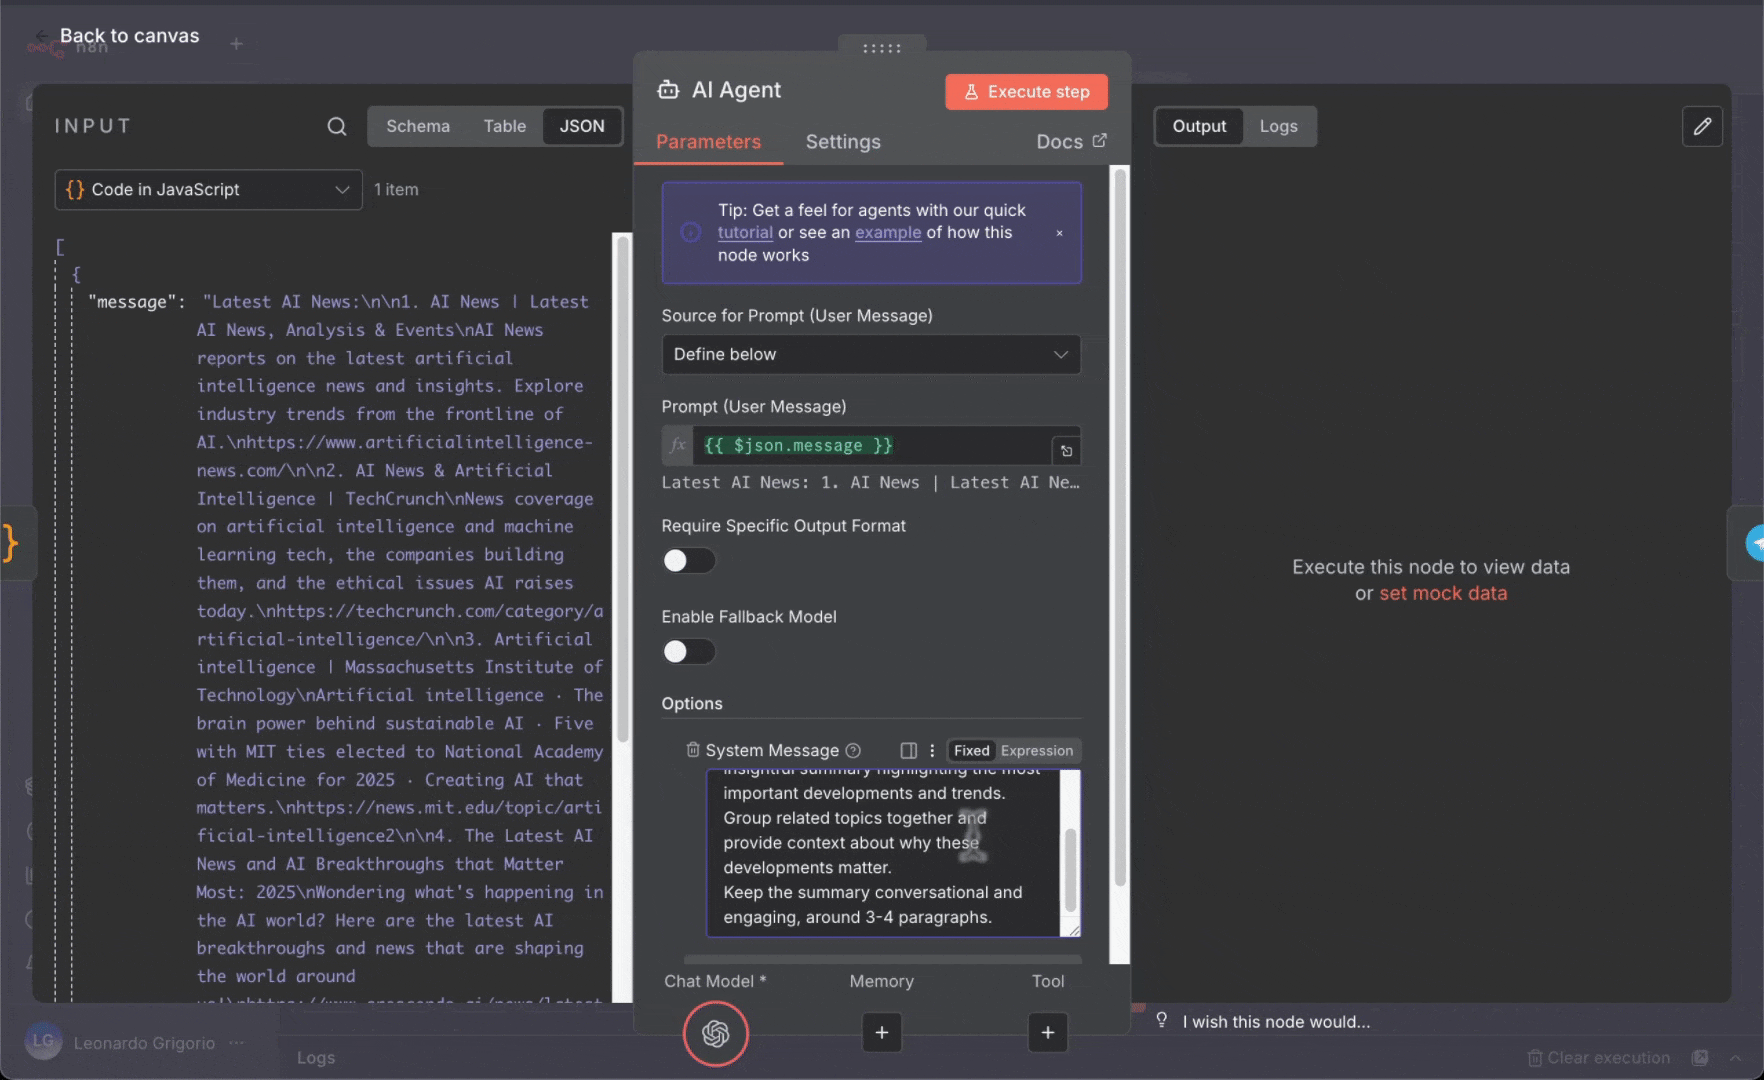
Ce workflow ajoute l’IA à l’exemple 2 en utilisant OpenAI pour générer des résumés pertinents des dernières actualités sur l’IA avant de les envoyer sur Telegram. Principales modifications par rapport à l’exemple 2 :- Configuration des identifiants OpenAI
- Ajout d’un nœud agent IA entre Code et Telegram
- agent IA analyse et résume intelligemment tous les articles d’actualité
- Telegram reçoit le résumé généré par l’IA au lieu de la liste brute d’actualités
- Obtenez votre clé API OpenAI :
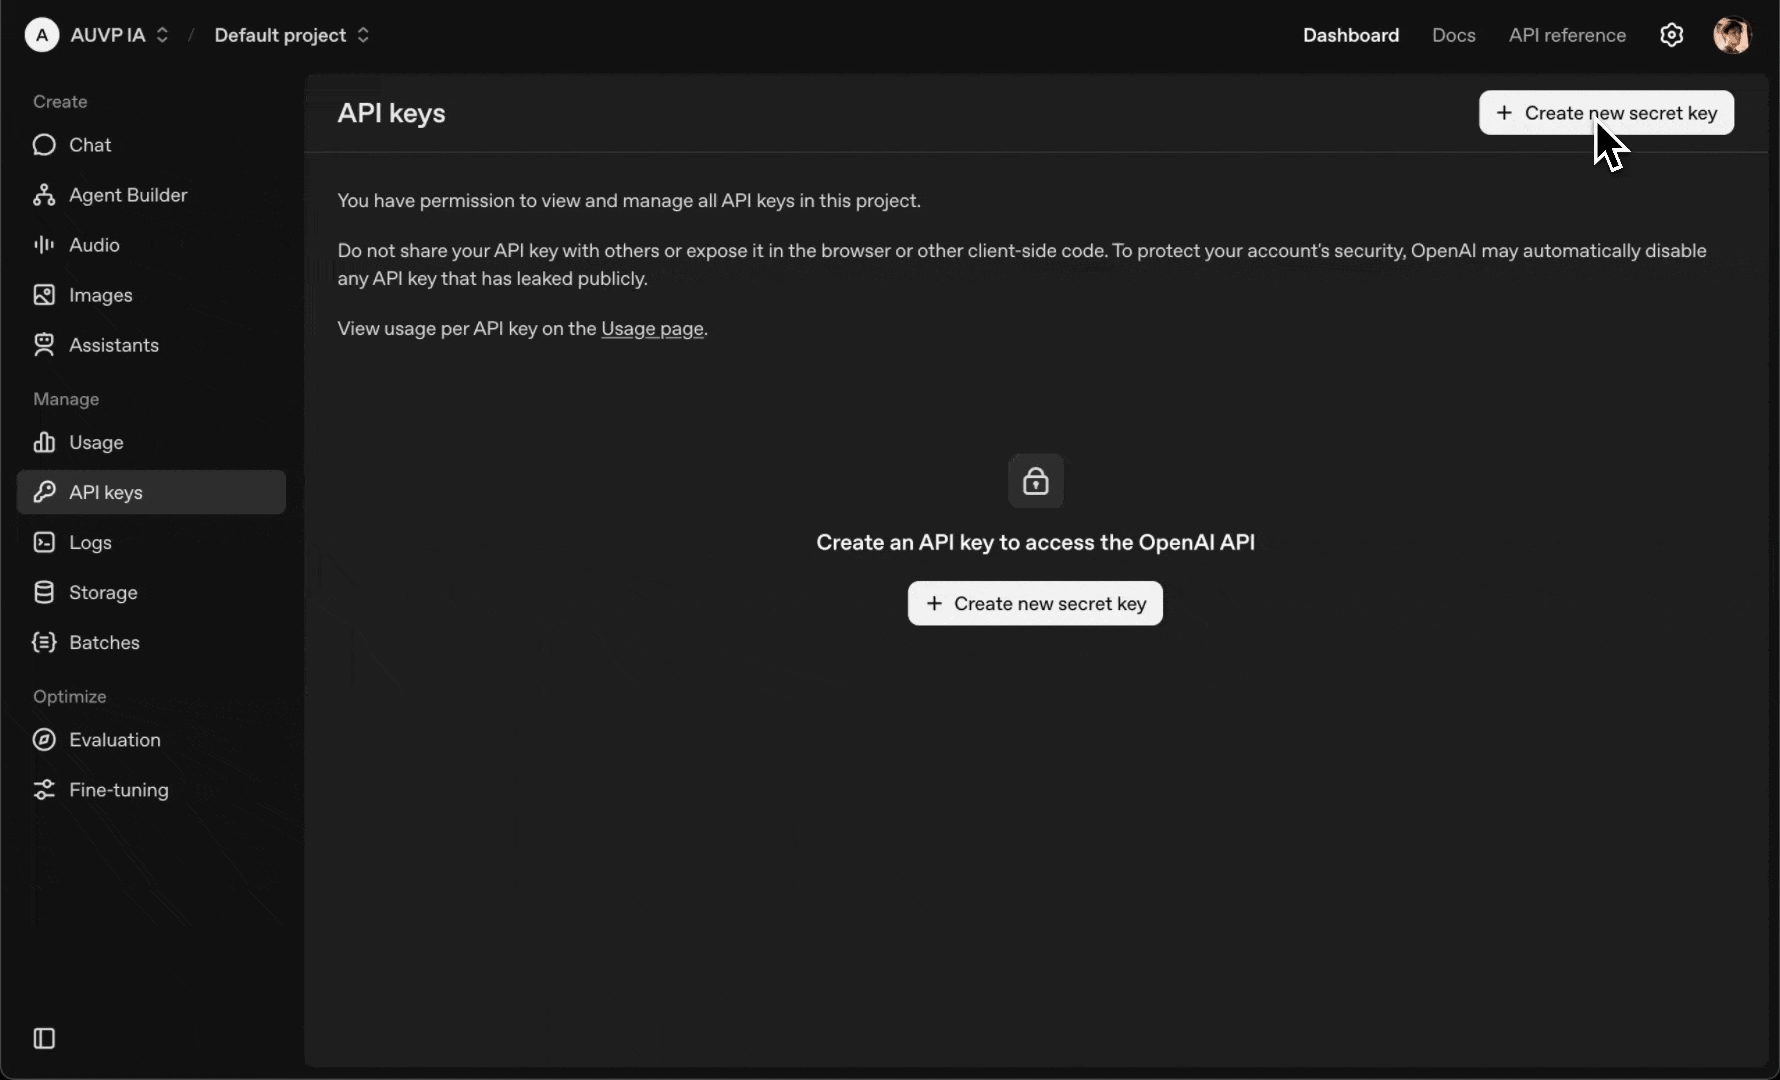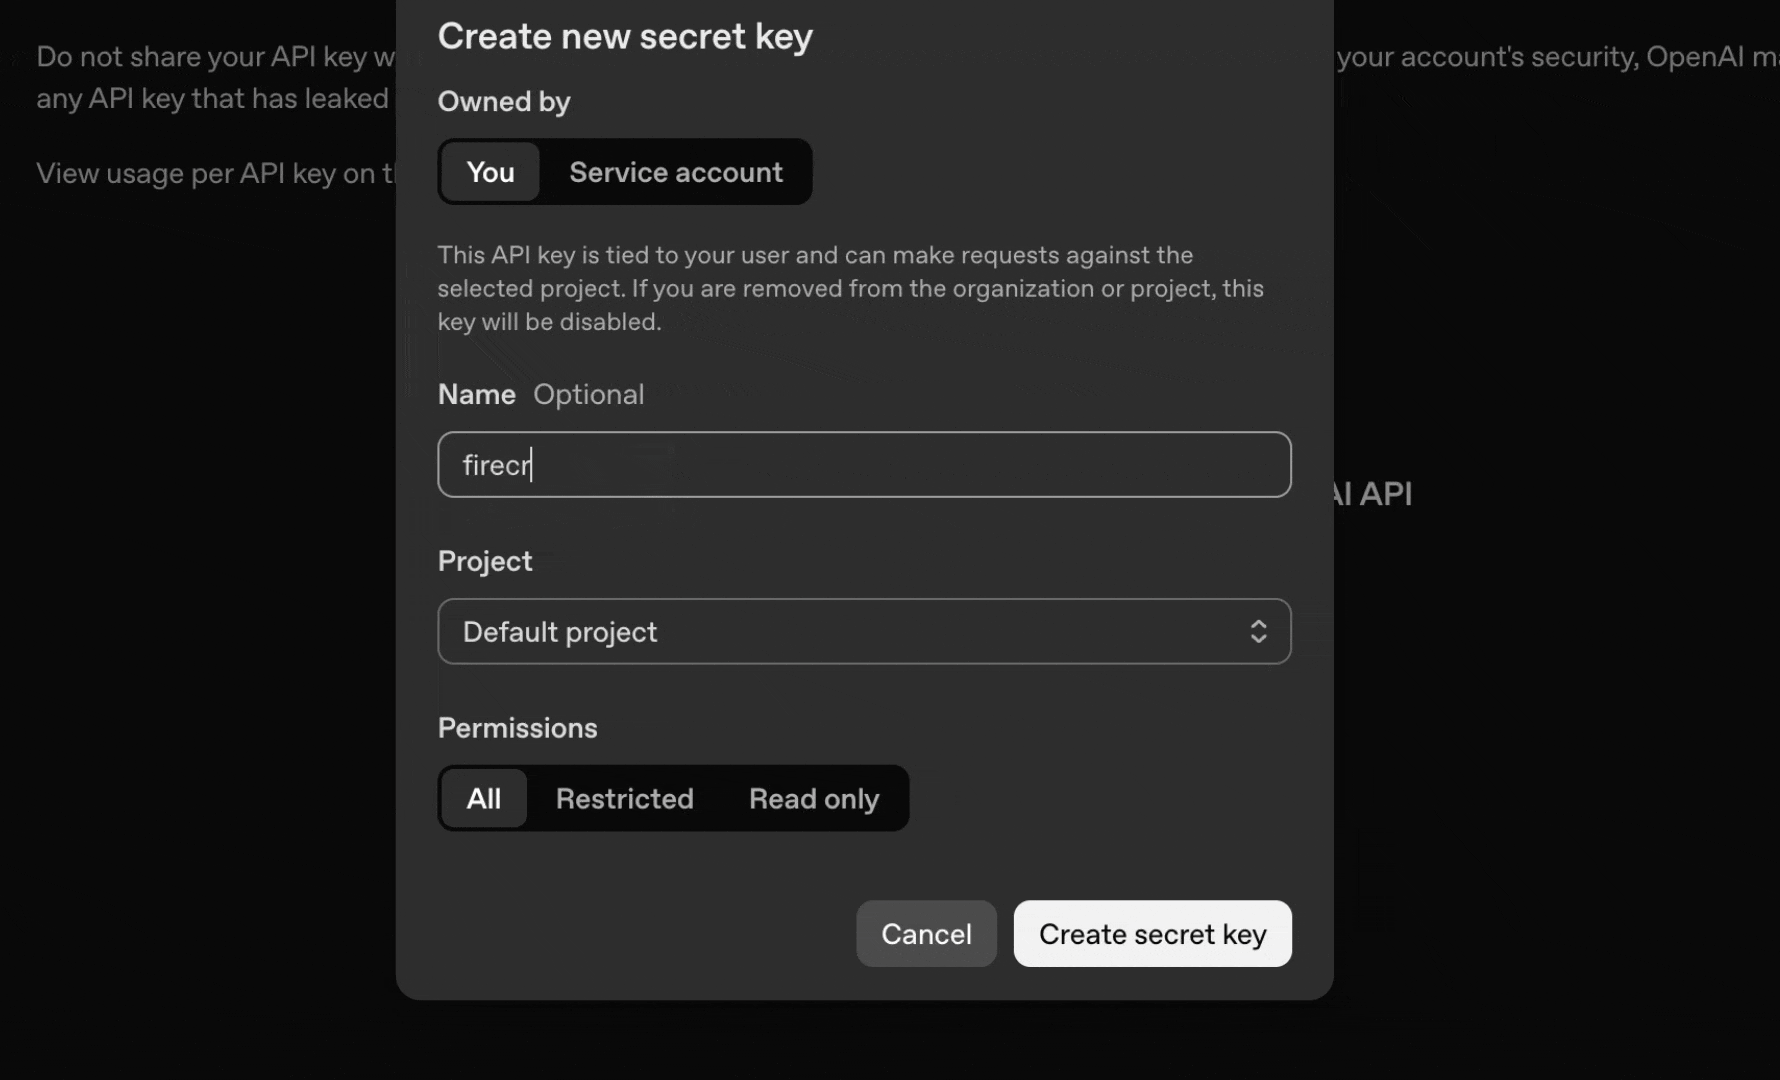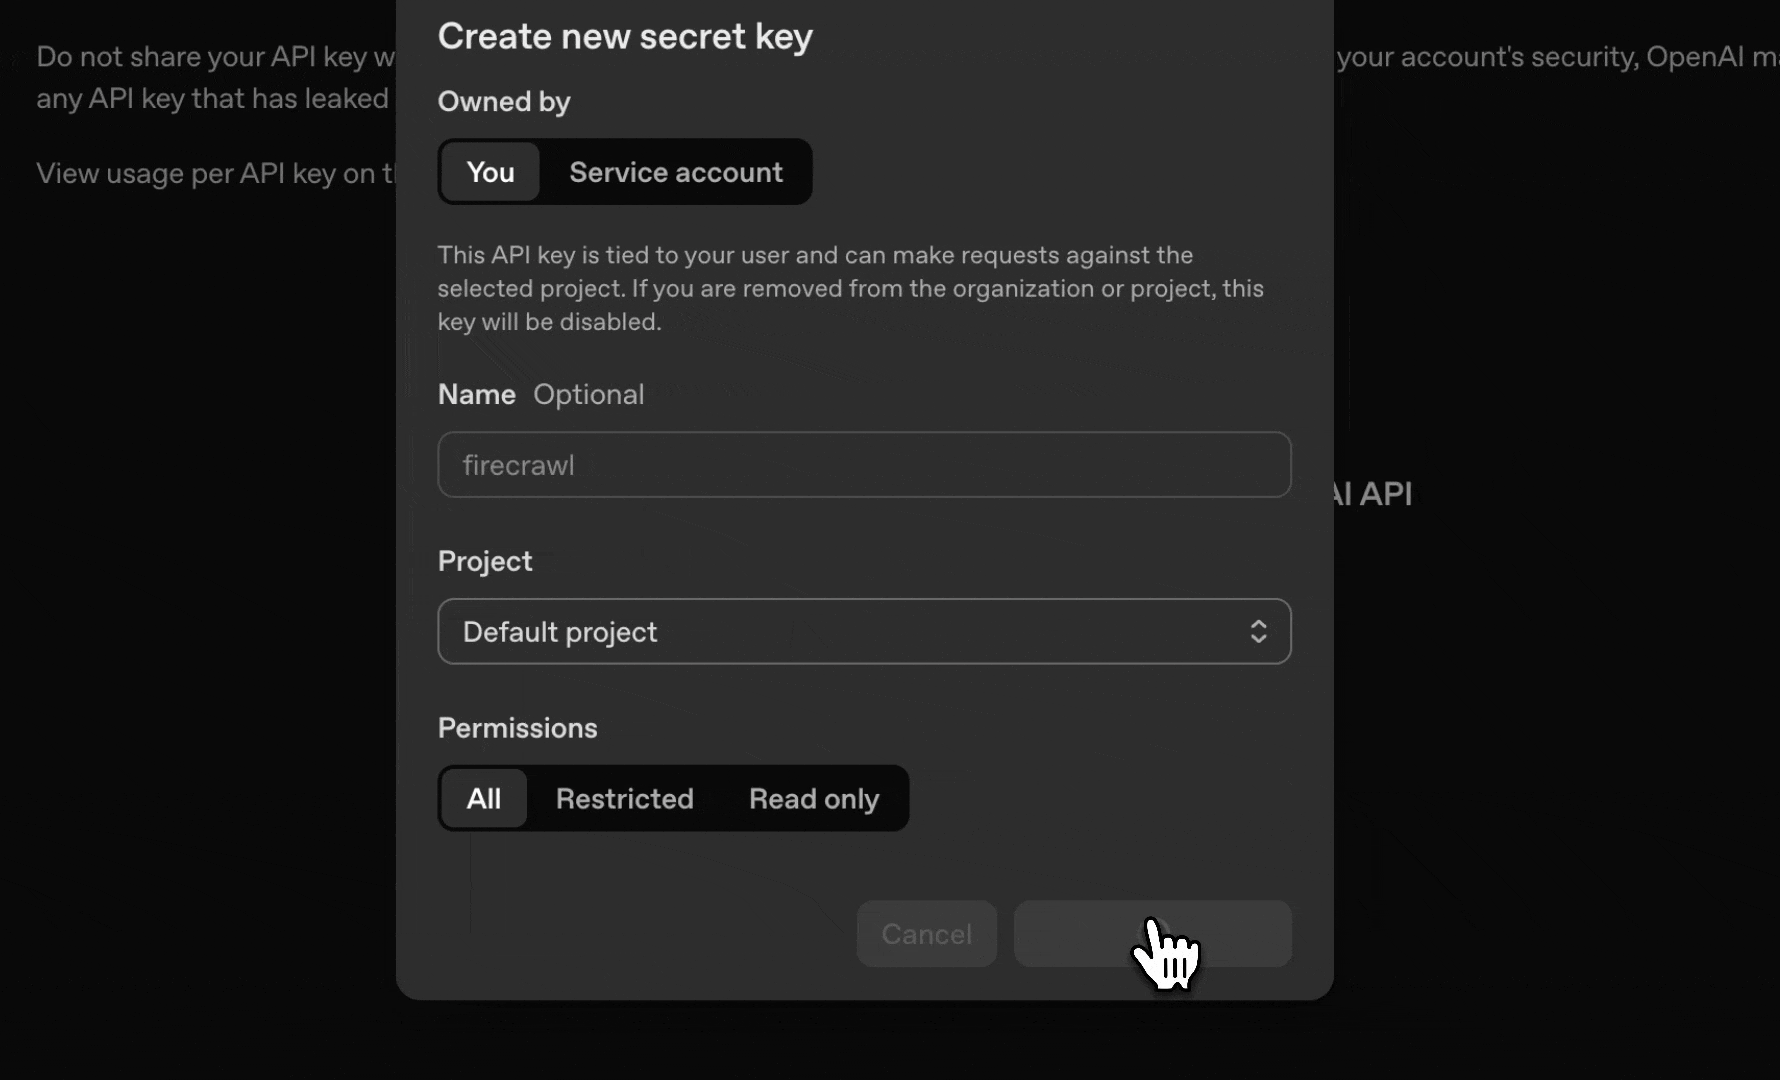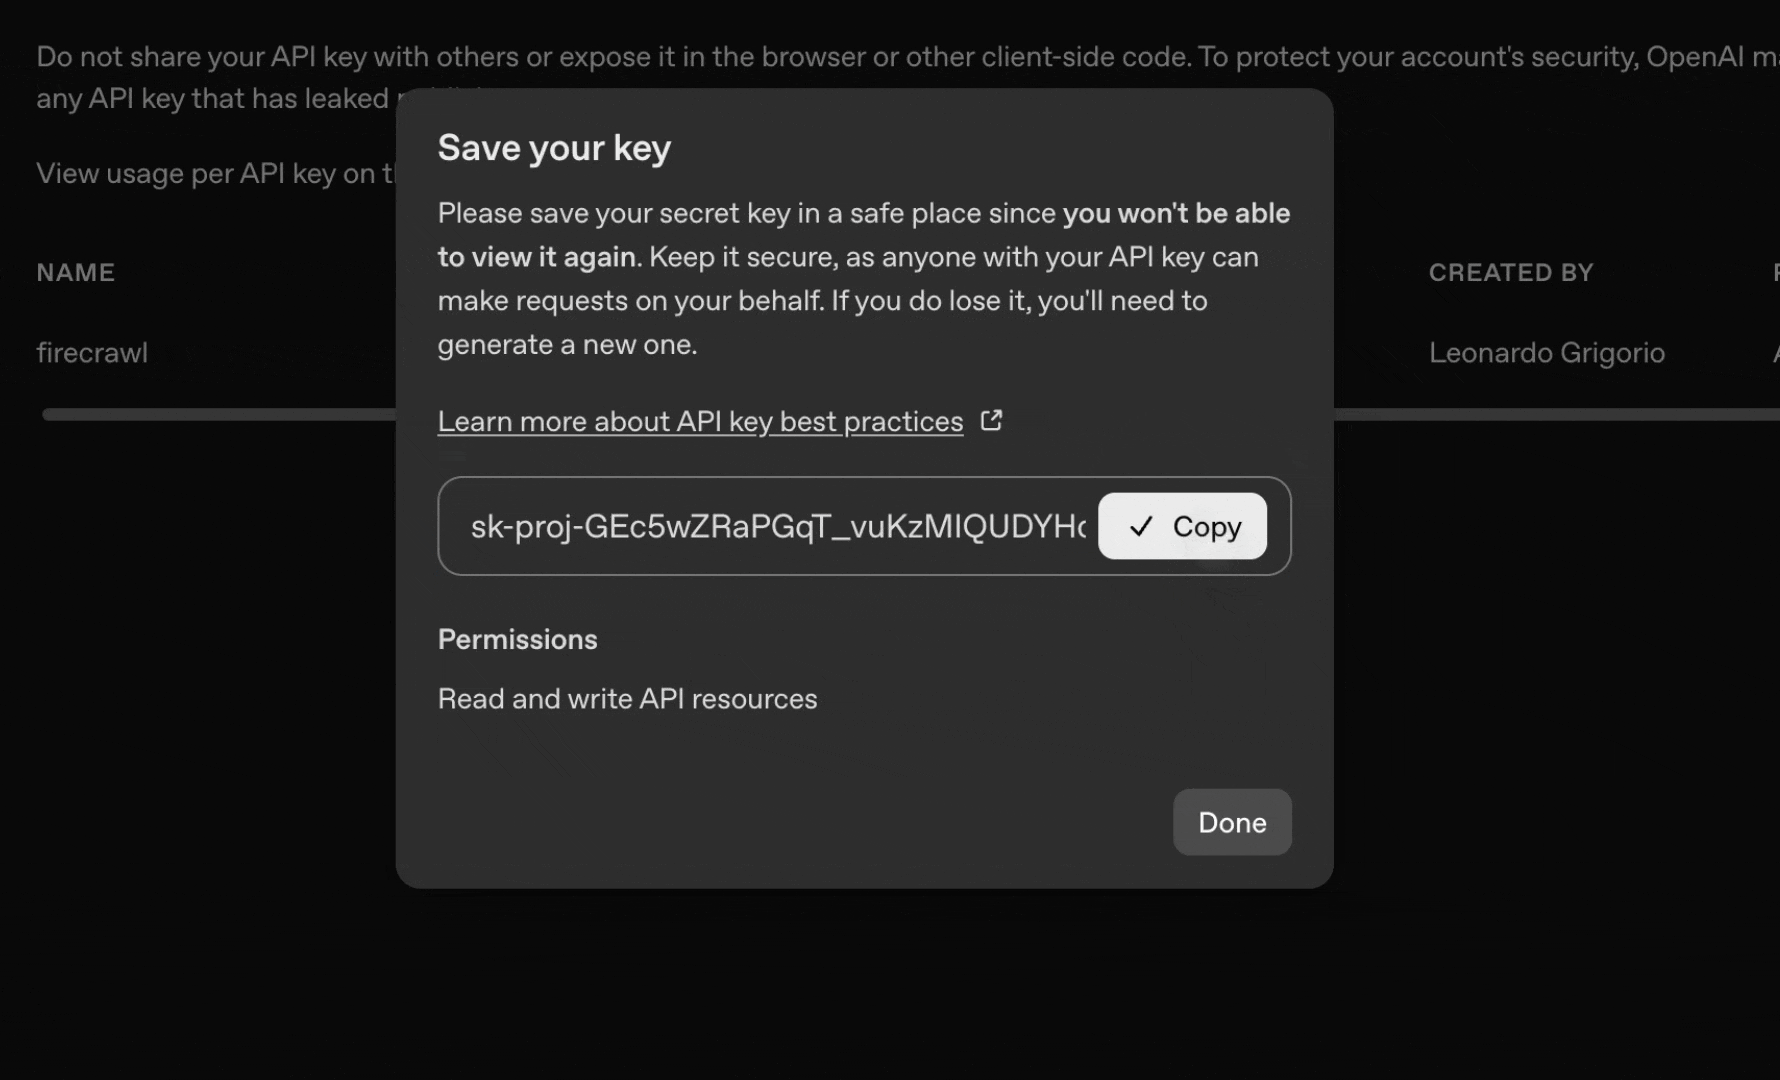
- Accédez à platform.openai.com/api-keys
- Connectez-vous ou créez un compte
- Cliquez sur “Create new secret key”
- Donnez-lui un nom (par exemple, “n8n Integration”)
- Copiez immédiatement la clé API (vous ne pourrez plus la consulter)
- Ajoutez et connectez le nœud agent IA :
- Cliquez sur ”+” après le nœud Code
- Recherchez “Basic LLM Chain” ou “agent IA”
- Faites glisser le champ
messagedu nœud Code vers le champ de prompt d’entrée de l’agent IA - Sélectionnez OpenAI comme fournisseur de LLM

- Ajoutez vos identifiants OpenAI :
- Cliquez sur “Create New Credential” pour OpenAI
- Collez votre clé API OpenAI
- Sélectionnez le modèle : gpt-5-mini (économique) ou gpt-5 (plus performant)
- Cliquez sur “Save”
- Ajoutez le system prompt à l’agent IA :
- Dans le nœud agent IA, ajoutez ce system prompt :
- Mettez à jour le nœud Telegram et testez :
- Mettez à jour le nœud Telegram :
- Texte : faites glisser la sortie de l’agent IA (le résumé généré)
- Supprimez l’ancien mapping vers le message du nœud Code
- Cliquez sur “Exécuter le workflow” pour tester
- L’IA analysera tous les articles d’actualité et créera un résumé
- Consultez Telegram pour voir le résumé généré par l’IA
- Mettez à jour le nœud Telegram :

L’agent IA reçoit tous les articles d’actualité mis en forme et crée un résumé intelligent, ce qui permet de comprendre plus facilement les tendances et les évolutions importantes en un coup d’œil.
Comprendre les opérations Firecrawl
Maintenant que vous avez créé quelques workflows, découvrons les différentes opérations Firecrawl disponibles dans n8n. Dans le nœud Firecrawl, vous choisissez d’abord une Ressource (Scraping, Crawling, Map & Search, Agent, Interact, Browser, Account ou Extract (Legacy)), puis une Opération. Chaque opération est conçue pour des cas d’utilisation spécifiques liés aux données web.Extraire le contenu d’une URL
Ressource : Scraping. Extrait le contenu d’une page web unique et le renvoie dans différents formats. Fonctionnalités :- Extrait le contenu d’une URL unique
- Renvoie du Markdown propre, du HTML ou des résumés générés par l’IA
- Renvoie des données structurées avec le format JSON et un prompt ou un schéma
- Peut capturer des captures d’écran et extraire des liens
- L’extraction d’articles
- La surveillance de pages produit
- Le scraping d’articles de blog
- La génération de résumés de pages
Interact
Ressource : Interact. Permet de continuer à travailler sur une page après Scrape URL : cliquer, remplir des formulaires et naviguer, à l’aide d’un prompt en langage naturel ou de code Playwright ou Bash. Opérations :- Execute Interaction : exécute un prompt ou du code sur une page scrapée, à partir du
scrapeIdissu de la sortie de Scrape URL (data.metadata.scrapeId) - Stop Interaction : met fin à la session interactive associée à ce
scrapeId - Get Interact Context : renvoie des instructions d’utilisation destinées aux agents IA qui appellent ces opérations en tant qu’outils
scrapeId et un prompt ou du code. N’ajoutez pas profile au corps de la requête Interact : Interact hérite du profil de la tâche de scraping.
Pour enregistrer les cookies, le localStorage et le reste de l’état du navigateur, exécutez Stop Interaction une fois le flux de travail terminé. Si vous avez uniquement besoin de lire un profil existant lors d’une exécution ultérieure du flux de travail, désactivez Save Changes dans les paramètres de profil de l’étape Scrape.
Si la version installée du node Firecrawl n8n n’affiche pas Profile dans l’opération Scrape URL, mettez à jour le node Firecrawl n8n vers la dernière version. Vous pouvez également transmettre le même objet profile via Additional Fields > Custom Properties (JSON) :
Rechercher sur le Web
Ressource : Map & Search. Effectue des recherches sur le Web et renvoie des résultats avec la possibilité de scraper leur contenu. Ce qu’elle fait :- Recherche sur le Web, dans les actualités ou parmi les images
- Renvoie les titres, les descriptions et les URL
- Peut scraper le contenu complet des résultats
- Automatiser la recherche
- Surveiller les actualités
- Découvrir les tendances
- Trouver du contenu pertinent
Explorer un site web
Ressource : Crawling. Découvre et scrape de manière récursive plusieurs pages d’un site web. Ce que cette opération fait :- Suit automatiquement les liens
- Scrape plusieurs pages en une seule tâche
- Peut filtrer les URL selon des motifs
- Renvoie un ID de tâche d’exploration ; ajoutez un second nœud Firecrawl avec Get Crawl Status pour lire les pages scrapées
- L’extraction complète d’une documentation
- L’archivage de sites
- La collecte de données sur plusieurs pages
Cartographier un site web
Ressource : Map & Search. Renvoie les URL trouvées sur un site web sans en scraper le contenu. Fonctionnement :- Découvre les liens d’un site
- Renvoie une liste d’URL épurée
- Rapide et léger
- La découverte d’URL
- La génération de sitemaps
- La planification de crawls plus vastes
Extraire des URL par lots
Ressource : Scraping. Extrait plusieurs URL en parallèle au sein d’une seule tâche. Ce qu’il fait :- Traite une liste d’URL en une seule fois, avec les mêmes options d’extraction pour chacune
- Plus efficace qu’une boucle
- Renvoie un ID de tâche de lot ; ajoutez Get Batch Scrape Status pour récupérer l’ensemble des résultats en une fois
- Traiter des listes d’URL
- Collecter des données en masse
- Projets de scraping à grande échelle
Agent
Ressource : Agent. Utilise un agent IA pour parcourir des sites web de manière autonome et en extraire des données à partir d’un prompt en langage naturel. Ce qu’il fait :- Accepte un prompt décrivant les données dont vous avez besoin, ainsi que des URL et un schéma JSON facultatifs
- L’agent IA navigue et extrait les informations de manière autonome
- Disponible sous deux formes : Extract Data With AI Agent (attend les résultats) et Start AI Agent Job (Async) (renvoie immédiatement un ID de tâche)
- Utilisez Get Agent Status pour interroger l’état et récupérer les résultats avec l’opération asynchrone
- La collecte de données complexe sur plusieurs pages, guidée par un prompt
- L’extraction d’informations lorsque vous ne connaissez pas la structure exacte de la page
- Les tâches de recherche qui nécessitent de naviguer sur plusieurs pages
- Extract Data With AI Agent démarre la tâche et attend le résultat en une seule étape : c’est l’option la plus simple dans la plupart des cas d’utilisation. Le paramètre Max Wait Time définit la durée pendant laquelle le nœud interroge l’état avant l’expiration du délai (par défaut : 300 secondes, maximum : 600 secondes). Si la tâche d’agent dure plus longtemps, le nœud renvoie un état
timeoutavec lejobId, même si la tâche peut encore aboutir côté Firecrawl. Transmettez cet ID à Get Agent Status, ou utilisez l’opération asynchrone pour les tâches susceptibles de dépasser 10 minutes. - Start AI Agent Job (Async) renvoie immédiatement un ID de tâche. Ajoutez un second nœud Firecrawl avec l’opération Get Agent Status pour récupérer les résultats une fois la tâche terminée.
Extraire des données structurées (ancienne version)
Ressource : Extract (Legacy). Utilise l’IA pour extraire des informations structurées d’une liste d’URL à partir d’un prompt ou d’un schéma. L’opération Get Extract Status permet ensuite d’en récupérer les résultats. Cette ressource appelle l’ancien point de terminaison/extract. Pour les nouveaux flux de travail, privilégiez Agent, ou Extraire le contenu d’une URL avec le format JSON si vous connaissez déjà la page.
Browser Sandbox
Ressource : Browser. Fournit une session de navigateur persistante que vous pouvez contrôler par code, afin d’automatiser le navigateur en plusieurs étapes au sein d’une même session. Opérations :- Create Browser Session : démarre une nouvelle session de navigateur et renvoie son
id - Execute Browser Code : exécute du code Node (Playwright), Python ou Bash dans la session, en utilisant l’
idobtenu à l’étape Create comme Session ID - Get Many Browser Sessions : répertorie les sessions actives ou détruites
- Delete Browser Session : détruit une session lorsque vous avez terminé
- Get Browser Context : renvoie les instructions d’utilisation et les sessions actives aux agents IA qui appellent ces opérations en tant qu’outils
- Les workflows de navigateur en plusieurs étapes nécessitant de conserver l’état entre les pages
- La navigation dans des pages dynamiques lorsque le nombre d’étapes n’est pas connu à l’avance
- Les workflows utilisant des profils de navigateur persistants pour conserver les cookies et le localStorage entre les exécutions
id de session obtenu à l’étape Create à chaque étape Execute ou Delete suivante. Utilisez le nœud Loop Over Items de n8n pour parcourir une liste dynamique de pages et appeler Execute pour chacune d’elles au sein de la même session.
Pour en savoir plus sur la fonctionnalité Browser Sandbox, consultez la documentation de Browser Sandbox.
Compte
Ressource : Account. Récupère l’utilisation des crédits, l’utilisation des jetons et l’état de la file d’attente de votre équipe, ce qui permet à un flux de travail de vérifier les crédits restants avant de lancer une tâche volumineuse.Modèles et exemples de workflows
Plutôt que de créer un workflow de A à Z, vous pouvez démarrer à partir de modèles prédéfinis. La communauté n8n a créé de nombreux workflows Firecrawl que vous pouvez copier et personnaliser.Modèles à la une
Tutoriel complet n8n
Créez un chatbot IA avec accès au web à l’aide de Firecrawl et n8n
8 workflows prêts pour la production
Modèles prêts à l’emploi pour la génération de prospects, la surveillance des prix et bien plus encore
Pipeline RAG Supabase pgvector
Scrapez des pages, générez des embeddings et stockez-les dans Supabase pgvector pour le RAG
Enrichissement de prospects par IA
Scrapez les sites web d’entreprises et extrayez des signaux commerciaux structurés
Pipeline RAG Pinecone
Scrapez des pages, générez des embeddings et stockez-les dans Pinecone pour le RAG
Workflows de la communauté n8n
Parcourez des centaines de workflows utilisant Firecrawl
Intégration officielle de n8n
Consultez la documentation officielle de l’intégration
Comment importer des modèles
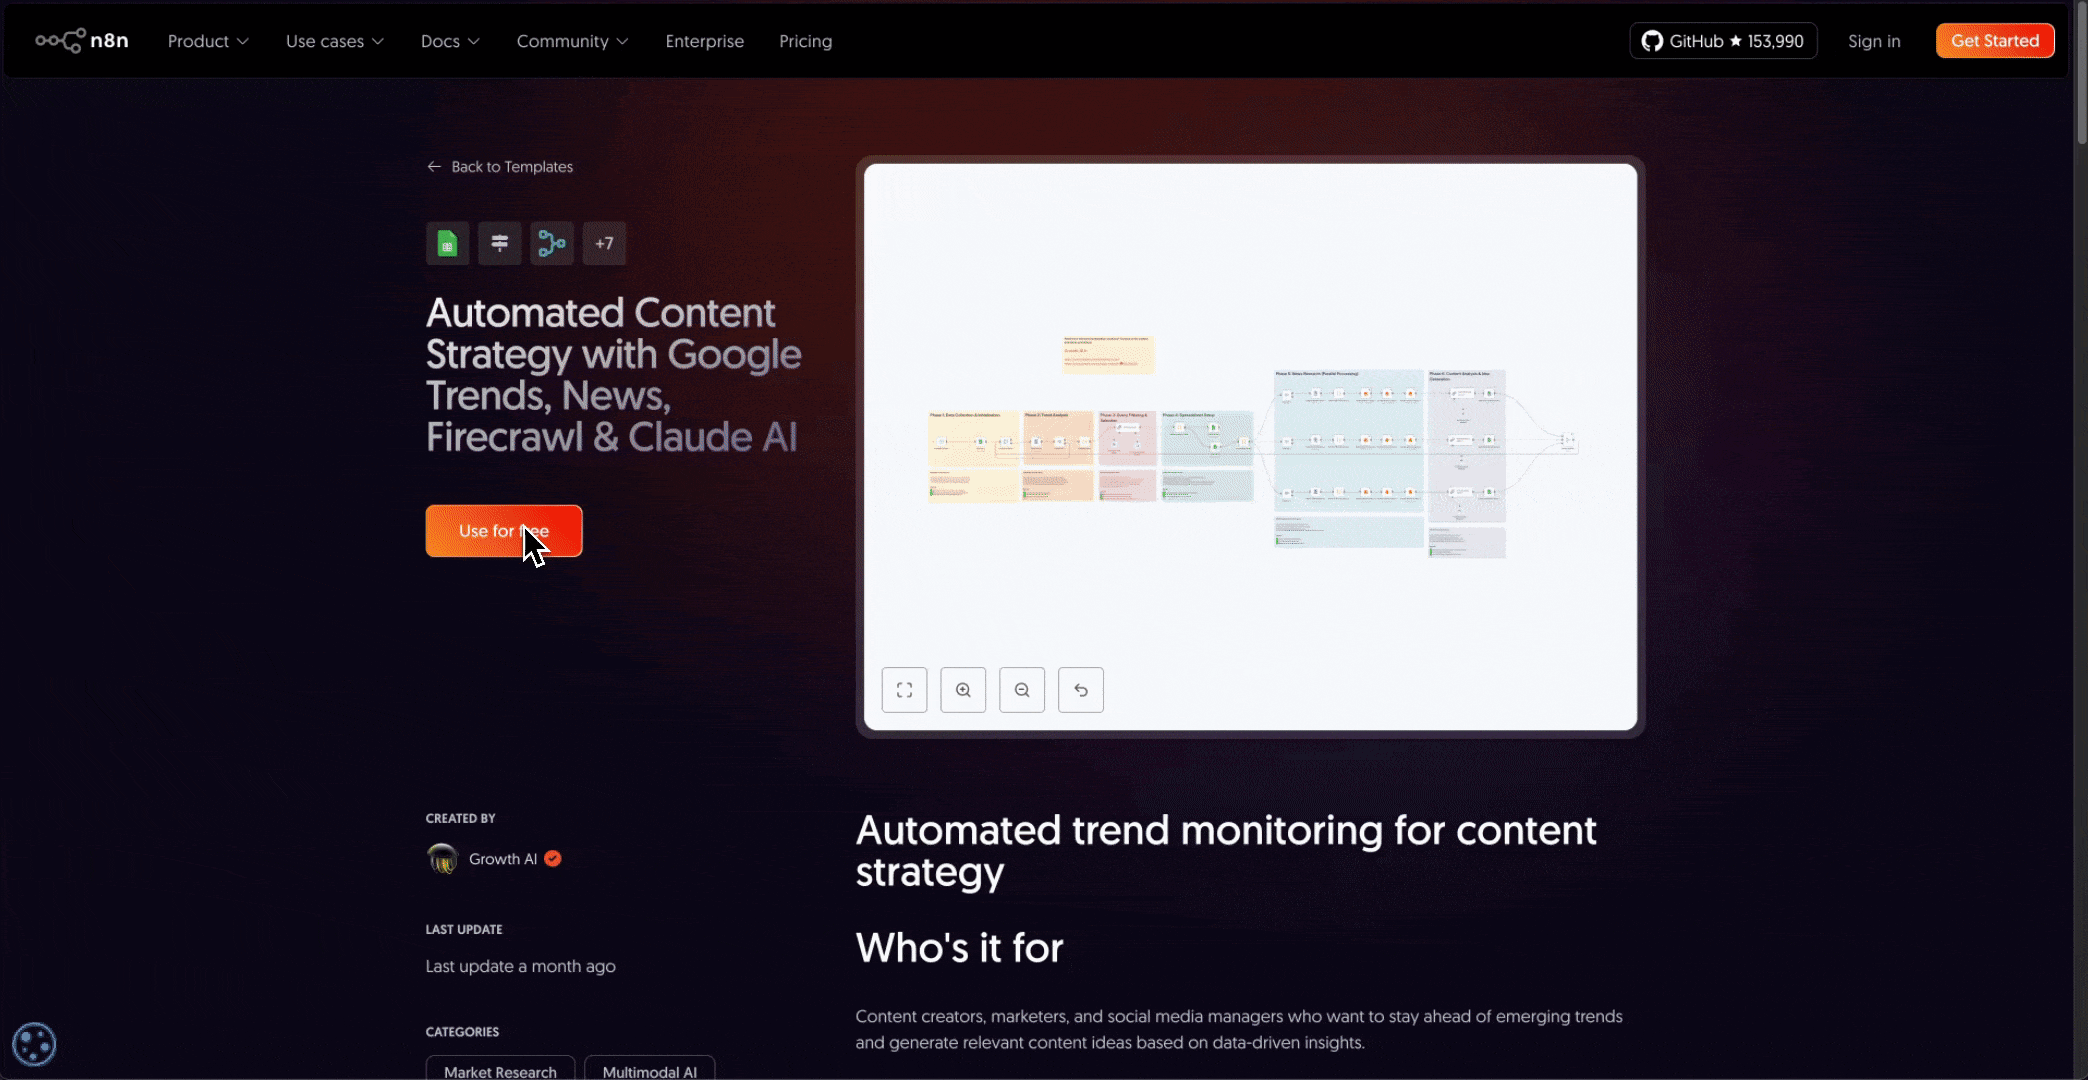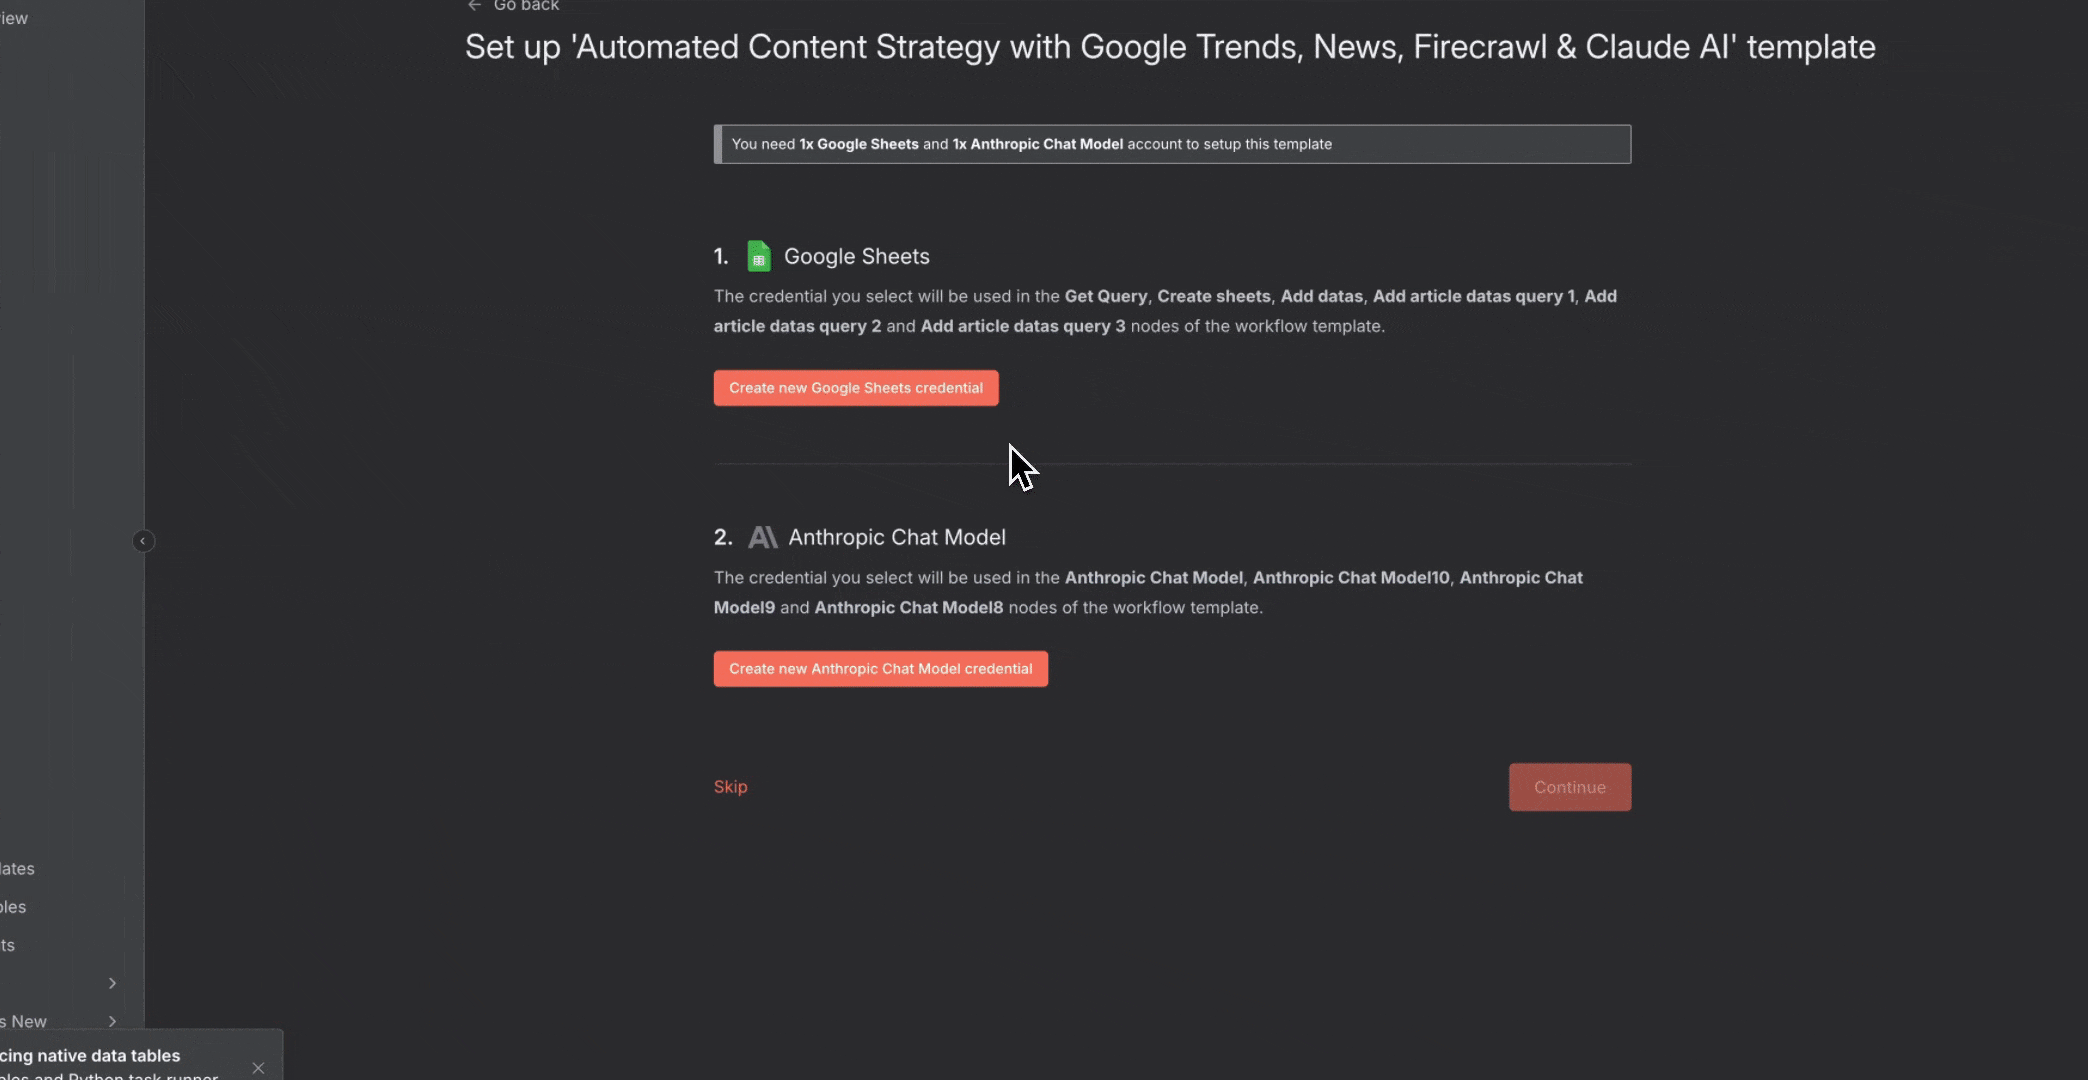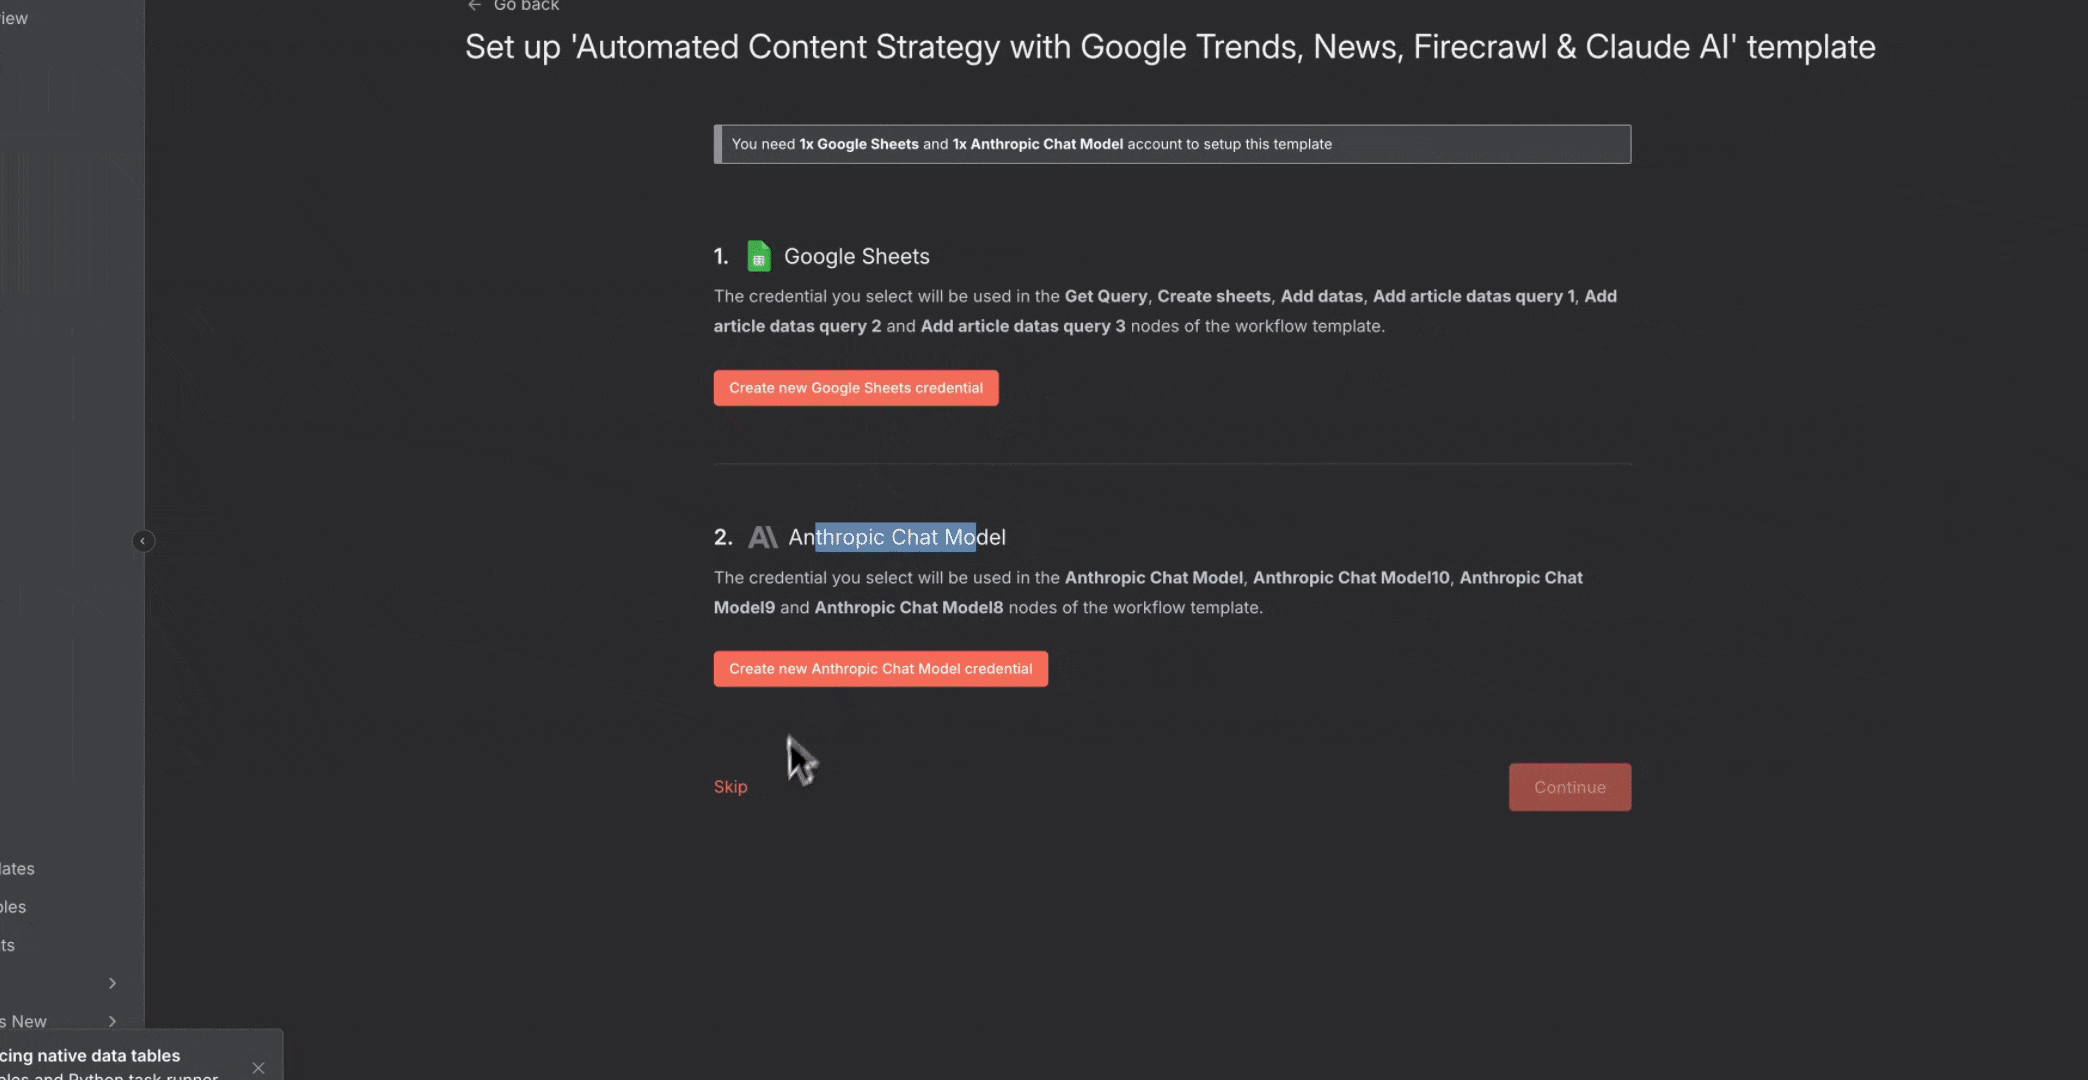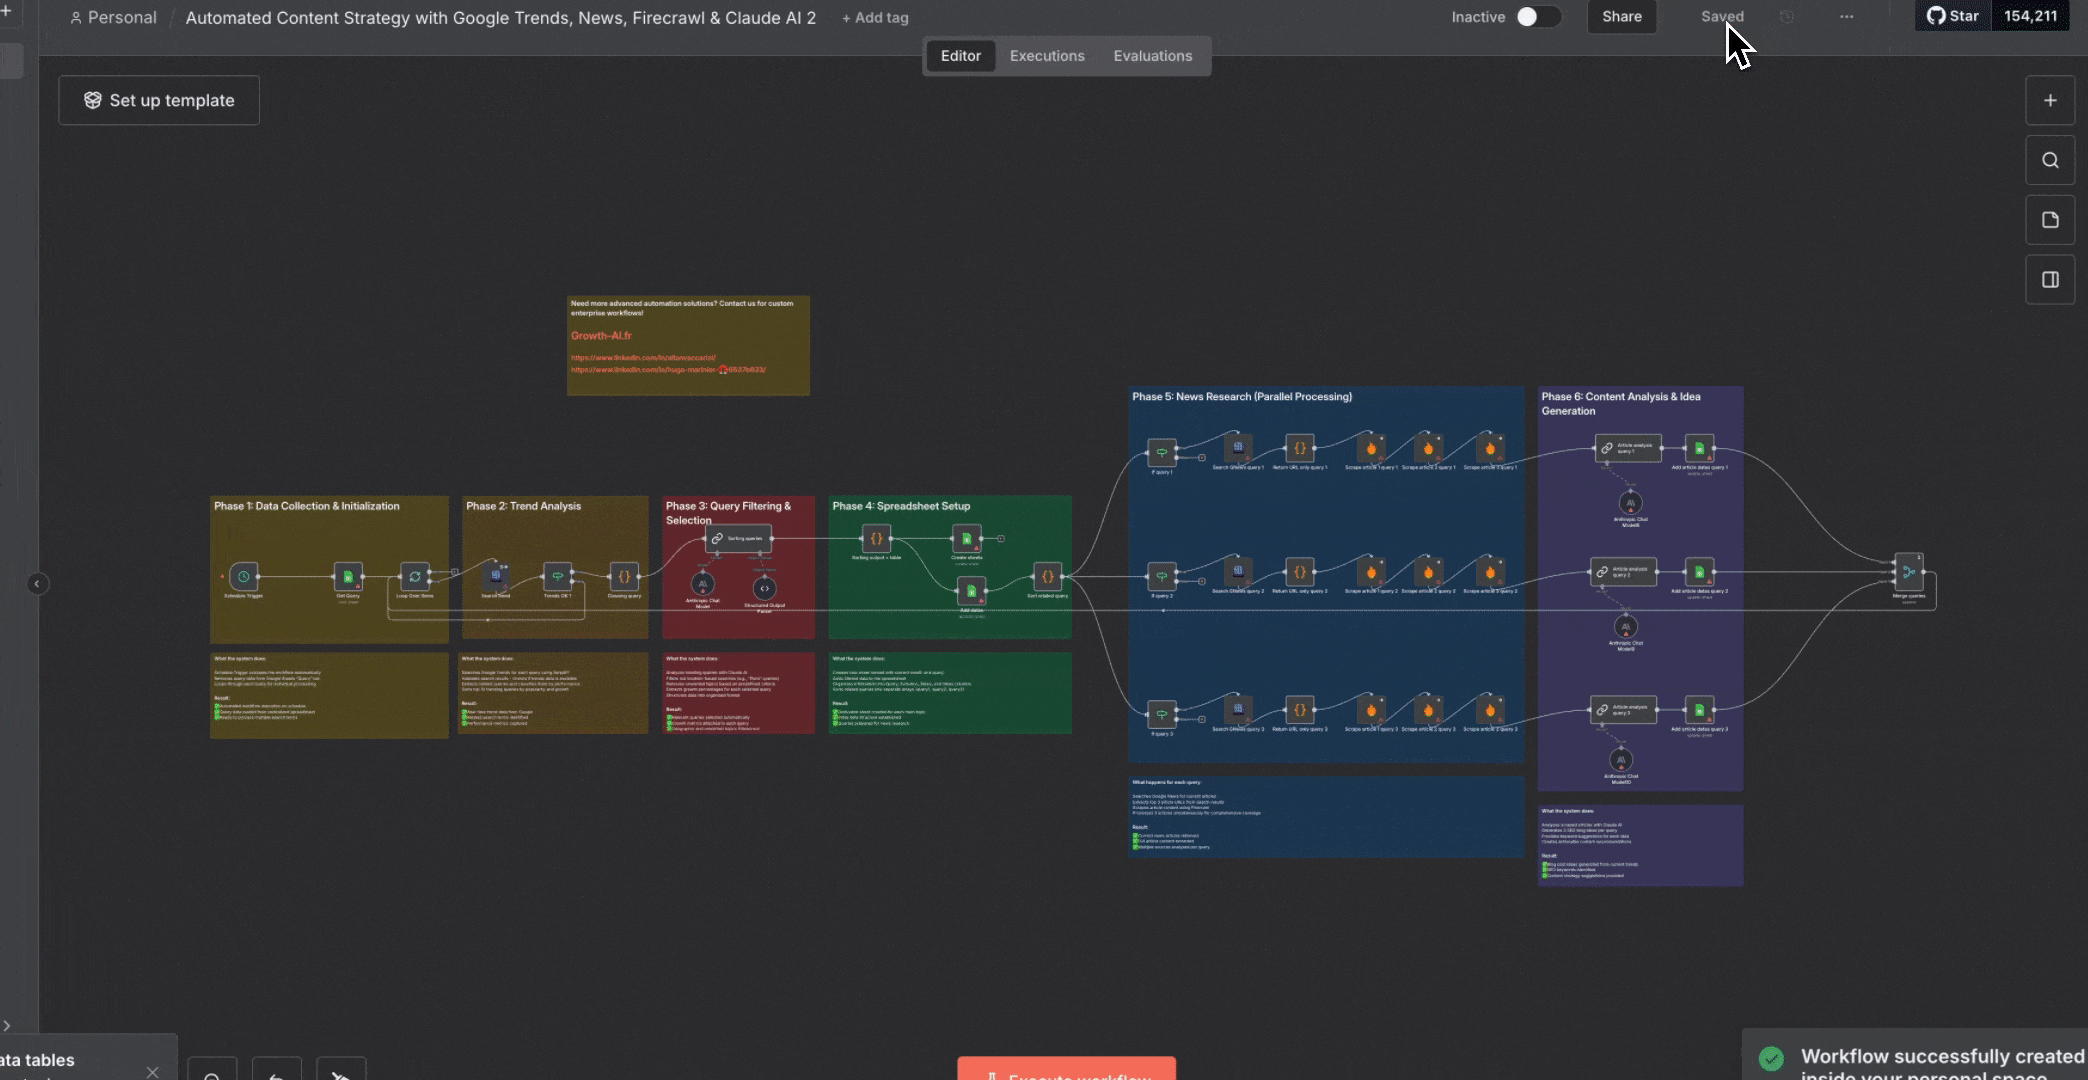
Pour utiliser un modèle de la communauté n8n :- Cliquez sur un lien vers un modèle de workflow
- Sur la page du modèle, cliquez sur le bouton « Import template to localhost:5678 self-hosted instance »
- Le workflow s’ouvre dans votre instance n8n
- Configurez les identifiants de chaque nœud
- Personnalisez les paramètres selon votre cas d’utilisation
- Activez le workflow
Bonnes pratiques
Suivez ces recommandations pour créer des workflows fiables et efficaces :Tests et débogage
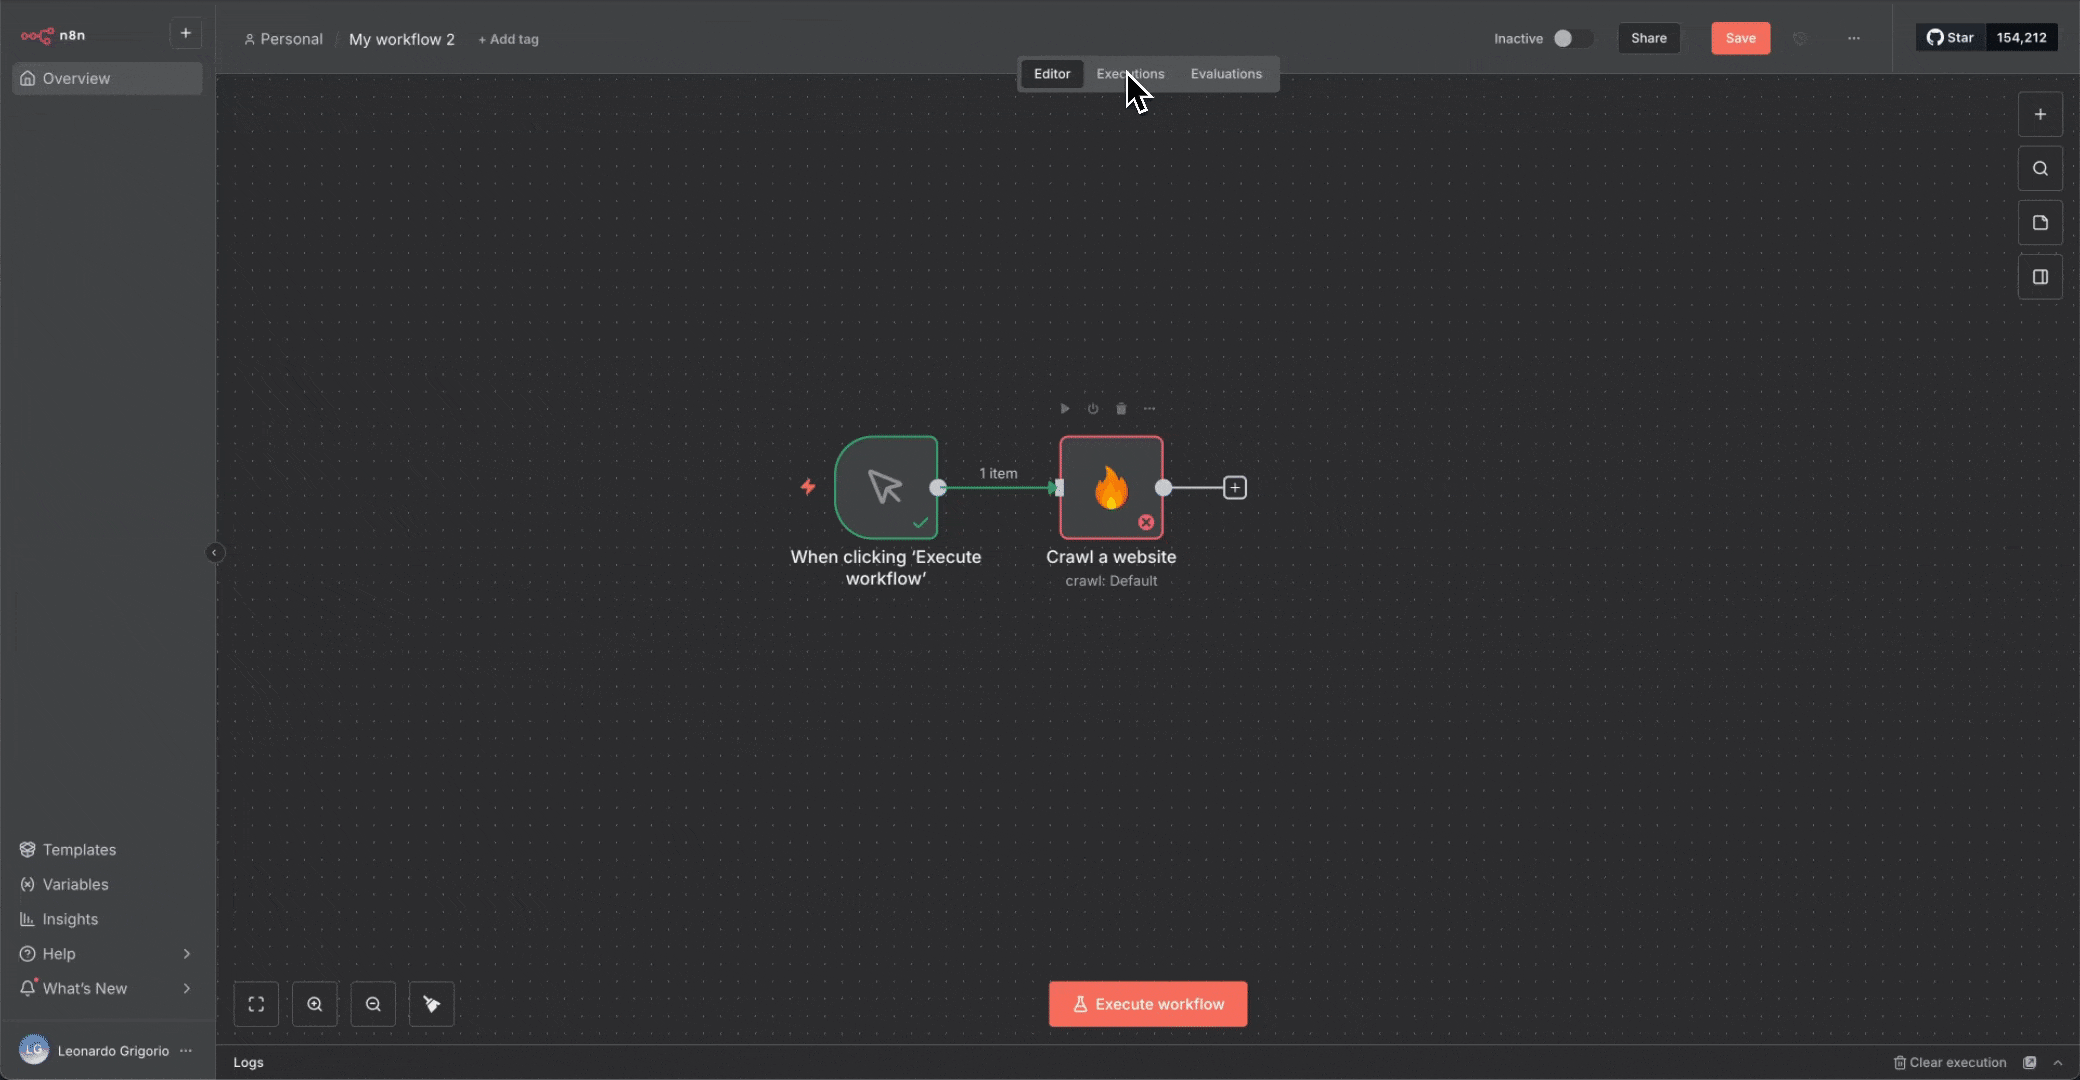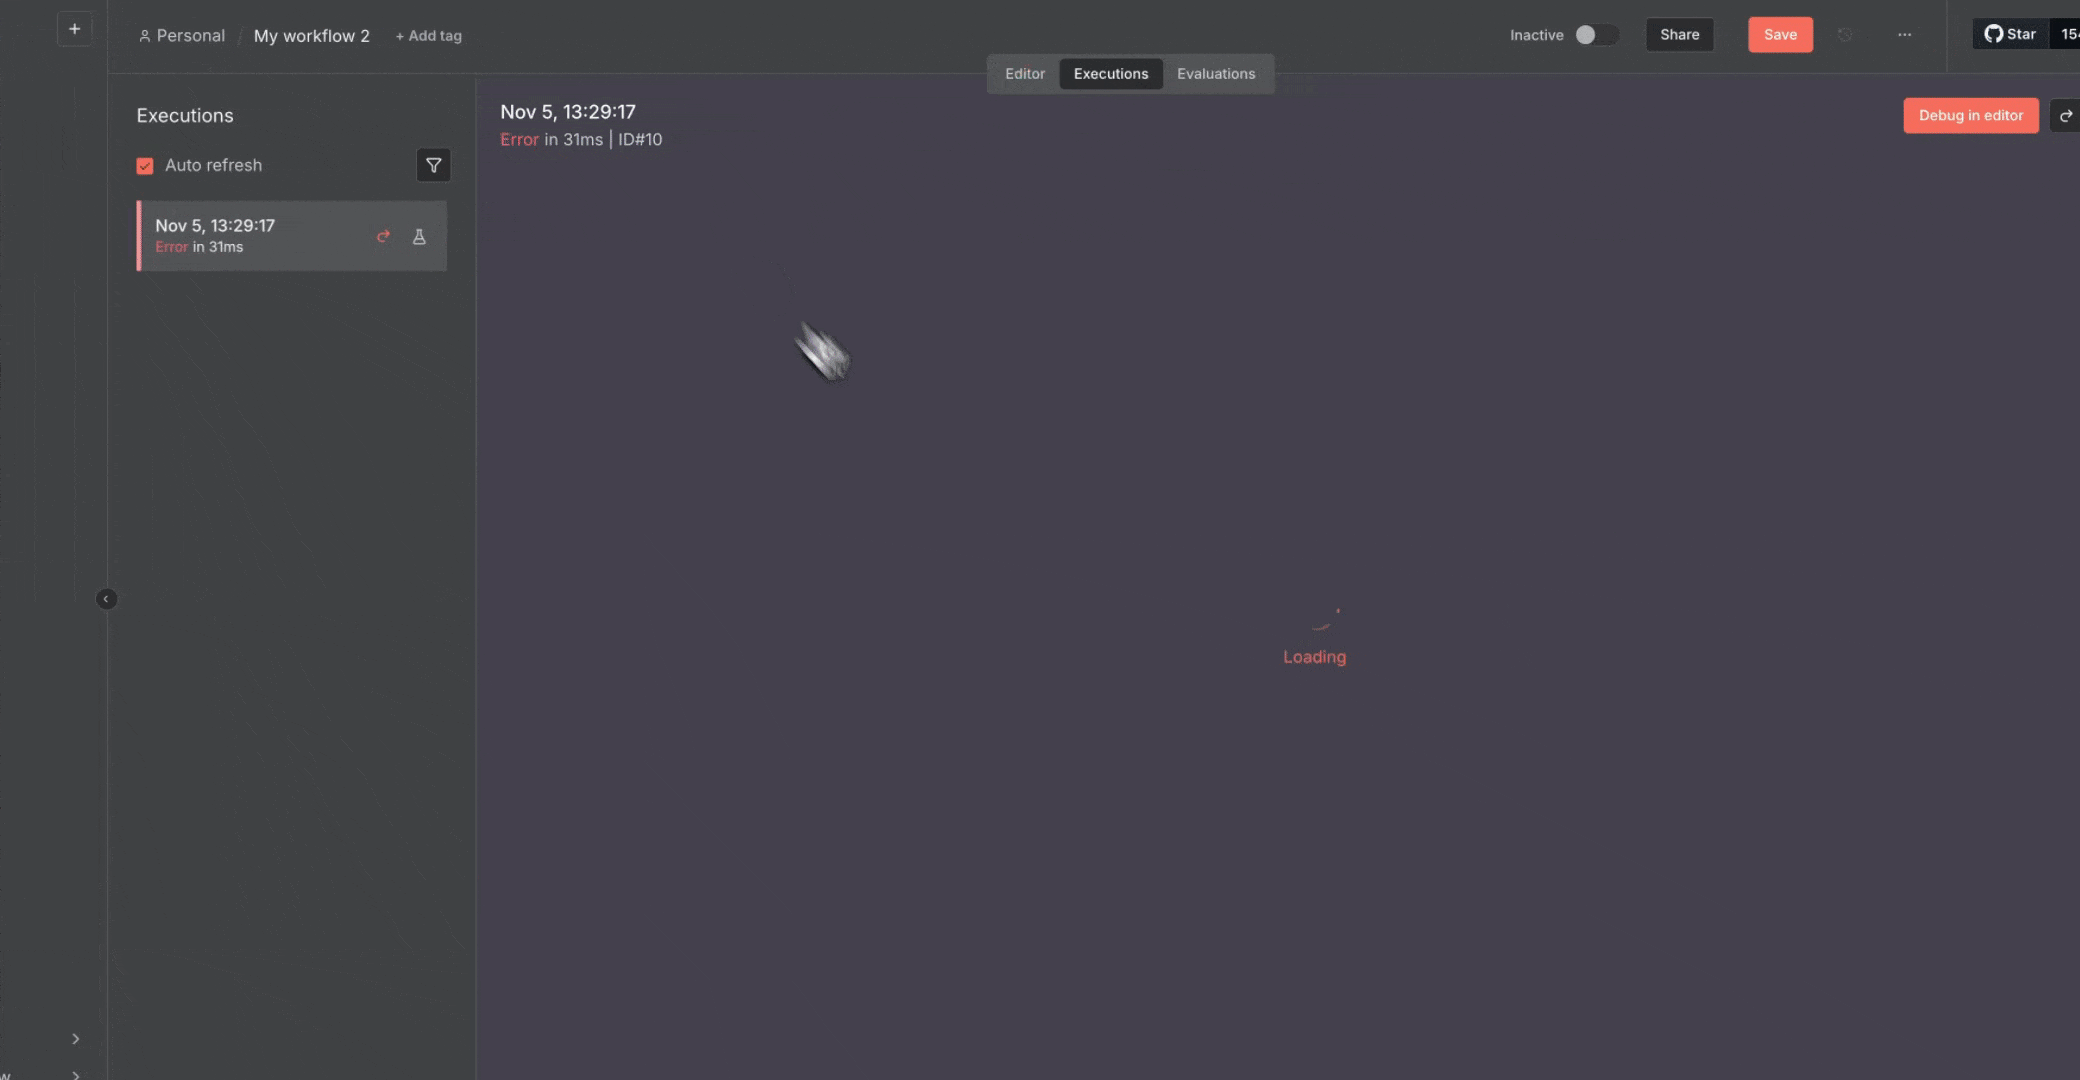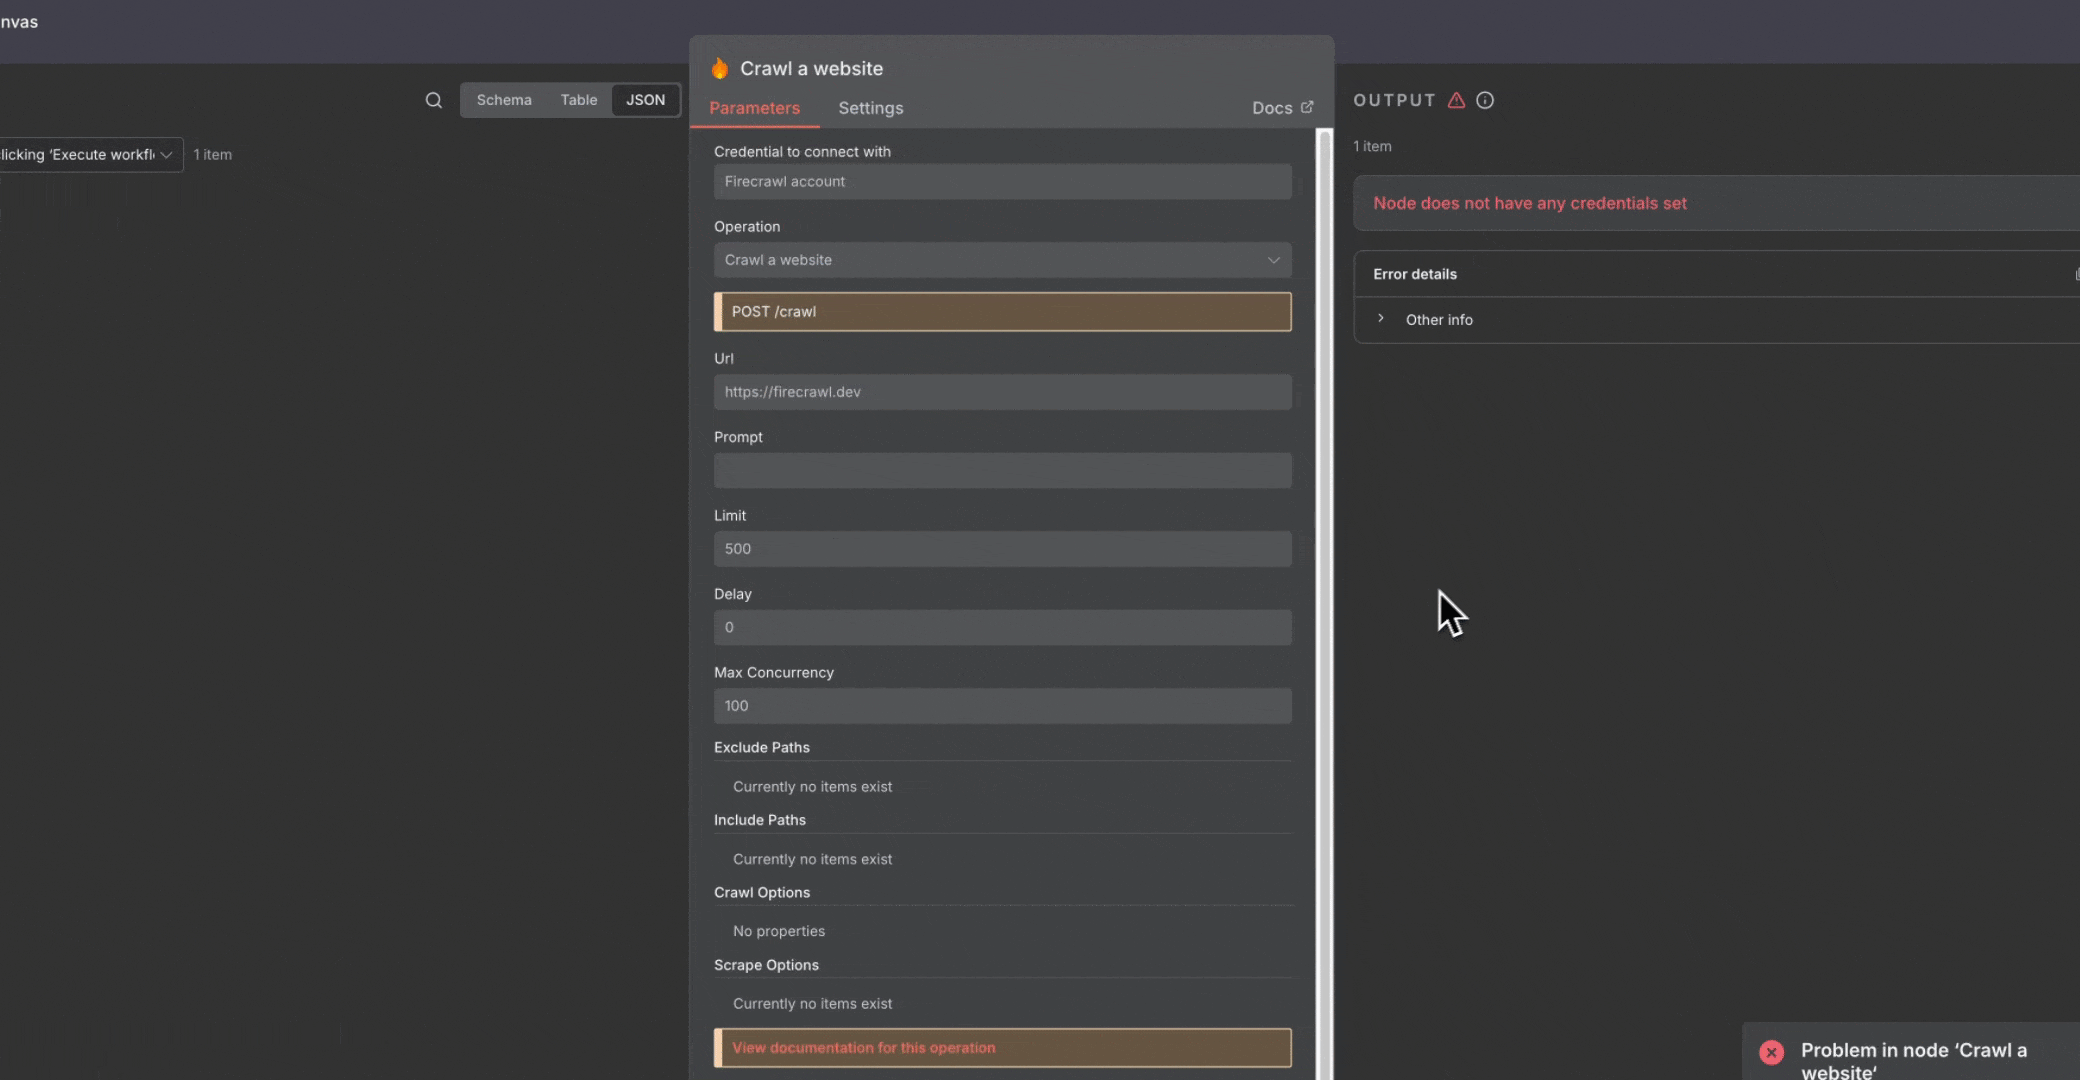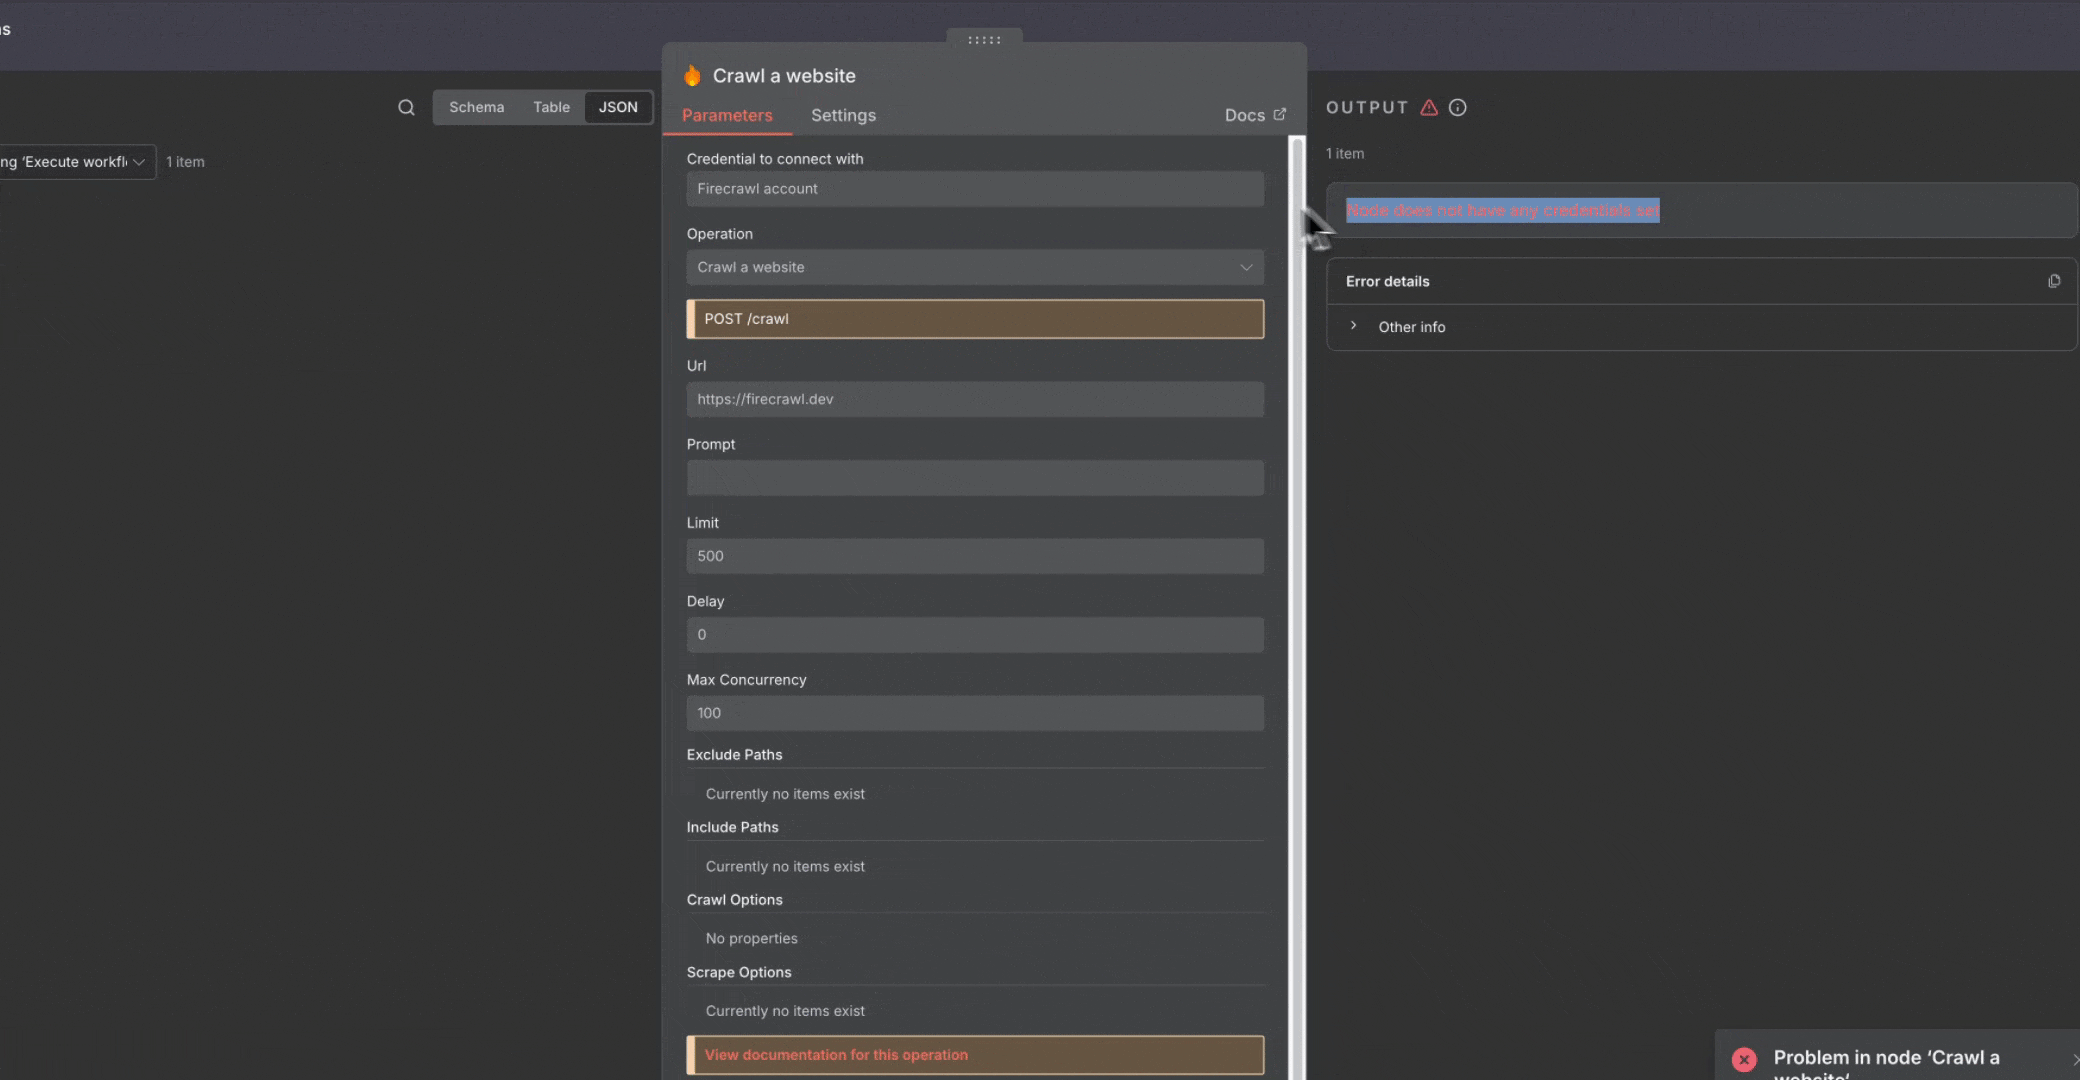
- Testez toujours les workflows manuellement avant d’activer les planifications
- Utilisez le bouton “Exécuter le workflow” pour tester l’ensemble du flux
- Vérifiez les données de sortie de chaque nœud pour vous assurer qu’elles sont correctes
- Utilisez l’onglet “Exécutions” pour consulter les exécutions précédentes et résoudre les problèmes
Gestion des erreurs
- Ajoutez des nœuds Error Trigger pour détecter et gérer les erreurs
- Configurez des notifications en cas d’échec des workflows
- Utilisez le paramètre “Continue On Fail” pour les nœuds non critiques
- Surveillez régulièrement l’exécution de vos workflows
Optimisation des performances
- Utilisez l’extraction par lot pour traiter plusieurs URL plutôt que de recourir à des boucles
- Définissez des limites de débit appropriées pour éviter de surcharger les sites cibles
- Mettez les données en cache lorsque possible afin de réduire les requêtes inutiles
- Planifiez les workflows intensifs pendant les heures creuses
Sécurité
- N’exposez jamais de clés API dans les configurations de workflow
- Utilisez le système d’identifiants de n8n pour stocker vos informations d’authentification de manière sécurisée
- Soyez prudent lorsque vous partagez des workflows publiquement
- Respectez les conditions d’utilisation et le fichier robots.txt des sites web ciblés
Prochaines étapes
Vous disposez désormais des bases nécessaires pour créer des automatisations de scraping web avec Firecrawl et n8n. Voici comment poursuivre votre apprentissage :Explorer les fonctionnalités avancées
- Étudiez les configurations de webhooks pour traiter les données en temps réel
- Expérimentez l’extraction optimisée par l’IA à l’aide de prompts et de schémas
- Créez des workflows complexes en plusieurs étapes avec une logique de branchement
Rejoignez la communauté
- Discord de Firecrawl - Obtenez de l’aide avec Firecrawl et échangez sur le web scraping
- Forum de la communauté n8n - Posez vos questions sur l’automatisation des workflows
- Partagez vos workflows et inspirez-vous des autres
Parcours d’apprentissage recommandé
- Réalisez les exemples de workflows de ce guide
- Modifiez les modèles de la bibliothèque communautaire
- Créez un workflow pour résoudre un problème concret dans votre travail
- Explorez les fonctionnalités avancées de Firecrawl
- Partagez vos propres modèles pour aider les autres
Besoin d’aide ? Si vous êtes bloqué ou avez des questions, les communautés Firecrawl et n8n sont actives et prêtes à vous aider. N’hésitez pas à demander conseil lors de la création de vos automatisations.