

Introducción a Firecrawl y n8n
Firecrawl es la API de contexto para agentes de IA, y el nodo de Firecrawl incorpora Search, Scrape, Crawl, Map, Interact y Agent a tus flujos de trabajo de n8n. Supervisa precios, agrega contenido, genera clientes potenciales o proporciona contexto limpio a agentes de IA sin escribir código.
¿Por qué usar Firecrawl con n8n?
El scraping web tradicional plantea varios desafíos. Los scripts personalizados dejan de funcionar cuando los sitios web cambian su estructura. Los sitios complejos y con mucho JavaScript no se renderizan correctamente. La infraestructura requiere mantenimiento constante. Firecrawl se encarga de estas complejidades técnicas de scraping, mientras que n8n proporciona el marco de automatización. Juntos, te permiten crear flujos de trabajo listos para producción que:- Extraen datos de cualquier sitio web de forma fiable
- Conectan los datos extraídos con otras herramientas empresariales
- Se ejecutan según una programación o se activan mediante eventos
- Escalan desde tareas simples hasta pipelines complejos
Paso 1: Crea tu cuenta de Firecrawl
Firecrawl proporciona capacidades de búsqueda, scraping e interacción con el navegador para tus agentes de IA y flujos de trabajo. Configura tu cuenta y obtén tus credenciales de API.Regístrate en Firecrawl
- Ve a firecrawl.dev en tu navegador web
- Haz clic en el botón “Empezar” o “Registrarse”
- Crea una cuenta con tu dirección de correo electrónico o inicia sesión con GitHub
- Verifica tu correo electrónico si se te solicita
Obtén tu clave de API
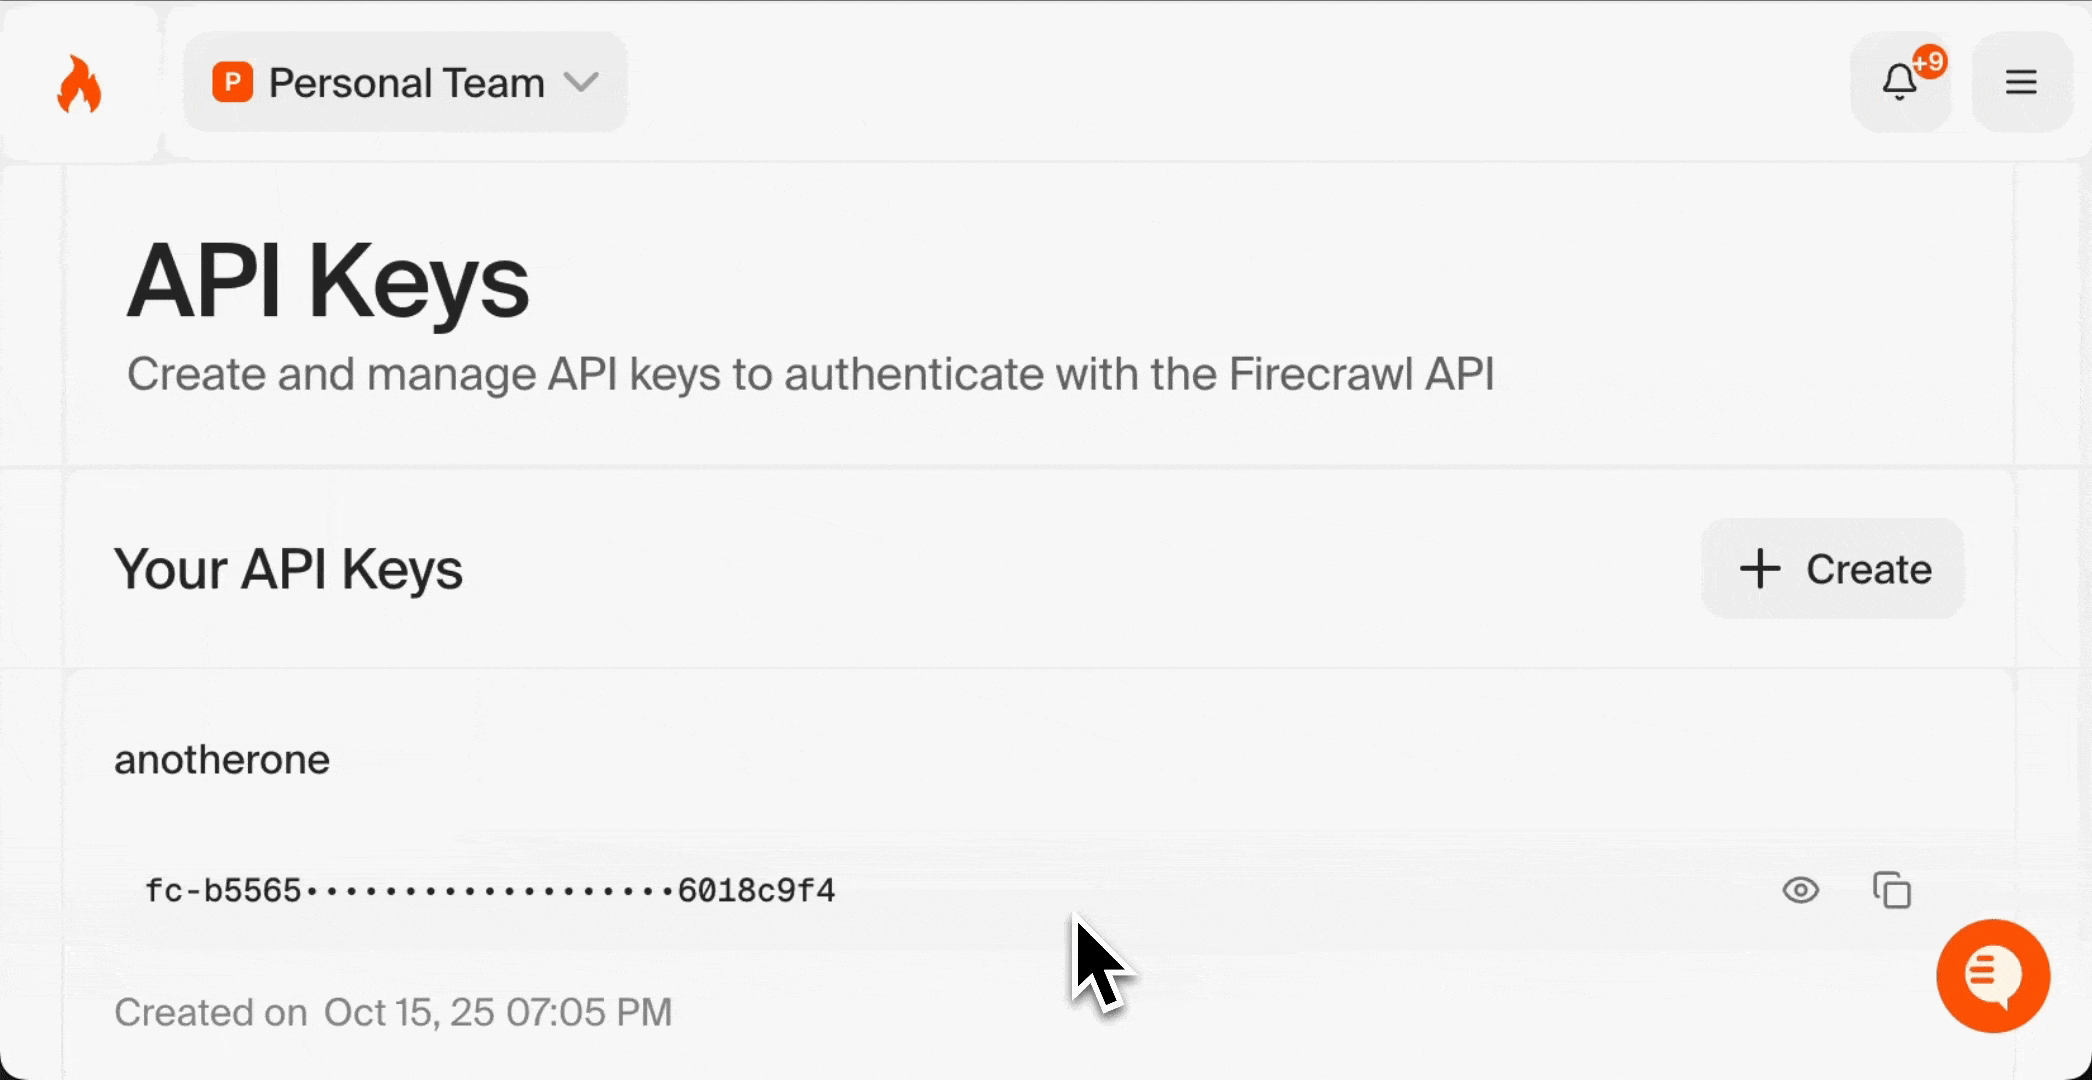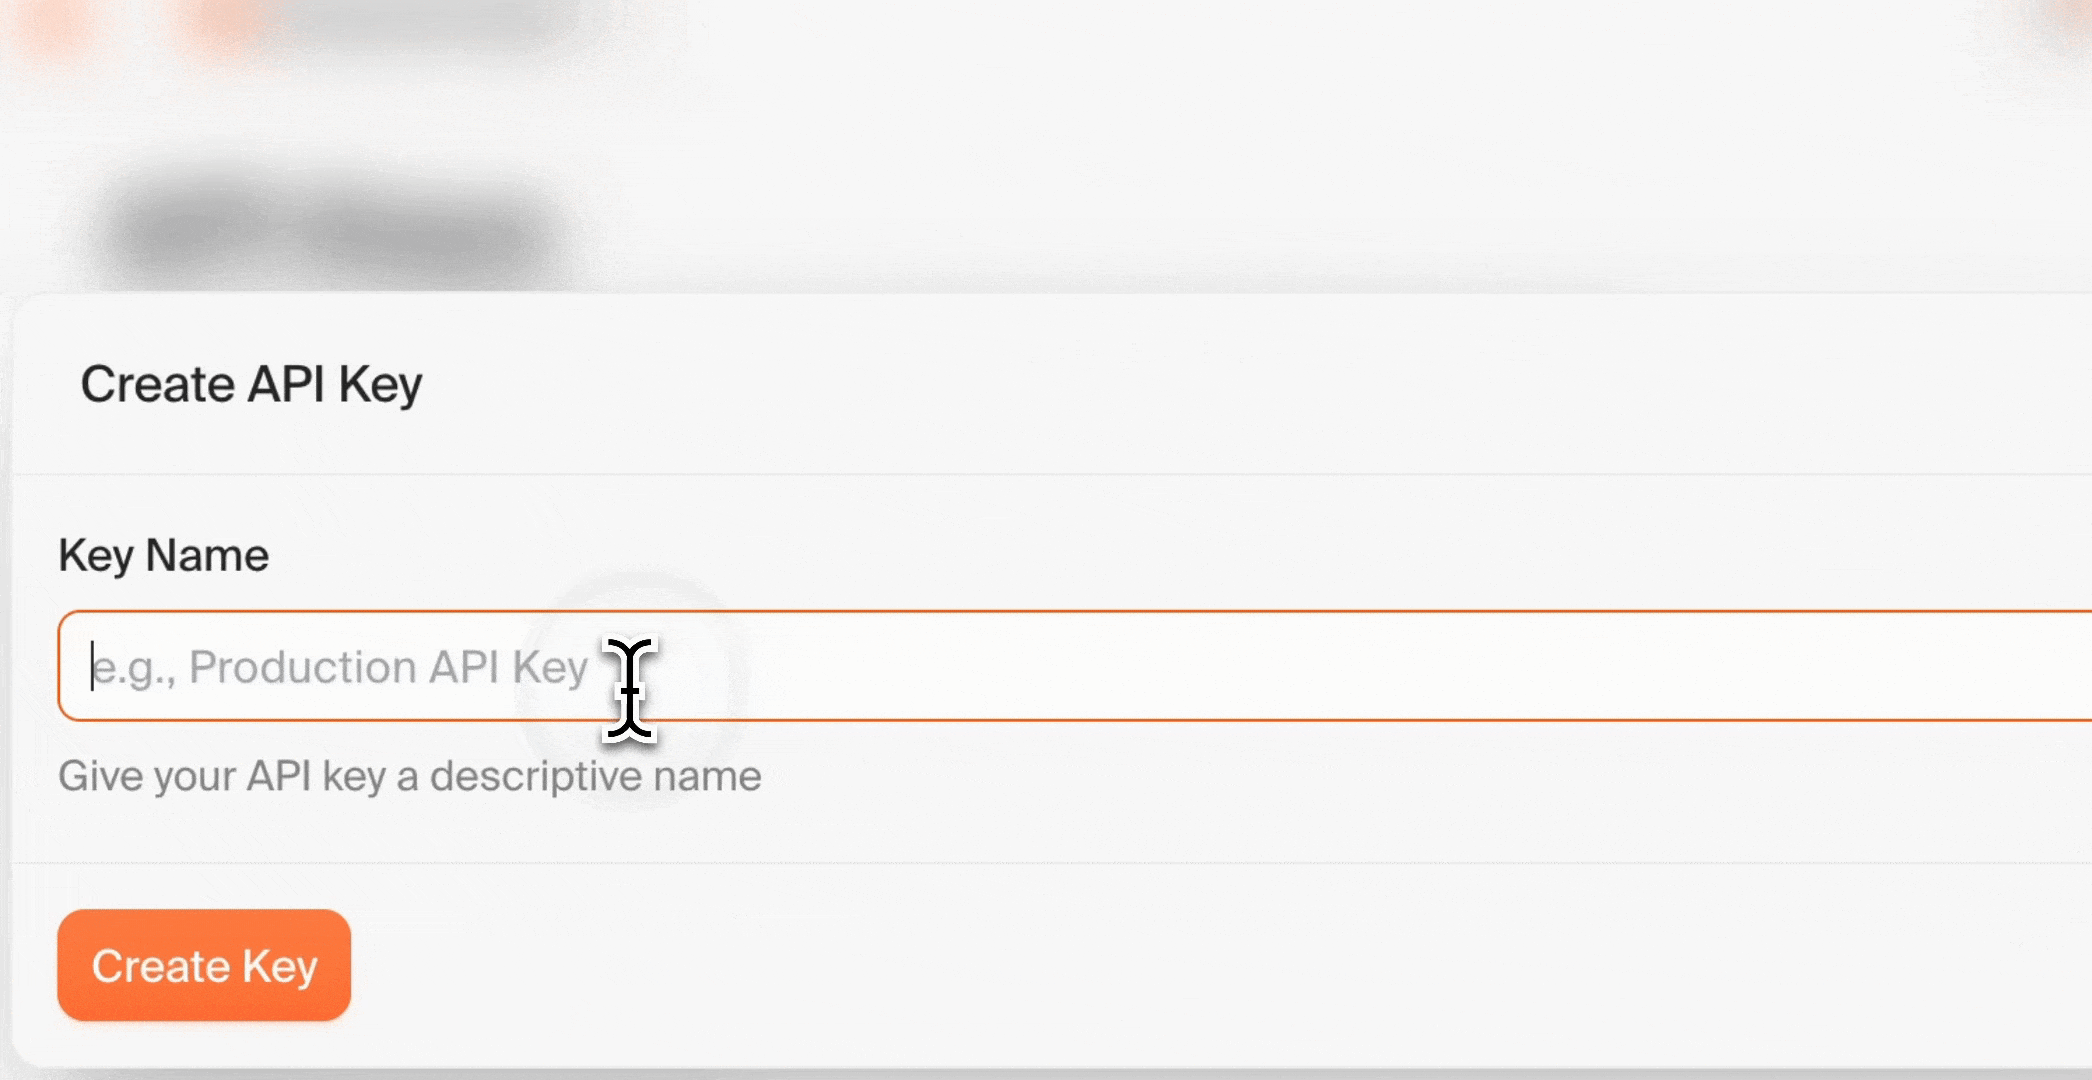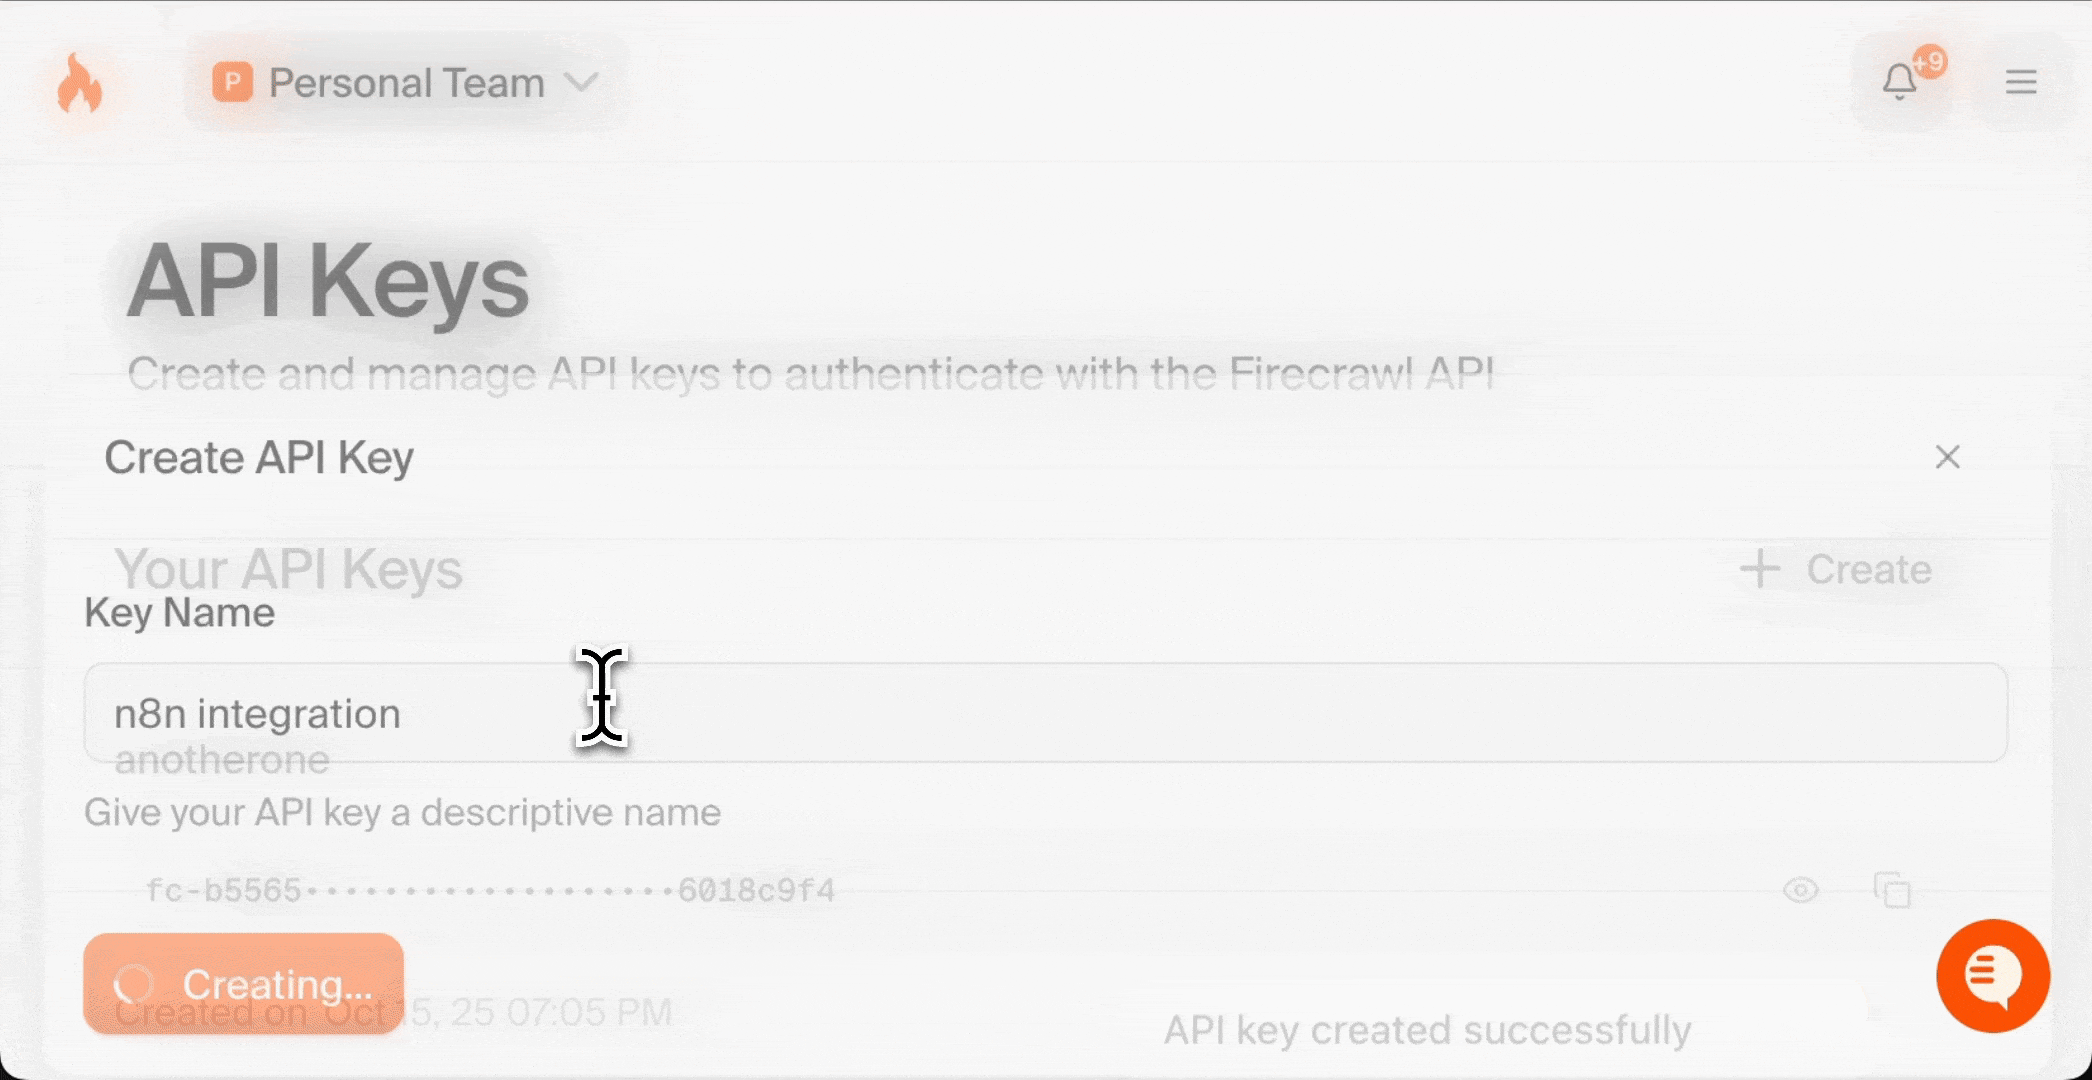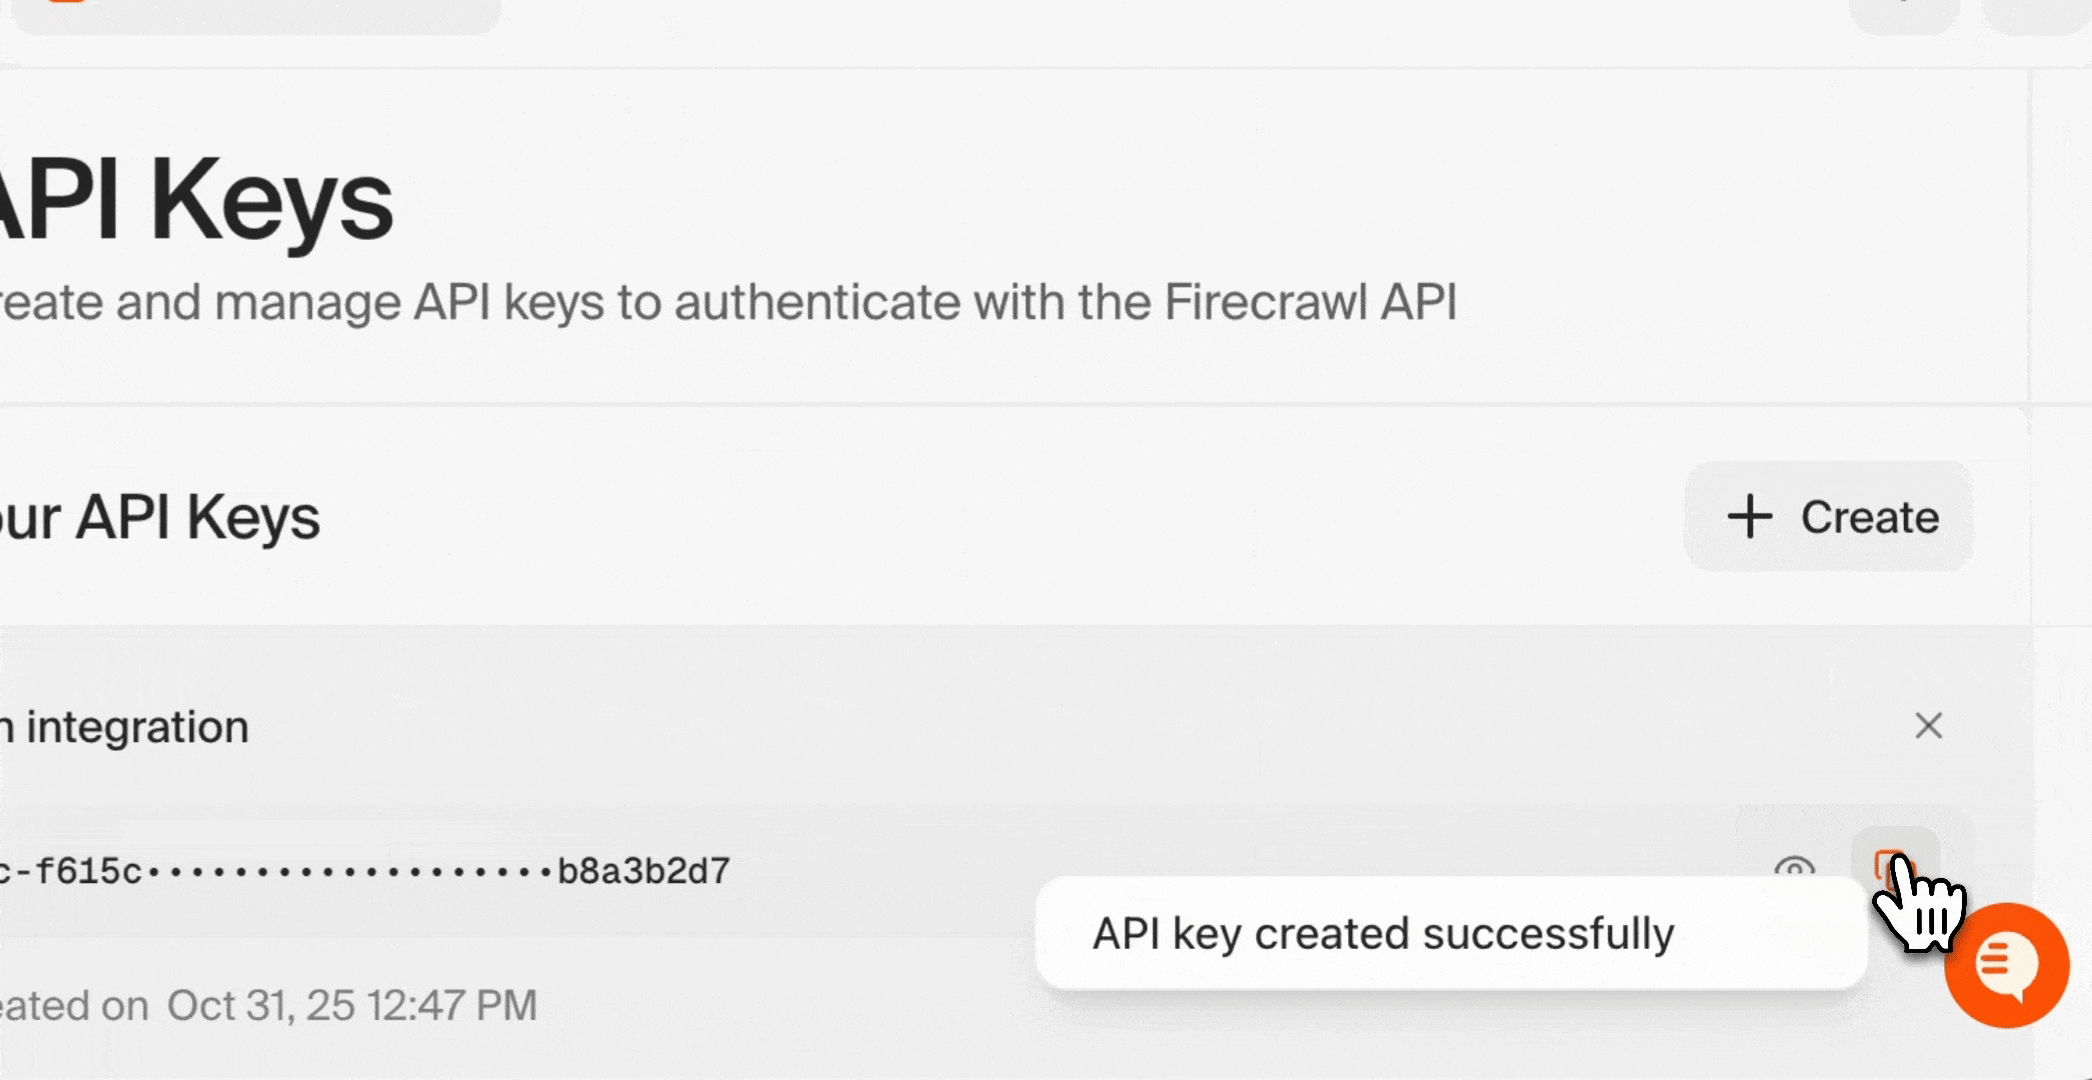
Después de iniciar sesión, necesitas una clave de API para conectar Firecrawl con n8n:- Ve al dashboard de Firecrawl
- Accede a la página de claves de API
- Haz clic en “Create New clave de API”
- Asigna a tu clave un nombre descriptivo (p. ej., “n8n Integration”)
- Copia la clave de API generada y guárdala en un lugar seguro
Tu clave de API es como una contraseña. Guárdala de forma segura y nunca la compartas públicamente. La necesitarás en la siguiente sección.
Paso 2: Configura n8n
n8n ofrece dos opciones de implementación: en la nube o autogestionada. Para principiantes, la versión en la nube es la forma más rápida de comenzar.Selecciona tu versión de n8n
n8n Cloud (recomendado para principiantes):- No requiere instalación
- Plan Free disponible
- Infraestructura gestionada
- Actualizaciones automáticas
- Control total sobre los datos
- Se ejecuta en tus propios servidores
- Requiere instalar Docker
- Ideal para usuarios avanzados con requisitos de seguridad específicos
Opción A: n8n Cloud (recomendado para principiantes)
- Visita n8n.cloud
- Haz clic en “Start Free” o “Sign Up”
- Regístrate con tu dirección de correo electrónico o GitHub
- Completa el proceso de verificación
- Accederás a tu dashboard de n8n
Opción B: Autogestionado con Docker
Si prefieres ejecutar n8n en tu propia infraestructura, puedes configurarlo rápidamente con Docker. Requisitos previos:- Docker Desktop instalado en tu equipo
- Conocimientos básicos de la línea de comandos o la terminal
- Abre la terminal o el símbolo del sistema
- Crea un volumen de Docker para conservar los datos de tu flujo de trabajo:
- Ejecuta el contenedor de Docker de n8n:
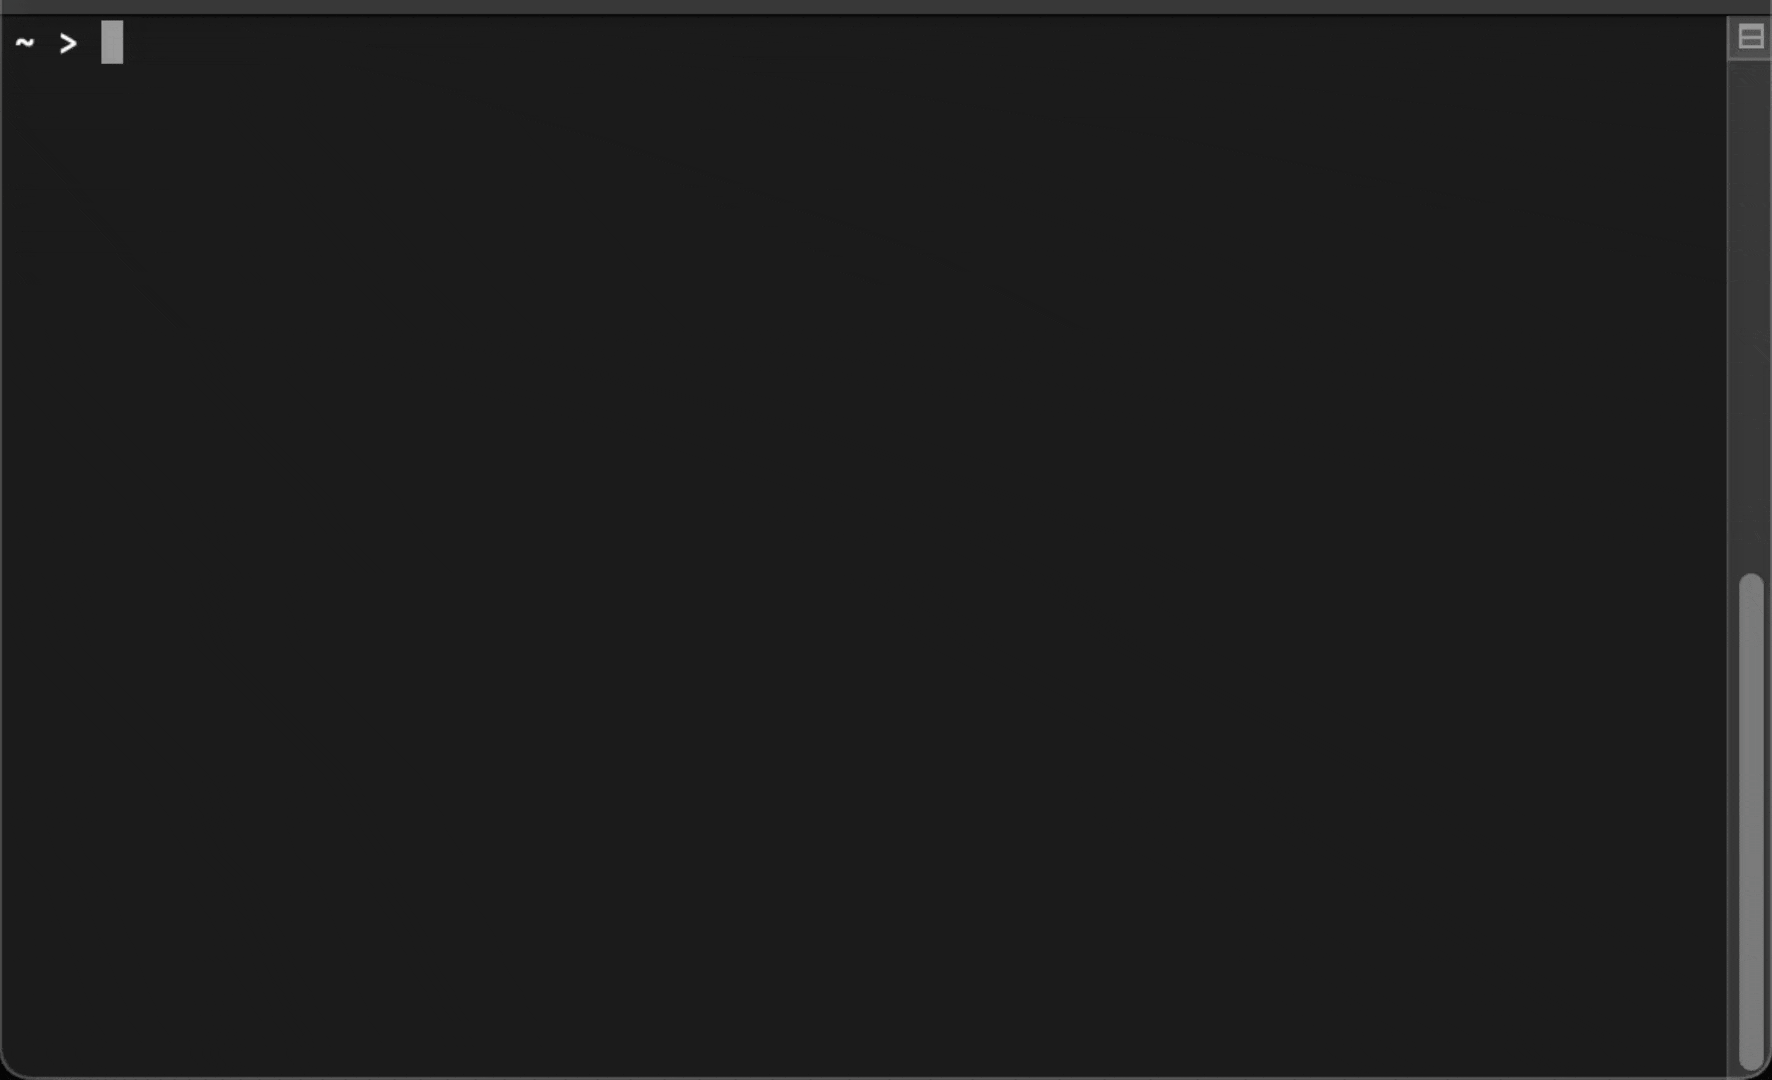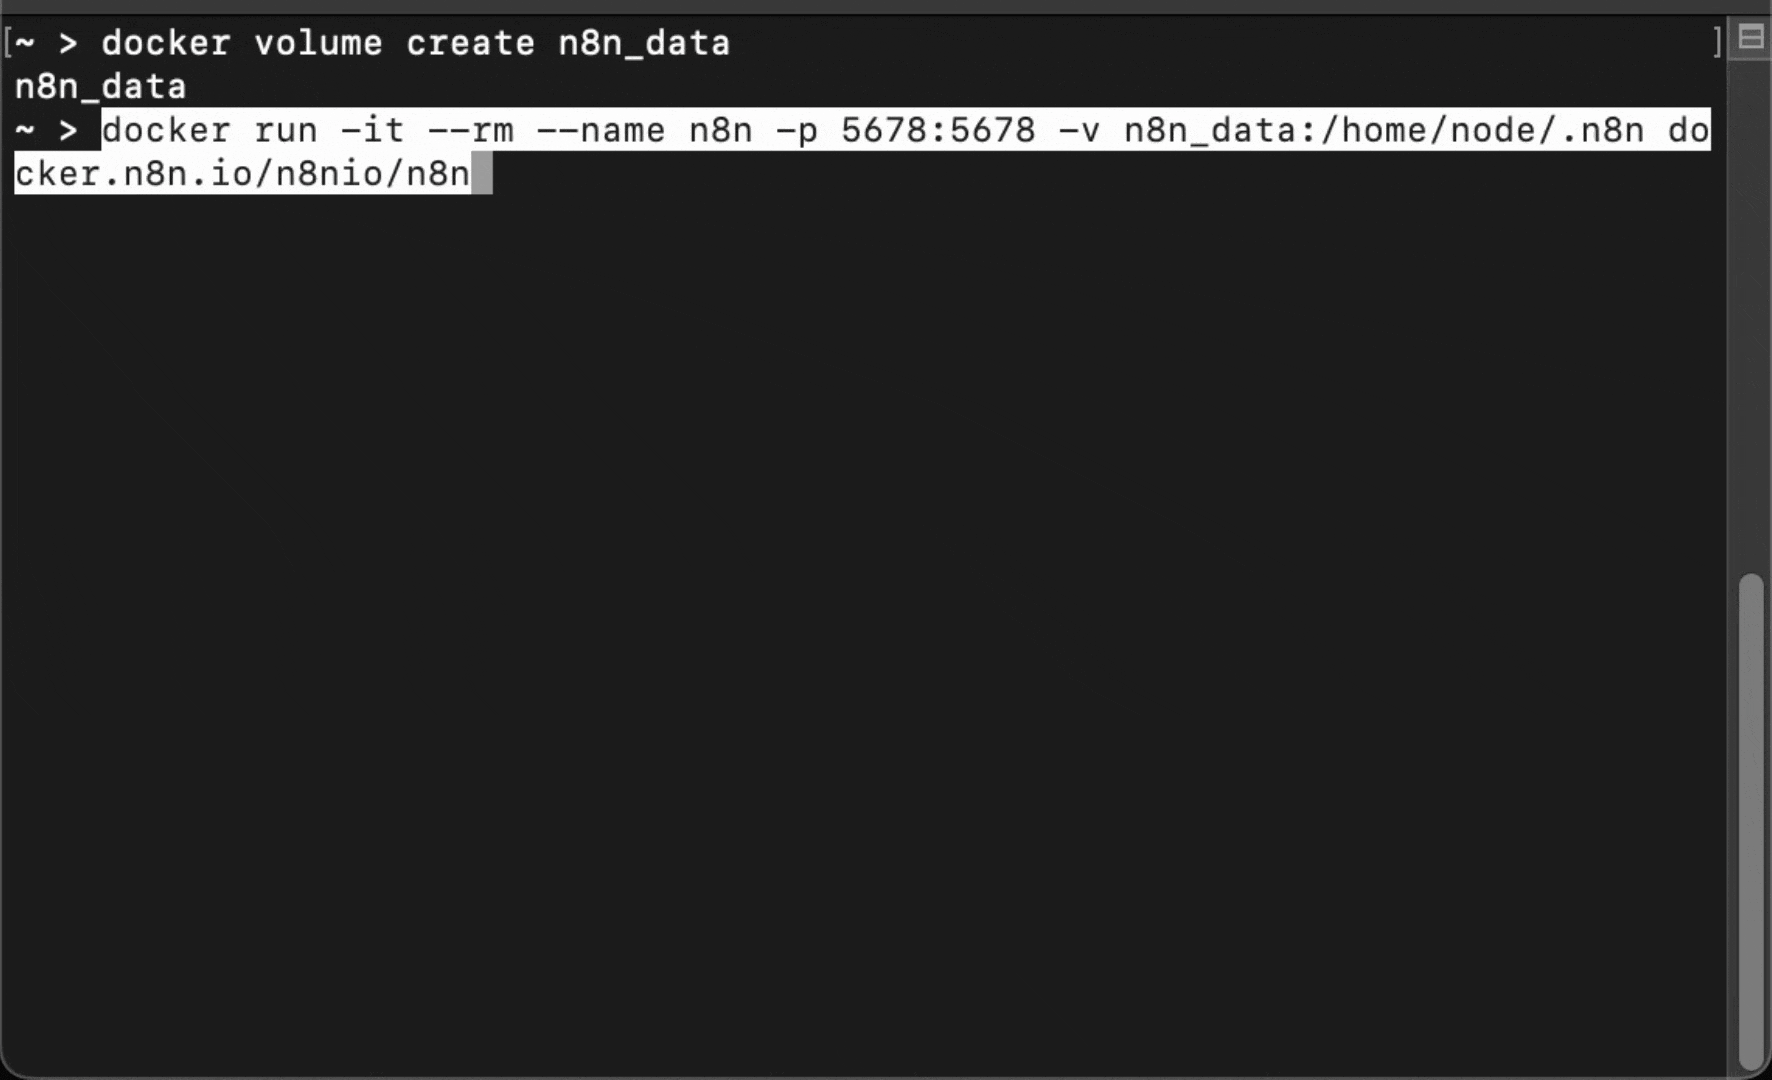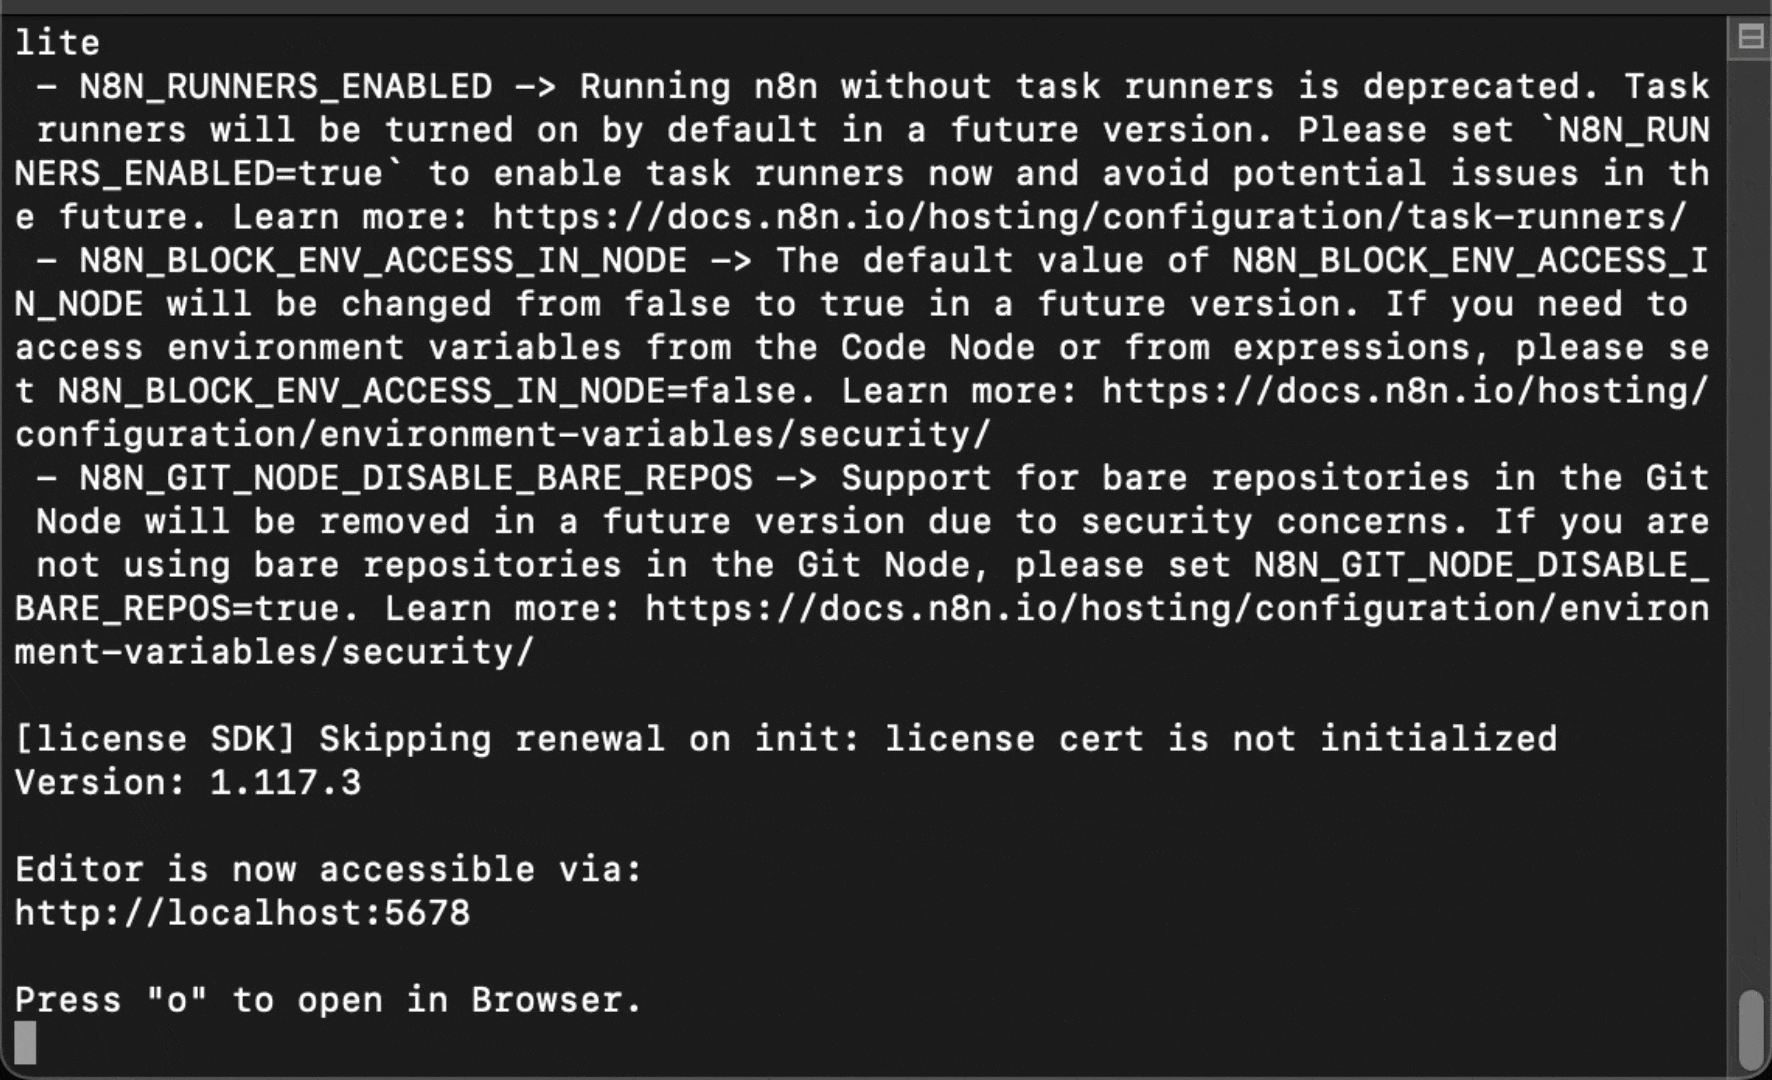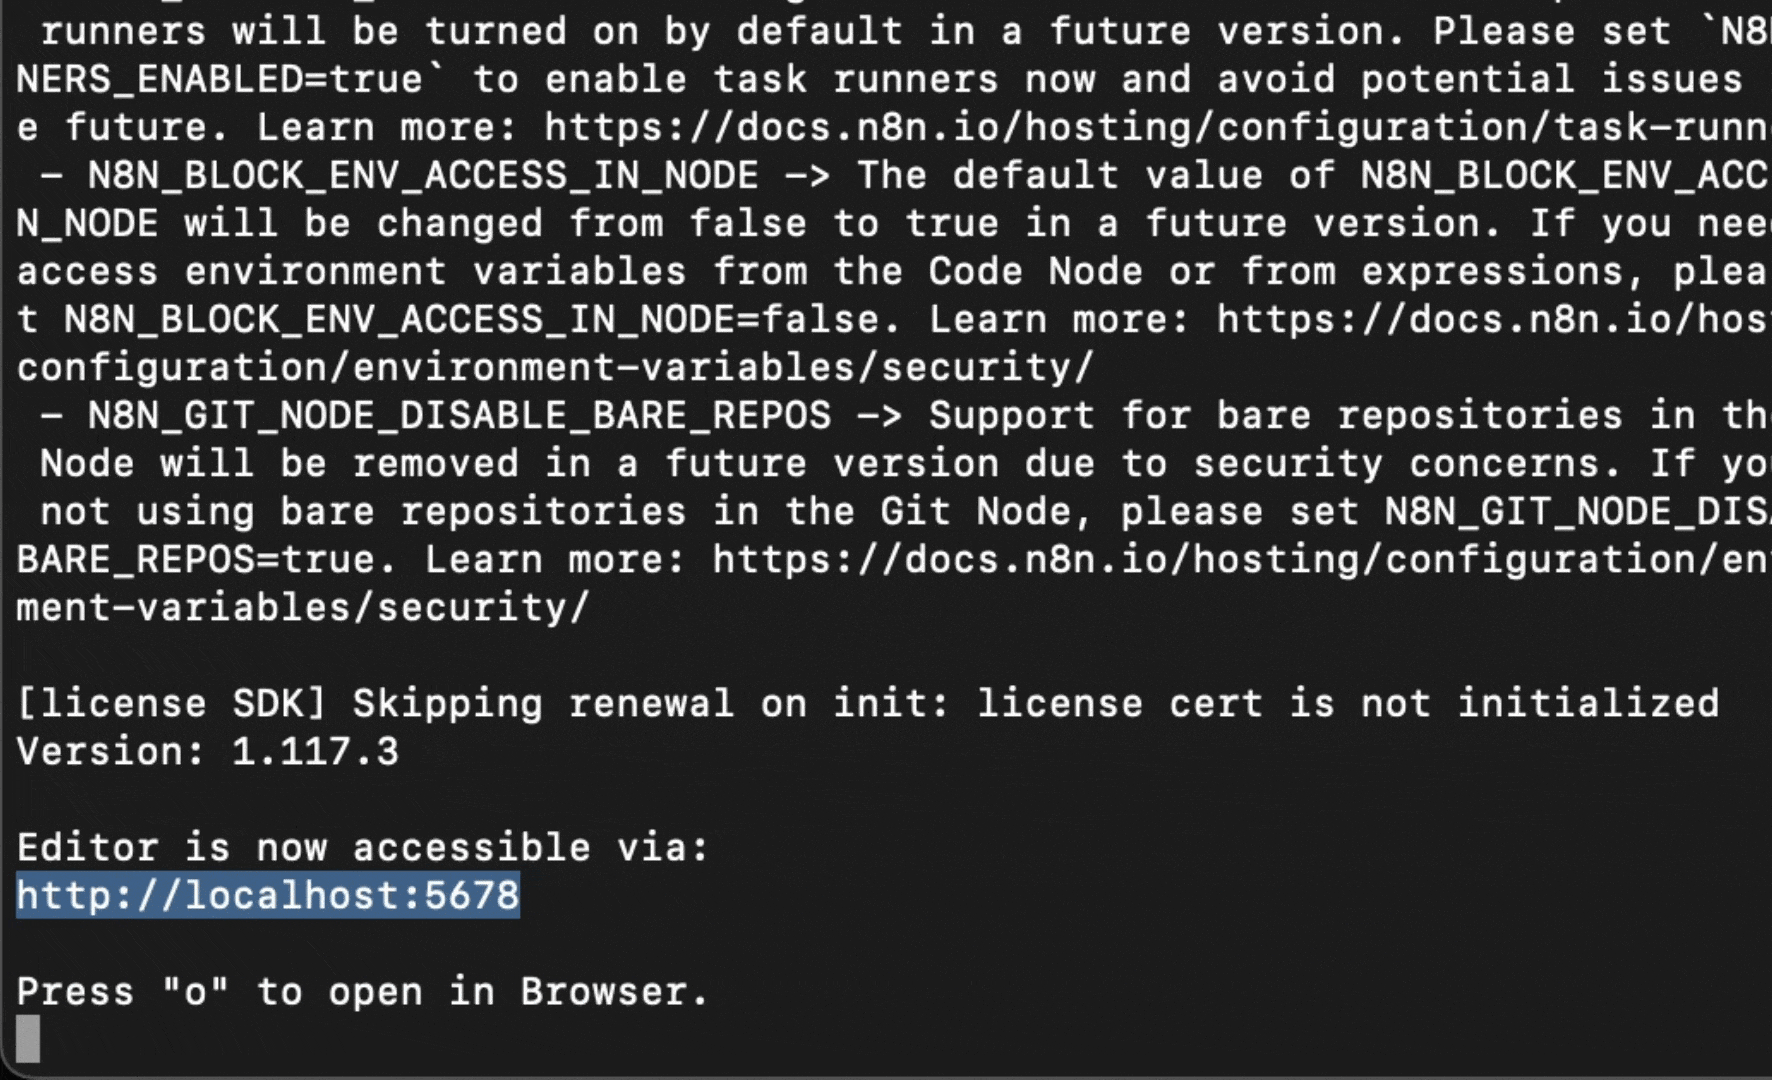
- Espera a que n8n se inicie. Verás una salida que indica que el servidor está en funcionamiento.
- Abre el navegador web y ve a
http://localhost:5678 - Crea tu cuenta de n8n registrándote con una dirección de correo electrónico
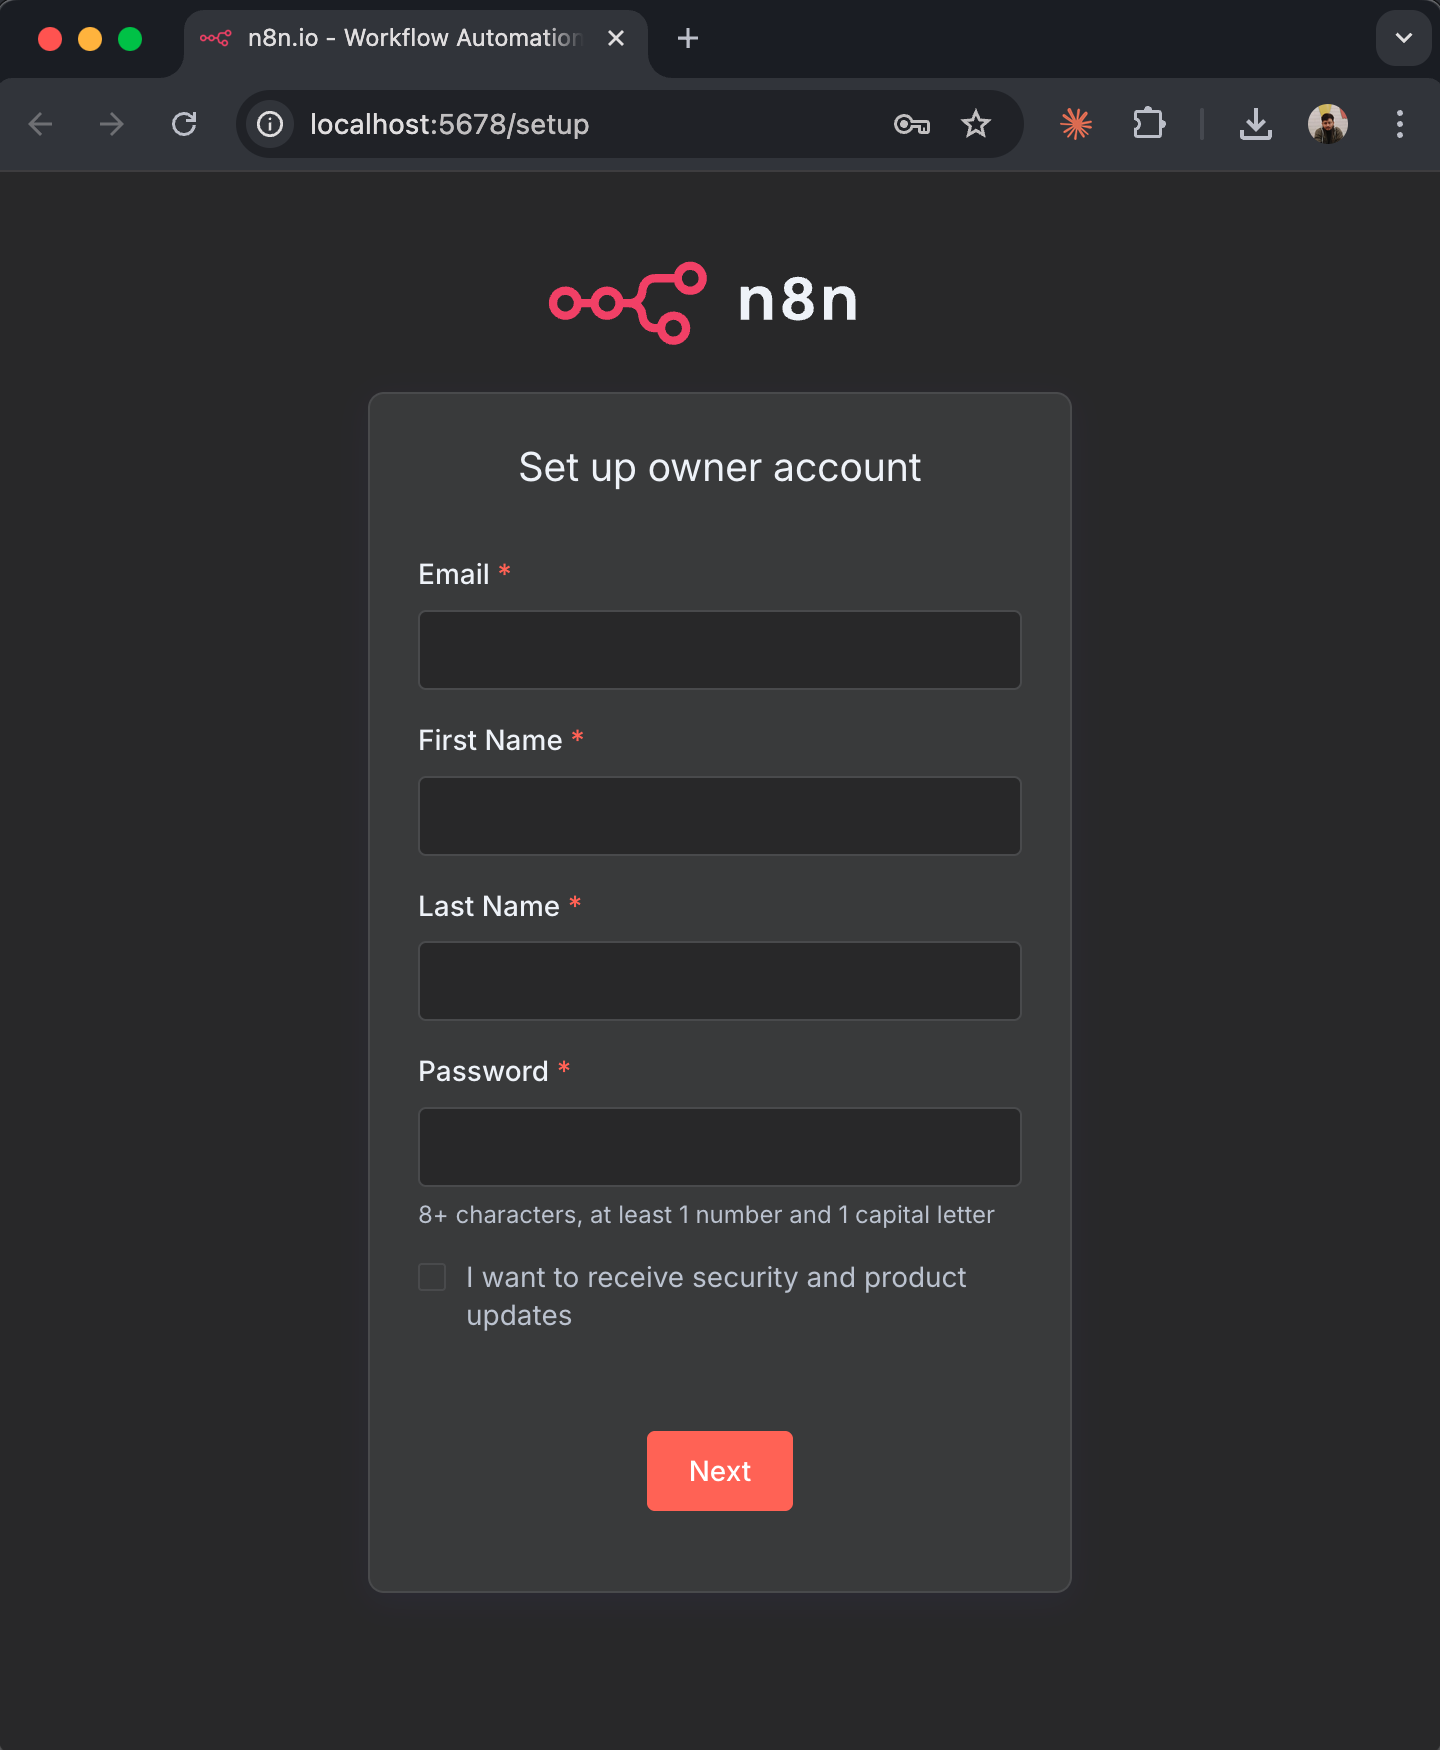
La opción
--rm elimina automáticamente el contenedor cuando lo detienes, pero tus datos permanecen seguros en el volumen n8n_data. Para implementaciones en producción, consulta la documentación de autoalojamiento de n8n para conocer opciones de configuración más avanzadas.Conocer la interfaz de n8n
Al iniciar sesión en n8n por primera vez, verás el dashboard principal: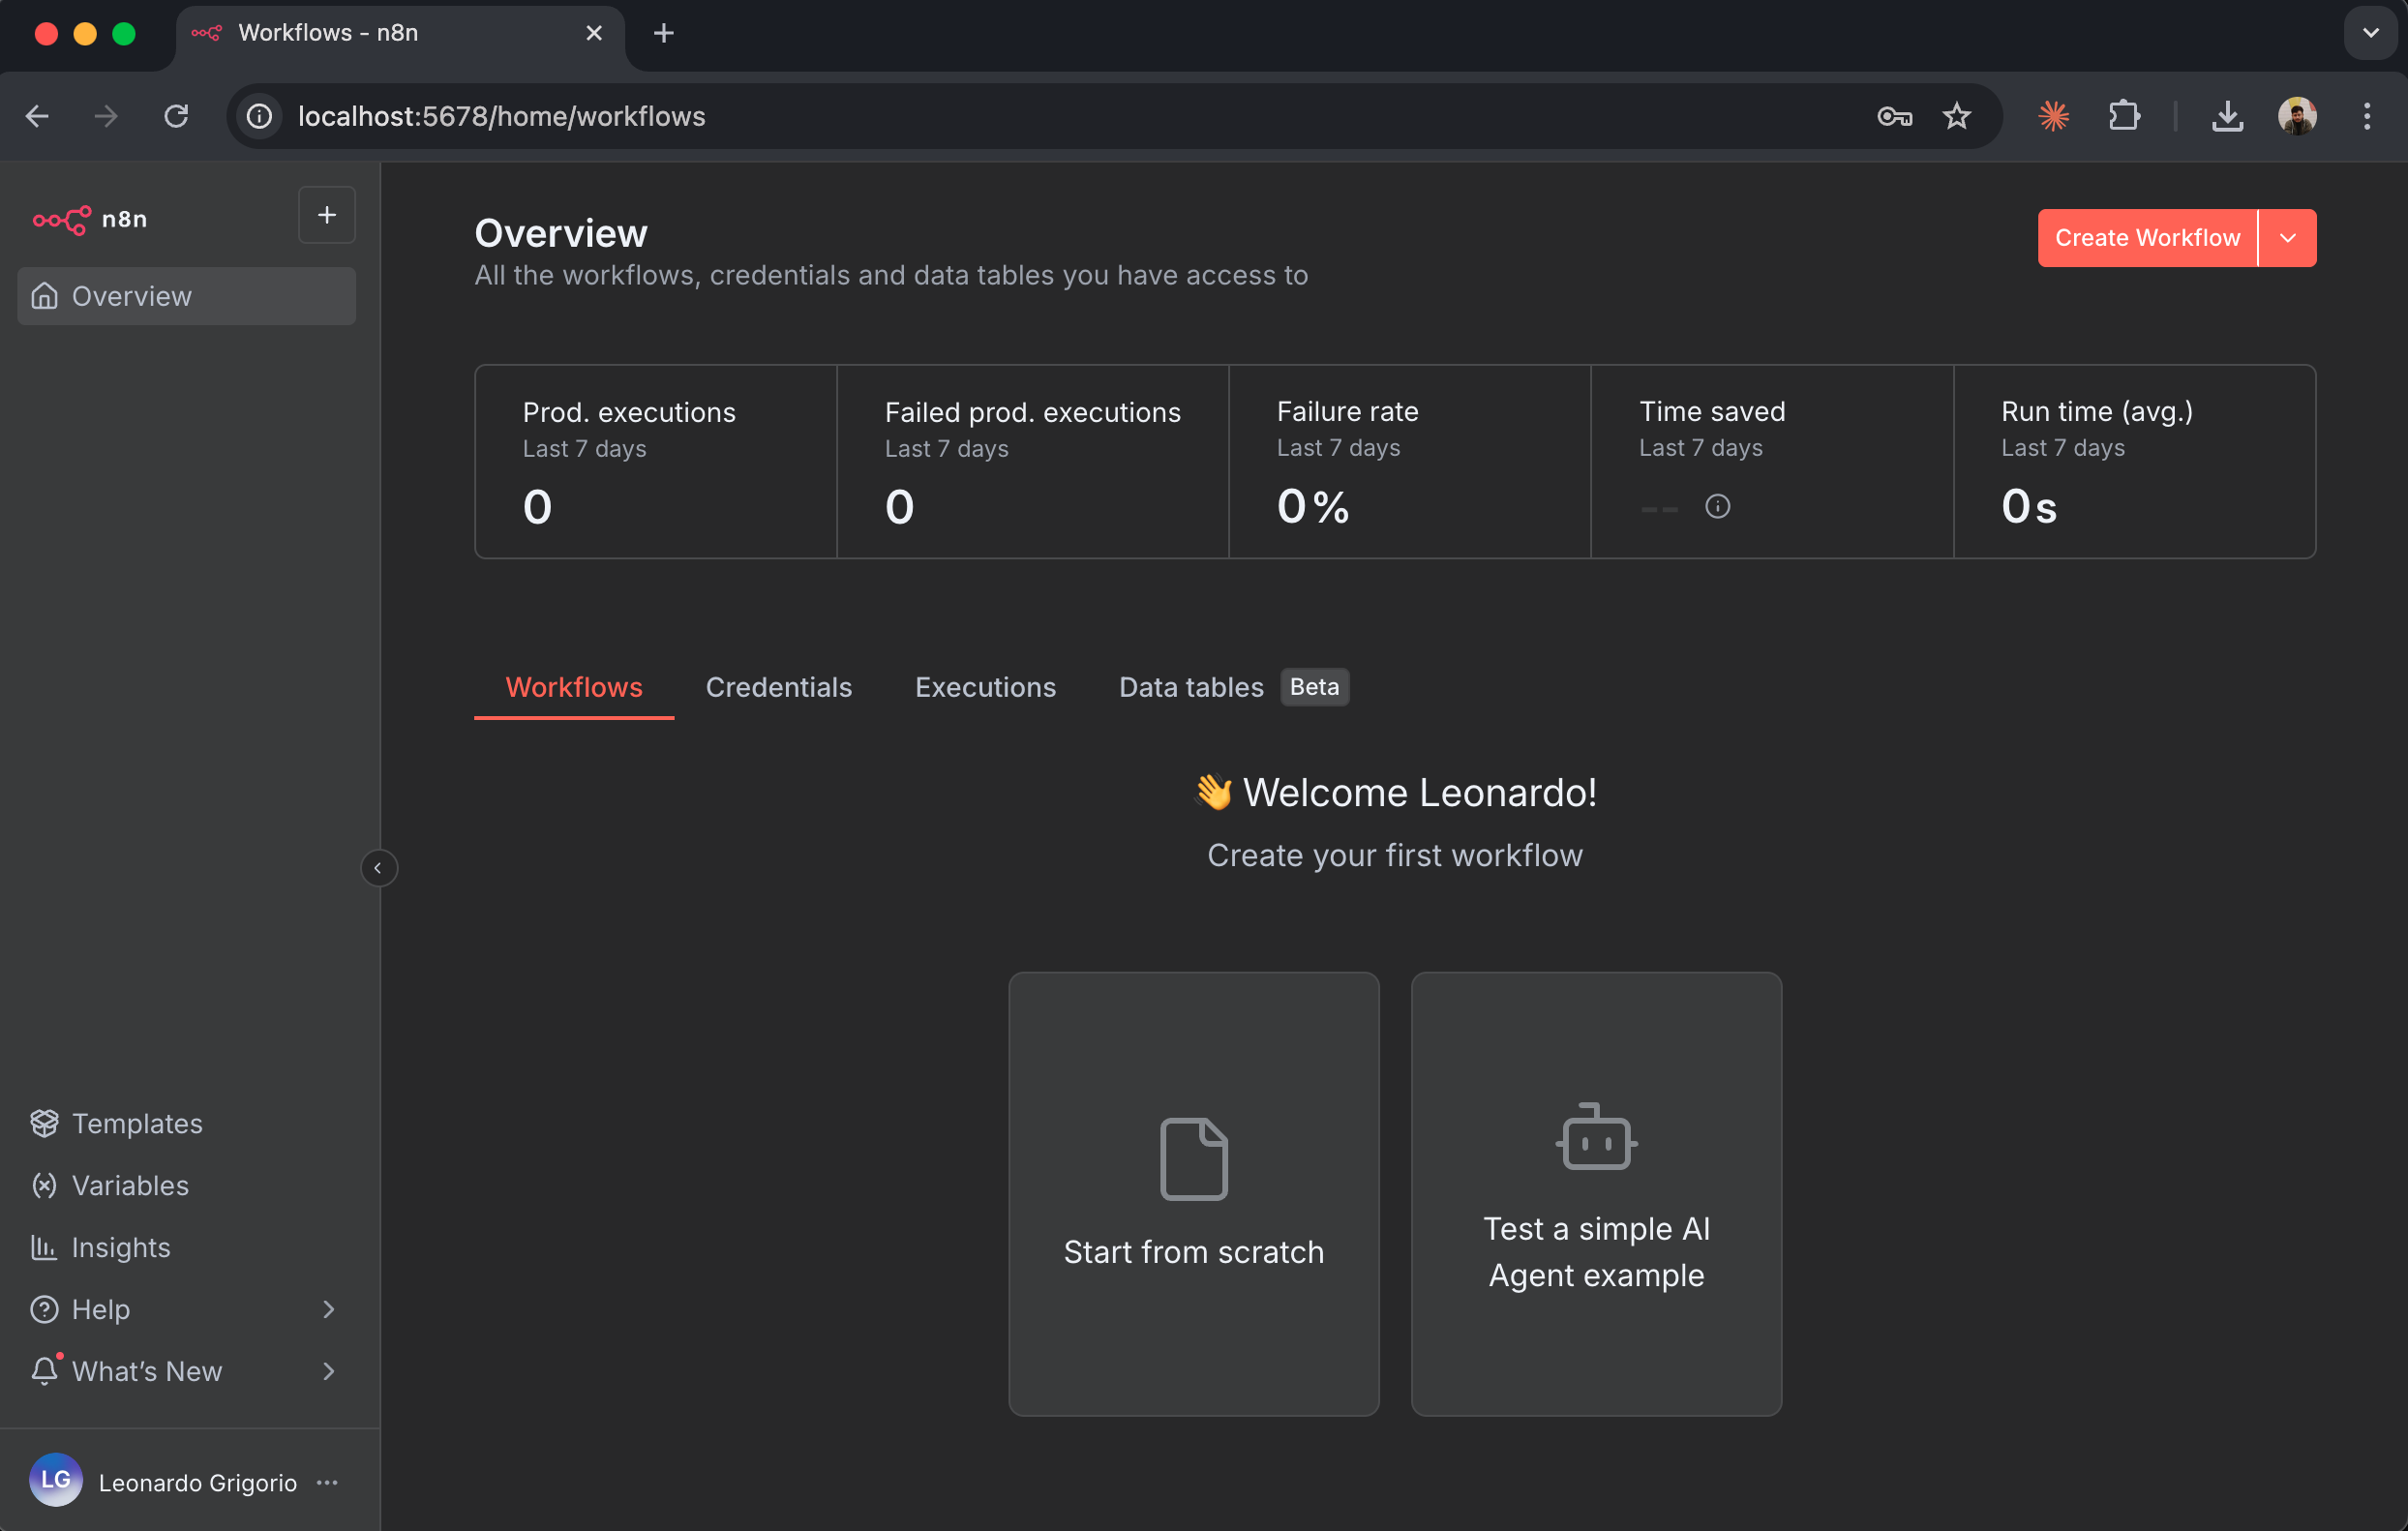
- Flujos de trabajo: Aquí aparecen tus automatizaciones guardadas
- Ejecuciones: Historial de ejecuciones de los flujos de trabajo
- Credenciales: Claves de API y tokens de autenticación almacenados
- Configuración: Configuración de la cuenta y el espacio de trabajo
El lienzo del flujo de trabajo
El editor de flujos de trabajo es donde crearás tus automatizaciones: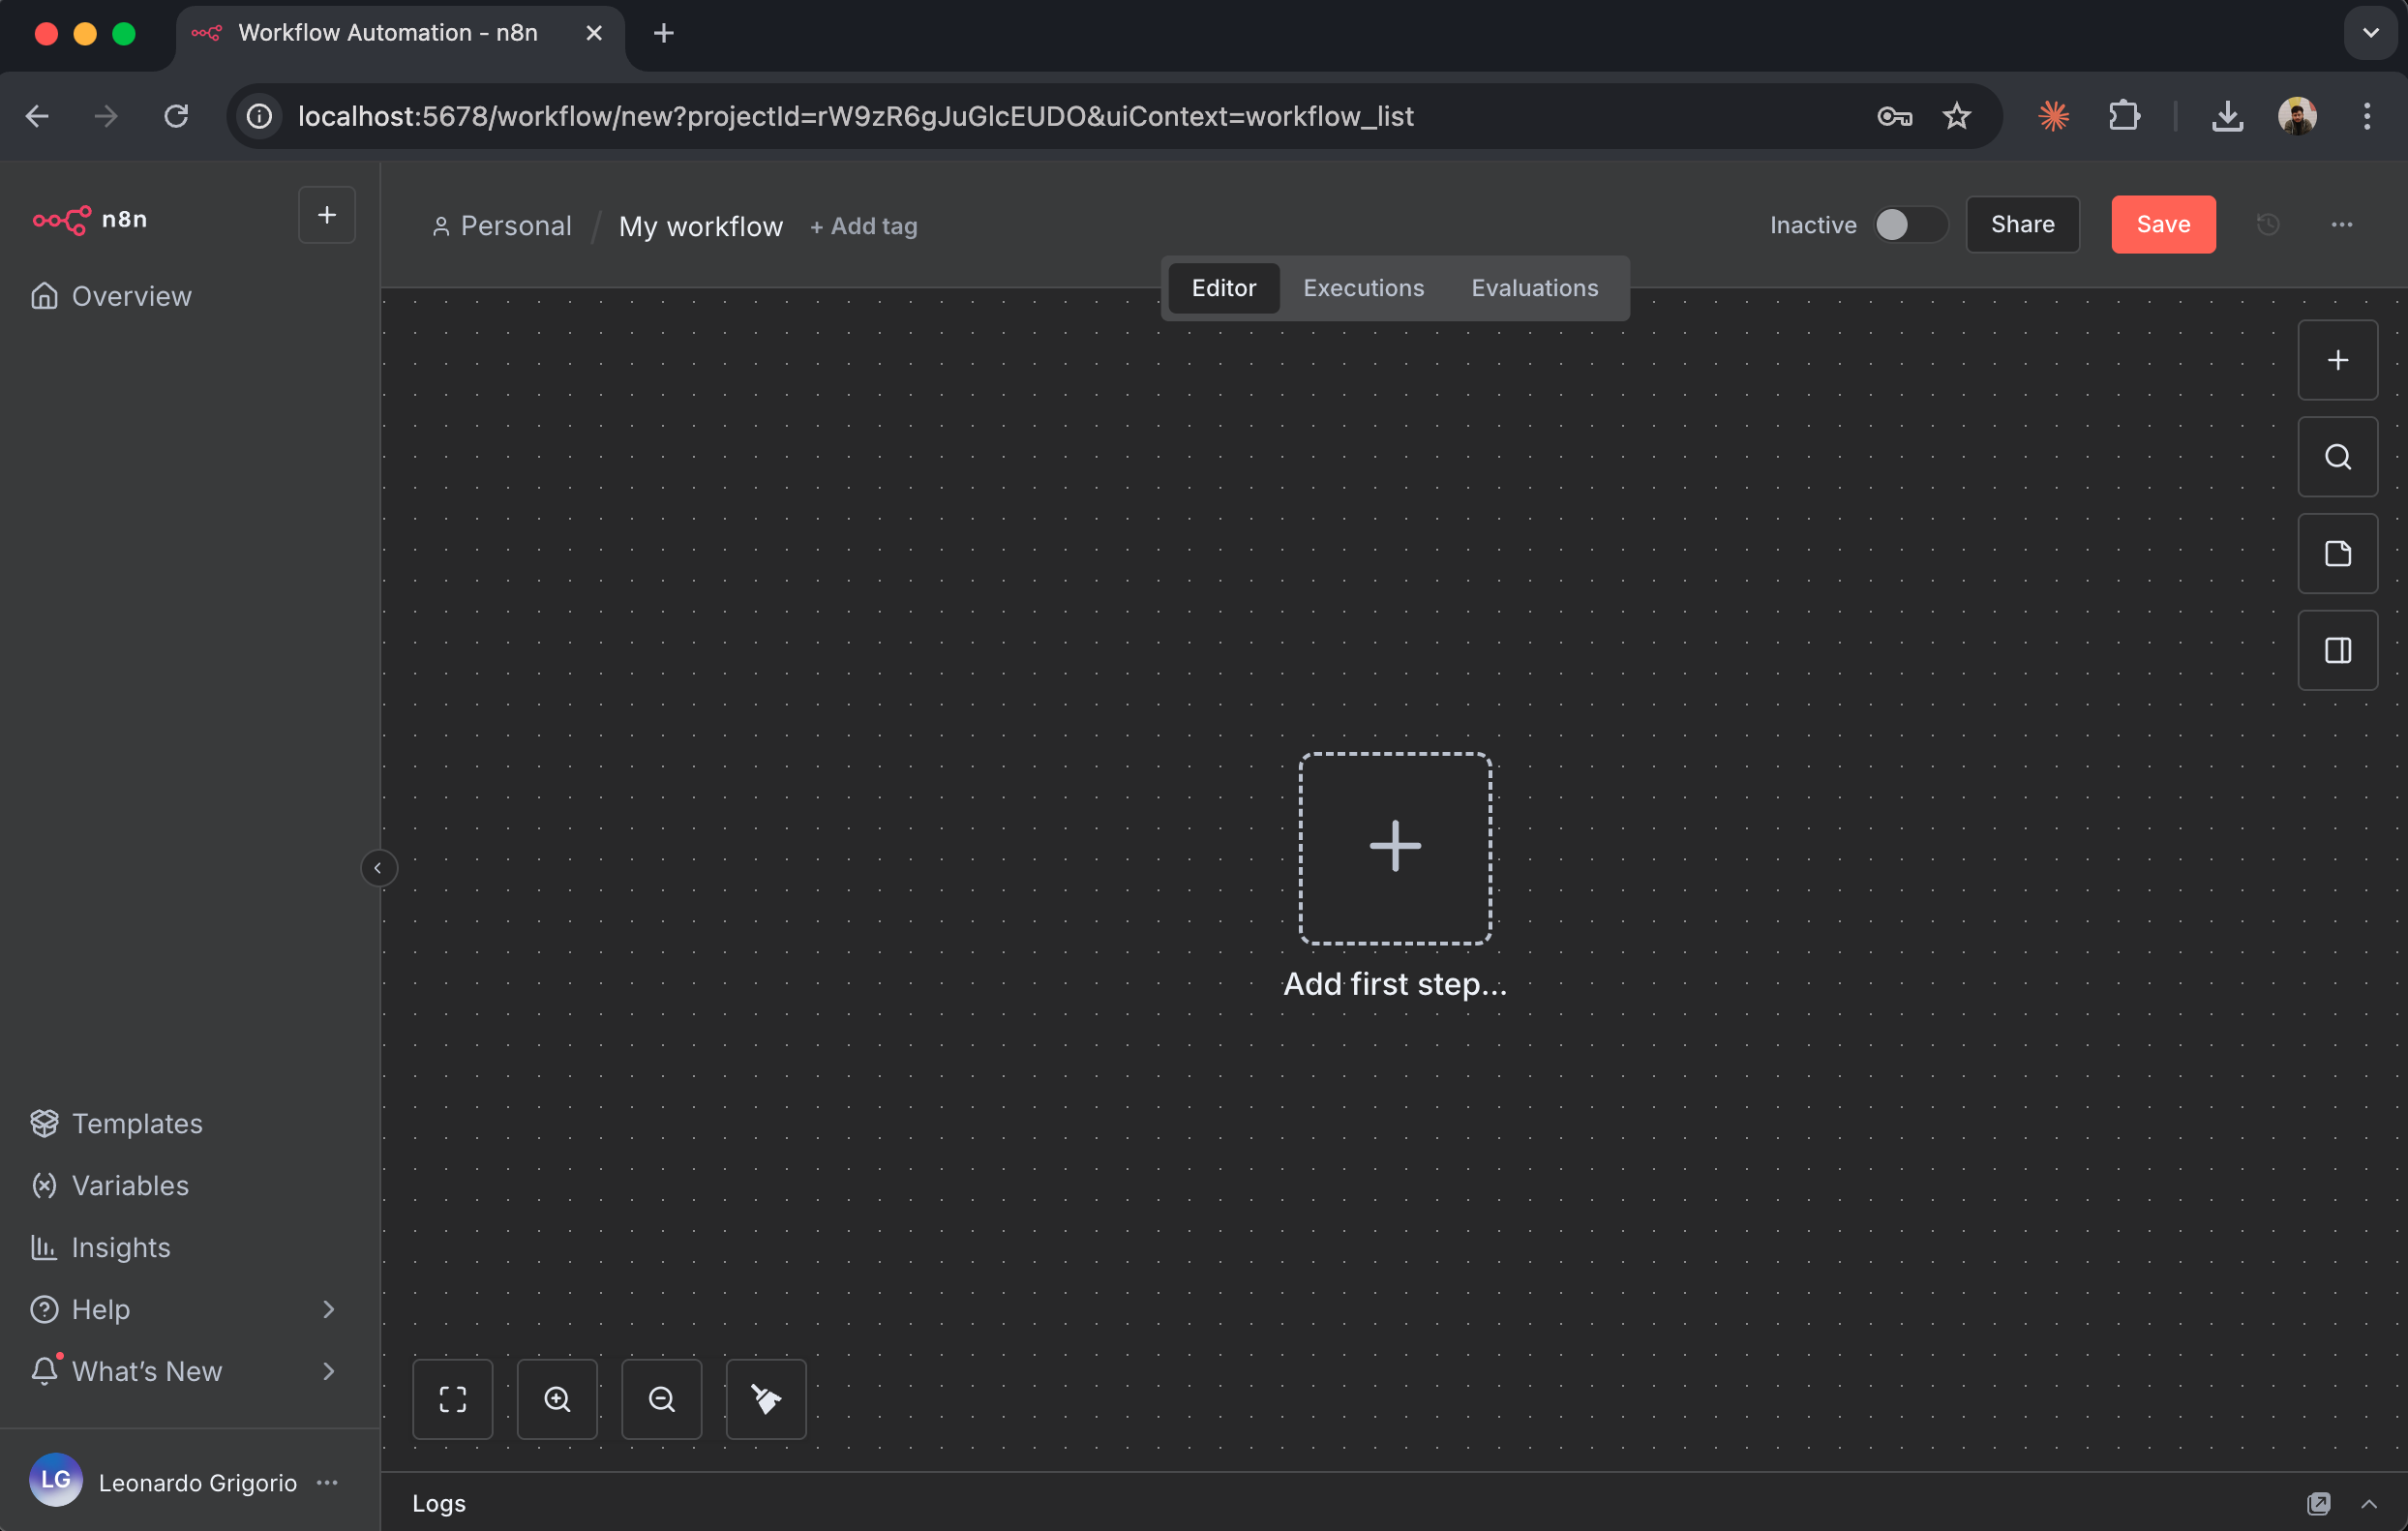
- Lienzo: El área principal donde colocas y conectas nodos
- Botón Añadir nodo (+): Haz clic para añadir nuevos nodos a tu flujo de trabajo
- Panel de nodos: Se abre al hacer clic en ”+” y muestra todos los nodos disponibles
- Ejecutar flujo de trabajo: Ejecuta manualmente tu flujo de trabajo para probarlo
- Guardar: Guarda la configuración de tu flujo de trabajo
Paso 3: Instala y configura el nodo de Firecrawl
Firecrawl está disponible en n8n como nodo verificado (@mendable/n8n-nodes-firecrawl), desarrollado y mantenido por Firecrawl. Instalarás el nodo y lo conectarás a tu cuenta de Firecrawl con la clave de API que creaste anteriormente. En instancias autogestionadas de n8n, el propietario de la instancia instala los nodos verificados una sola vez y, a partir de entonces, todos los usuarios de la instancia pueden usarlos.
Añade el nodo de Firecrawl a tu flujo de trabajo
- En el lienzo de tu nuevo flujo de trabajo, haz clic en el botón ”+” del centro
- Se abrirá el panel de selección de nodos en el lado derecho
- En el cuadro de búsqueda de la parte superior, escribe “Firecrawl”
- Verás que el nodo de Firecrawl aparece en los resultados de búsqueda
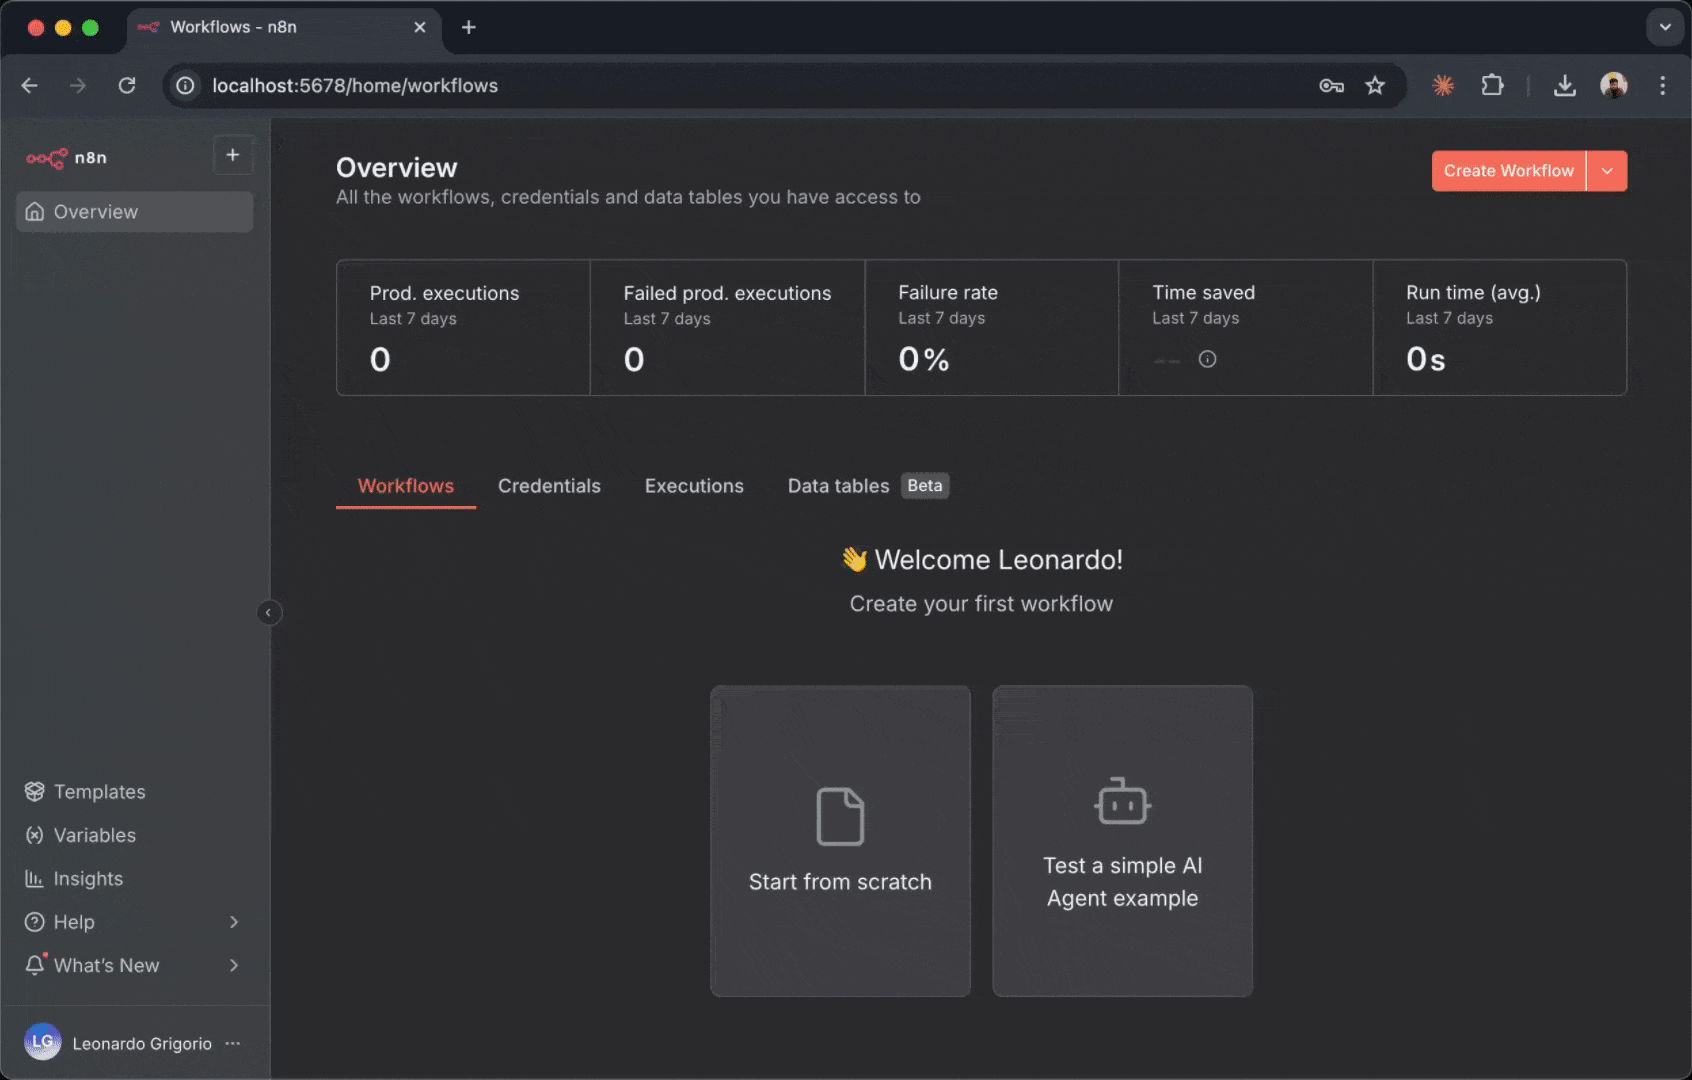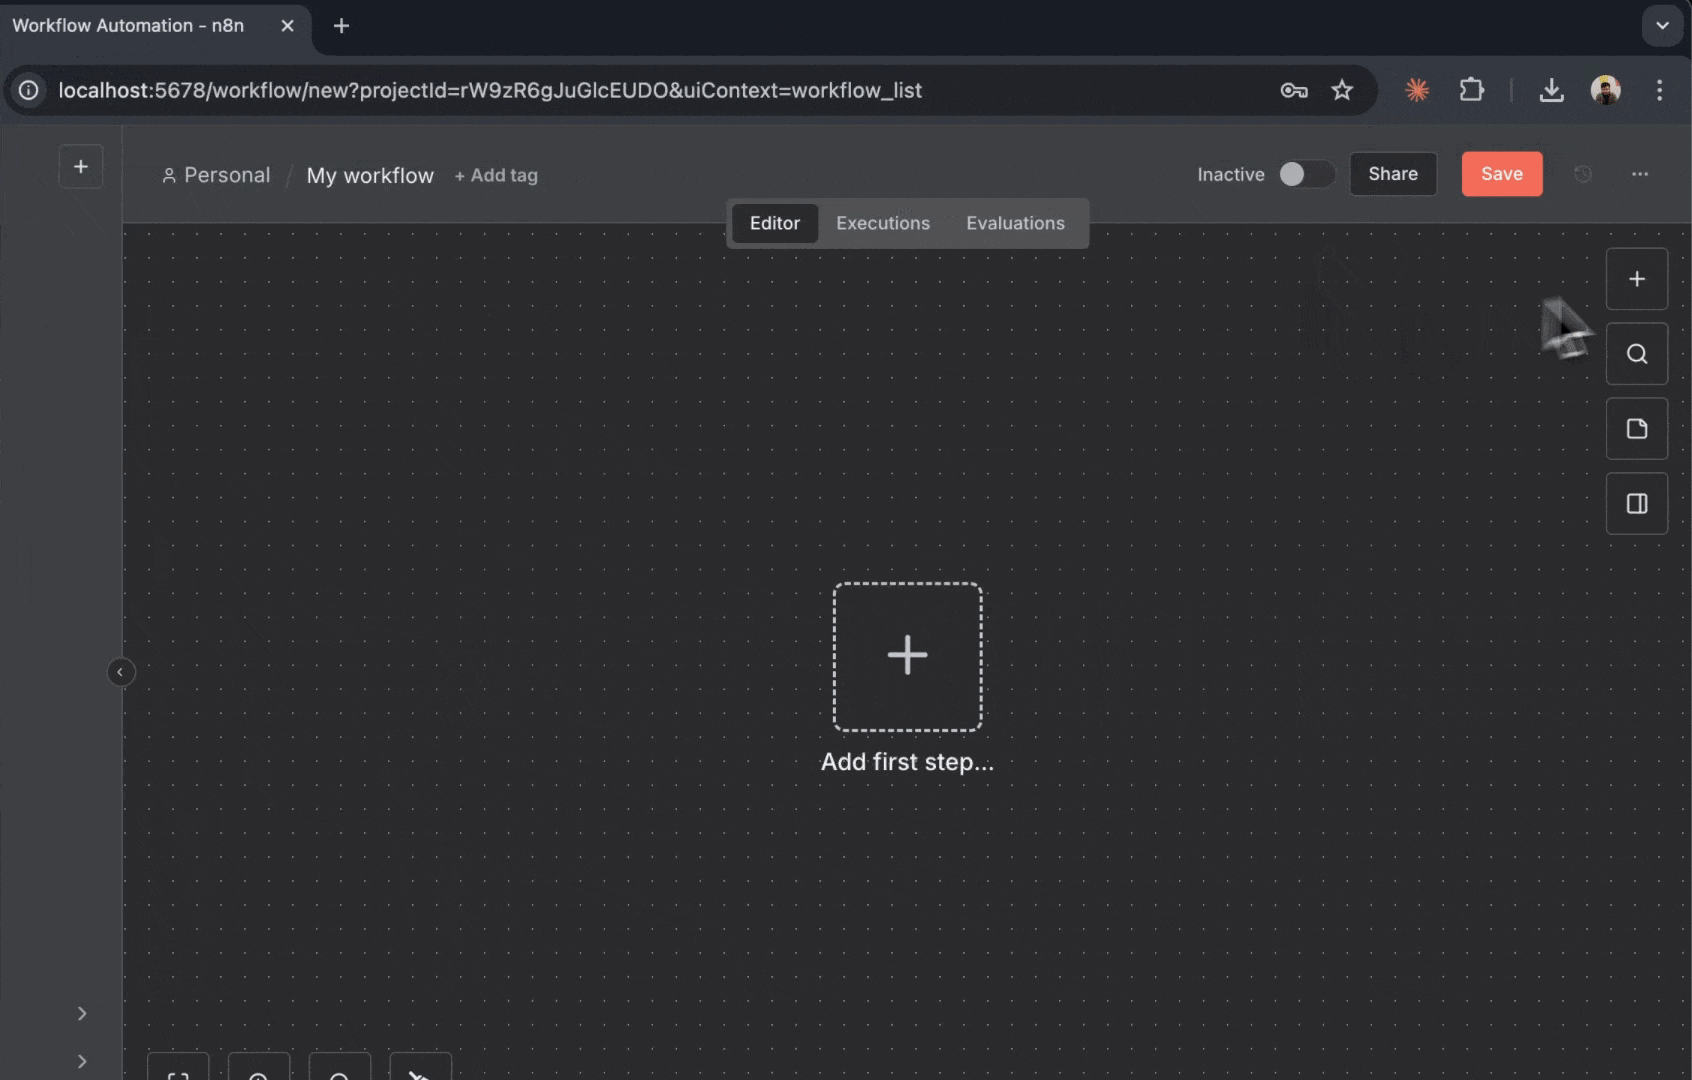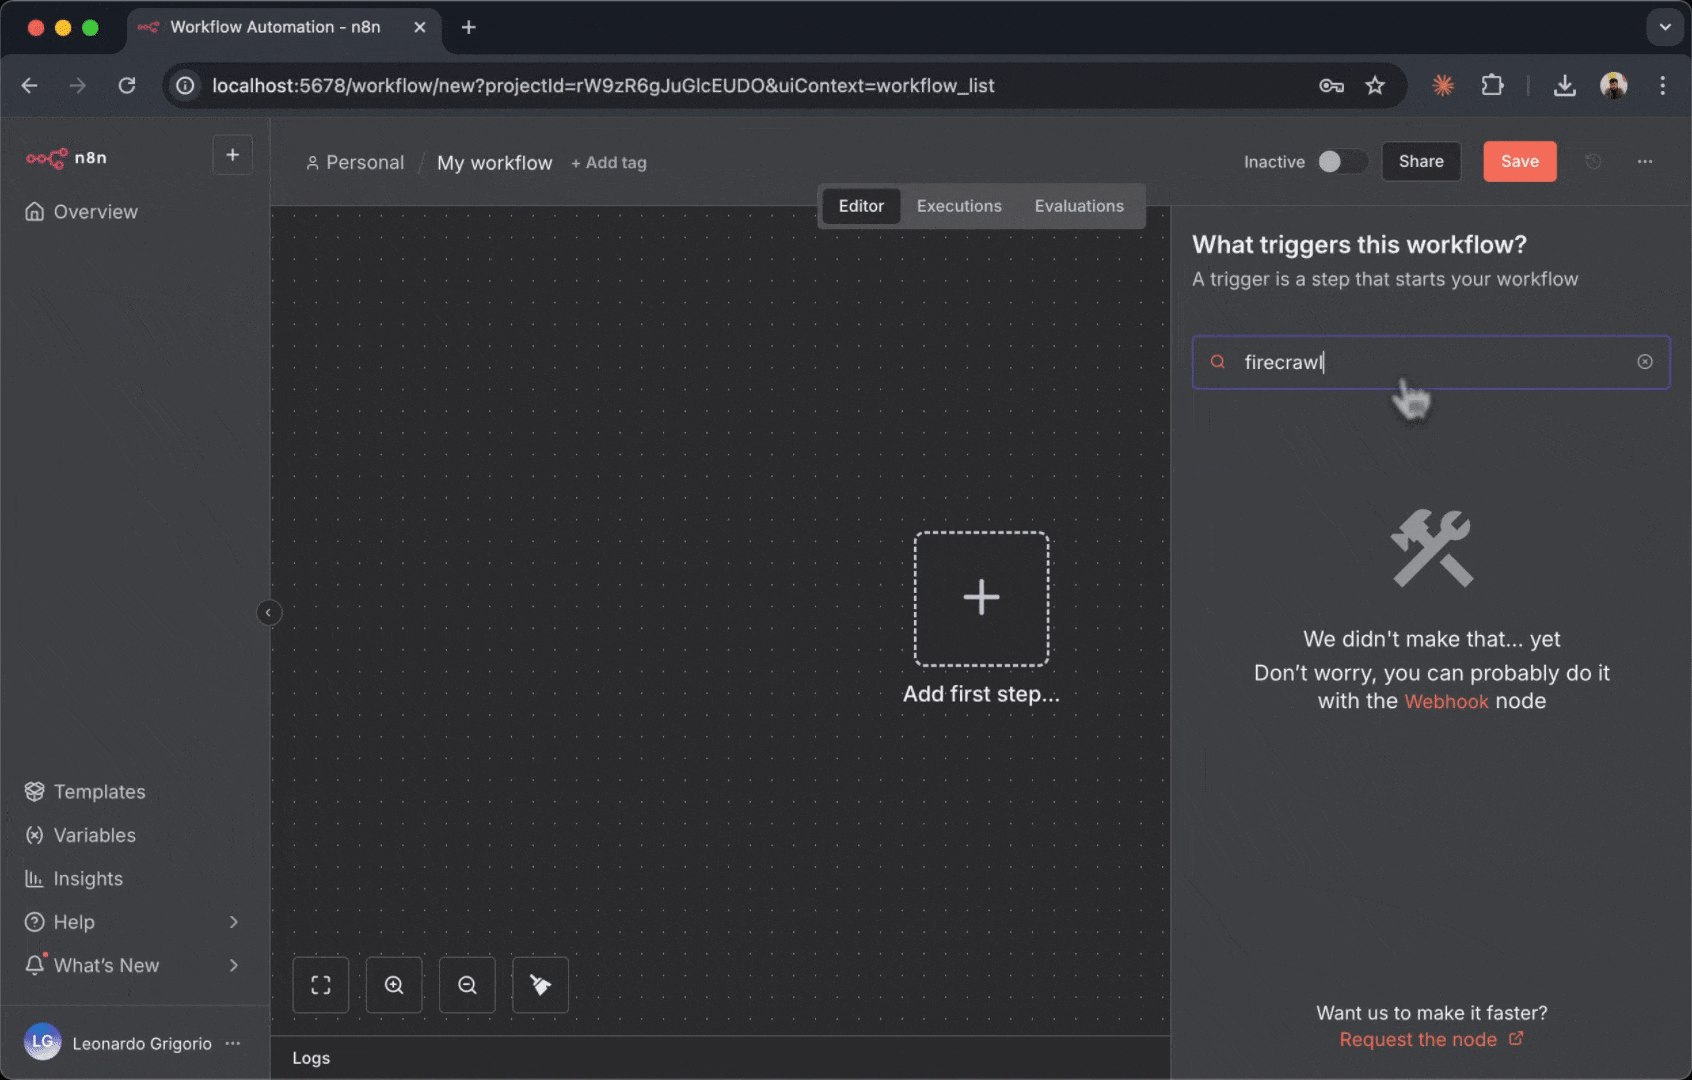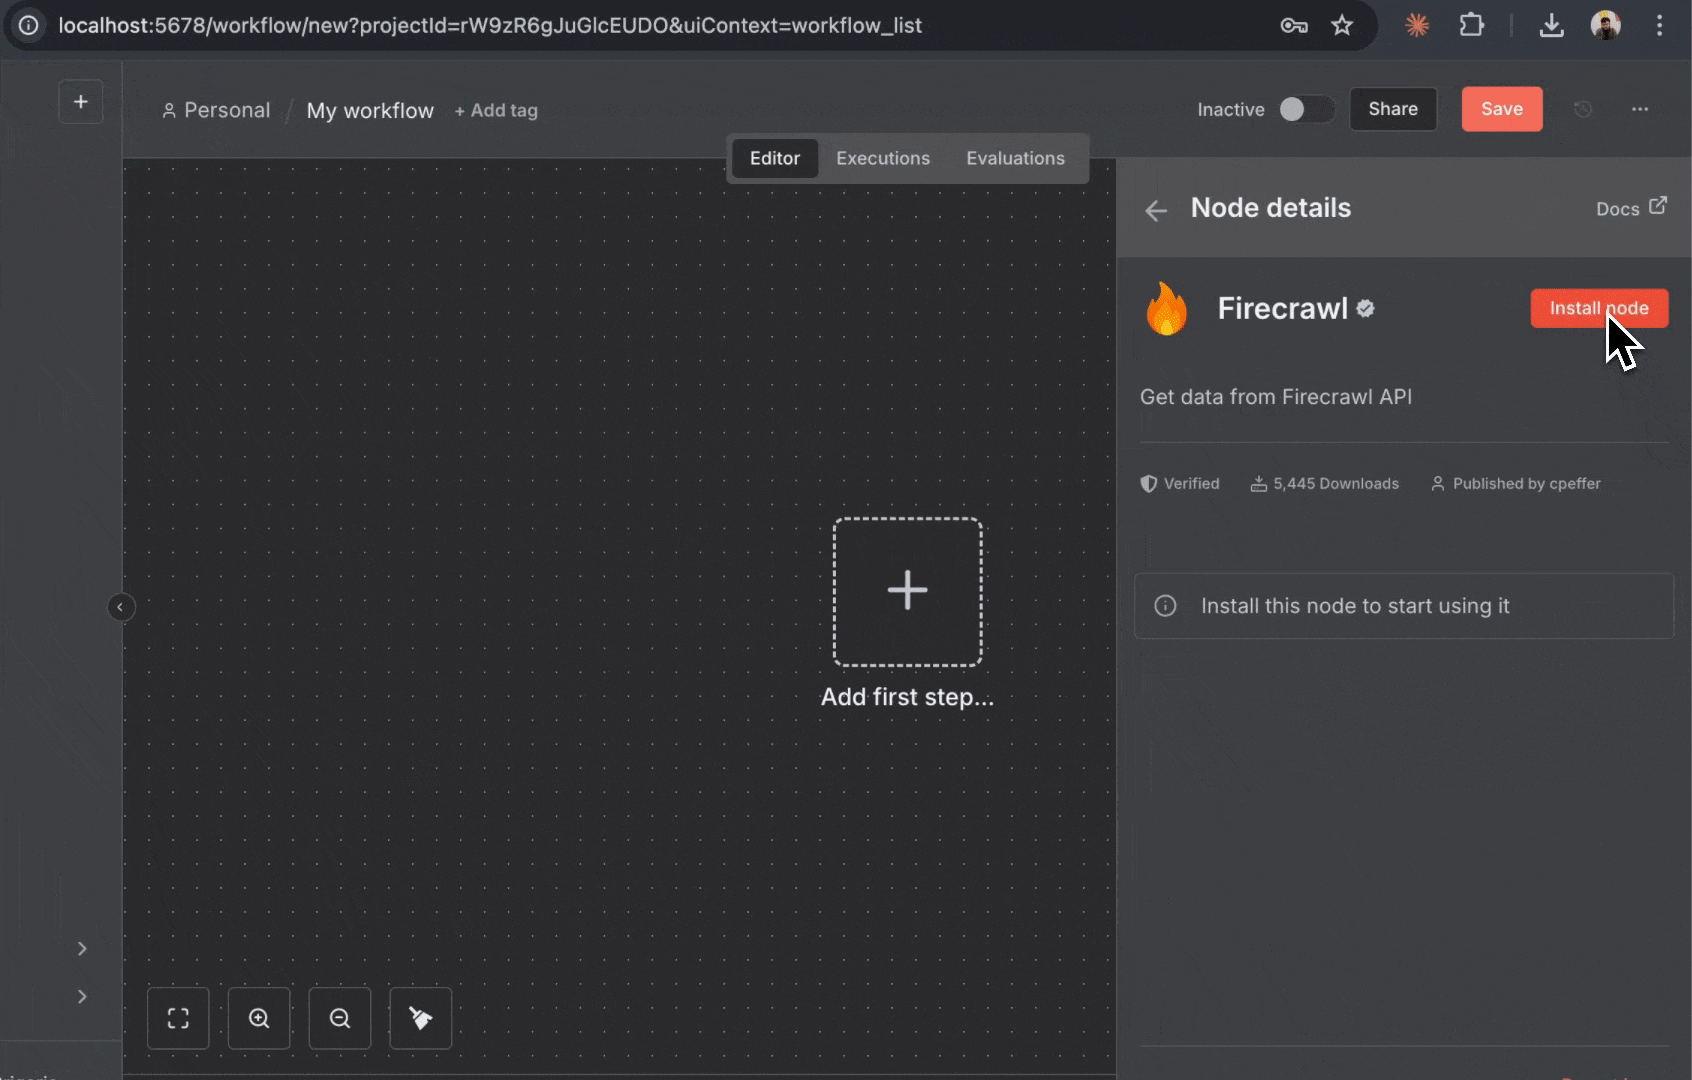
- Haz clic en “Instalar” junto al nodo de Firecrawl
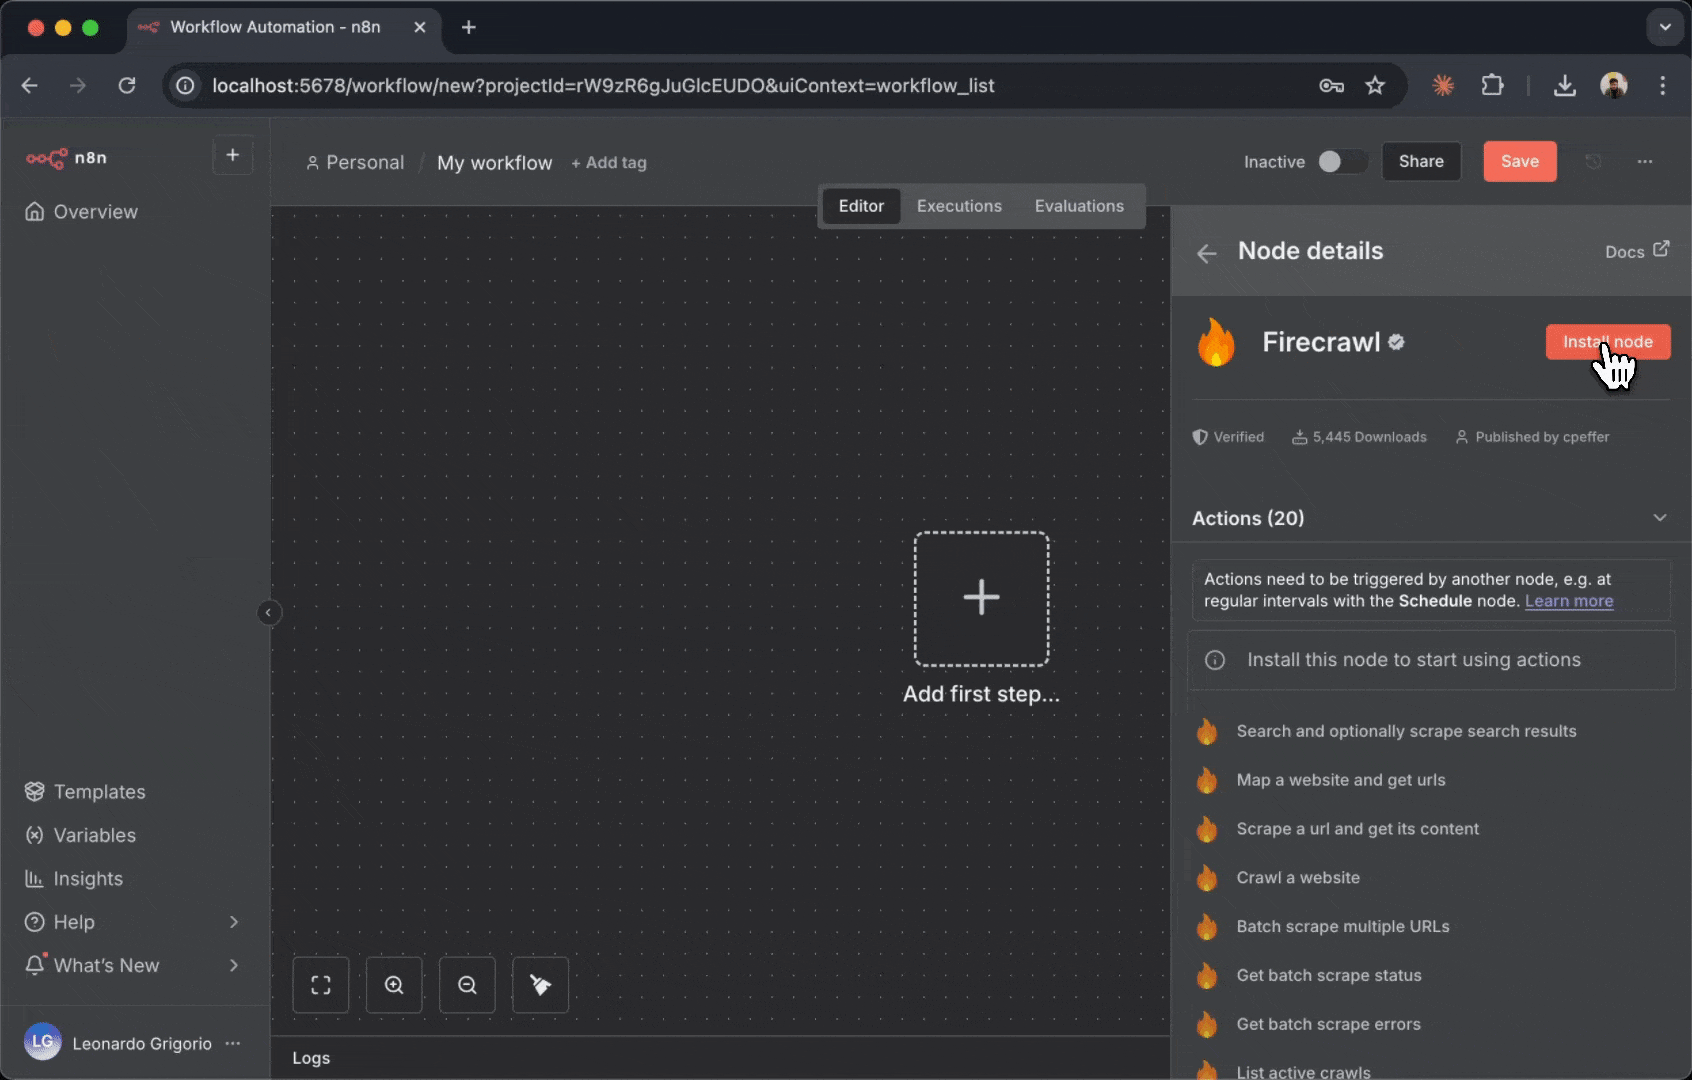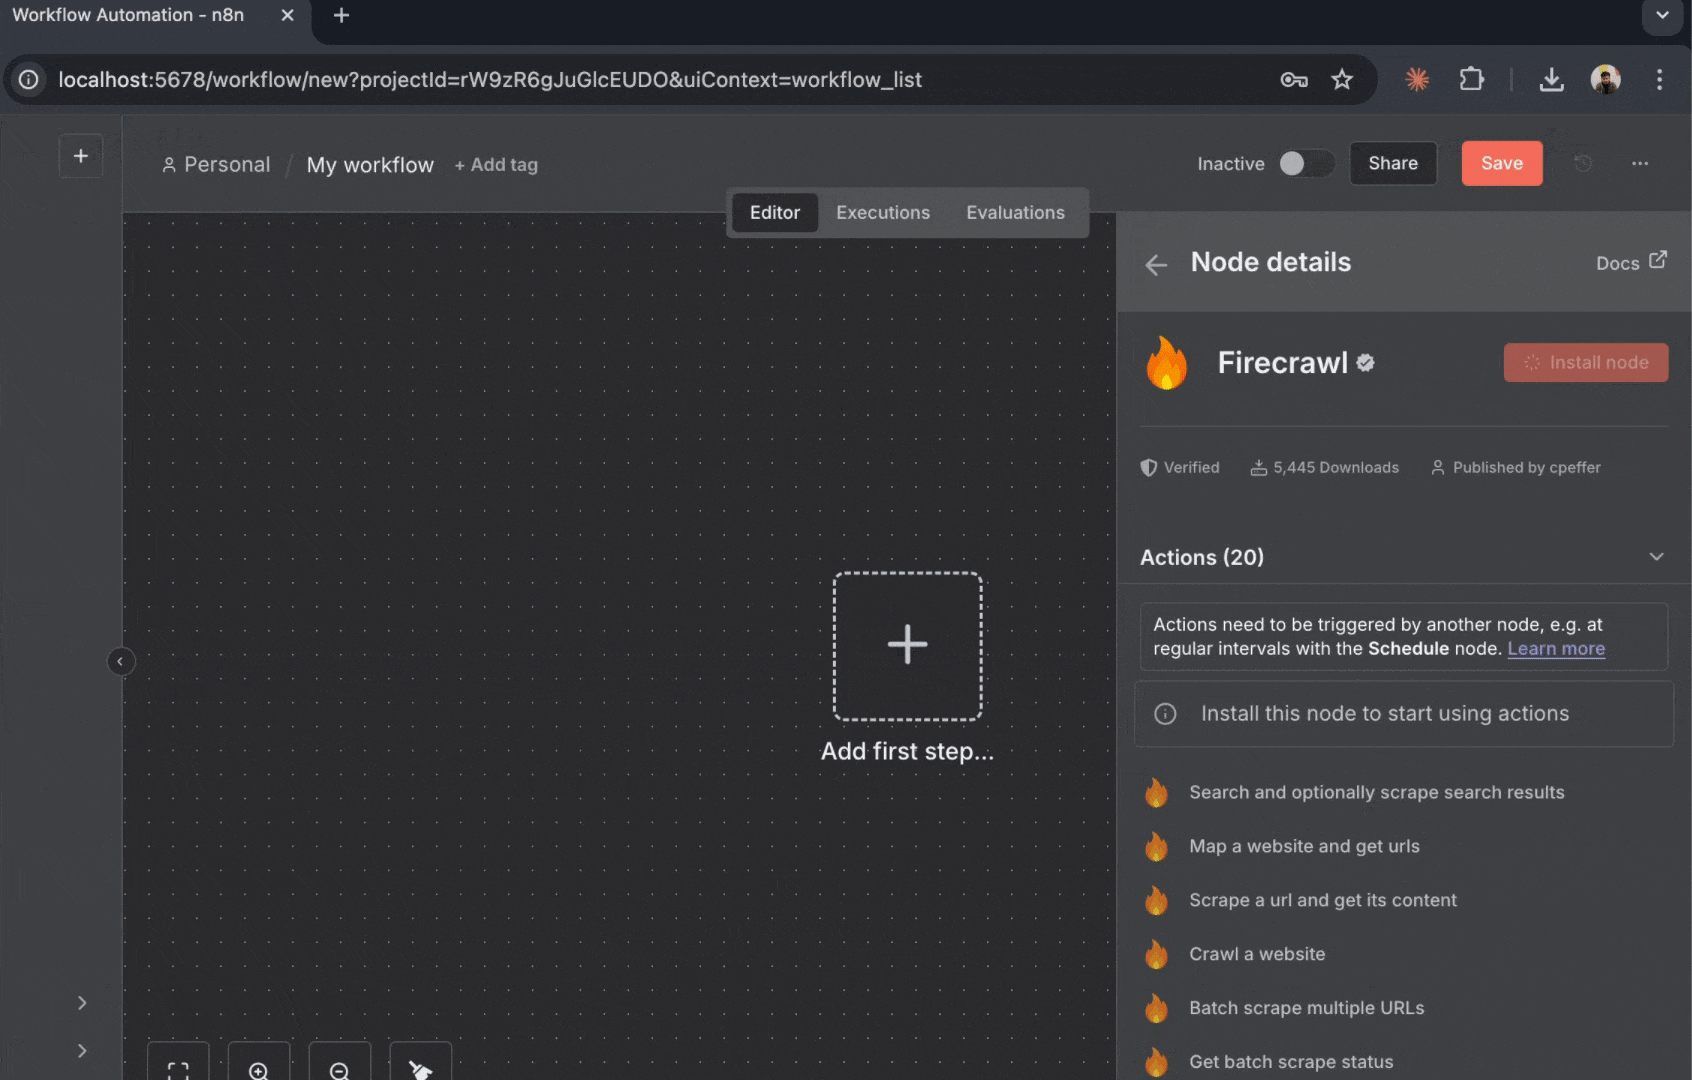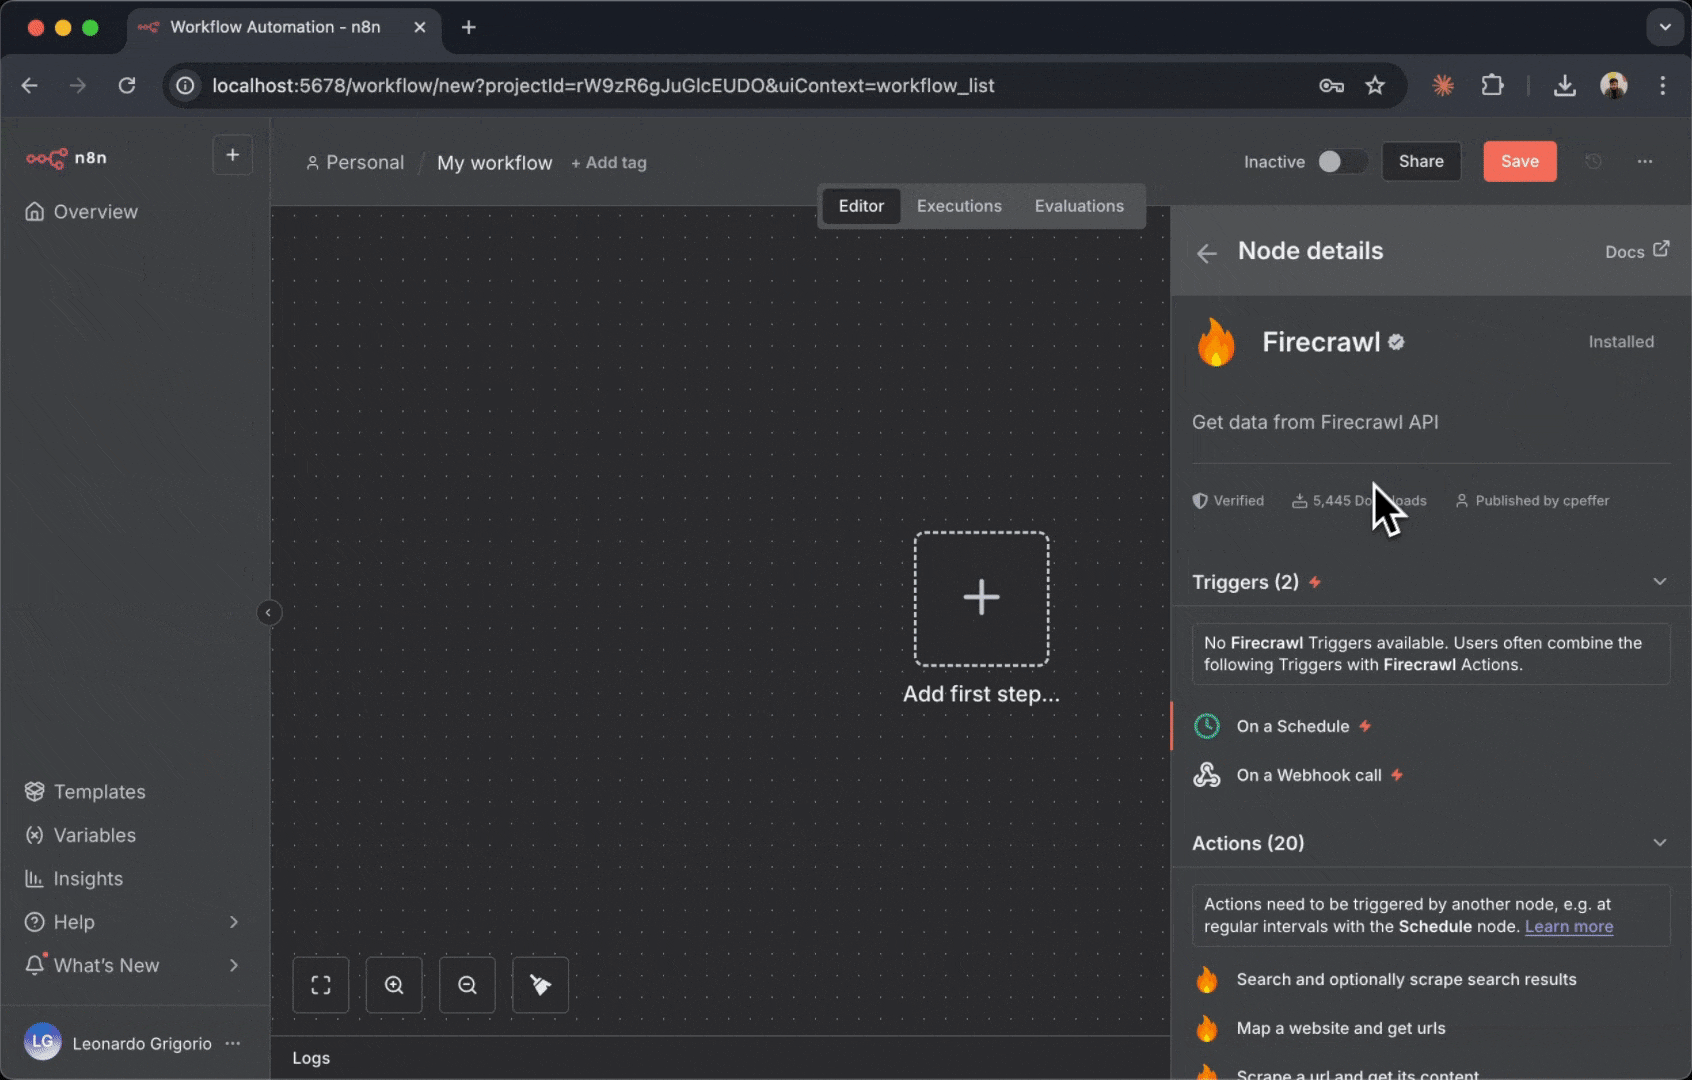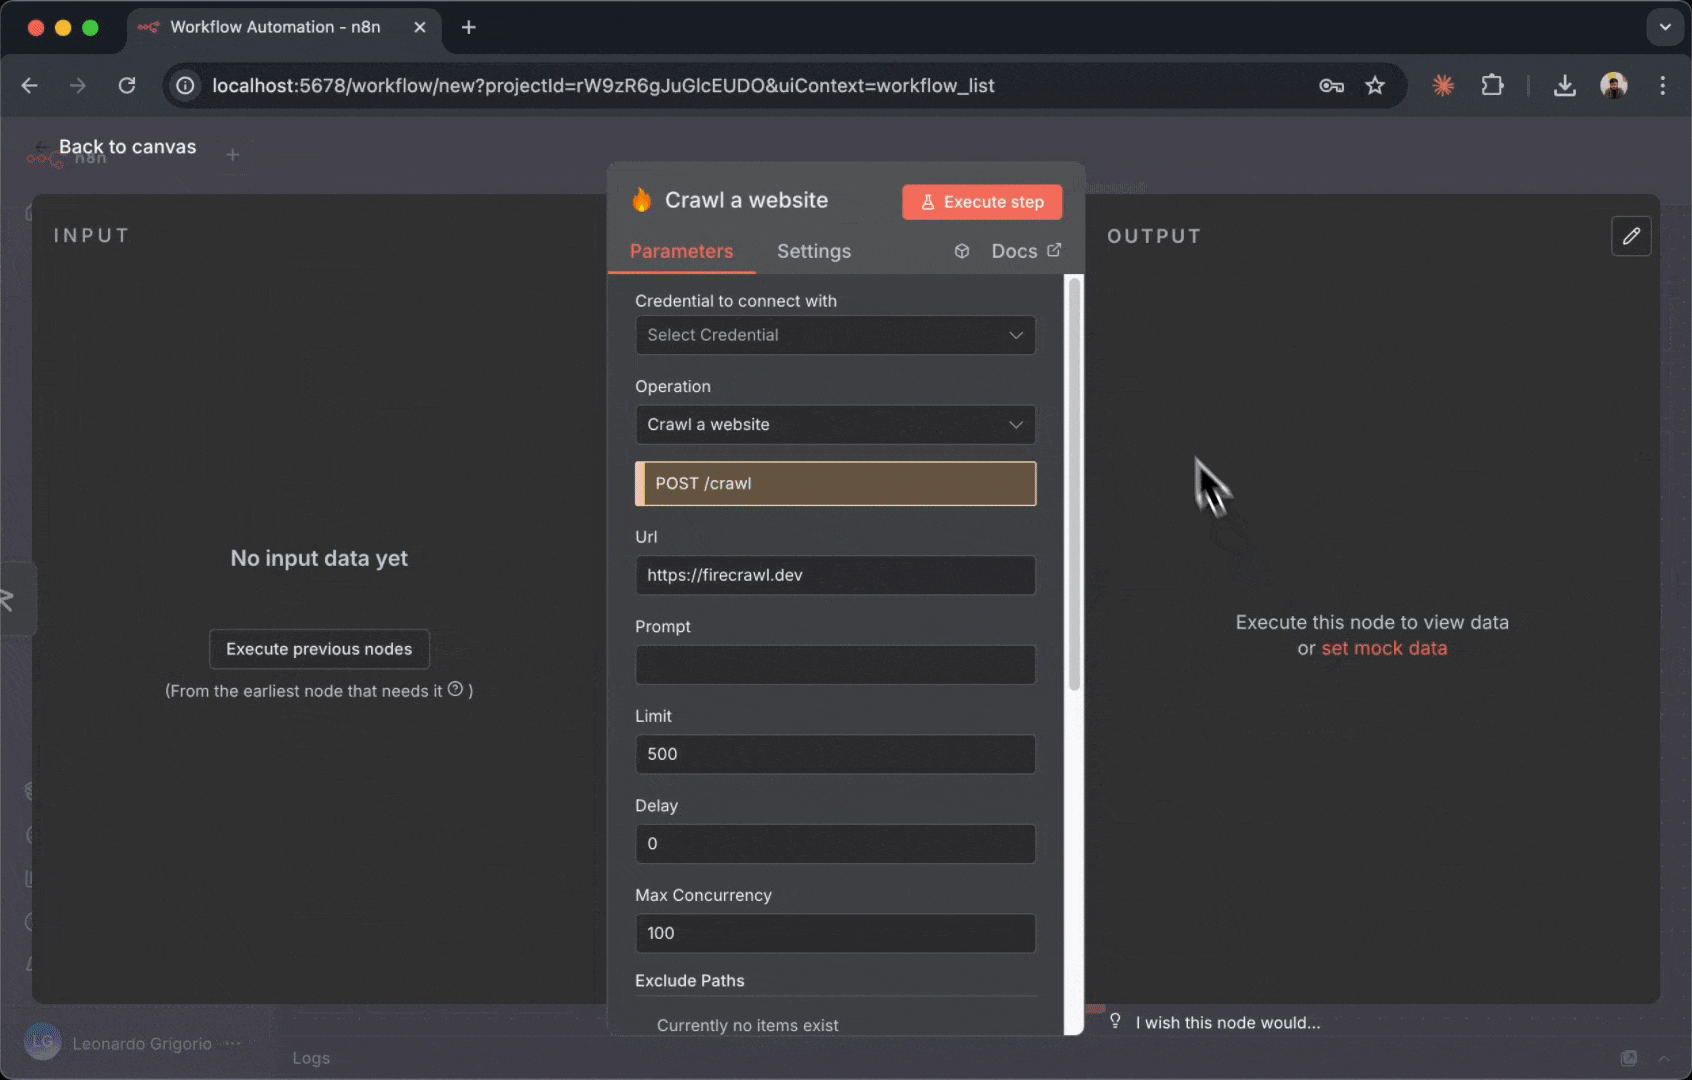
- Espera a que finalice la instalación (tardará unos segundos)
- Una vez instalado, haz clic en el nodo de Firecrawl para añadirlo al lienzo
Conecta tu clave de API de Firecrawl
Antes de poder usar el nodo de Firecrawl, debes autenticarlo con tu clave de API:- Haz clic en el recuadro del nodo de Firecrawl para abrir su panel de configuración a la derecha.
- En la parte superior, verás un menú desplegable llamado “credencial para conectarse”.
- Como es la primera vez que lo haces, haz clic en “crear nueva credencial”.
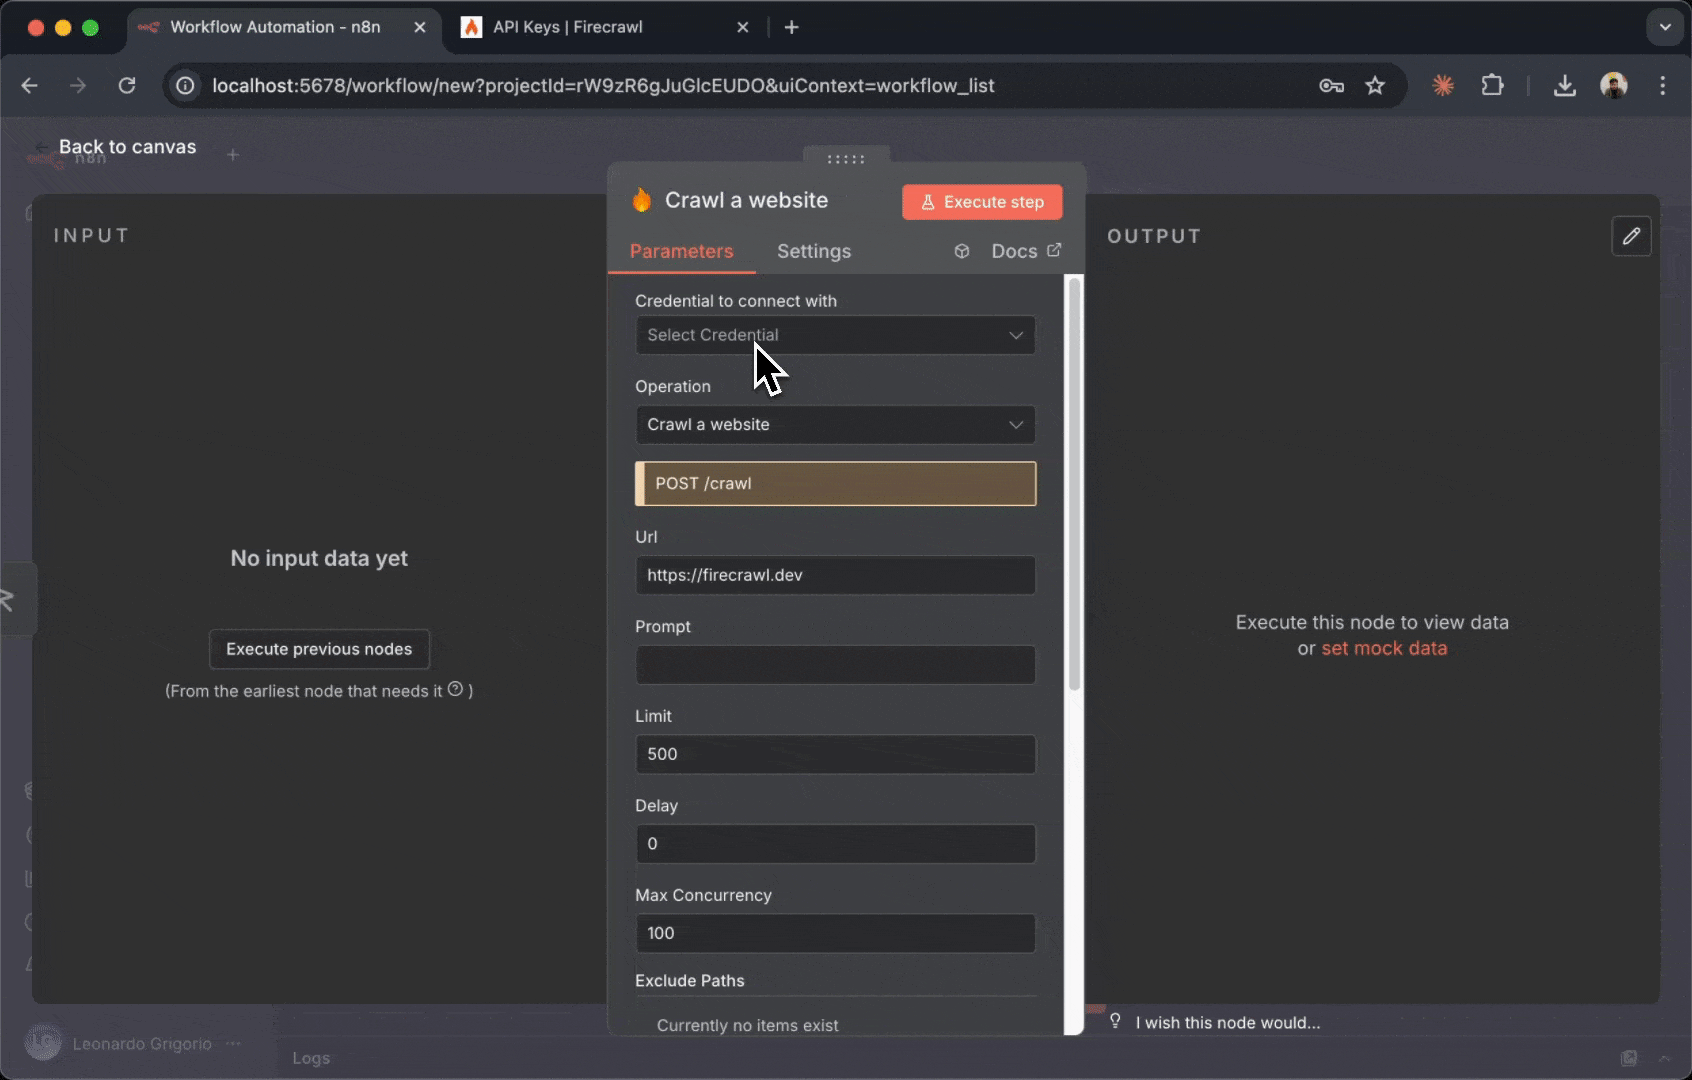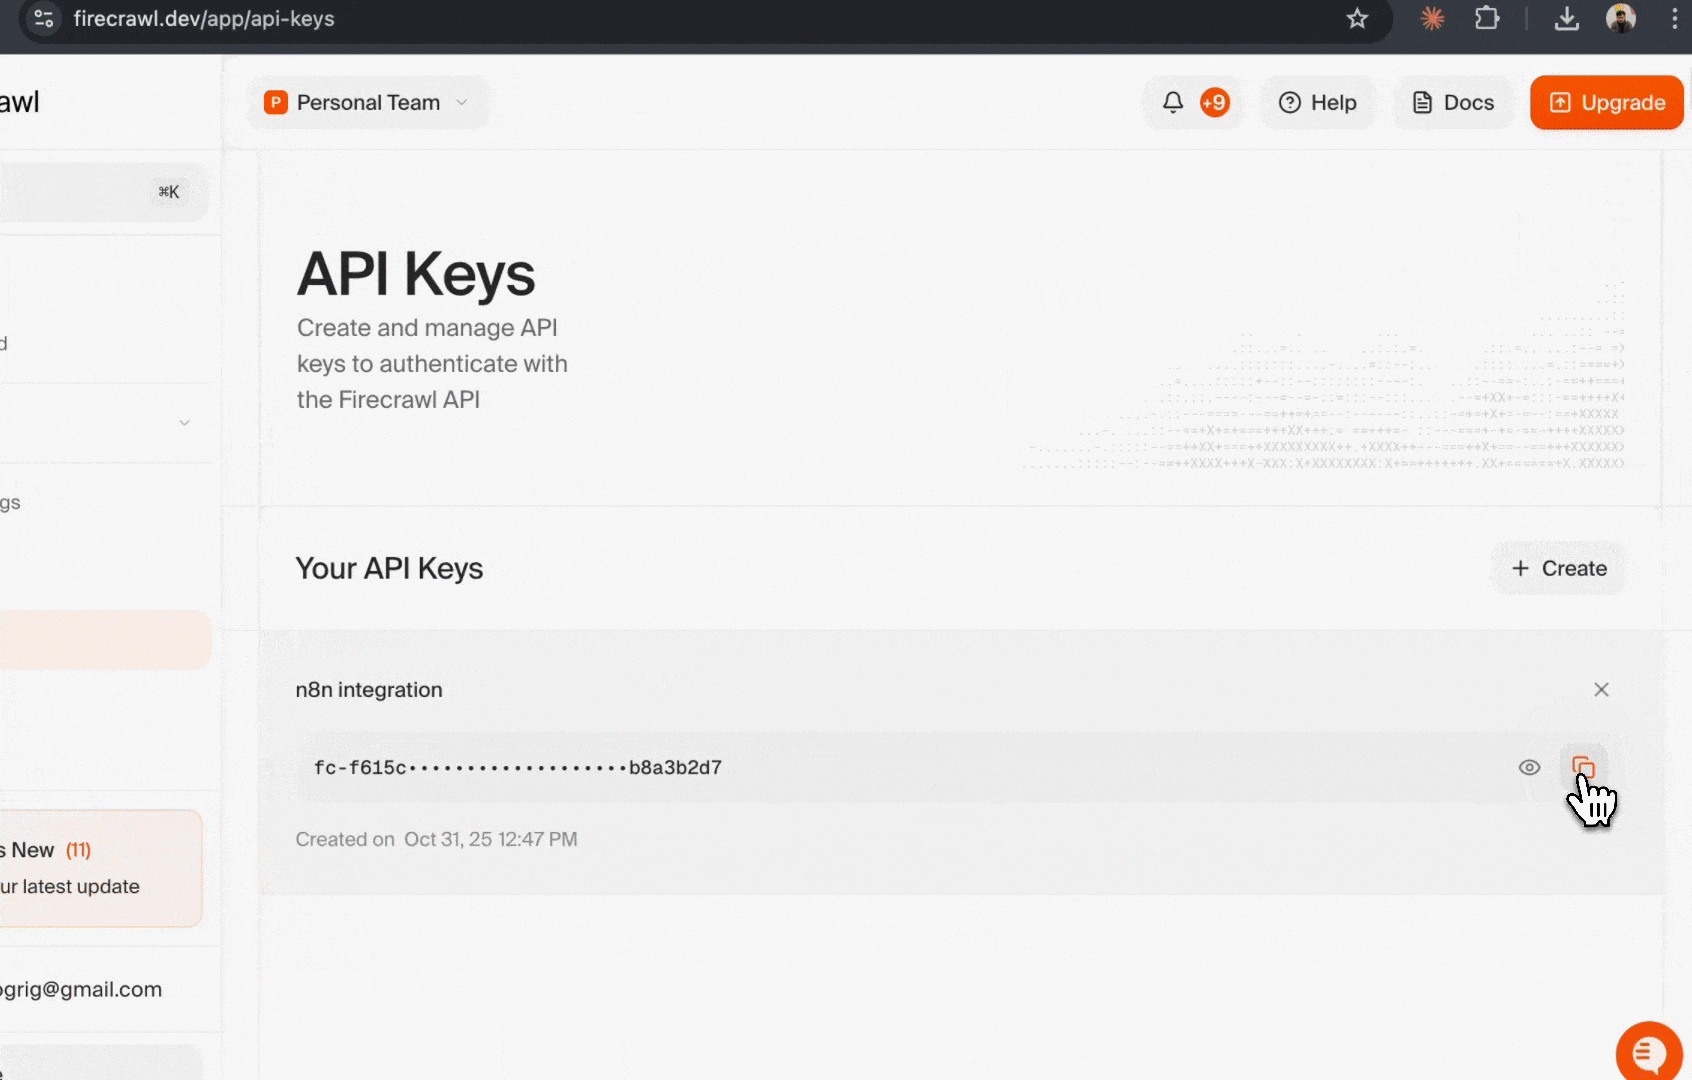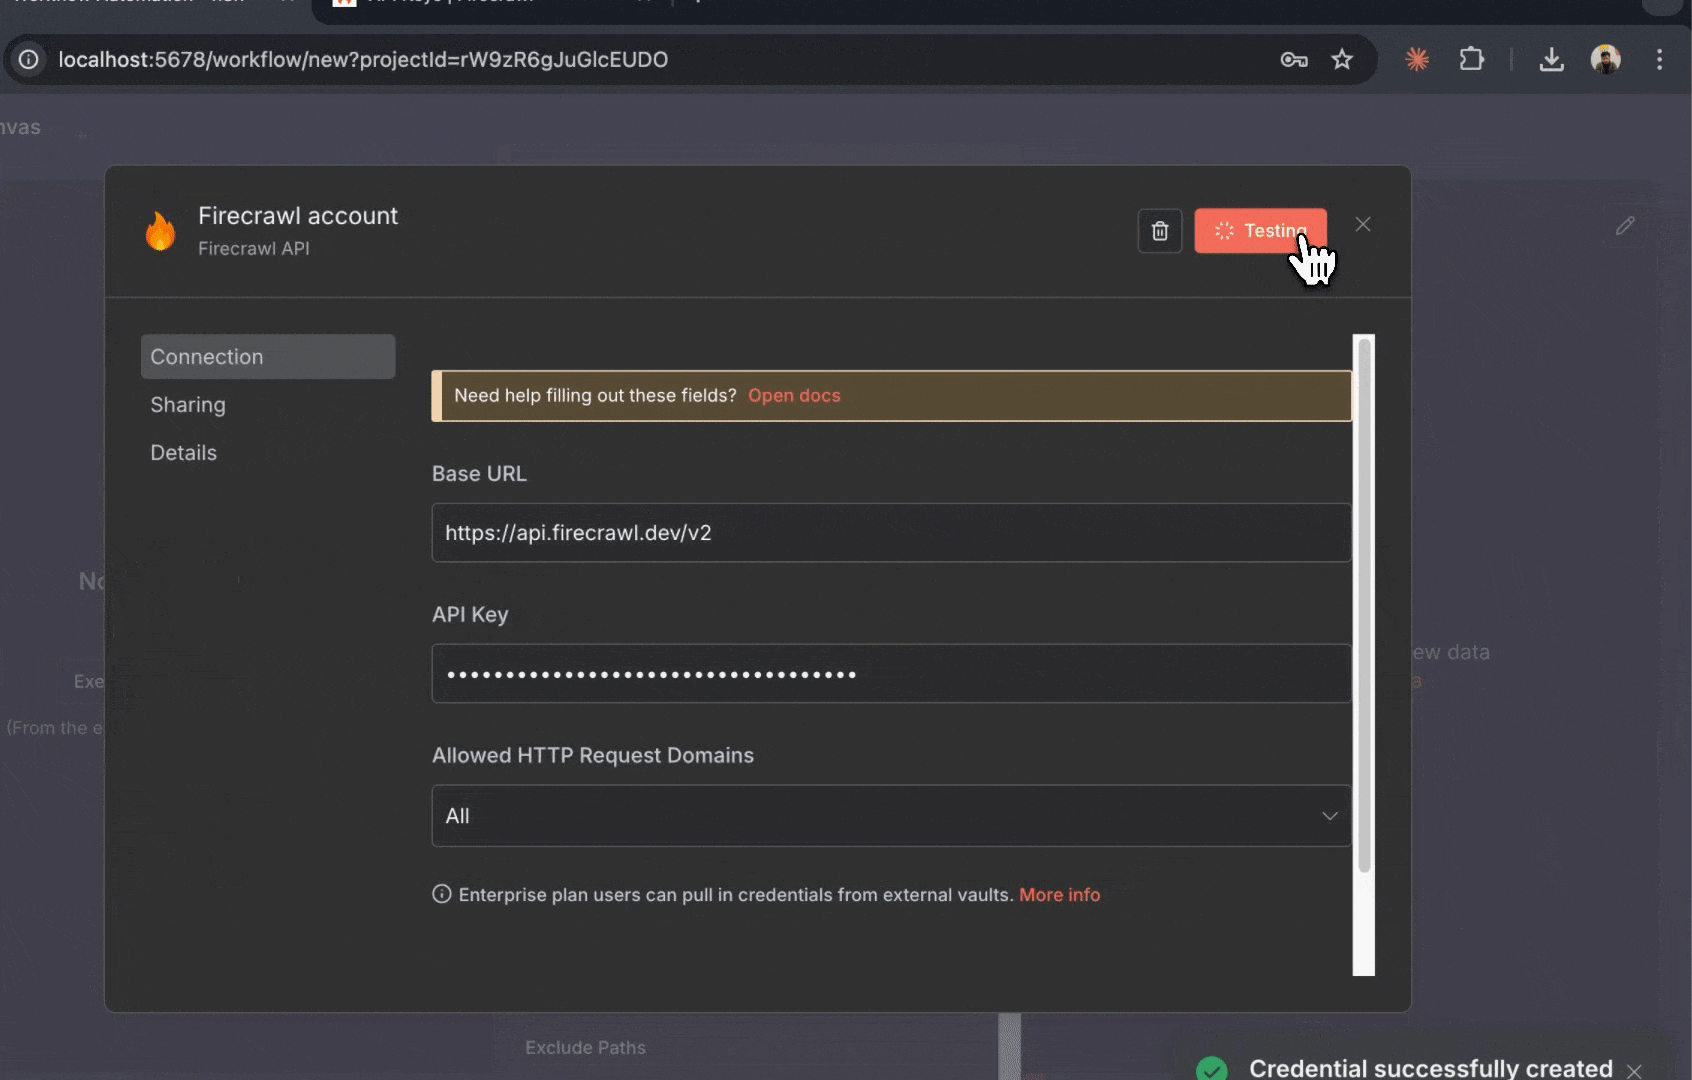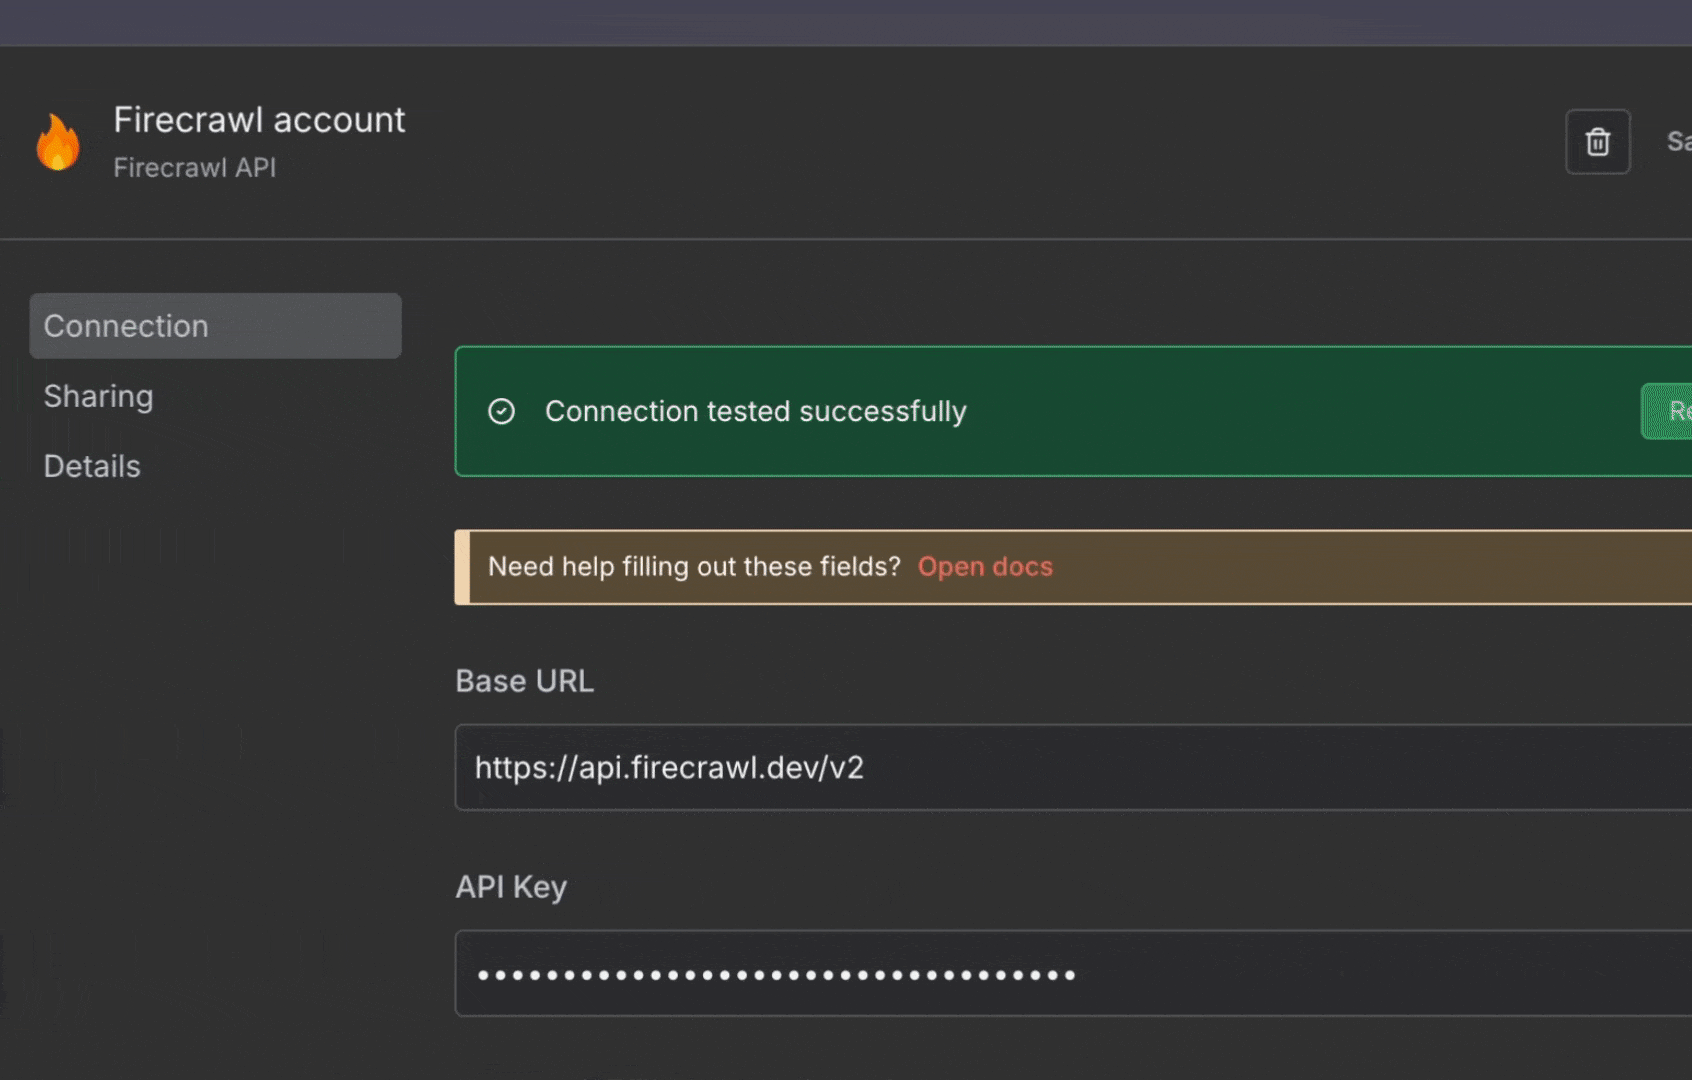
- Se abrirá una ventana de configuración de credenciales.
- Introduce un nombre para esta credencial (por ejemplo, “Mi cuenta de Firecrawl”).
- Pega tu clave de API de Firecrawl en el campo “clave de API”.
- Haz clic en “Save” en la parte inferior.
La credencial también incluye un campo Base URL, cuyo valor predeterminado es
https://api.firecrawl.dev/v2. Es posible que las credenciales creadas con versiones anteriores del nodo sigan apuntando a https://api.firecrawl.dev/v1. Con una Base URL de v1, las operaciones que solo existen en v2, como Agent, Browser e Interact, fallan con un error 404 (“The resource you are requesting could not be found”). Abre la credencial y cambia Base URL a https://api.firecrawl.dev/v2.Prueba la conexión
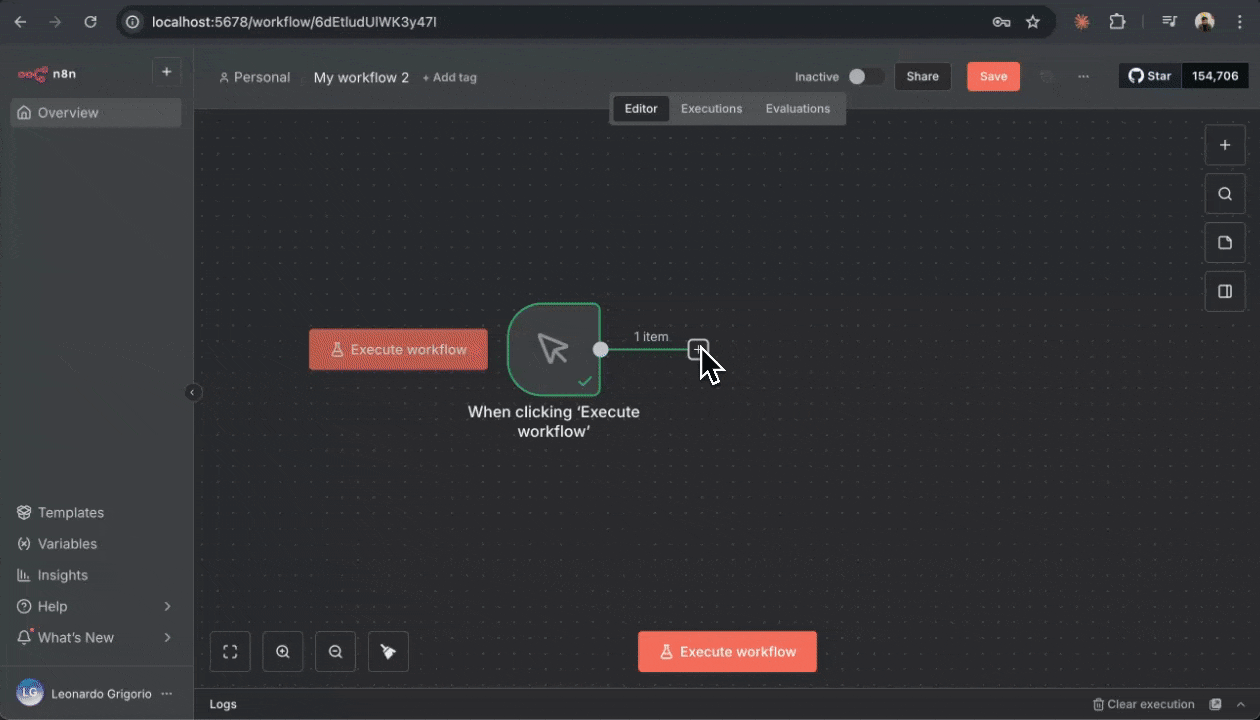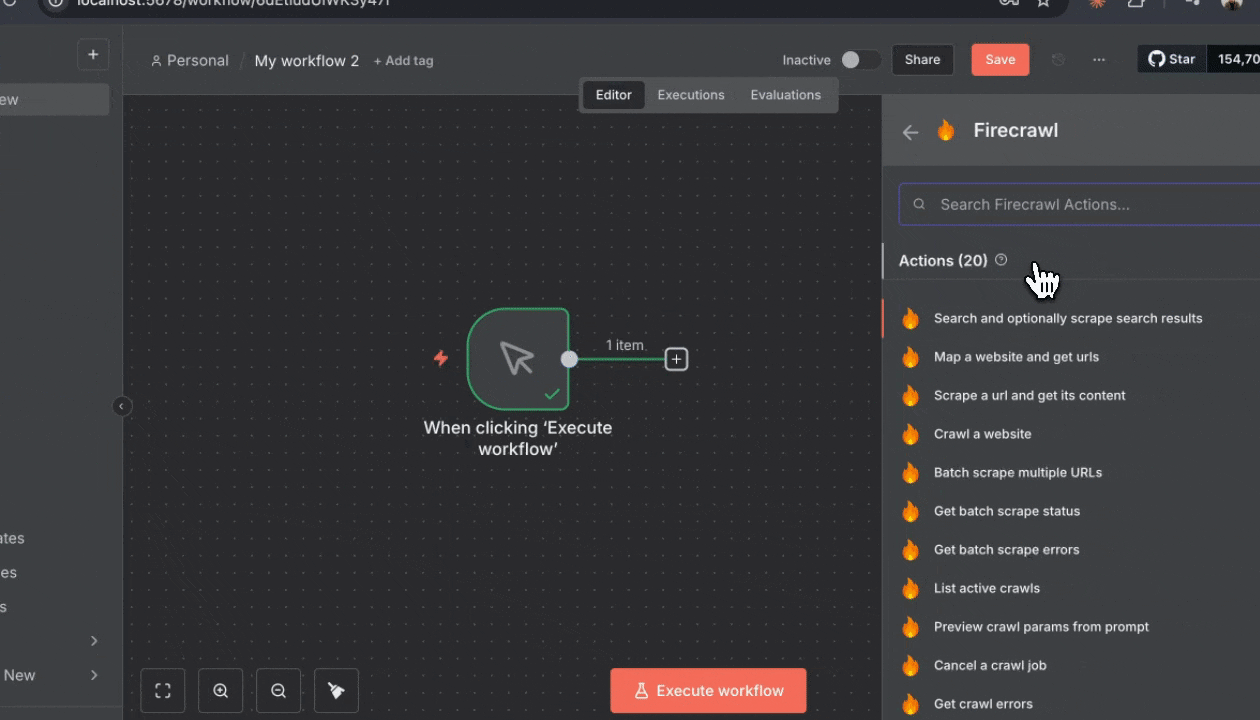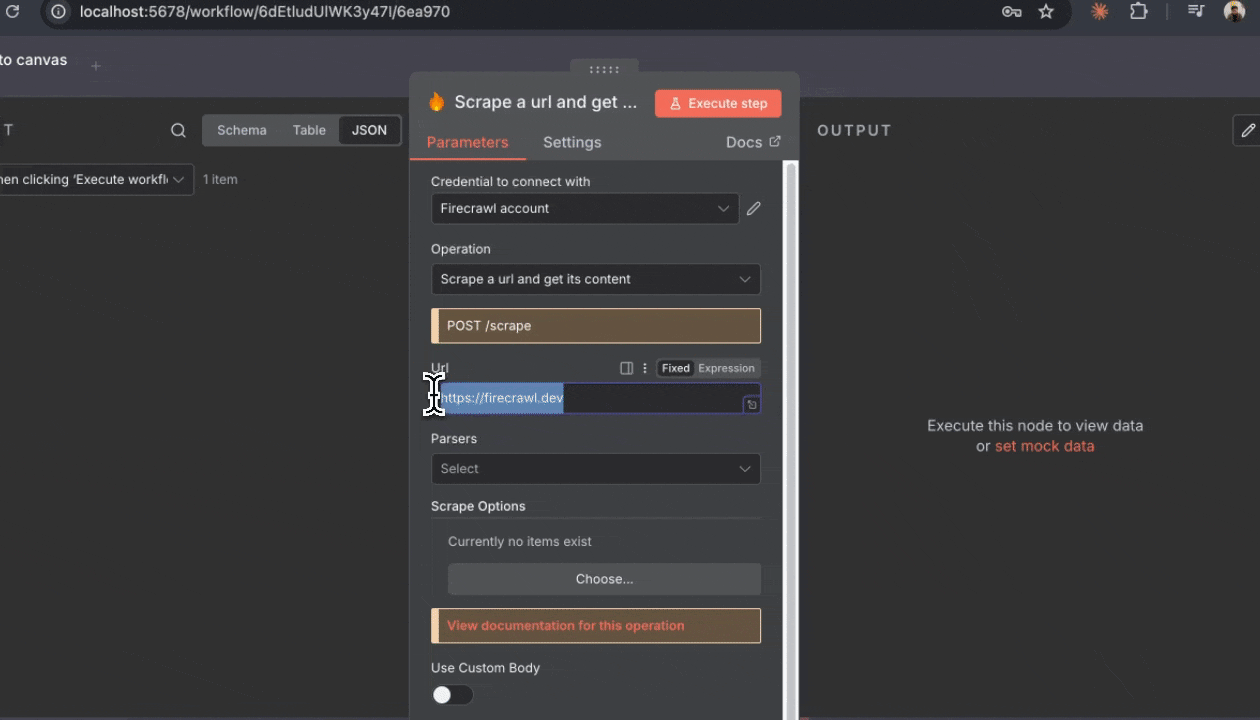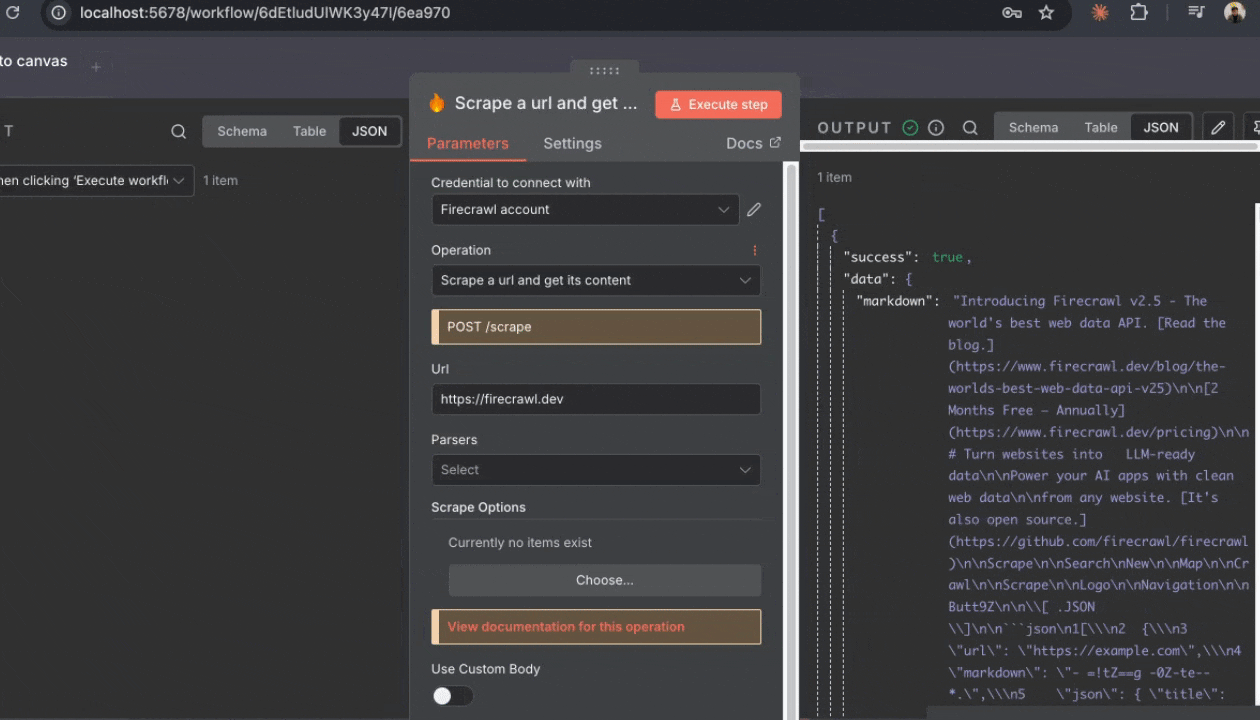
Verifiquemos que tu nodo de Firecrawl esté conectado correctamente:- Con el nodo de Firecrawl todavía seleccionado, revisa el panel de configuración.
- Establece Recurso en “Scraping” y Operación en “Scrape URL”.
- En el campo “URL”, introduce:
https://firecrawl.dev. - Por ahora, deja el resto de la configuración con los valores predeterminados.
- Haz clic en el botón “Execute step”.
Paso 4: Crea tu bot de Telegram
Antes de crear tu primer flujo de trabajo, necesitarás un bot de Telegram para recibir notificaciones. Los bots de Telegram son gratuitos y fáciles de crear con BotFather de Telegram.Crea un bot con BotFather
- Abre Telegram en tu teléfono o computadora
- Busca “@BotFather” (el bot oficial de Telegram)
- Inicia una conversación con BotFather haciendo clic en “Start”
- Envía el comando
/newbotpara crear un nuevo bot - BotFather te pedirá que elijas un nombre para tu bot (este es el nombre que verán los usuarios)
- Introduce un nombre como “My Firecrawl Bot”
- A continuación, elige un nombre de usuario para tu bot. Debe terminar en “bot” (p. ej., “my_firecrawl_updates_bot”)
- Si el nombre de usuario está disponible, BotFather creará tu bot y te enviará un mensaje con el token de tu bot
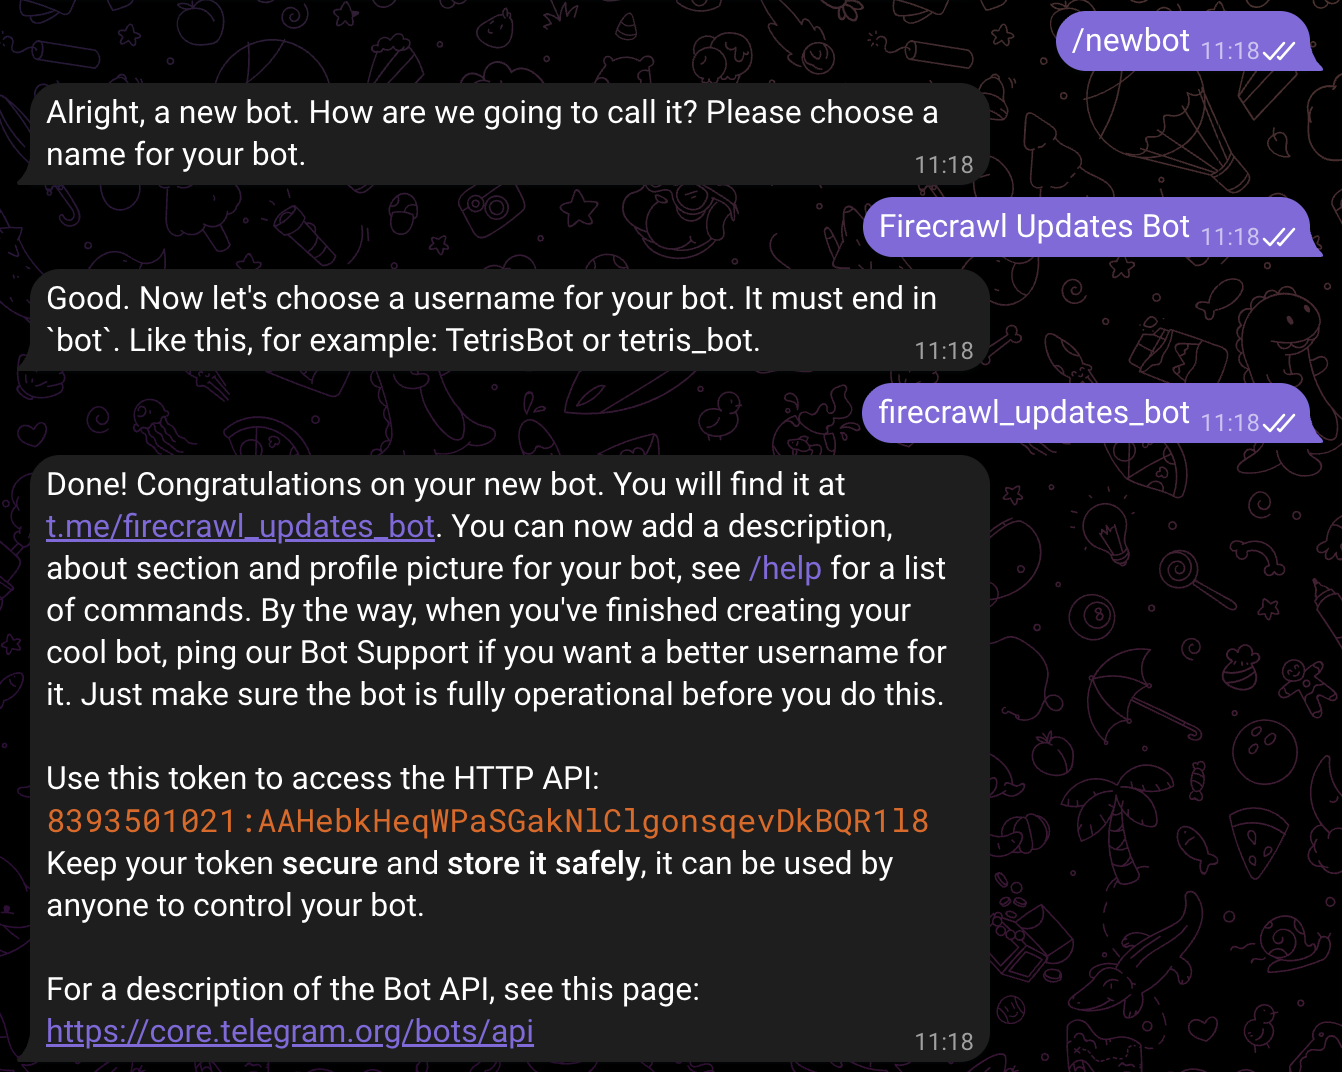
Guarda el token de tu bot de forma segura. Es como una contraseña que permite a n8n enviar mensajes como tu bot. Nunca lo compartas públicamente.
Obtén tu ID de chat
Para enviarte mensajes, necesitas el ID de chat de Telegram:- Abre el navegador web y visita esta URL (sustituye
YOUR_BOT_TOKENpor el token de tu bot): - Mantén abierta esta pestaña del navegador
- Busca el nombre de usuario de tu bot en Telegram (el que acabas de crear)
- Inicia una conversación con tu bot haciendo clic en “Iniciar”
- Envía cualquier mensaje a tu bot (por ejemplo, “hola”)
- Vuelve a la pestaña del navegador y actualiza la página
- Busca el campo
"chat":{"id":en la respuesta JSON - El número junto a
"id":es tu ID de chat (por ejemplo,123456789) - Guarda este ID de chat para usarlo más adelante
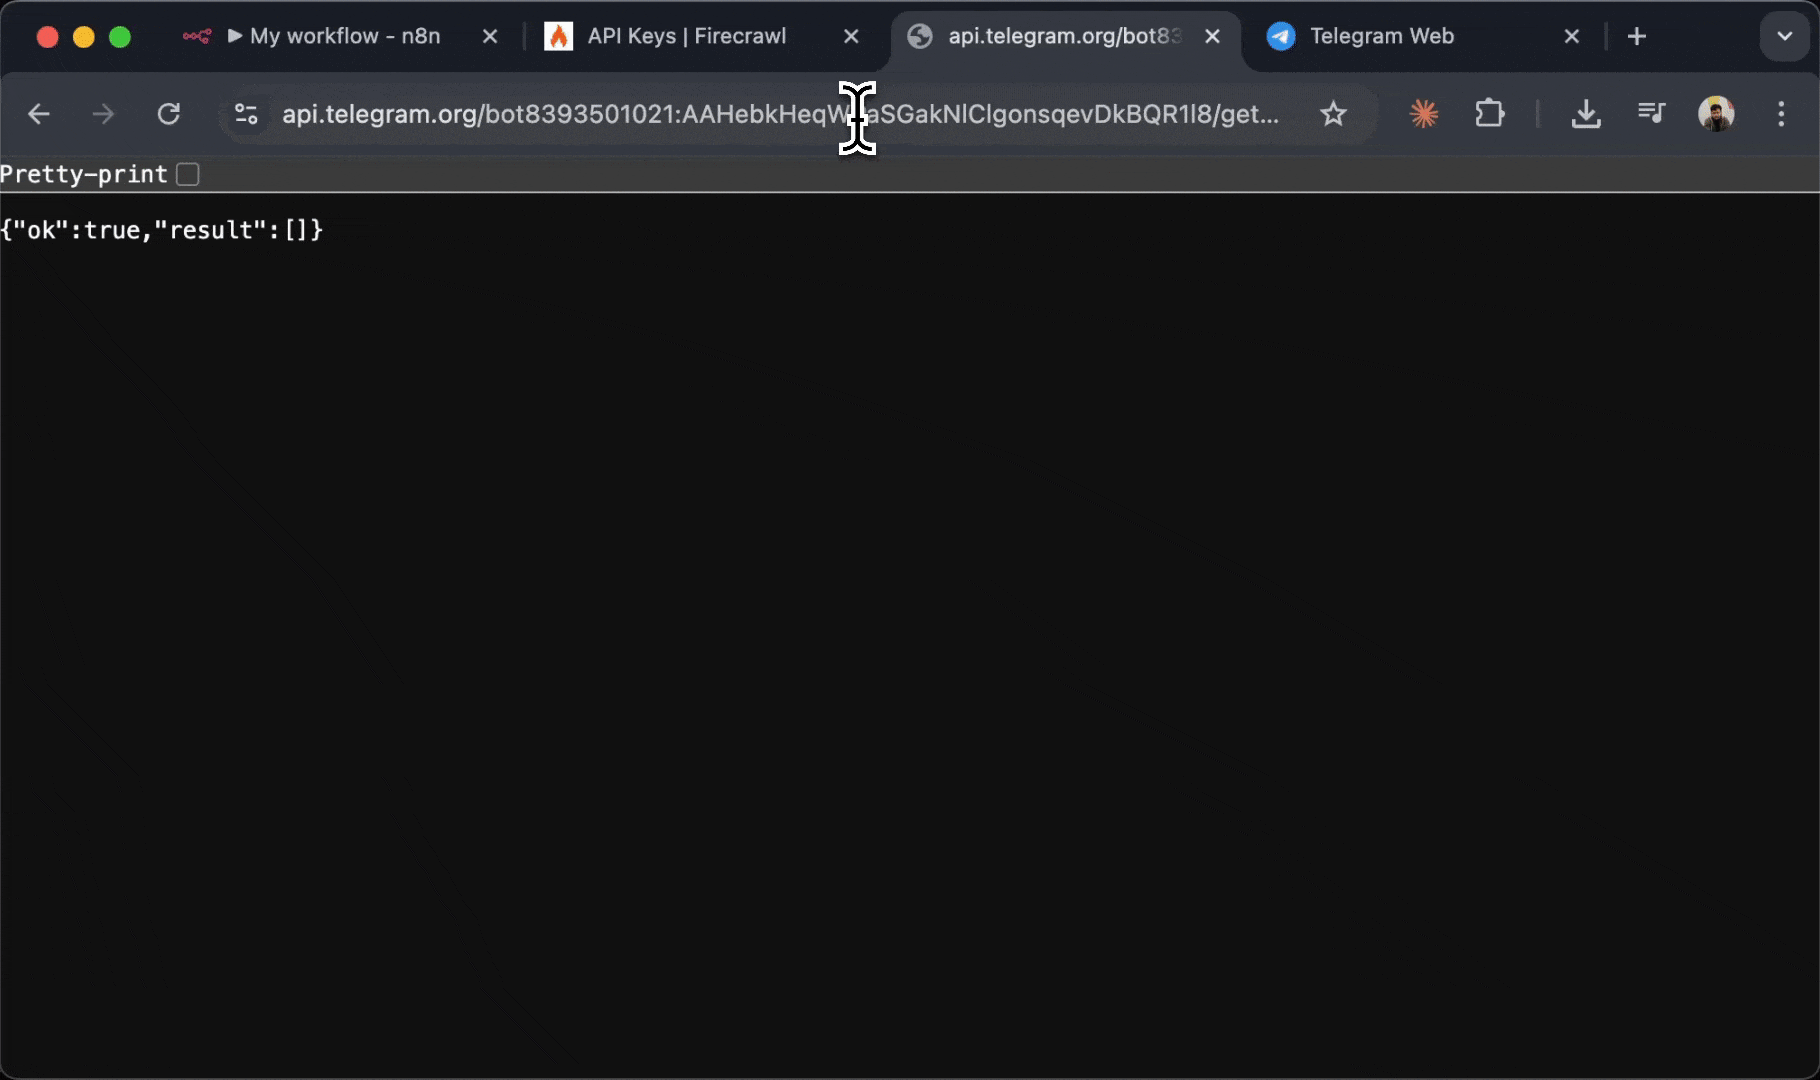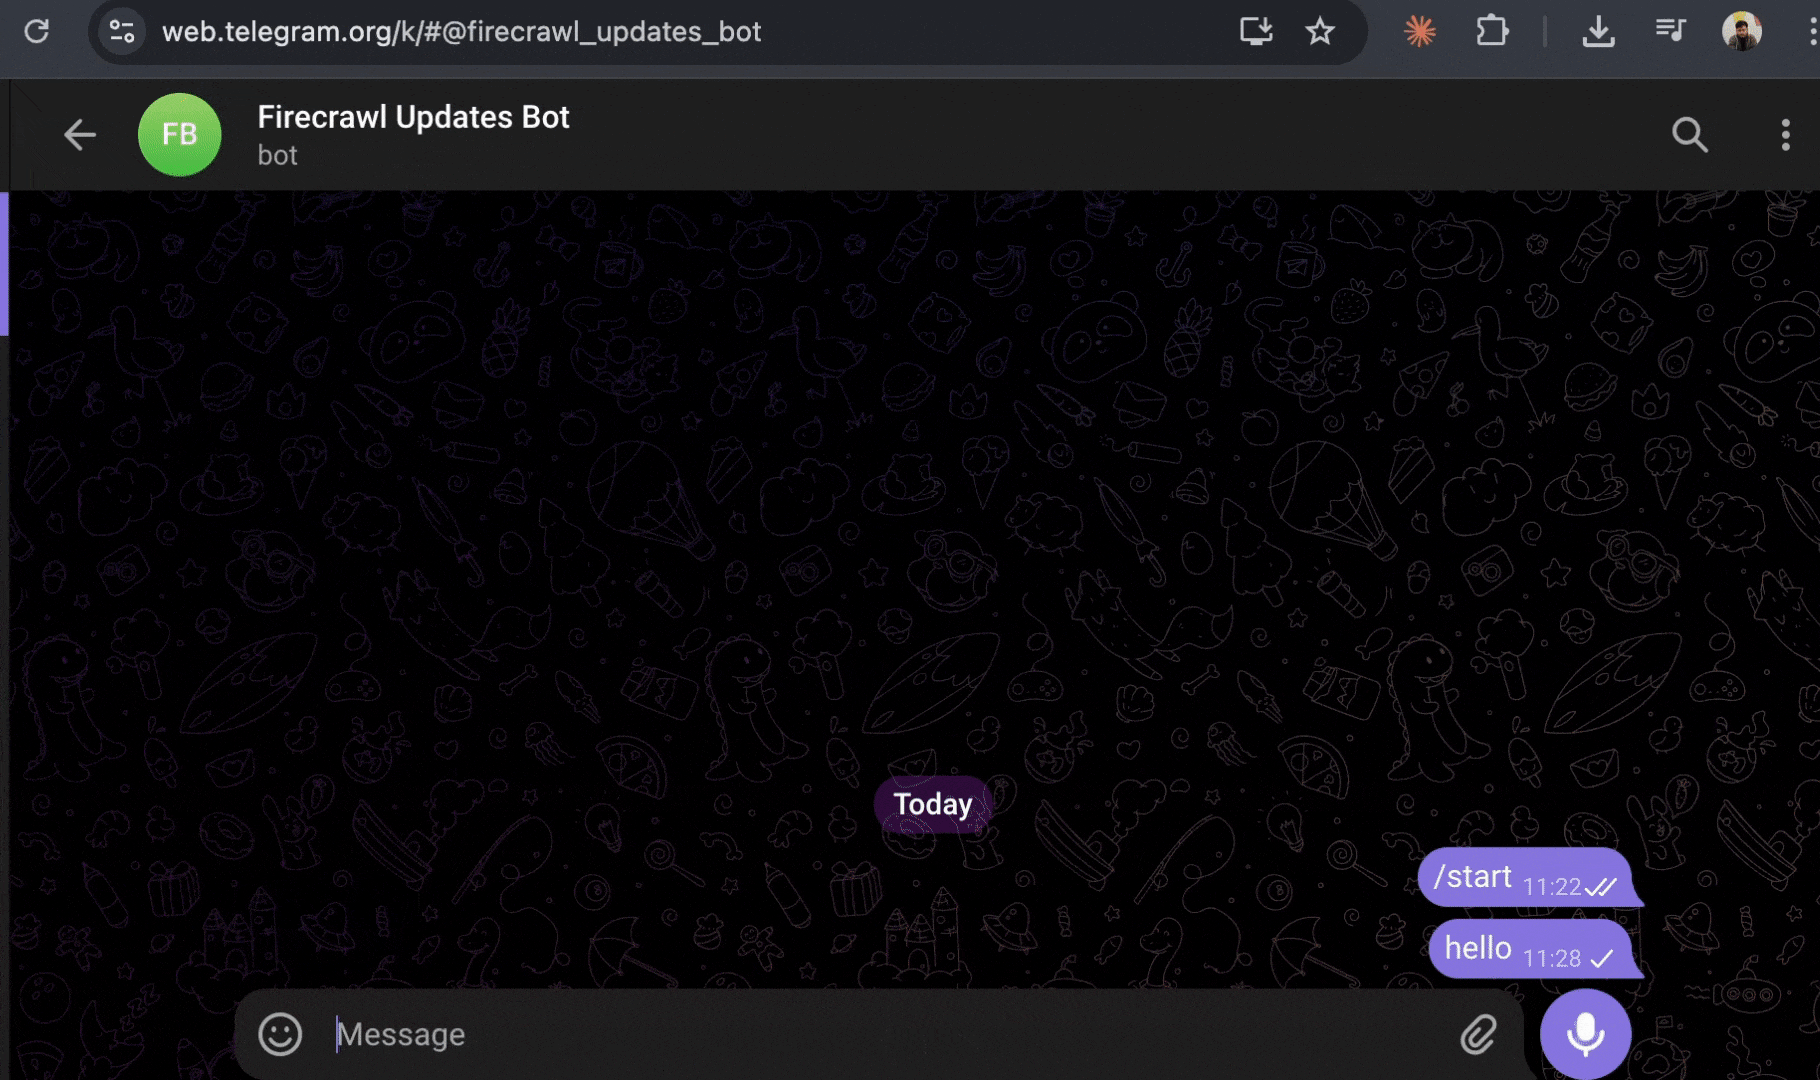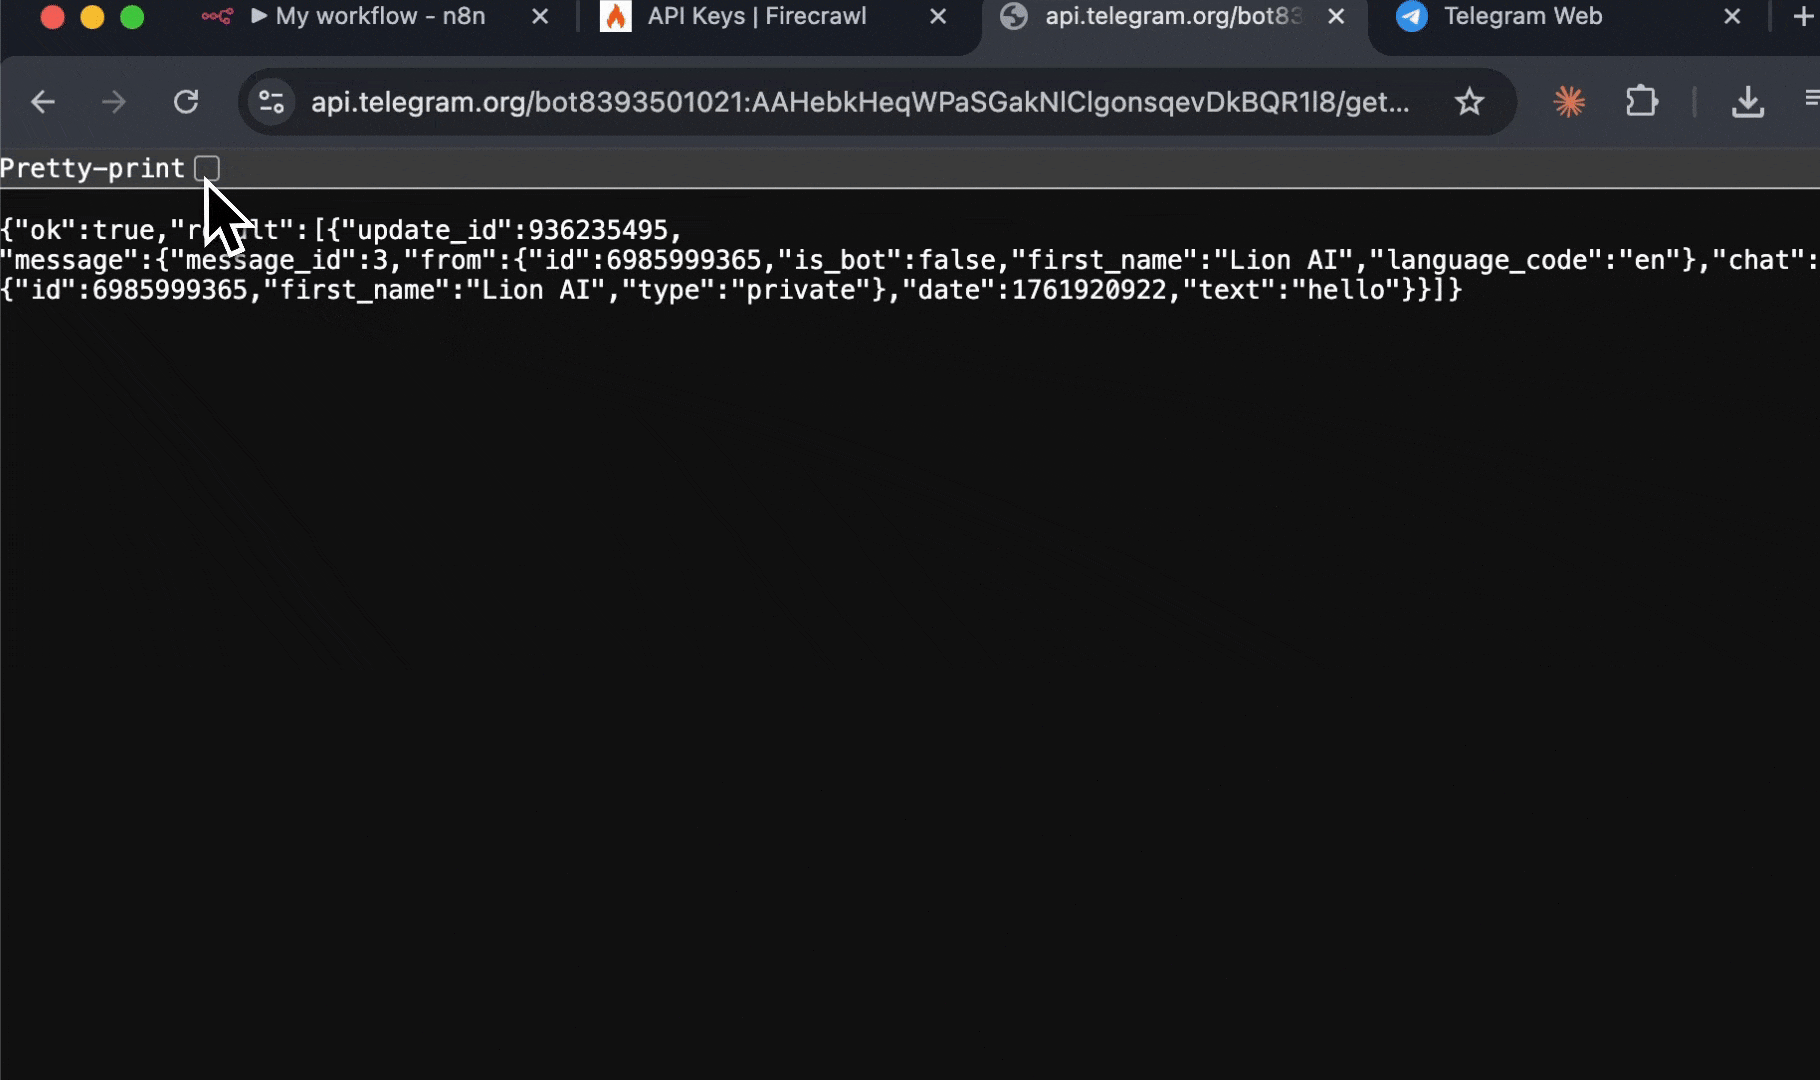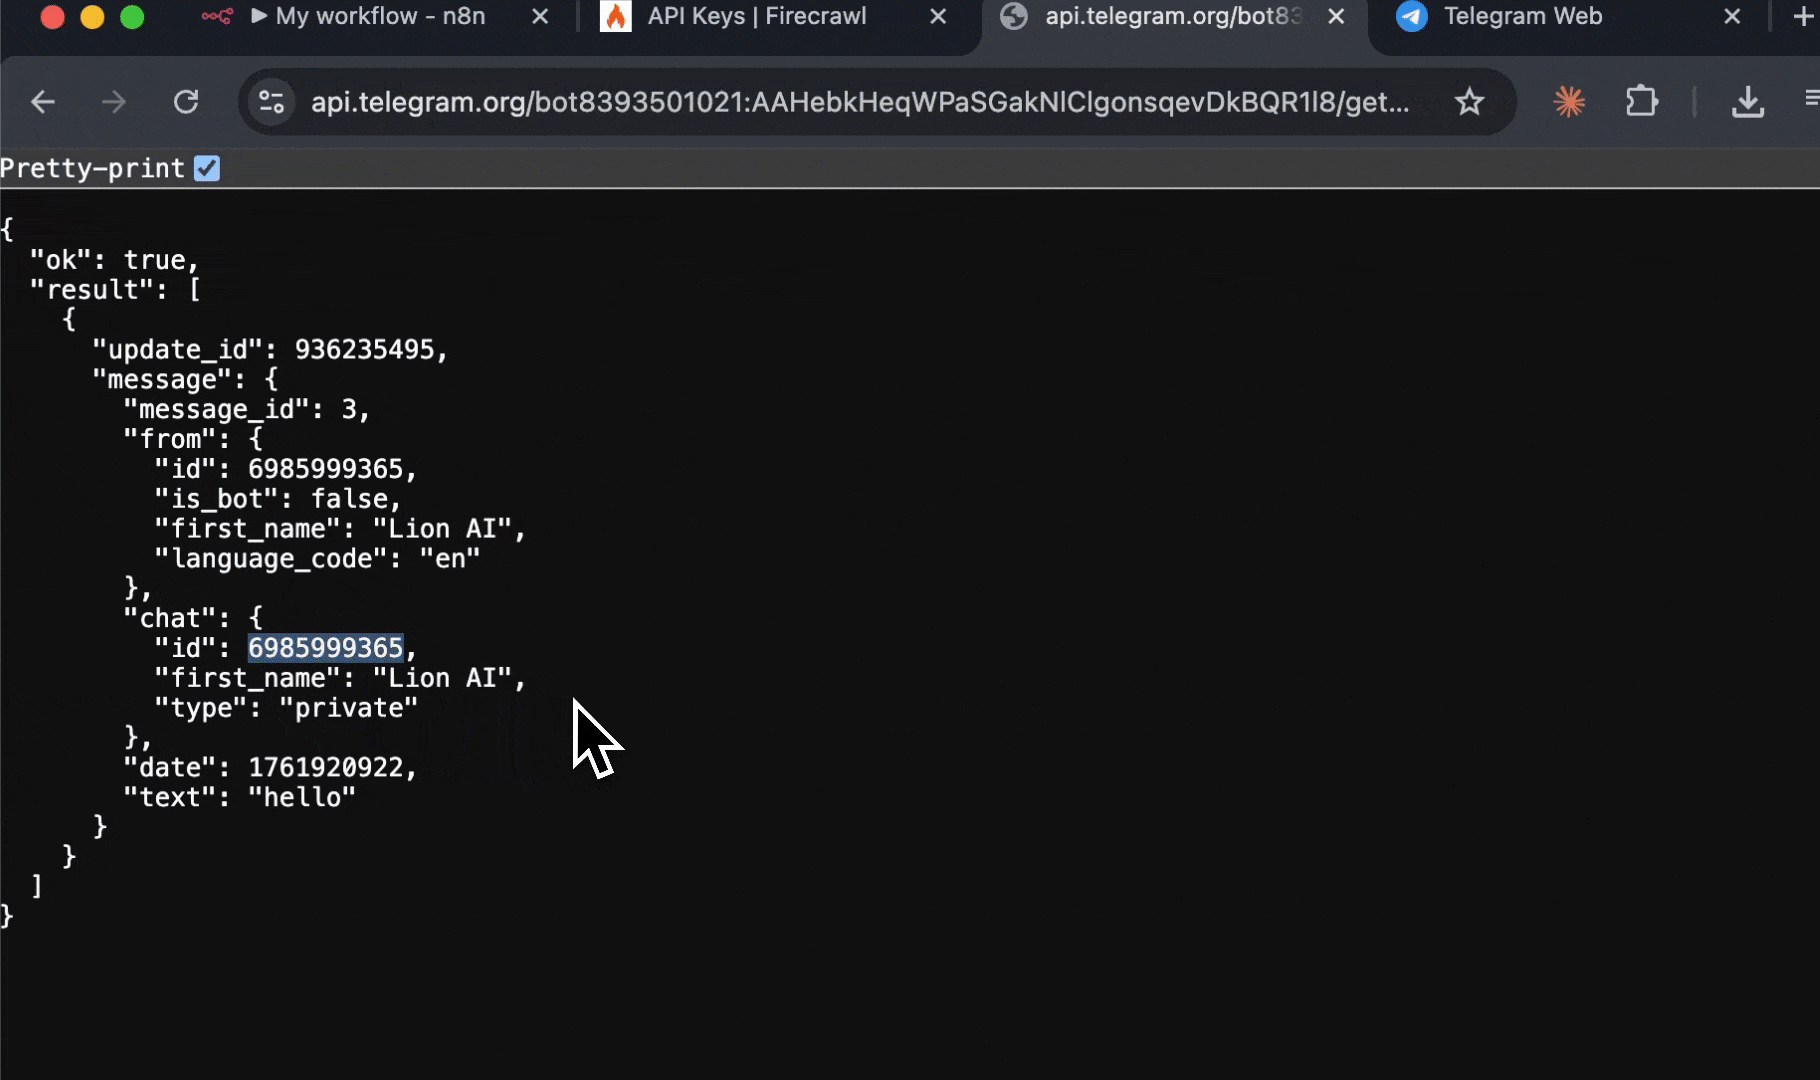
Tu ID de chat es el identificador único de tu conversación con el bot. Lo usarás para indicar a n8n dónde enviar los mensajes.
Paso 5: Crea flujos de trabajo prácticos con Telegram
Ahora vamos a crear tres flujos de trabajo reales que envían información directamente a Telegram. Estos ejemplos muestran distintas operaciones de Firecrawl y cómo integrarlas con las notificaciones de Telegram.Ejemplo 1: Resumen diario de actualizaciones de producto de Firecrawl
Recibe cada mañana en Telegram un resumen diario de las actualizaciones de producto de Firecrawl. Lo que crearás:- Hace scraping del blog de actualizaciones de producto de Firecrawl todos los días a las 9:00
- Usa IA para generar un resumen del contenido
- Envía el resumen a Telegram
- Crea un nuevo flujo de trabajo en n8n
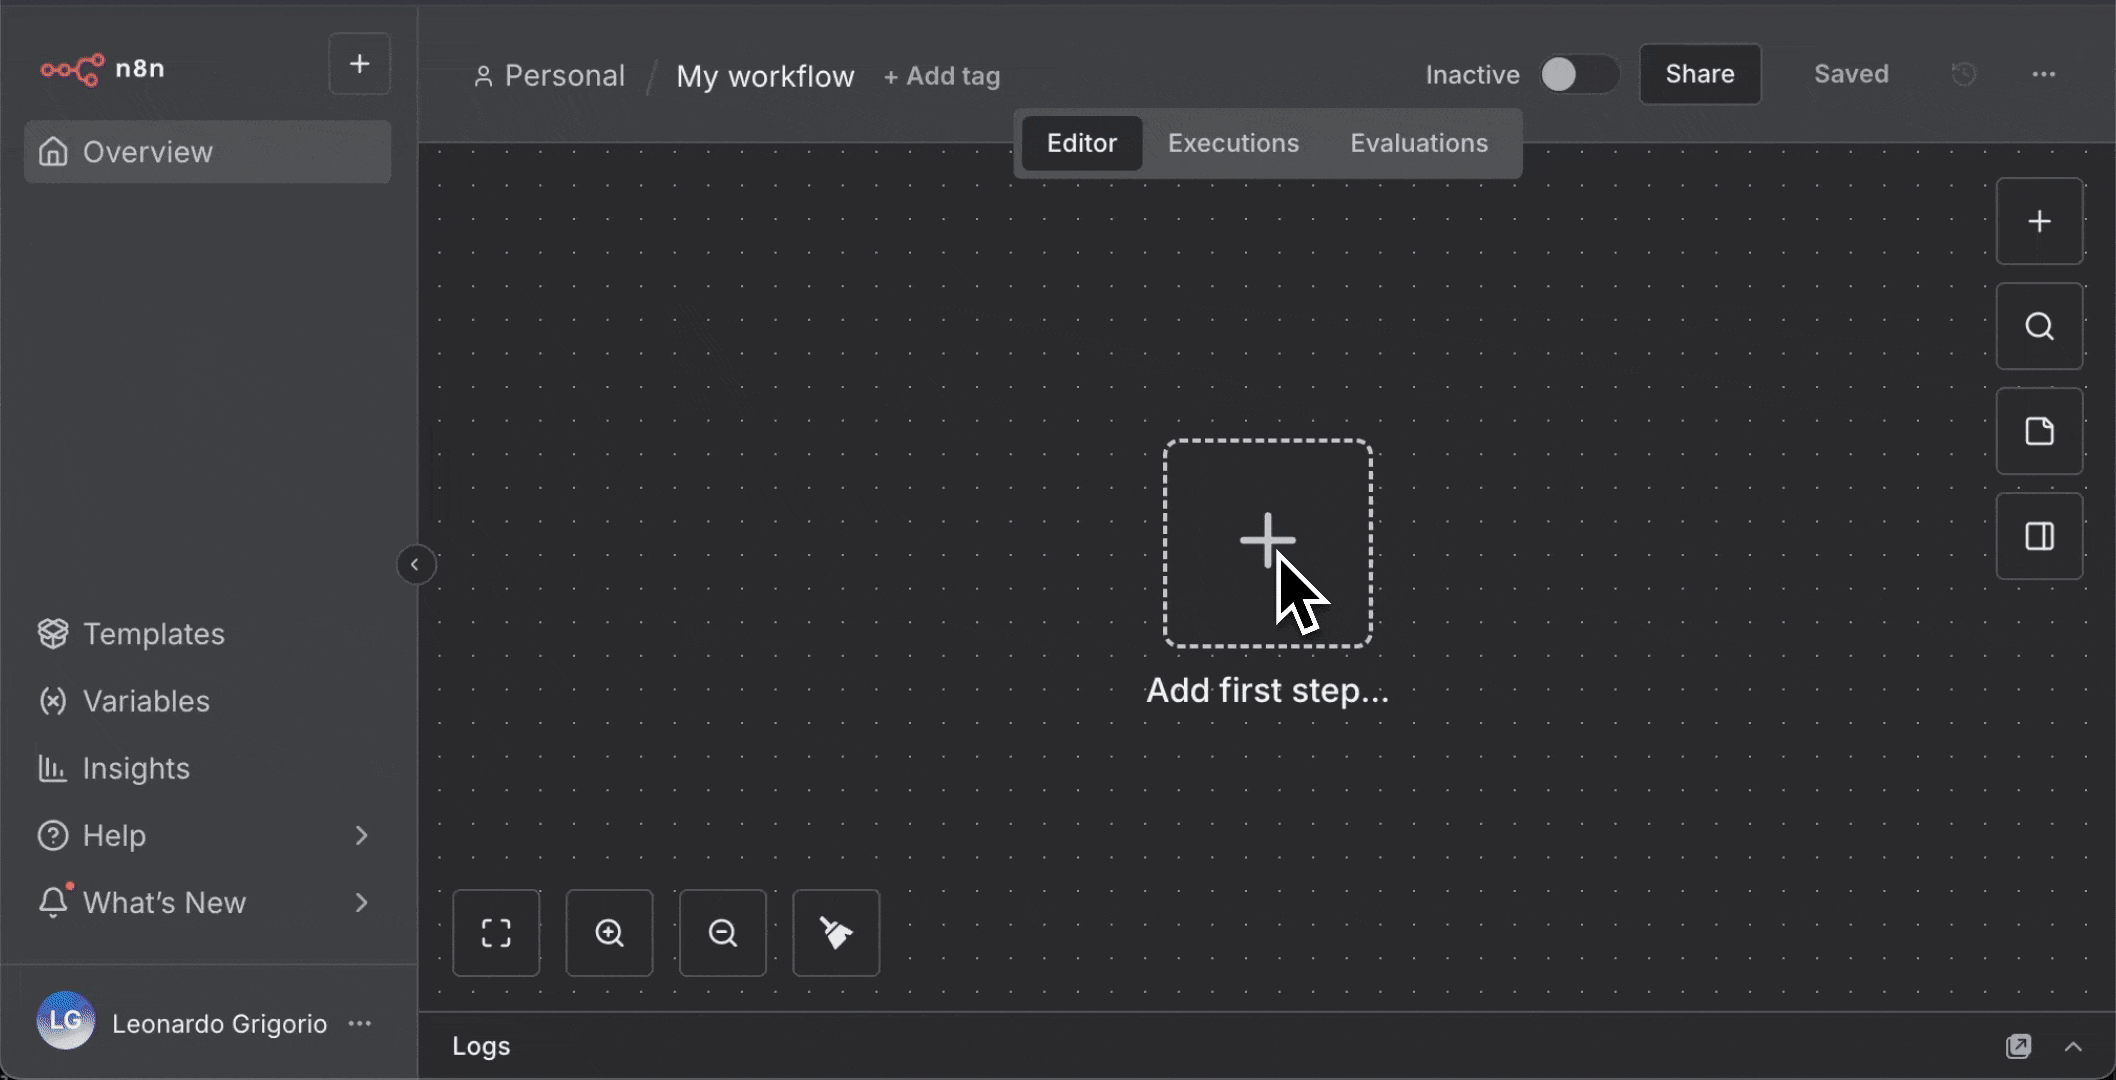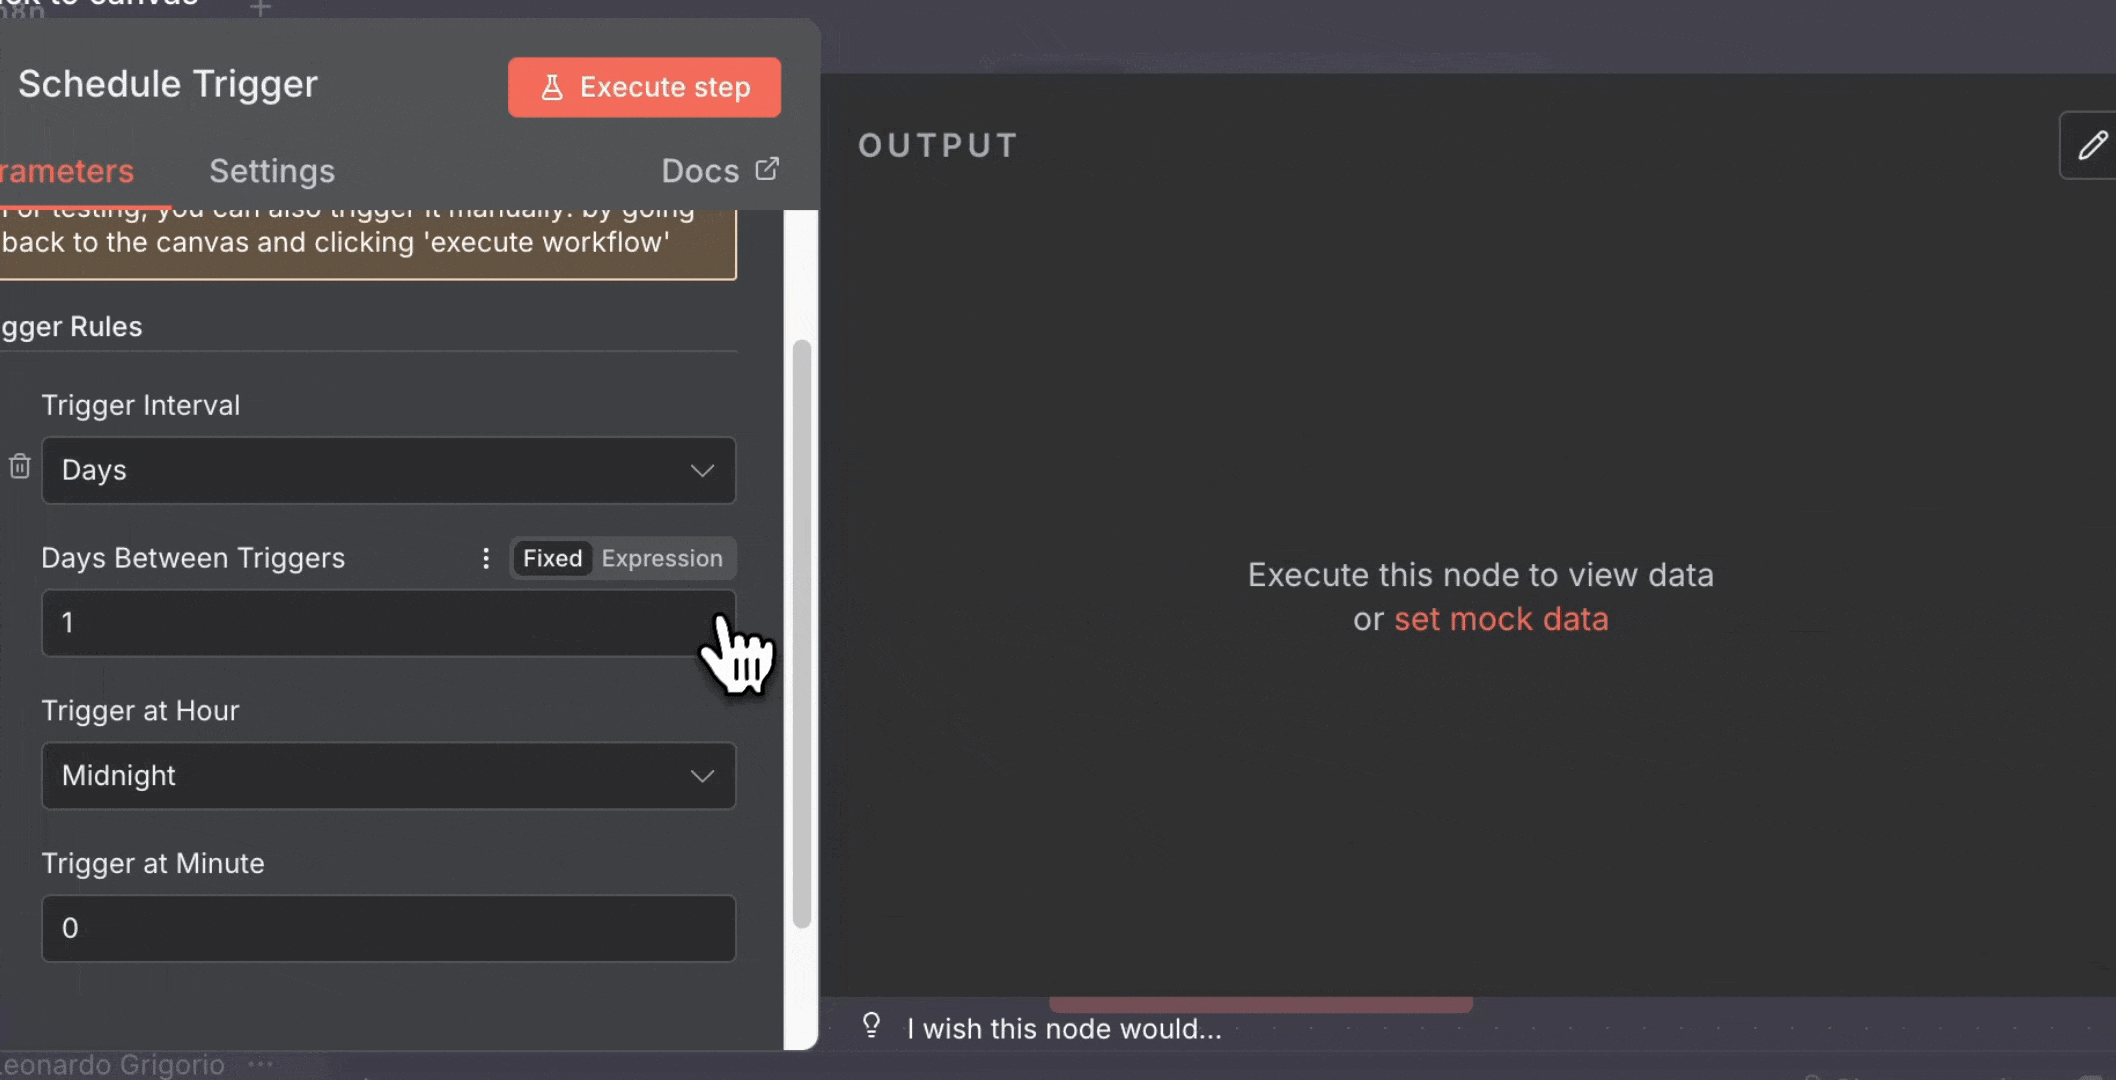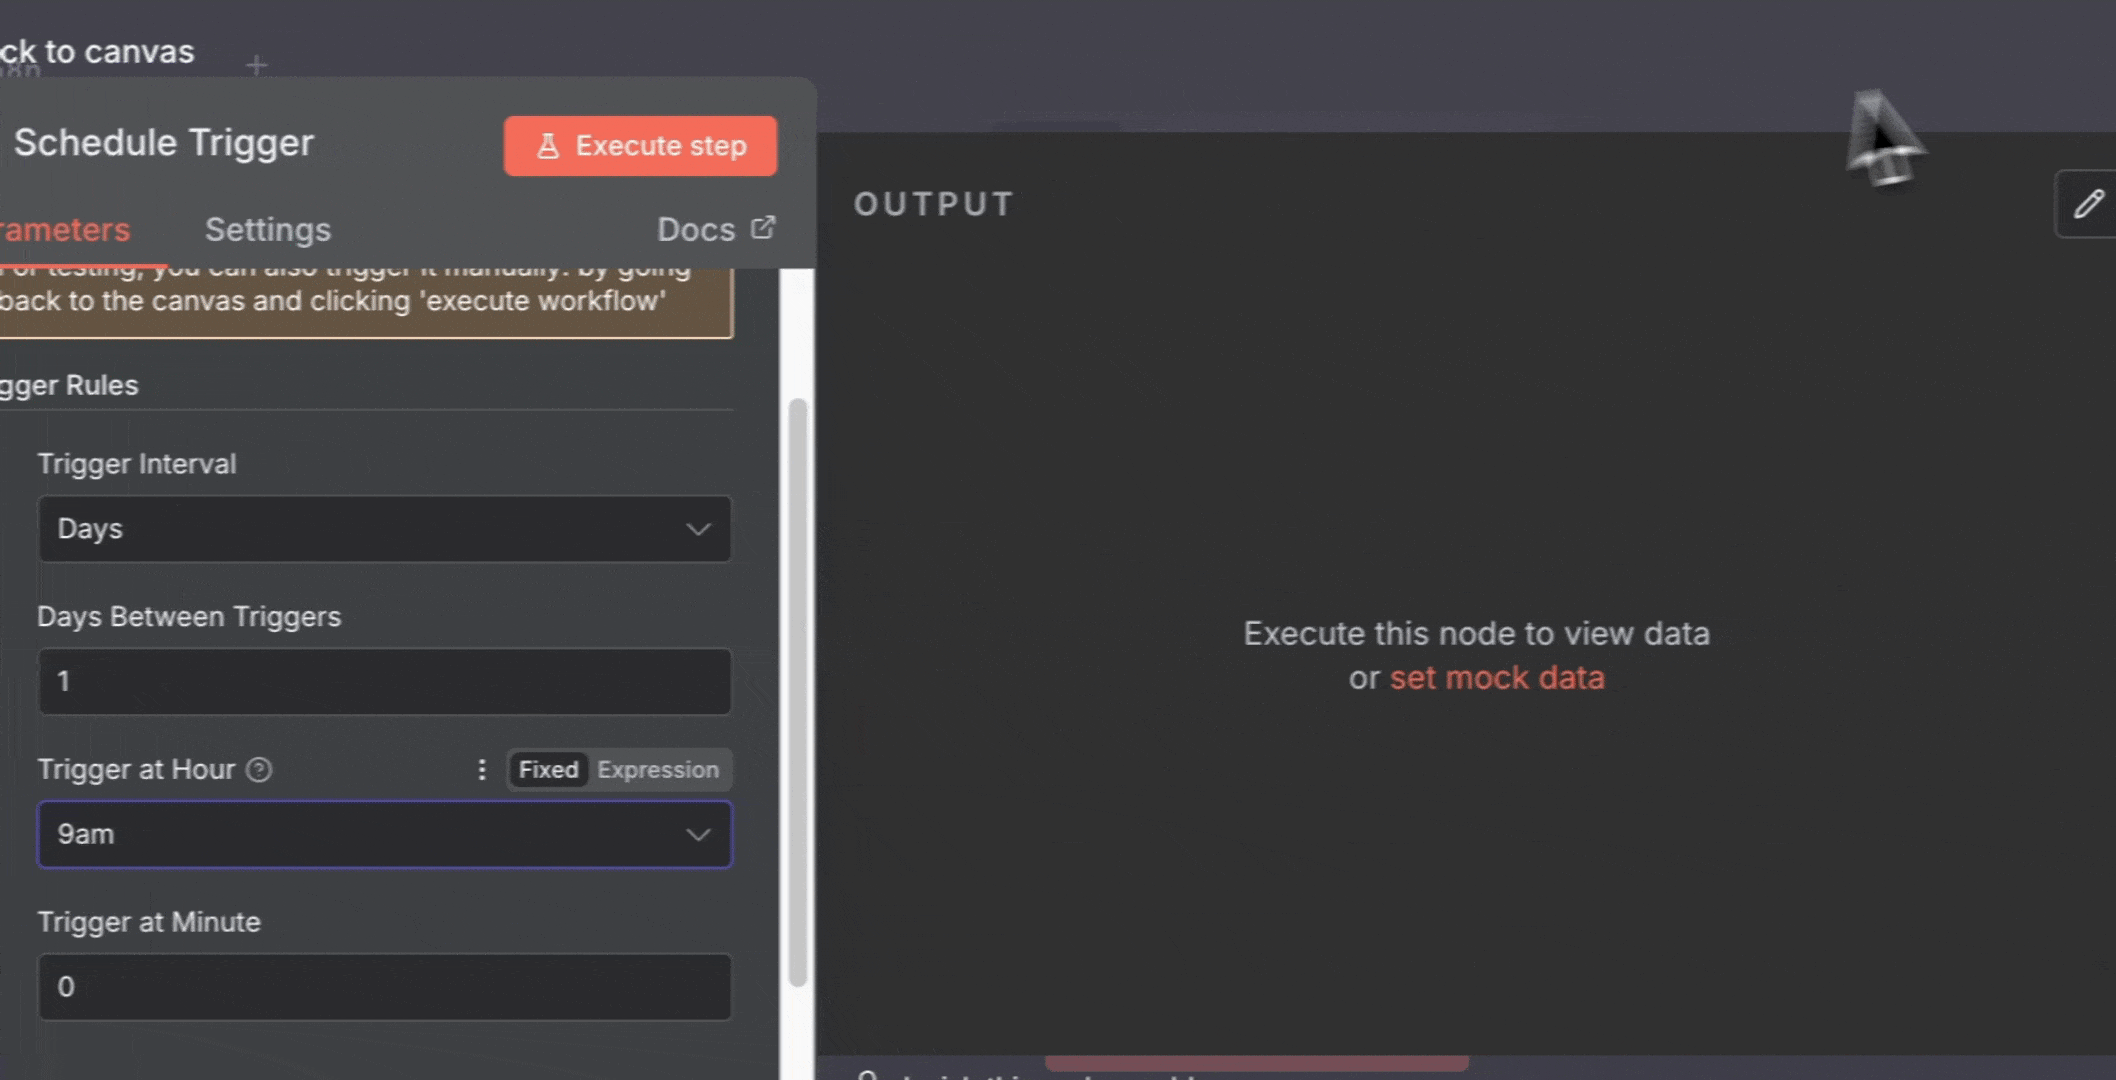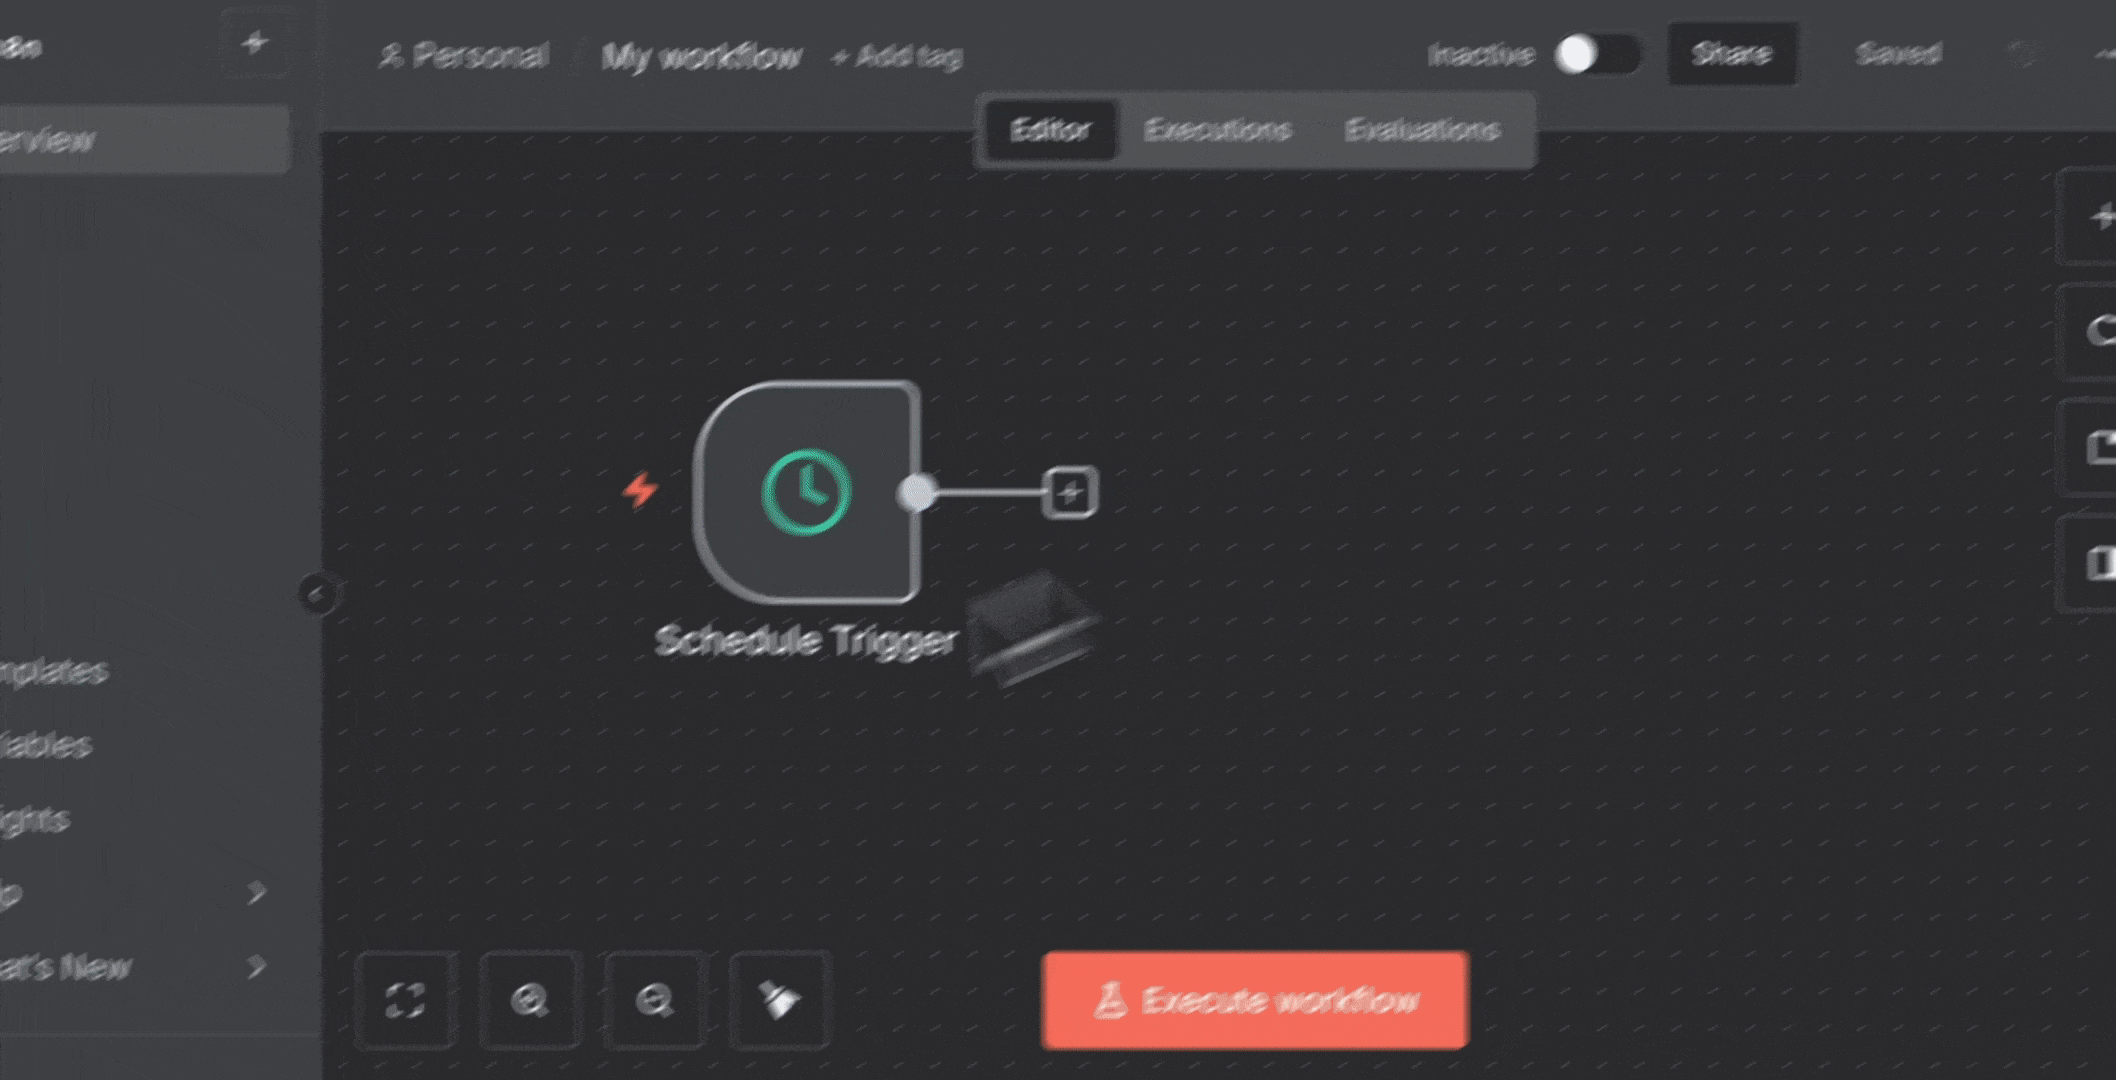
- Añade un nodo Schedule Trigger:
- Haz clic en el botón ”+” del lienzo
- Busca “Schedule Trigger”
- Configúralo para que se ejecute todos los días a las 9:00
- Añade el nodo Firecrawl:
- Haz clic en ”+” junto a Schedule Trigger
- Busca y añade “Firecrawl”
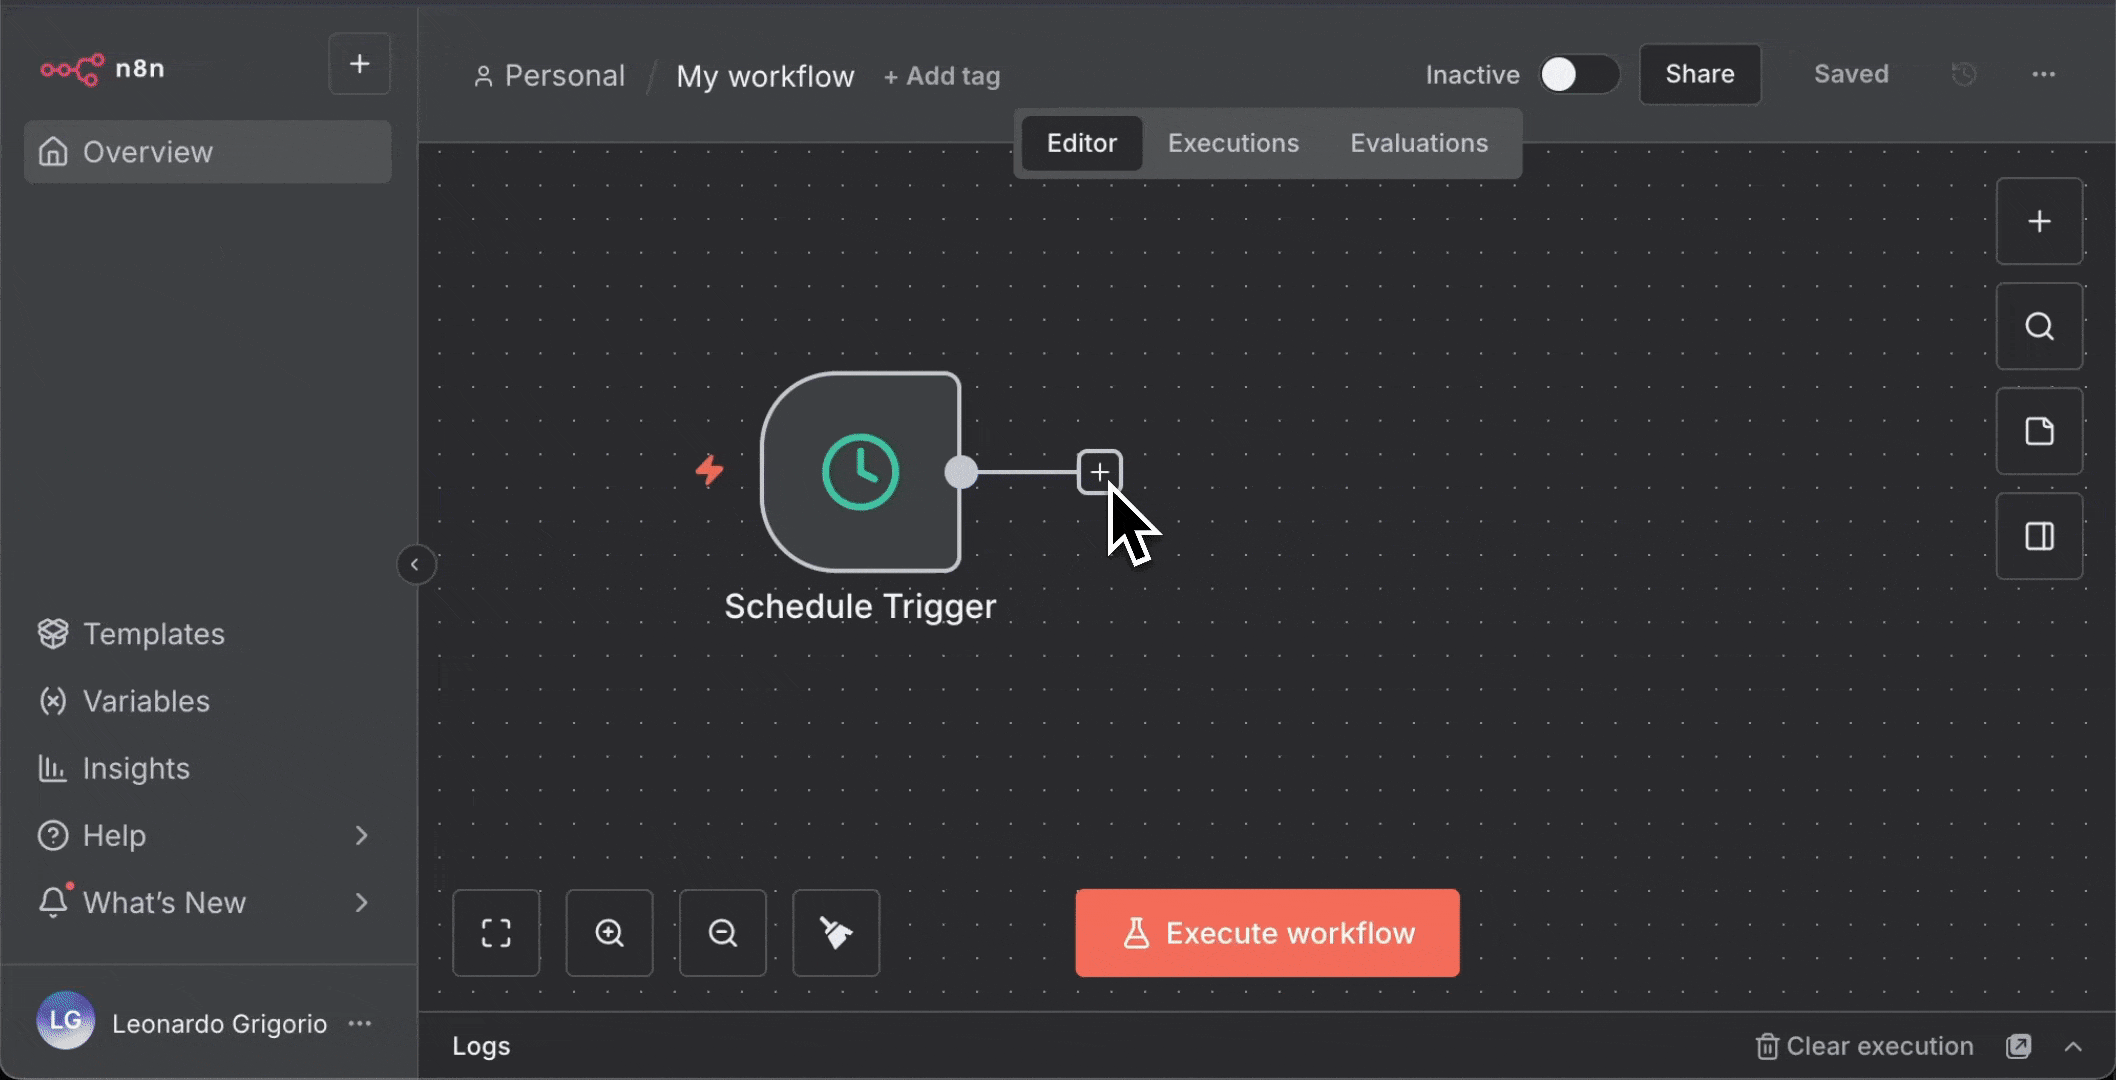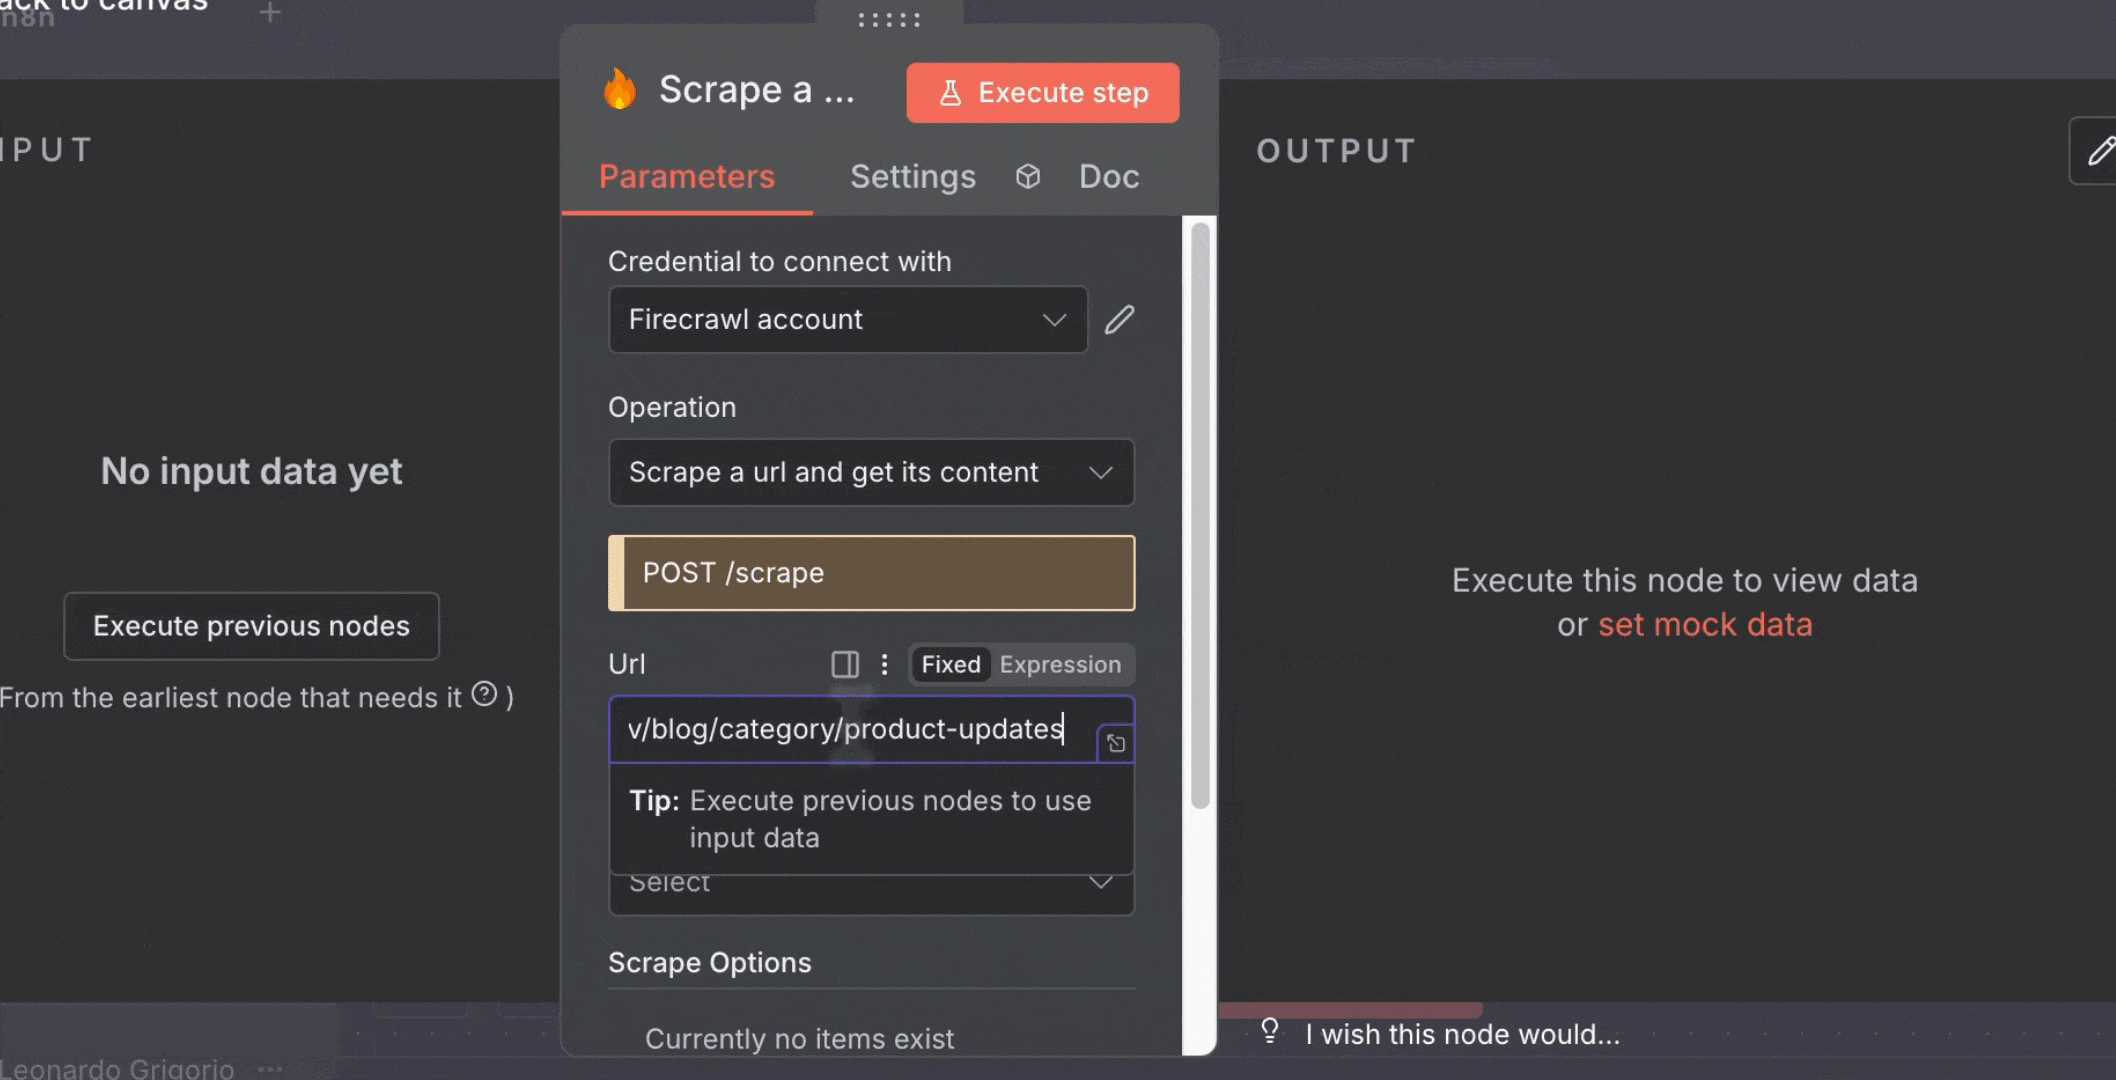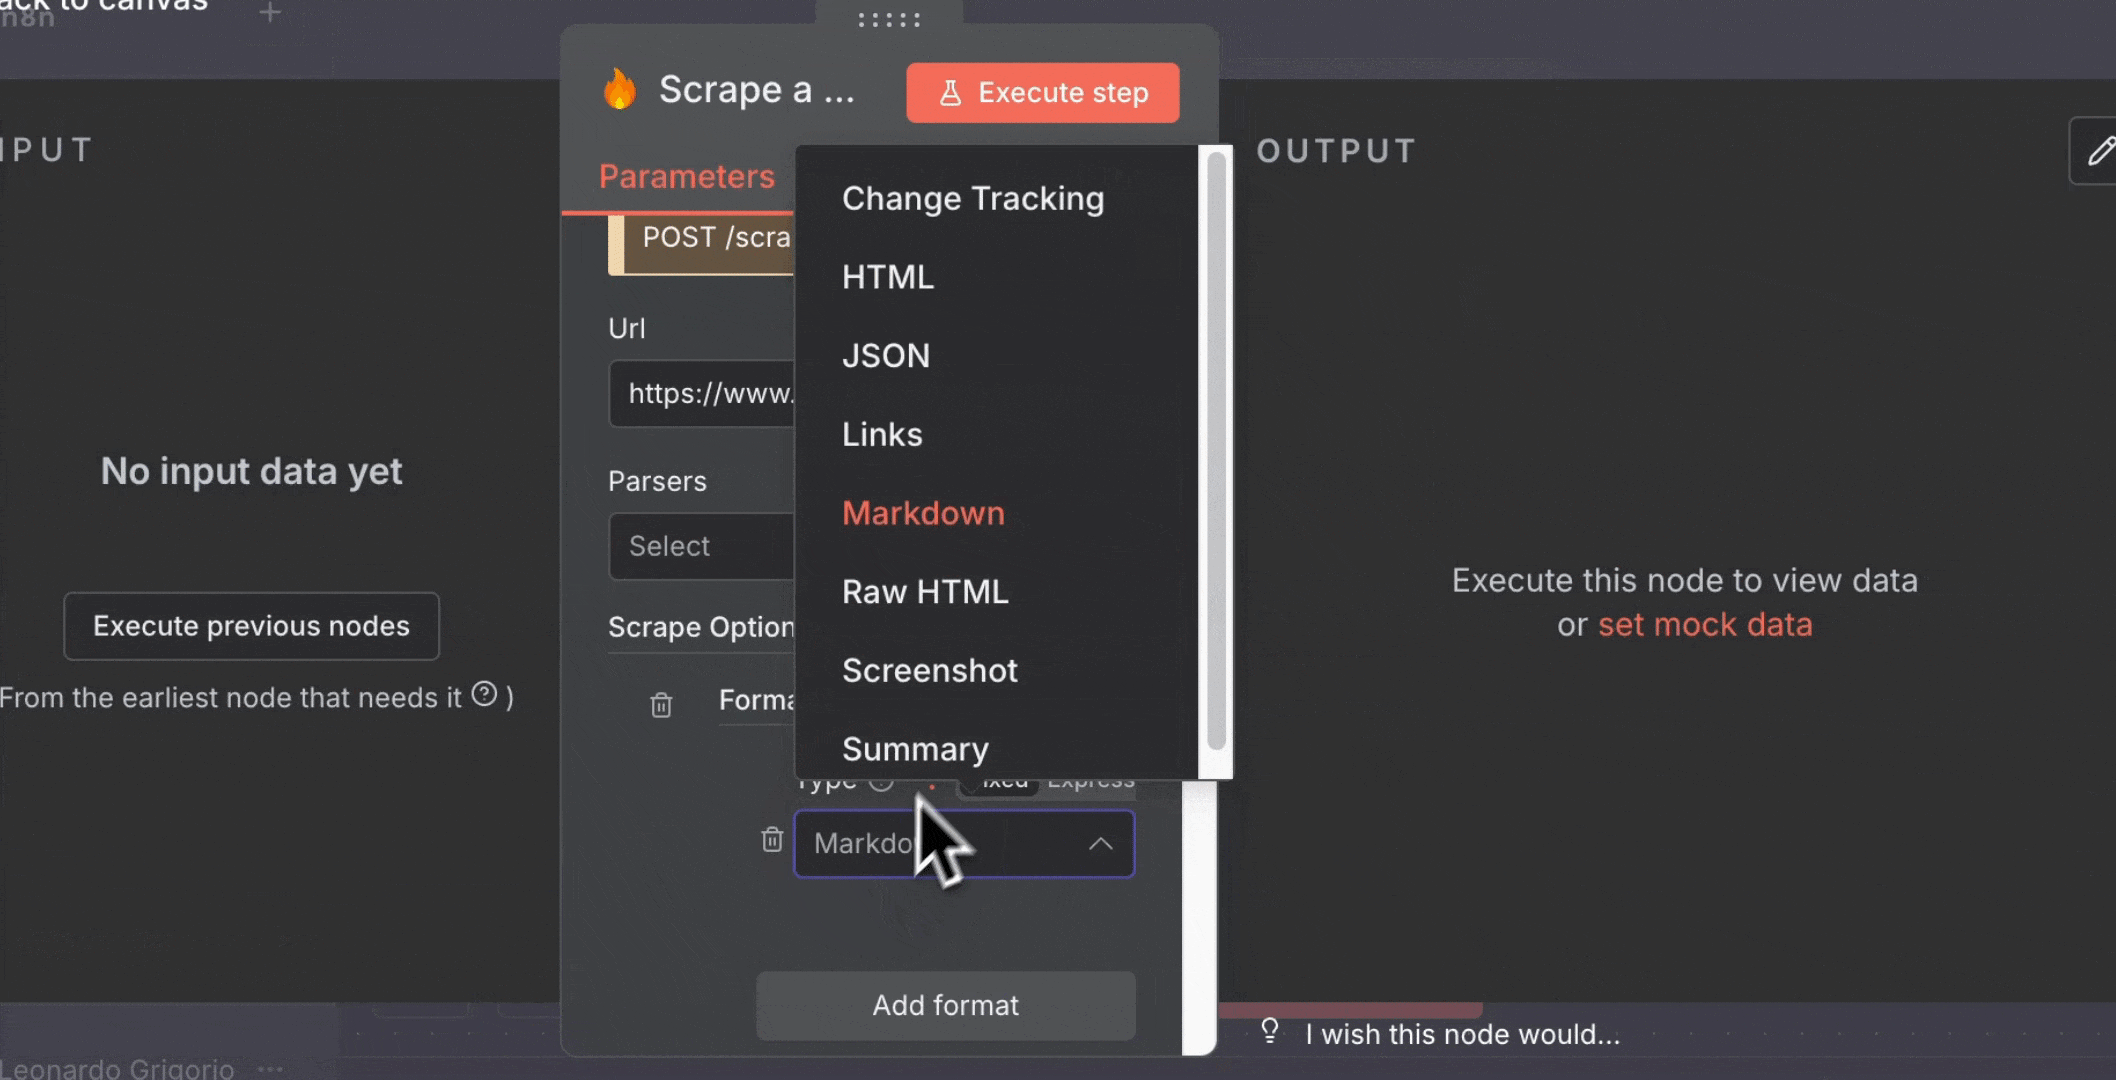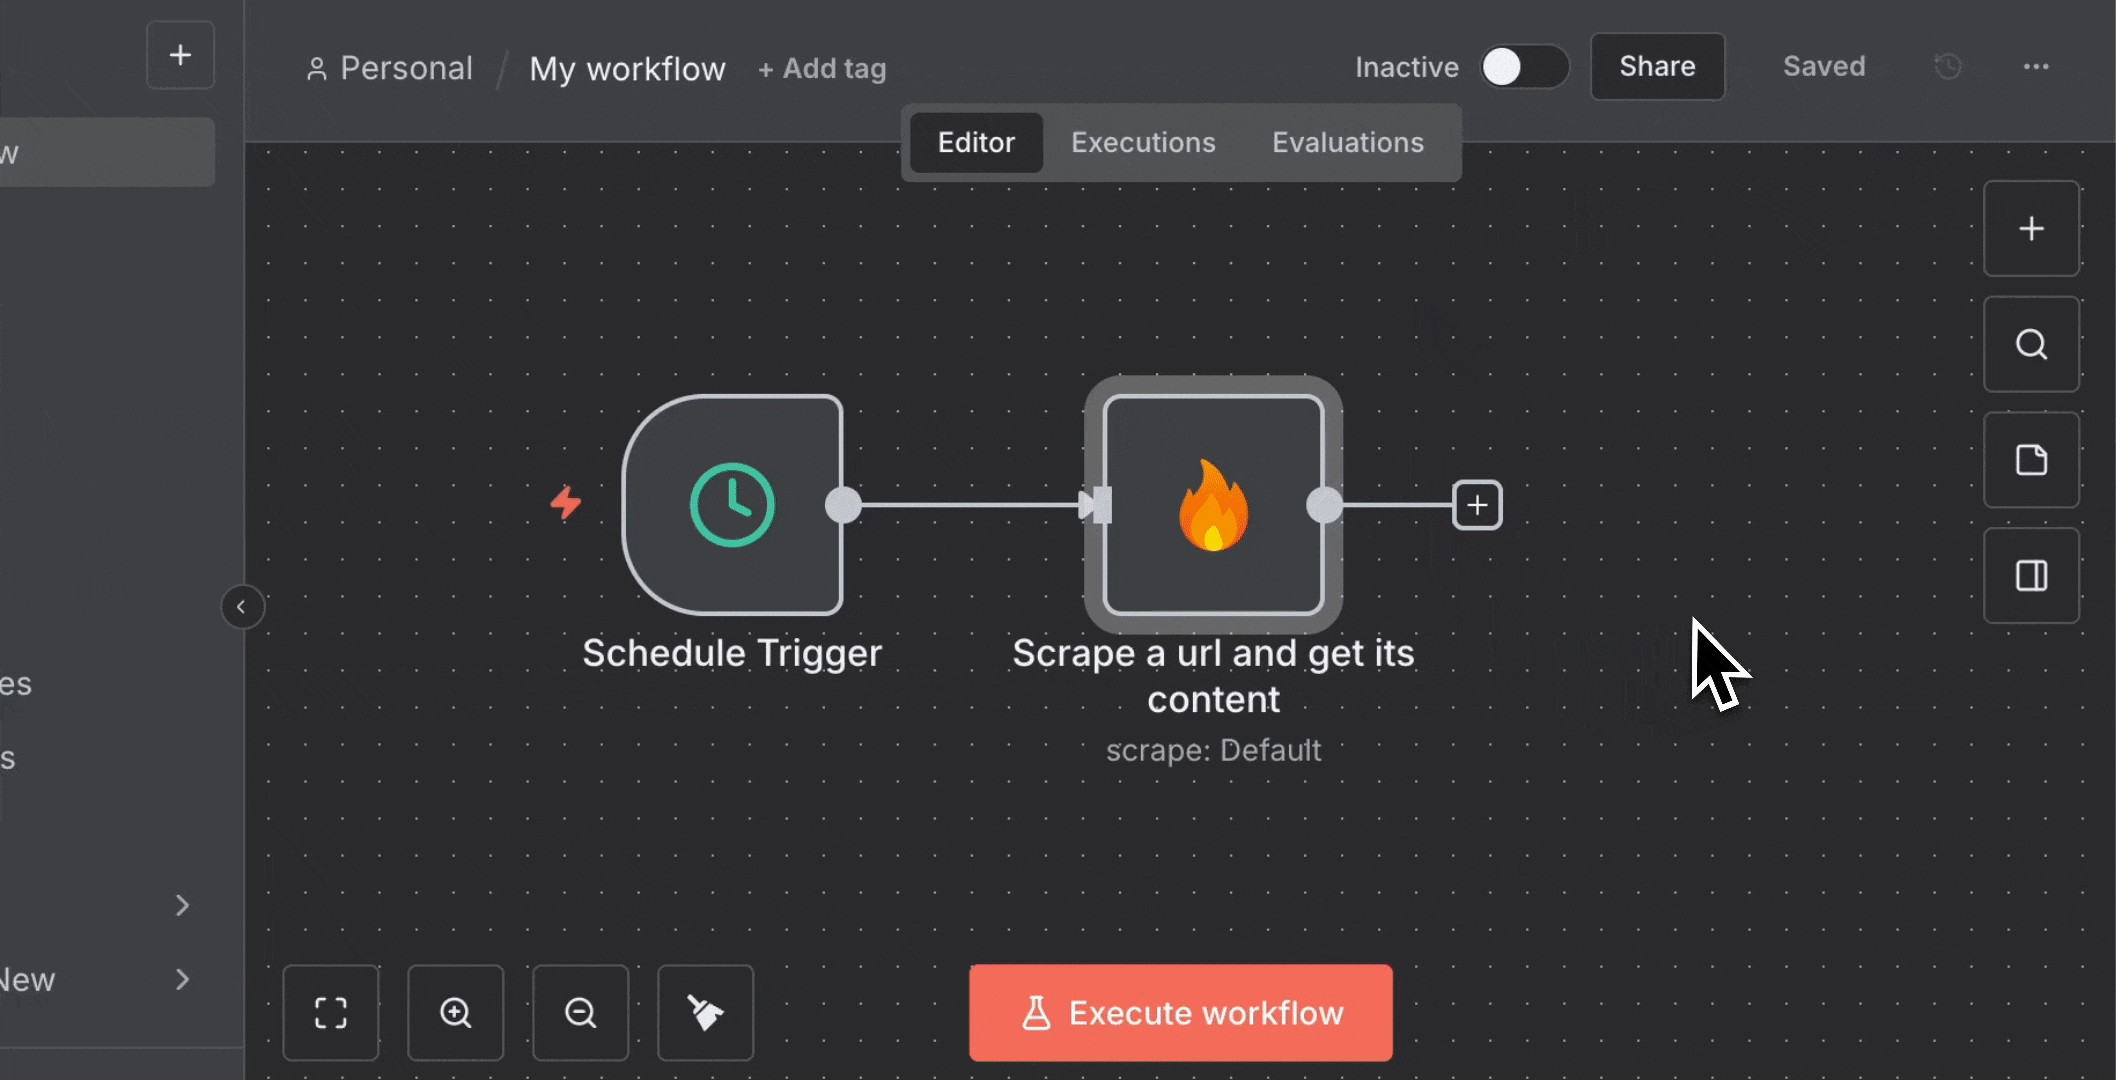
- Selecciona tu credencial de Firecrawl
- Configura:
- Recurso: Extracción de datos
- Operación: Extraer contenido de una URL
- URL:
https://www.firecrawl.dev/blog/category/product-updates - Opciones de extracción: Añade Formats y selecciona “Resumen”
-
Añade el nodo Telegram:
- Haz clic en ”+” junto a Firecrawl
- Busca “Telegram”
- Haz clic en “Send a text message” para añadirlo al lienzo
-
Configura las credenciales de Telegram:
- Haz clic en el nodo Telegram para abrir su configuración
- En el menú desplegable “Credencial para conectarse”, haz clic en “Crear nueva credencial”
- Pega el token de tu bot de BotFather
- Haz clic en “Guardar”

- Configura el mensaje de Telegram:
- Operación: Enviar mensaje
- ID de chat: Introduce tu ID de chat
- Texto: Por ahora, deja el mensaje “hello”
- Haz clic en Ejecutar paso para probar el envío de un mensaje y recibir el resumen de Firecrawl.

- Ahora que tienes la estructura del resumen de Firecrawl, añade el resumen al texto del mensaje arrastrando el campo
summary(dentro dedata) desde la salida del nodo Firecrawl.
- Prueba el flujo de trabajo:
- Haz clic en “ejecutar flujo de trabajo”
- Revisa Telegram para ver el mensaje con el resumen
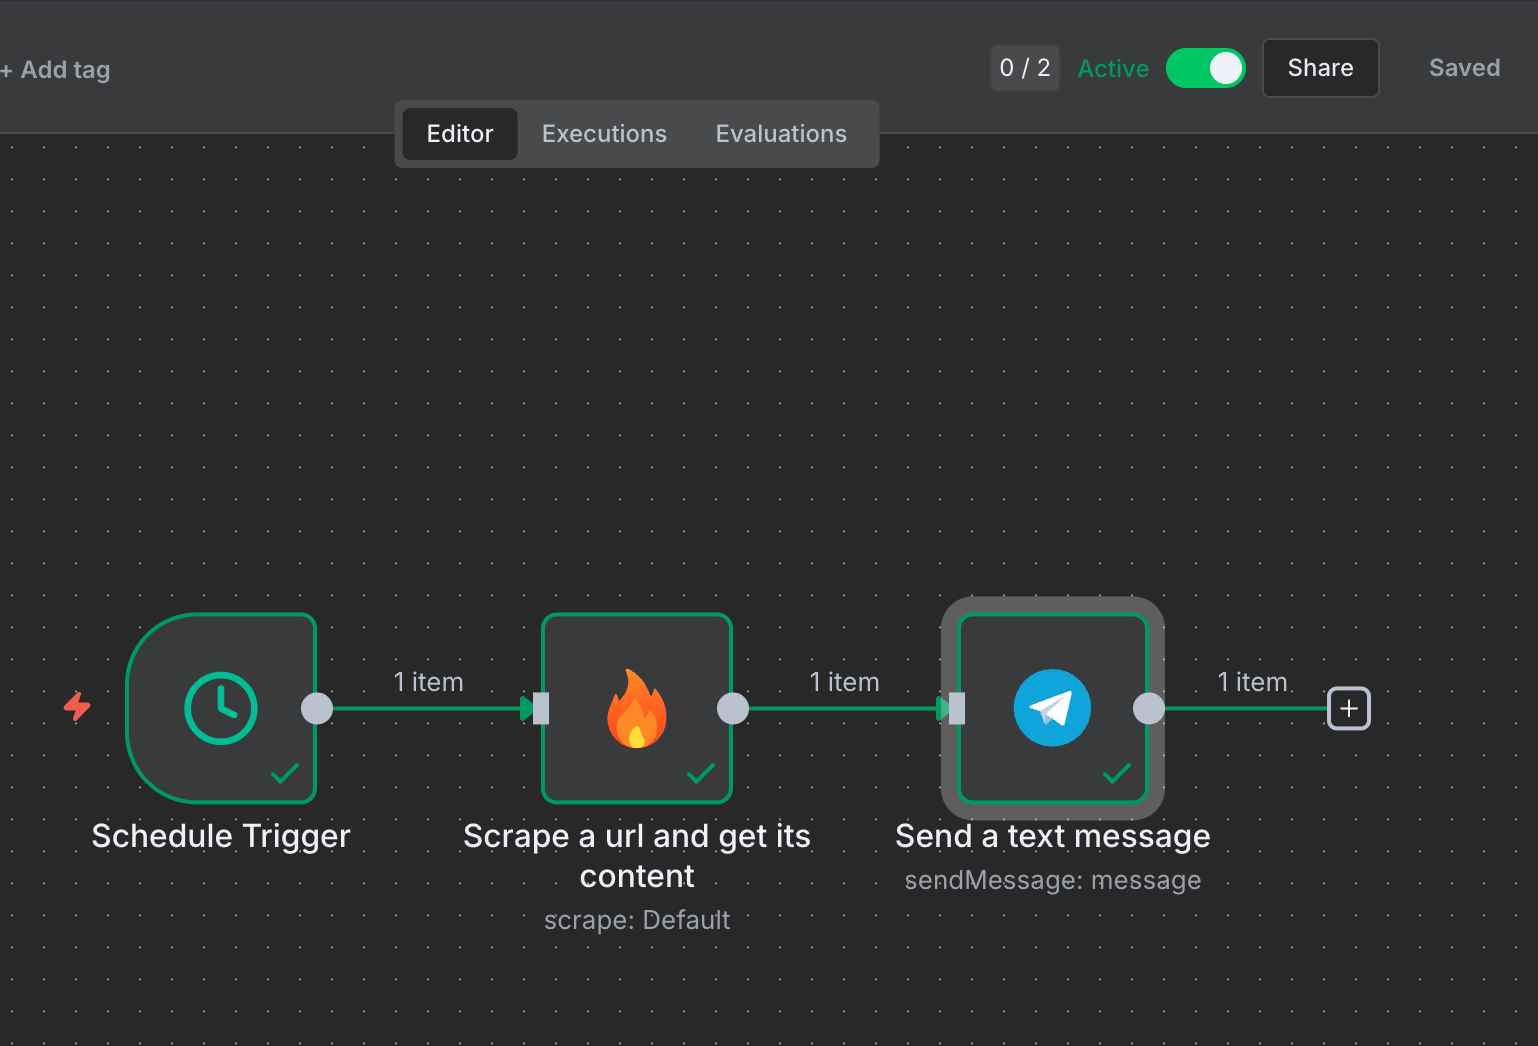
- Activa el flujo de trabajo con el interruptor “Active”
Ejemplo 2: Búsqueda de noticias de IA en Telegram
Este flujo de trabajo usa la operación Search de Firecrawl para buscar noticias de IA y enviar los resultados formateados a Telegram. Diferencias clave con respecto al ejemplo 1:- Usa un Manual Trigger en lugar de Schedule (se ejecuta bajo demanda)
- Usa la operación Search en lugar de scraping
- Incluye un nodo Code para formatear varios resultados
- Crea un nuevo flujo de trabajo y añade un nodo Manual Trigger
-
Añade un nodo Firecrawl con esta configuración:
- Resource: Map & Search
- Operation: Search Web
- Query:
ai news - Limit: 5
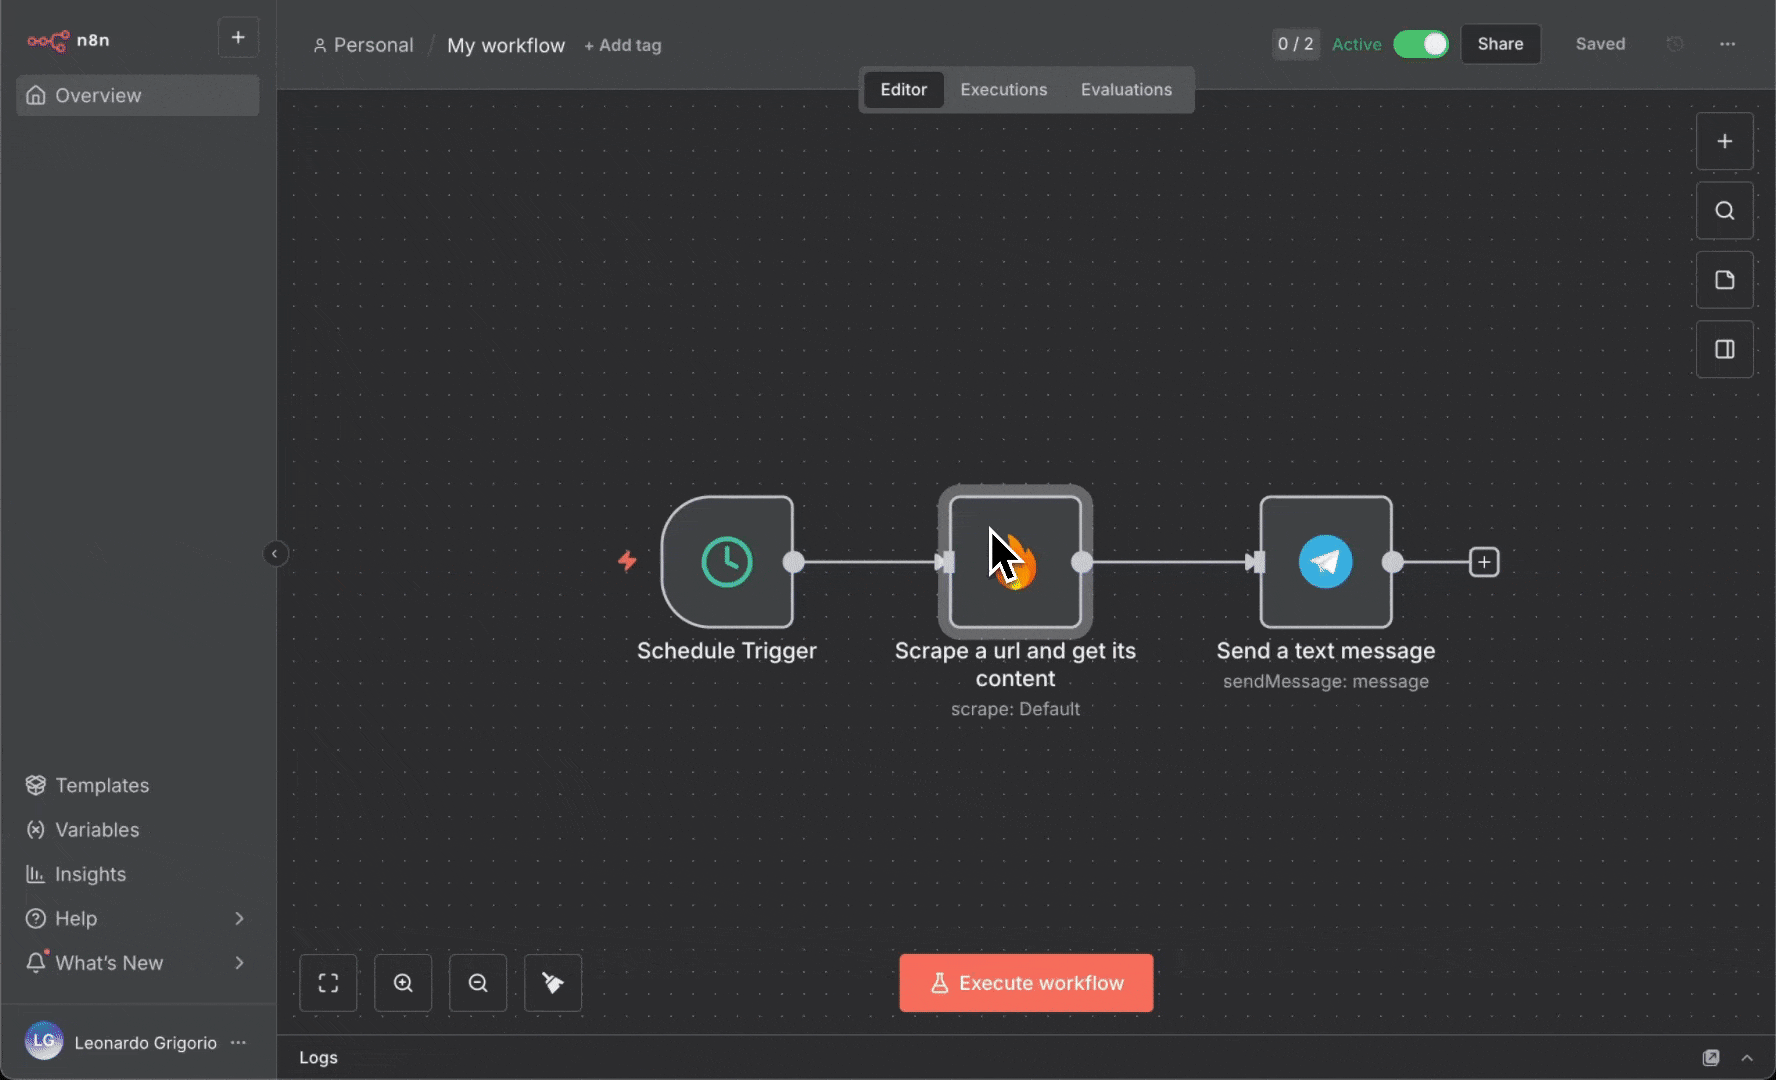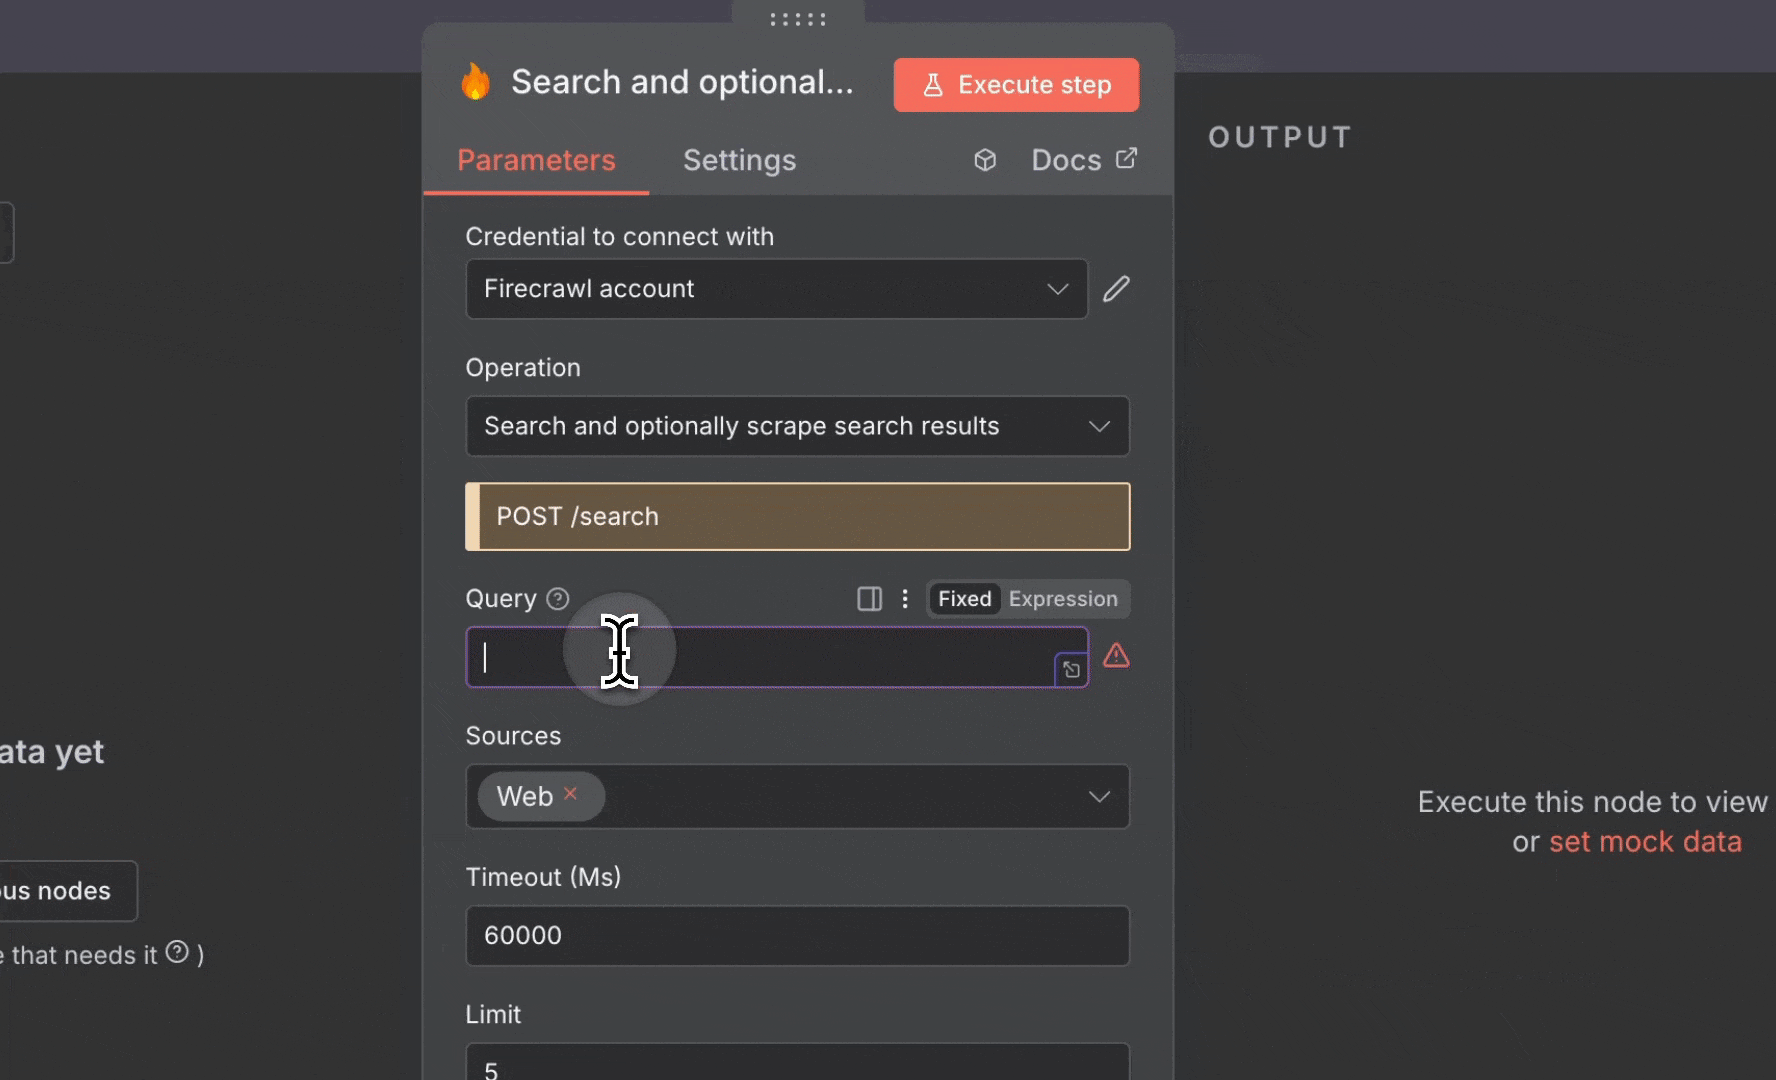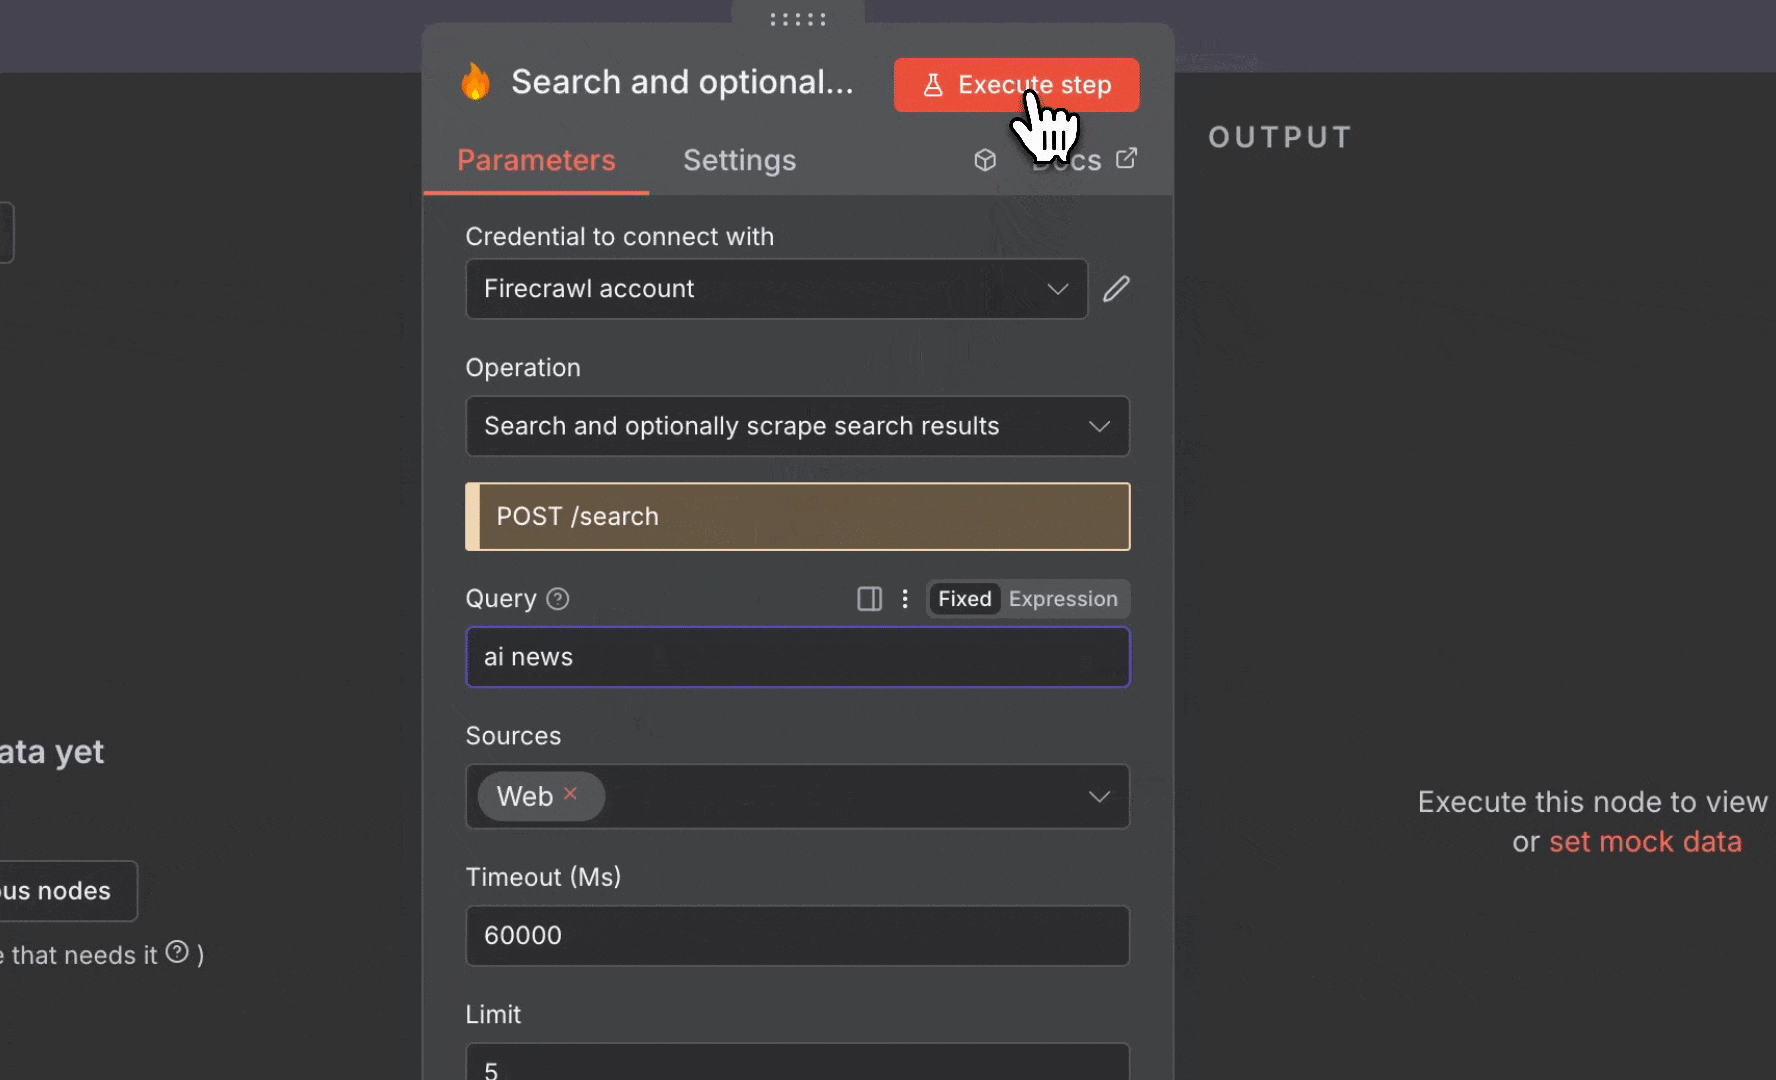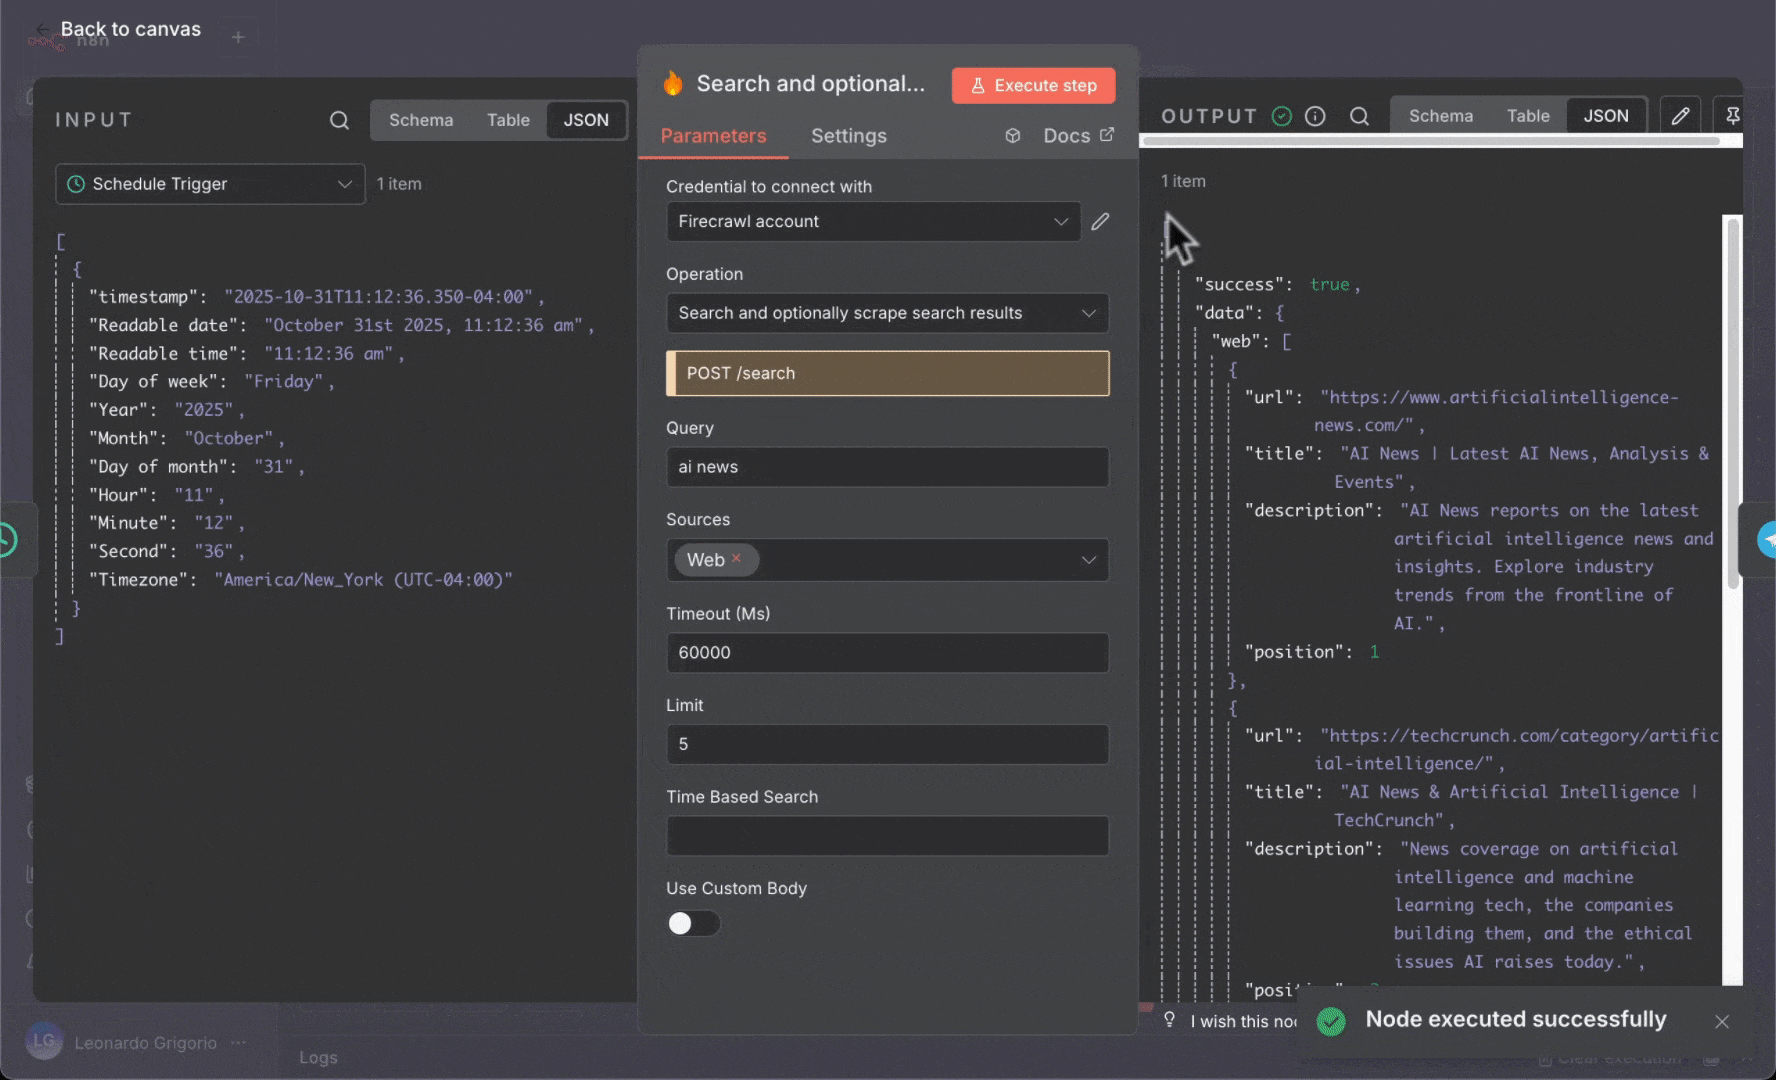
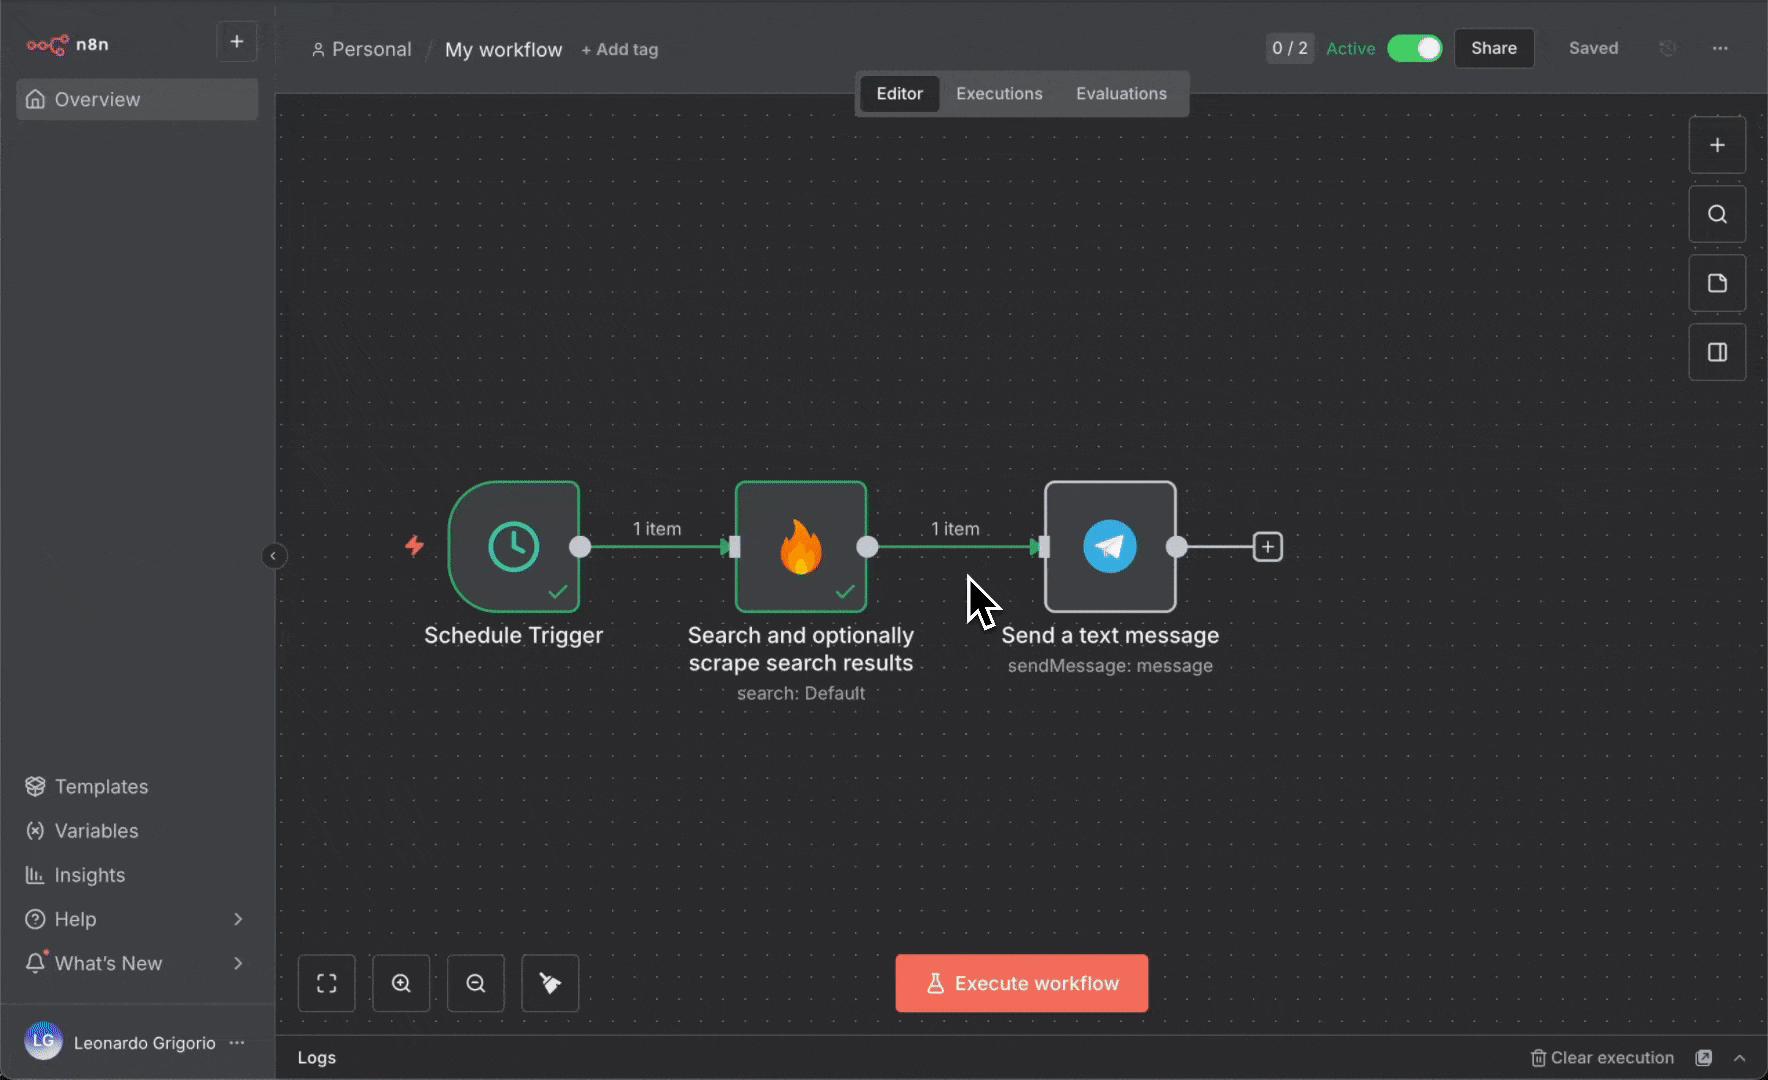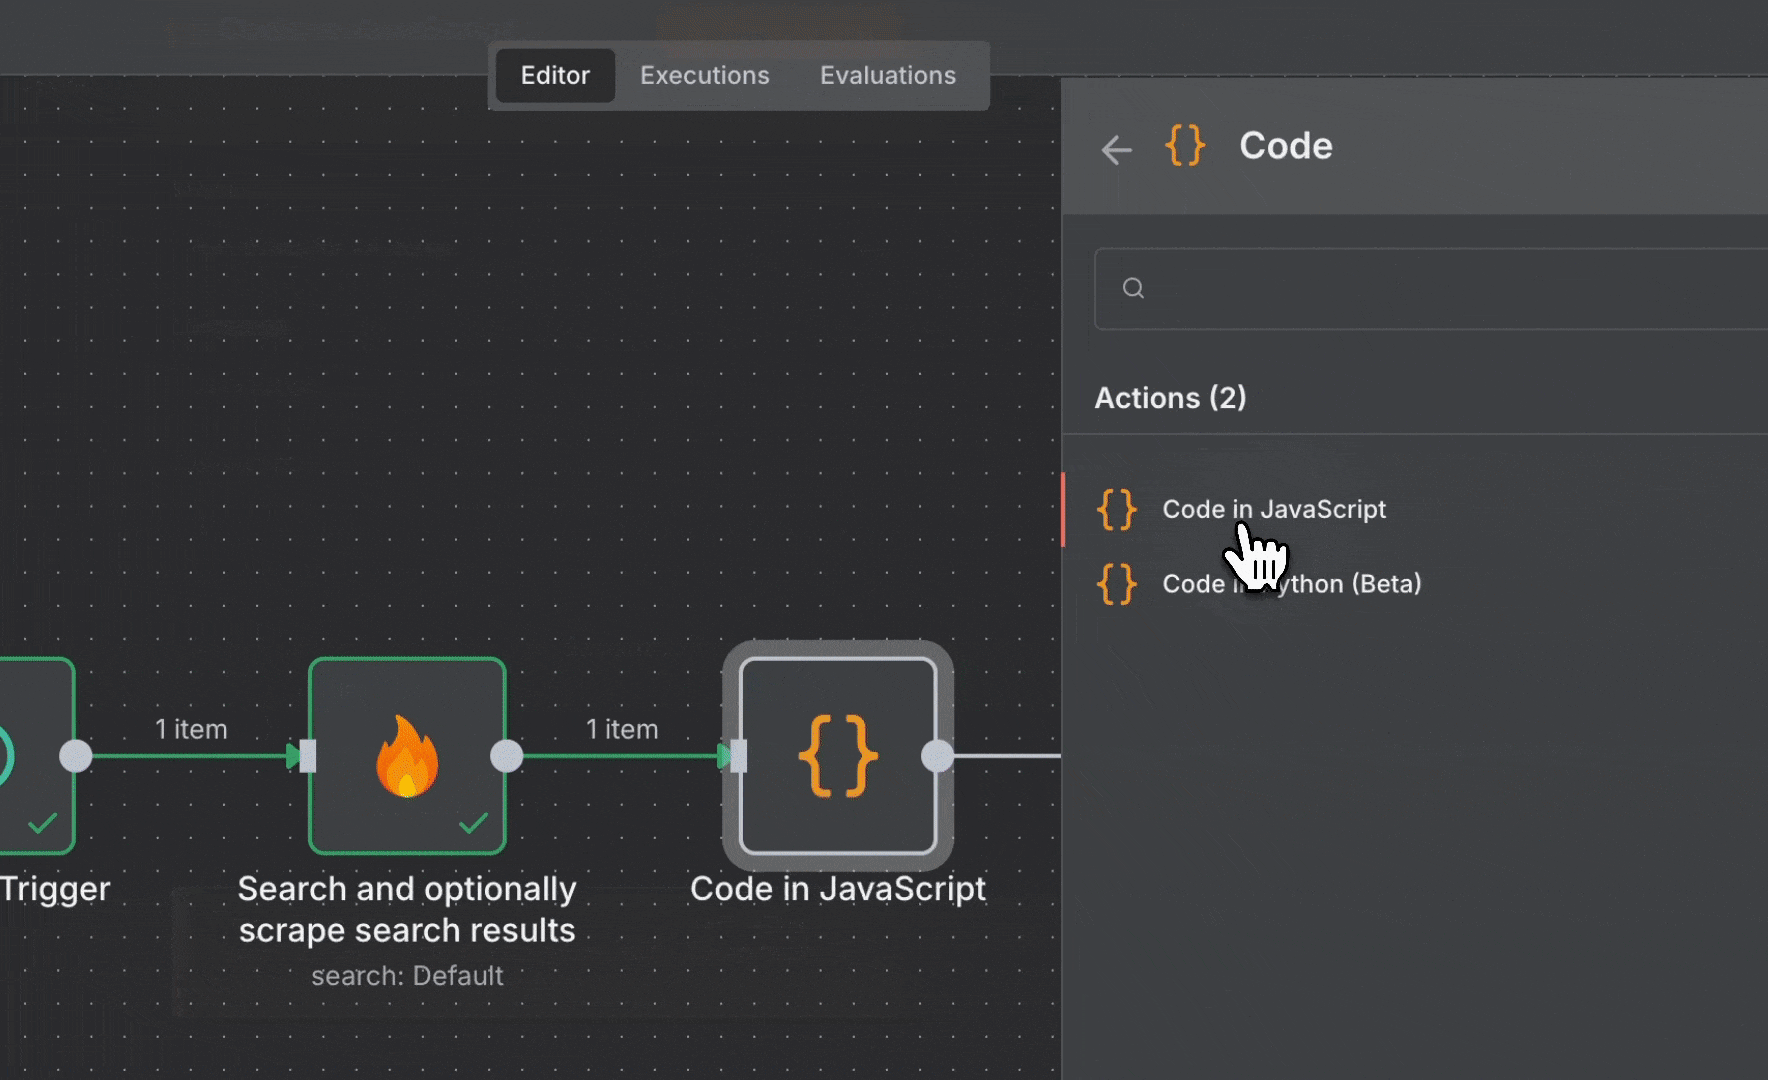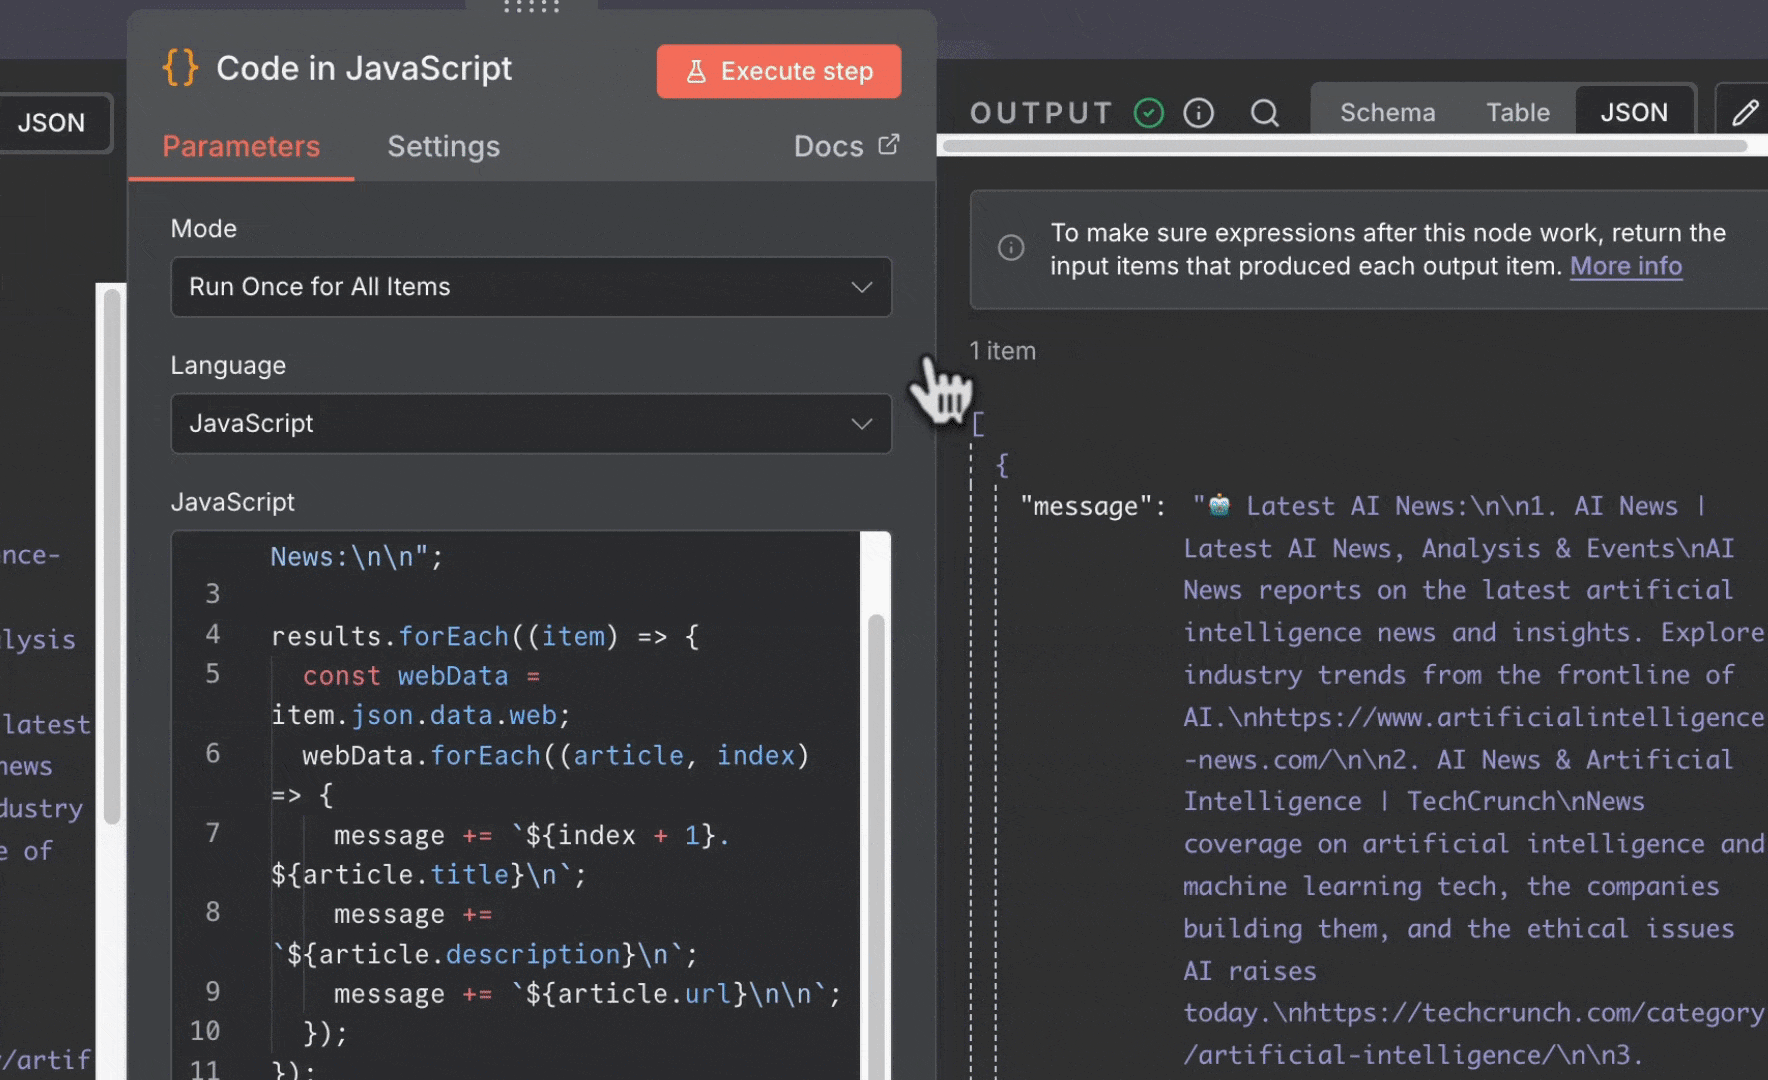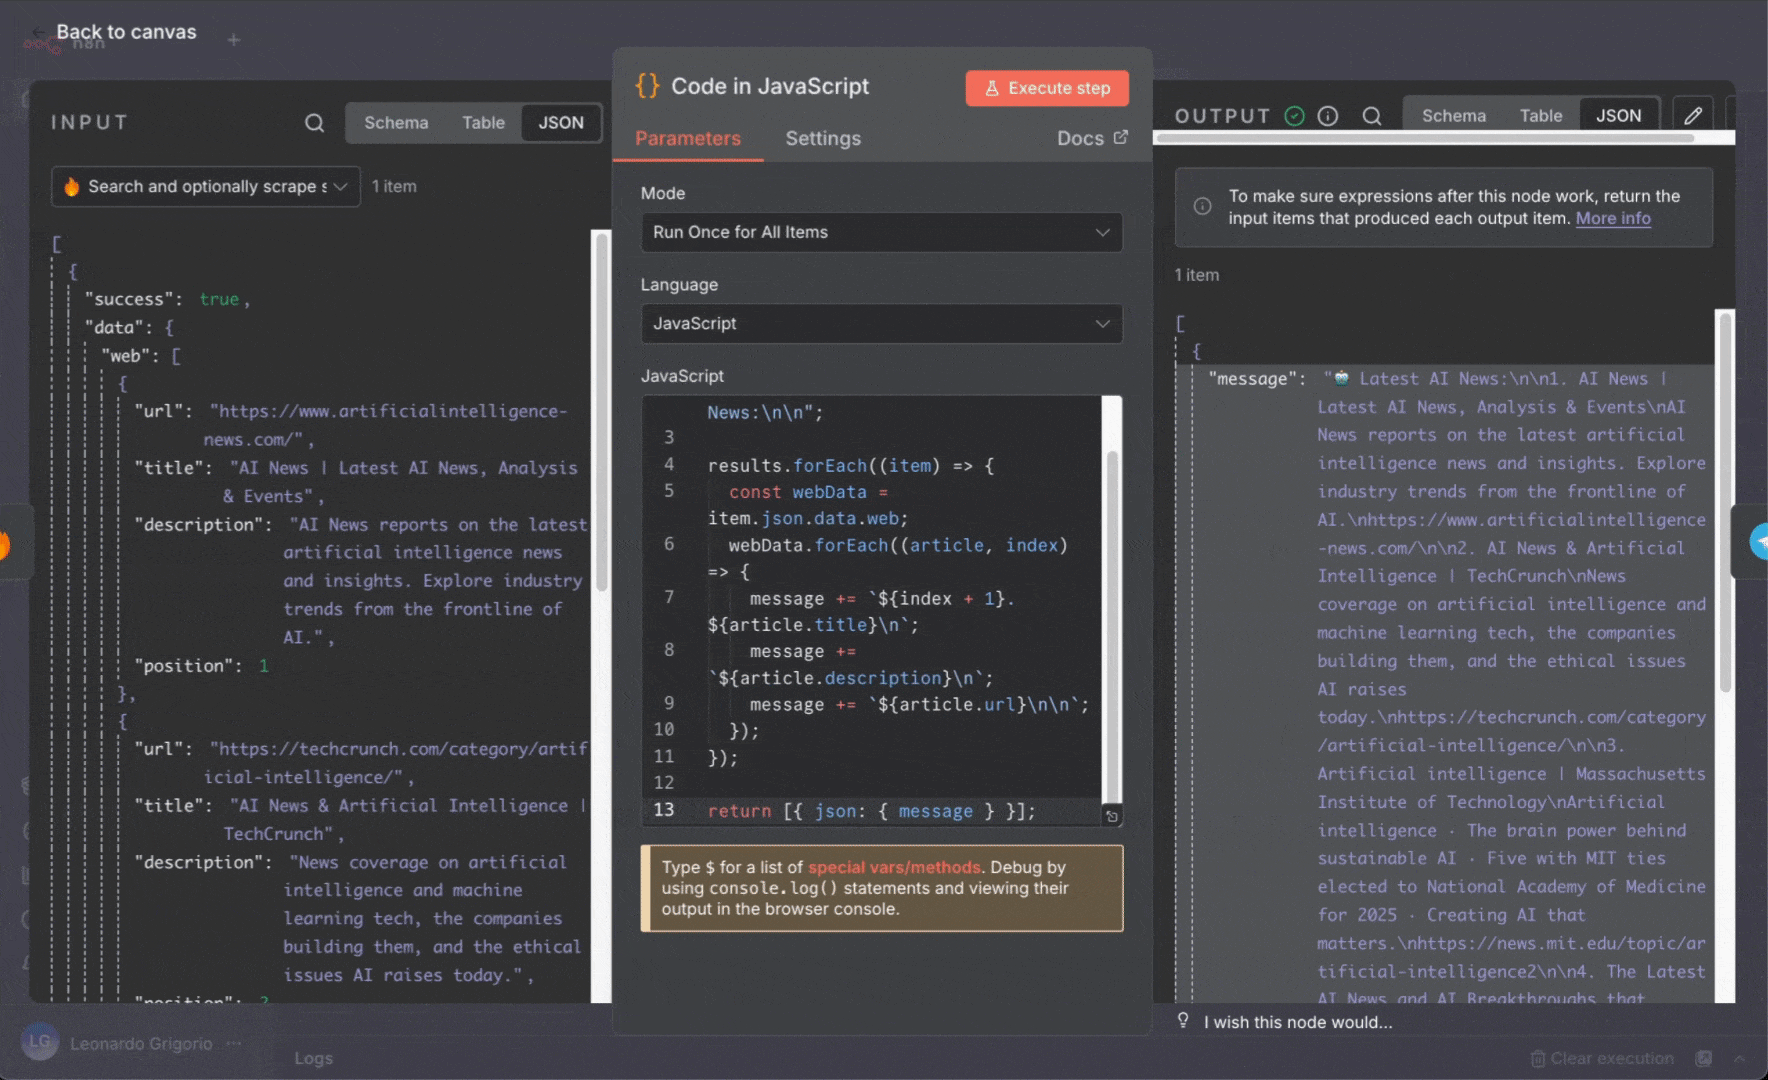
- Añade un nodo Code para formatear los resultados de búsqueda:
- Selecciona “Ejecutar una vez para todos los elementos”
- Pega este código:
- Actualiza el nodo Telegram (con tu credencial guardada):
- Texto: Arrastra el campo
messagedesde el nodo Code
- Texto: Arrastra el campo

Ejemplo 3: Resumen de noticias con IA
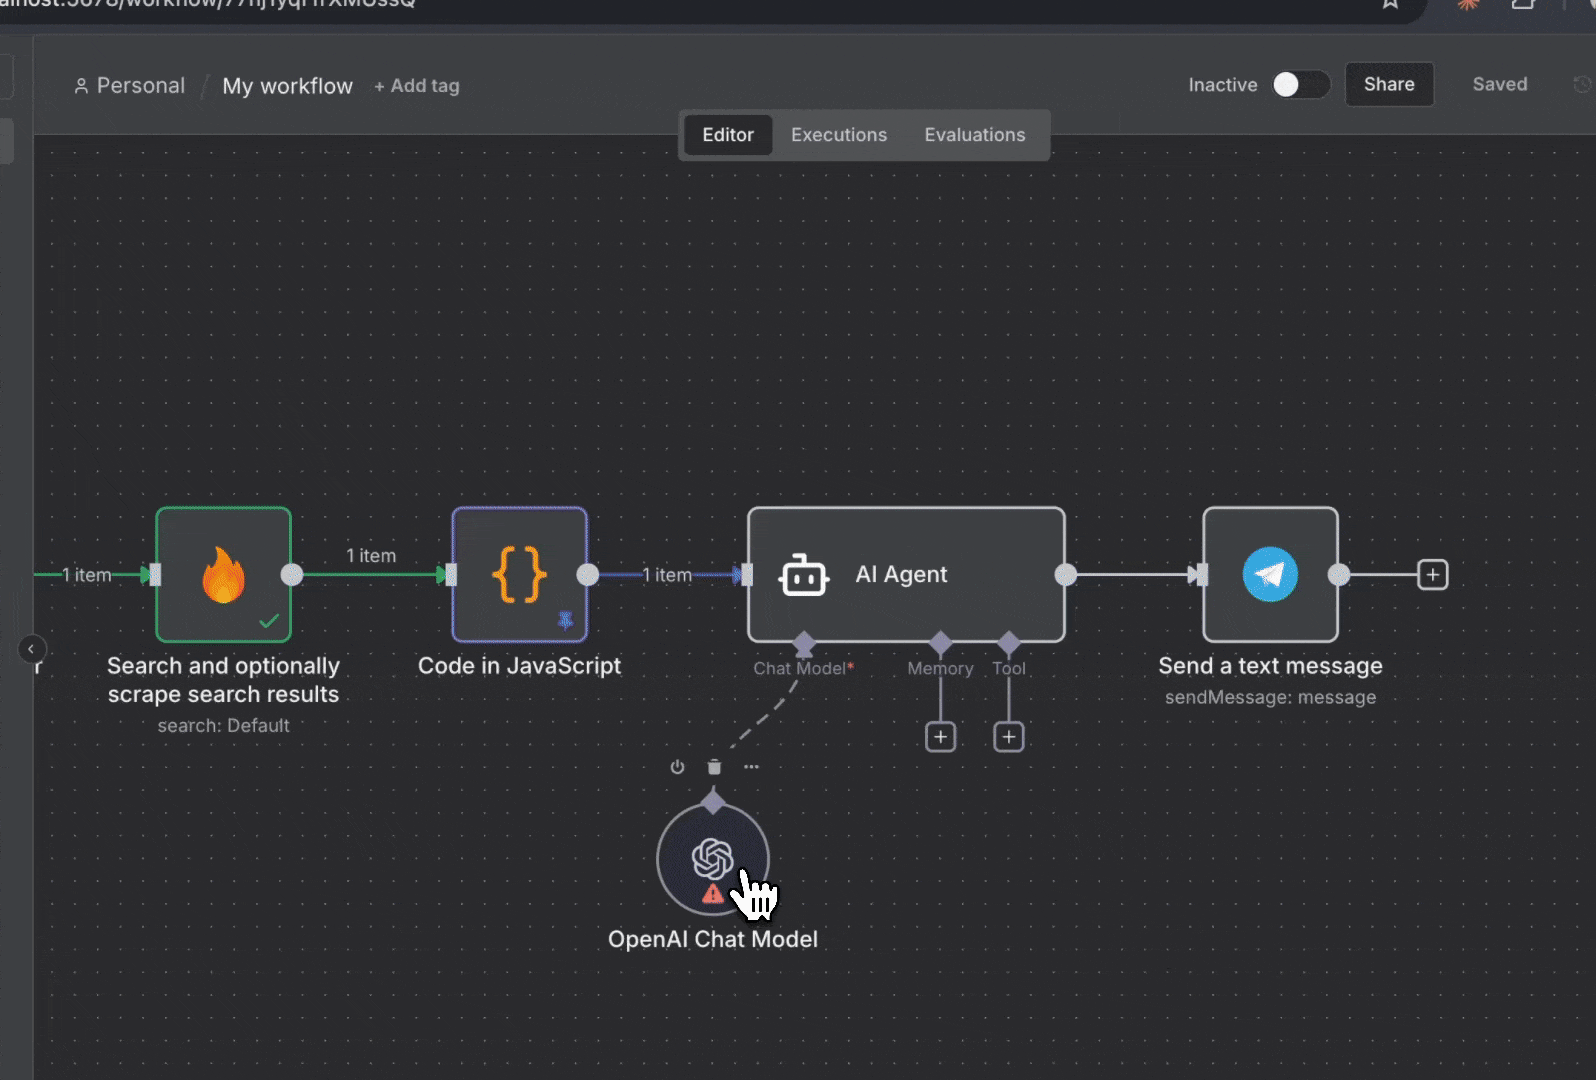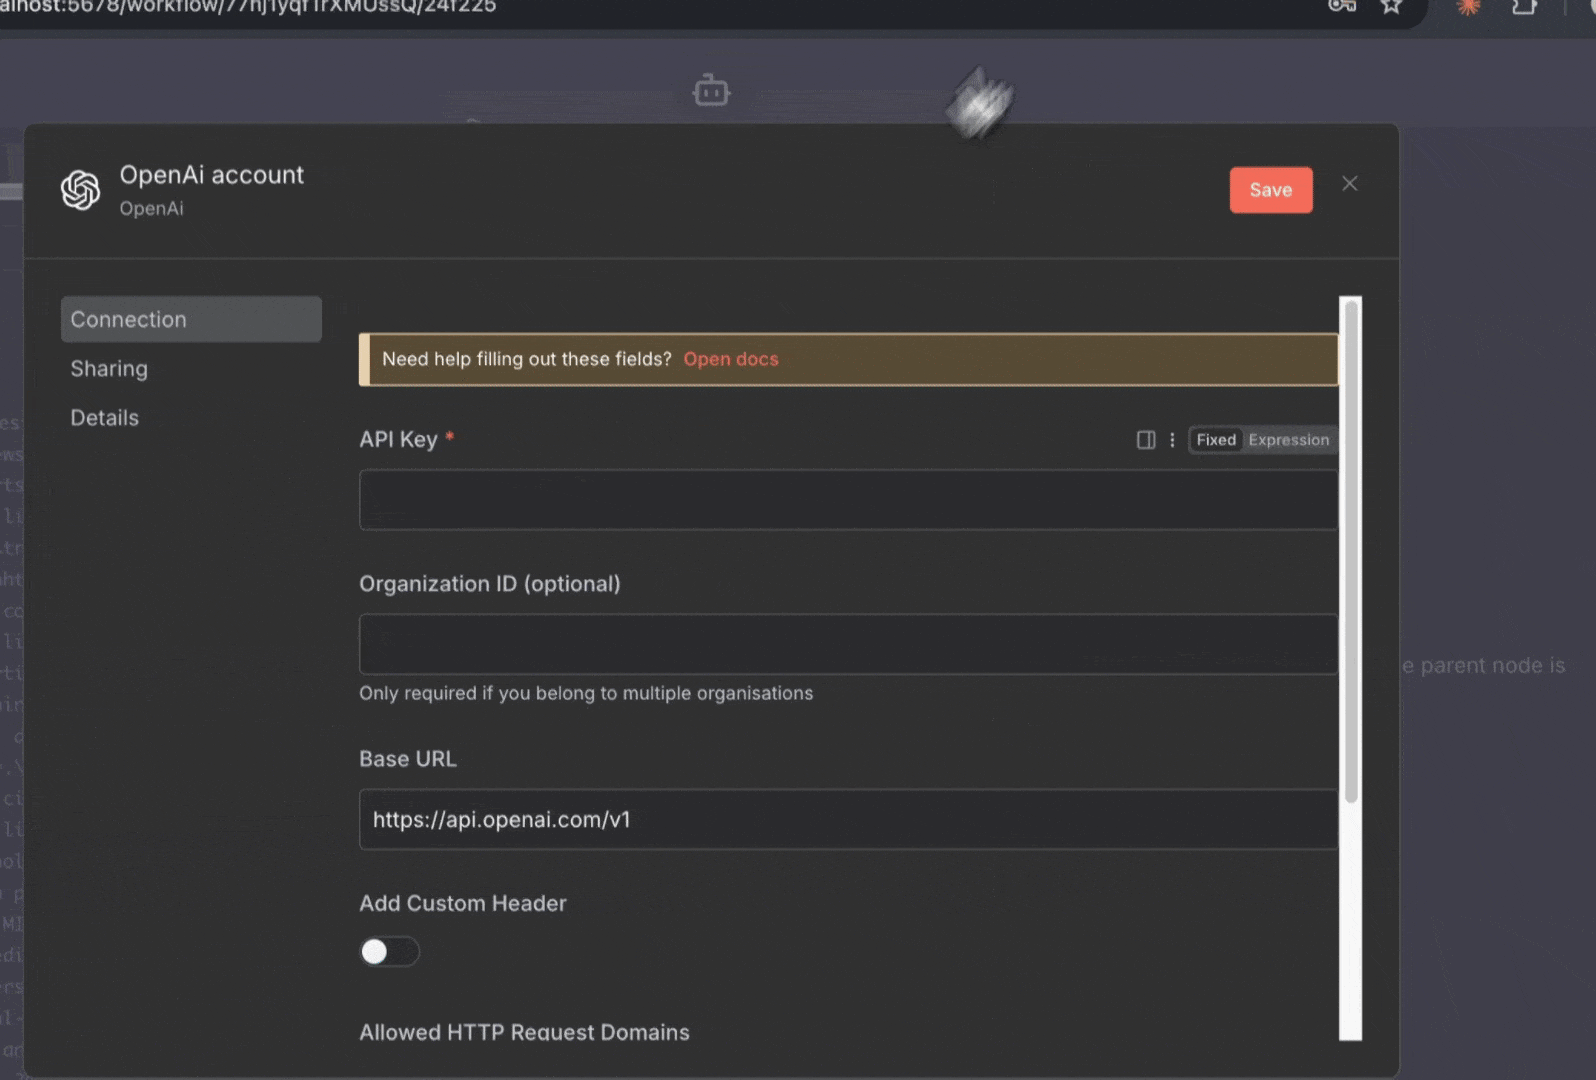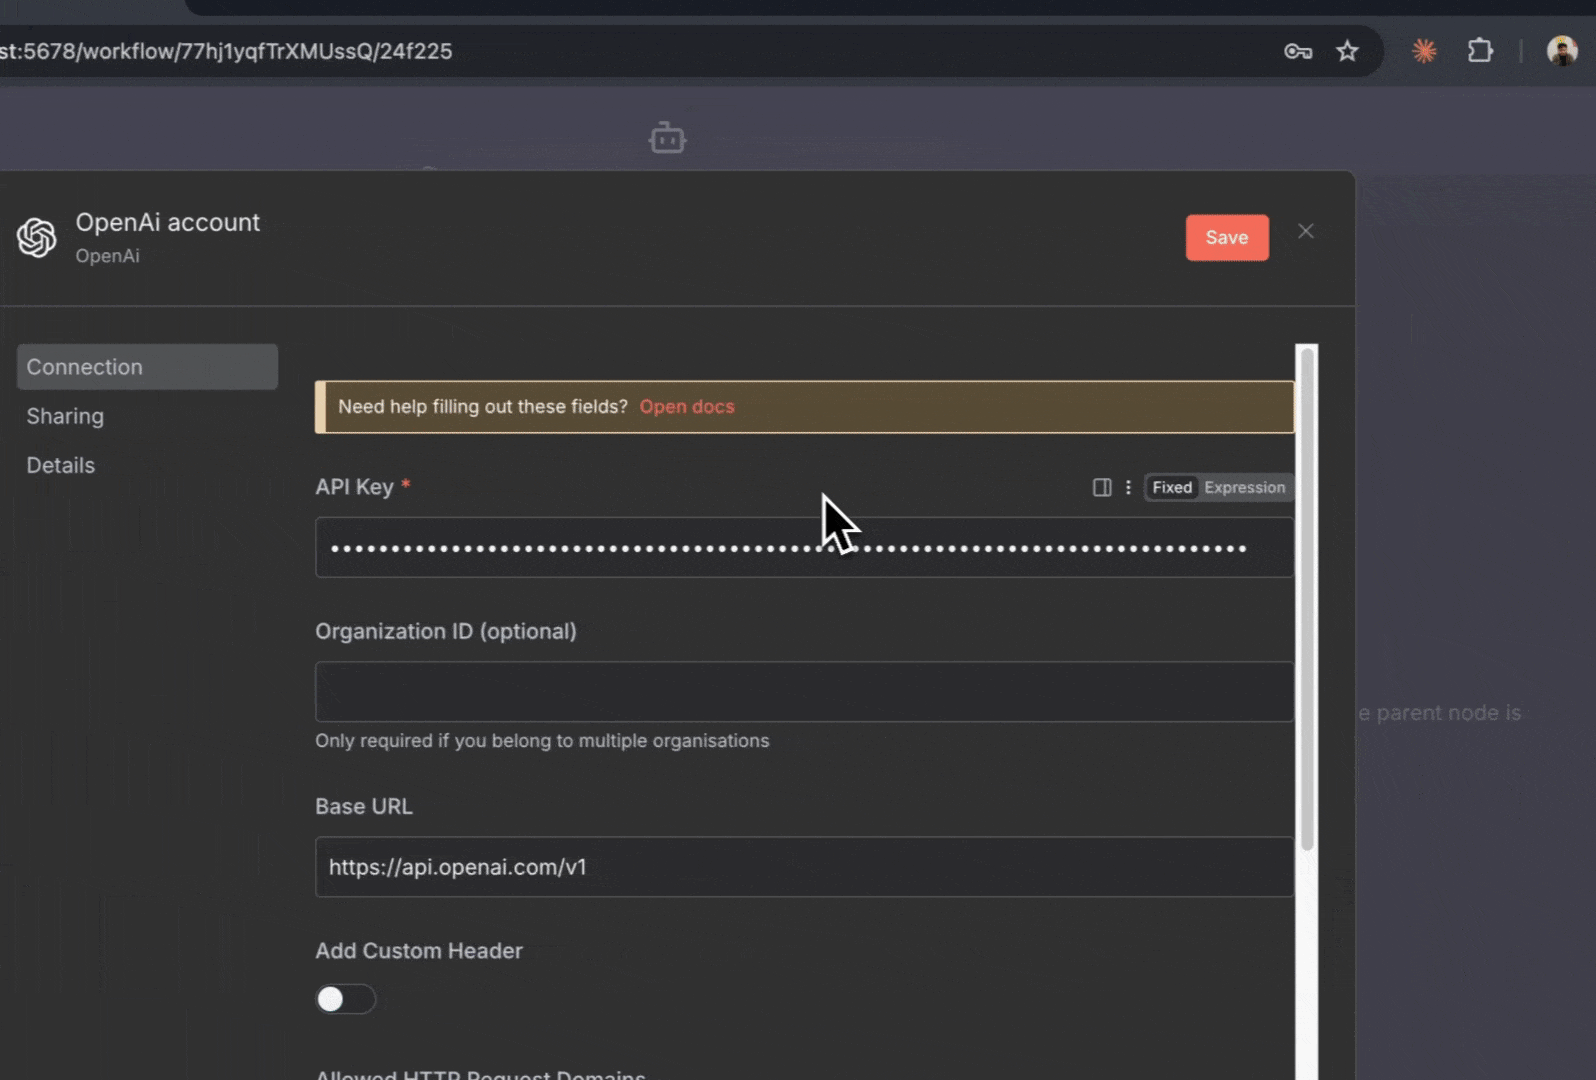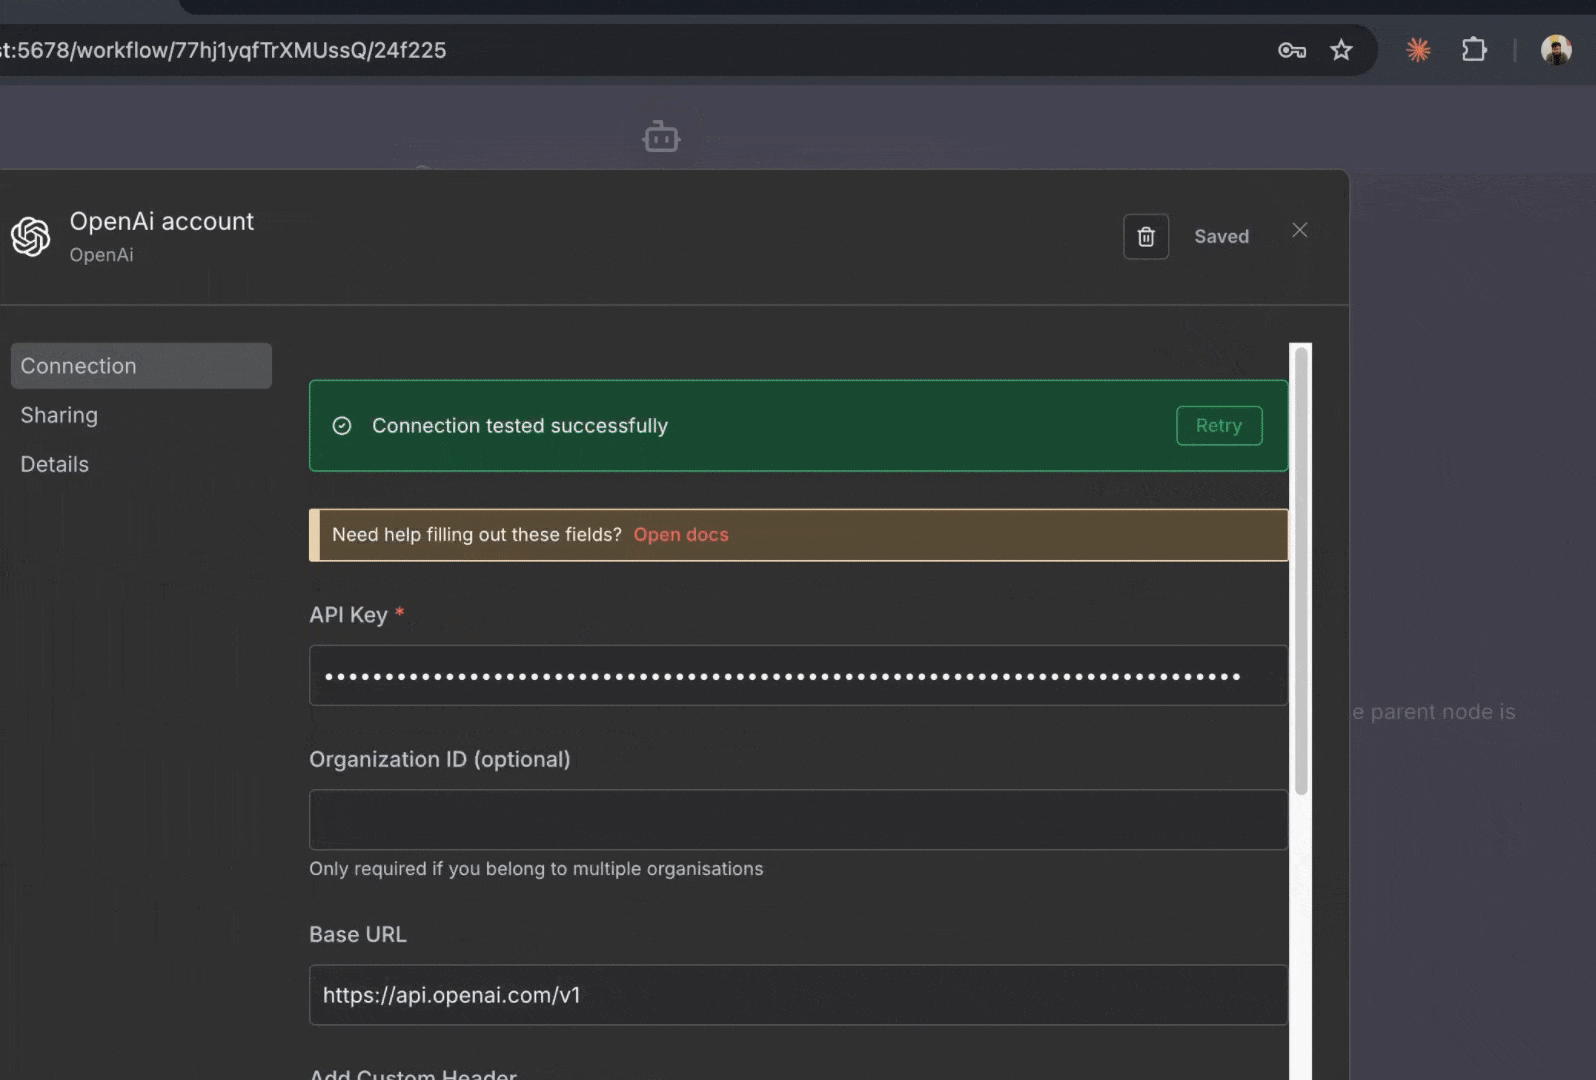
Este flujo de trabajo incorpora IA al Ejemplo 2 y utiliza OpenAI para generar resúmenes inteligentes de las últimas noticias sobre IA antes de enviarlas a Telegram. Cambios principales respecto al Ejemplo 2:- Configurar las credenciales de OpenAI
- Añadir el nodo agente de IA entre Code y Telegram
- agente de IA analiza y resume de forma inteligente todos los artículos de noticias
- Telegram recibe el resumen generado por IA en lugar de la lista de noticias sin procesar
- Obtén tu clave de API de OpenAI:
- Ve a platform.openai.com/api-keys
- Inicia sesión o crea una cuenta
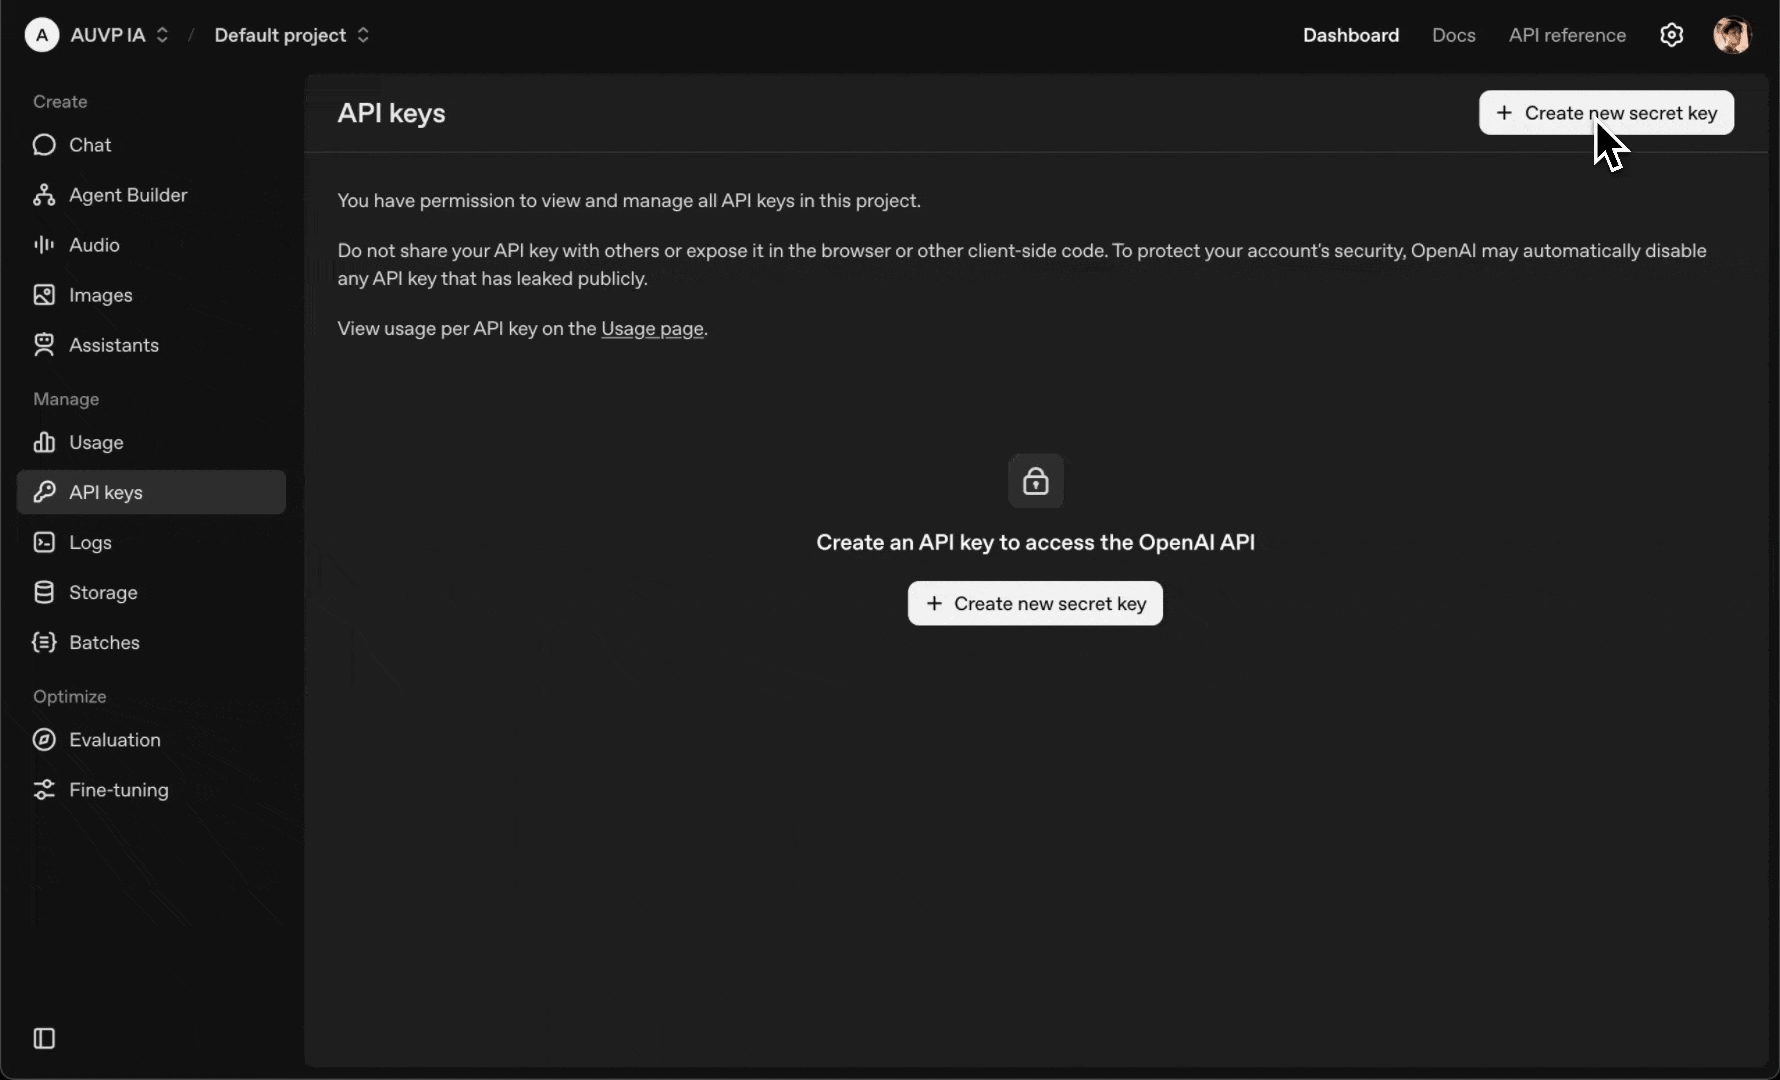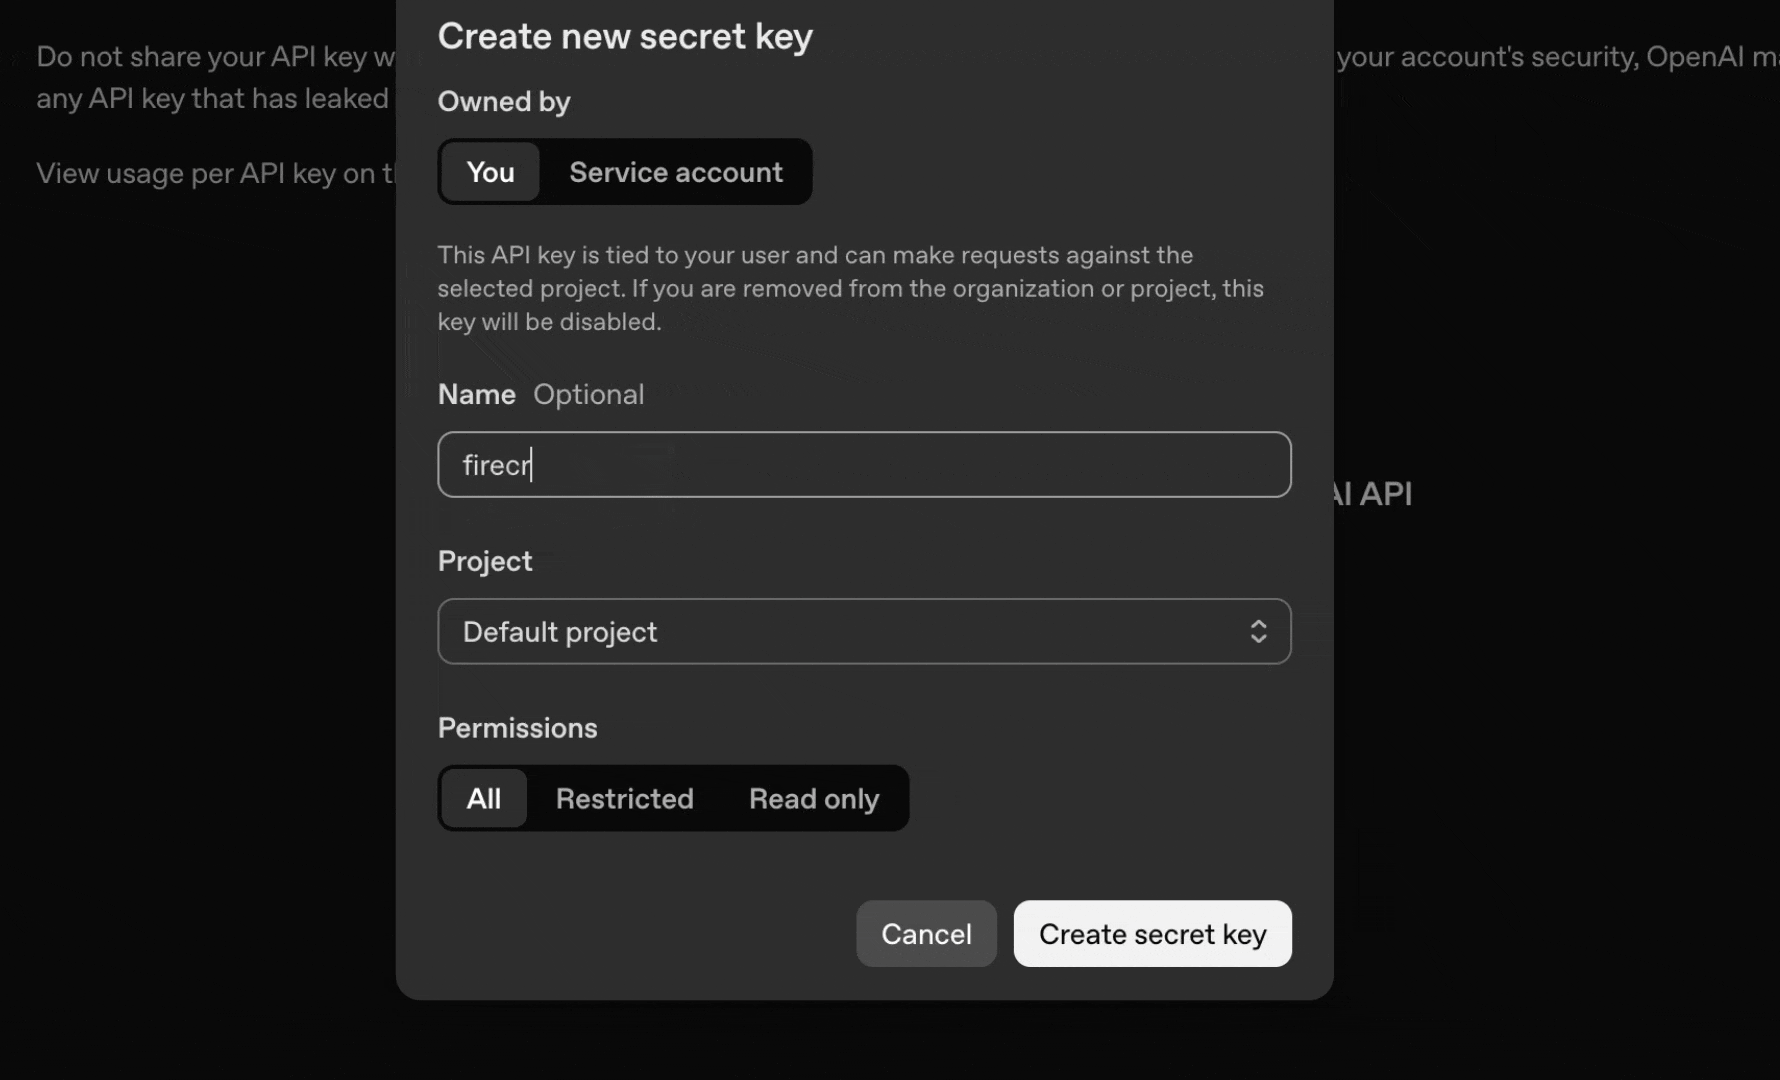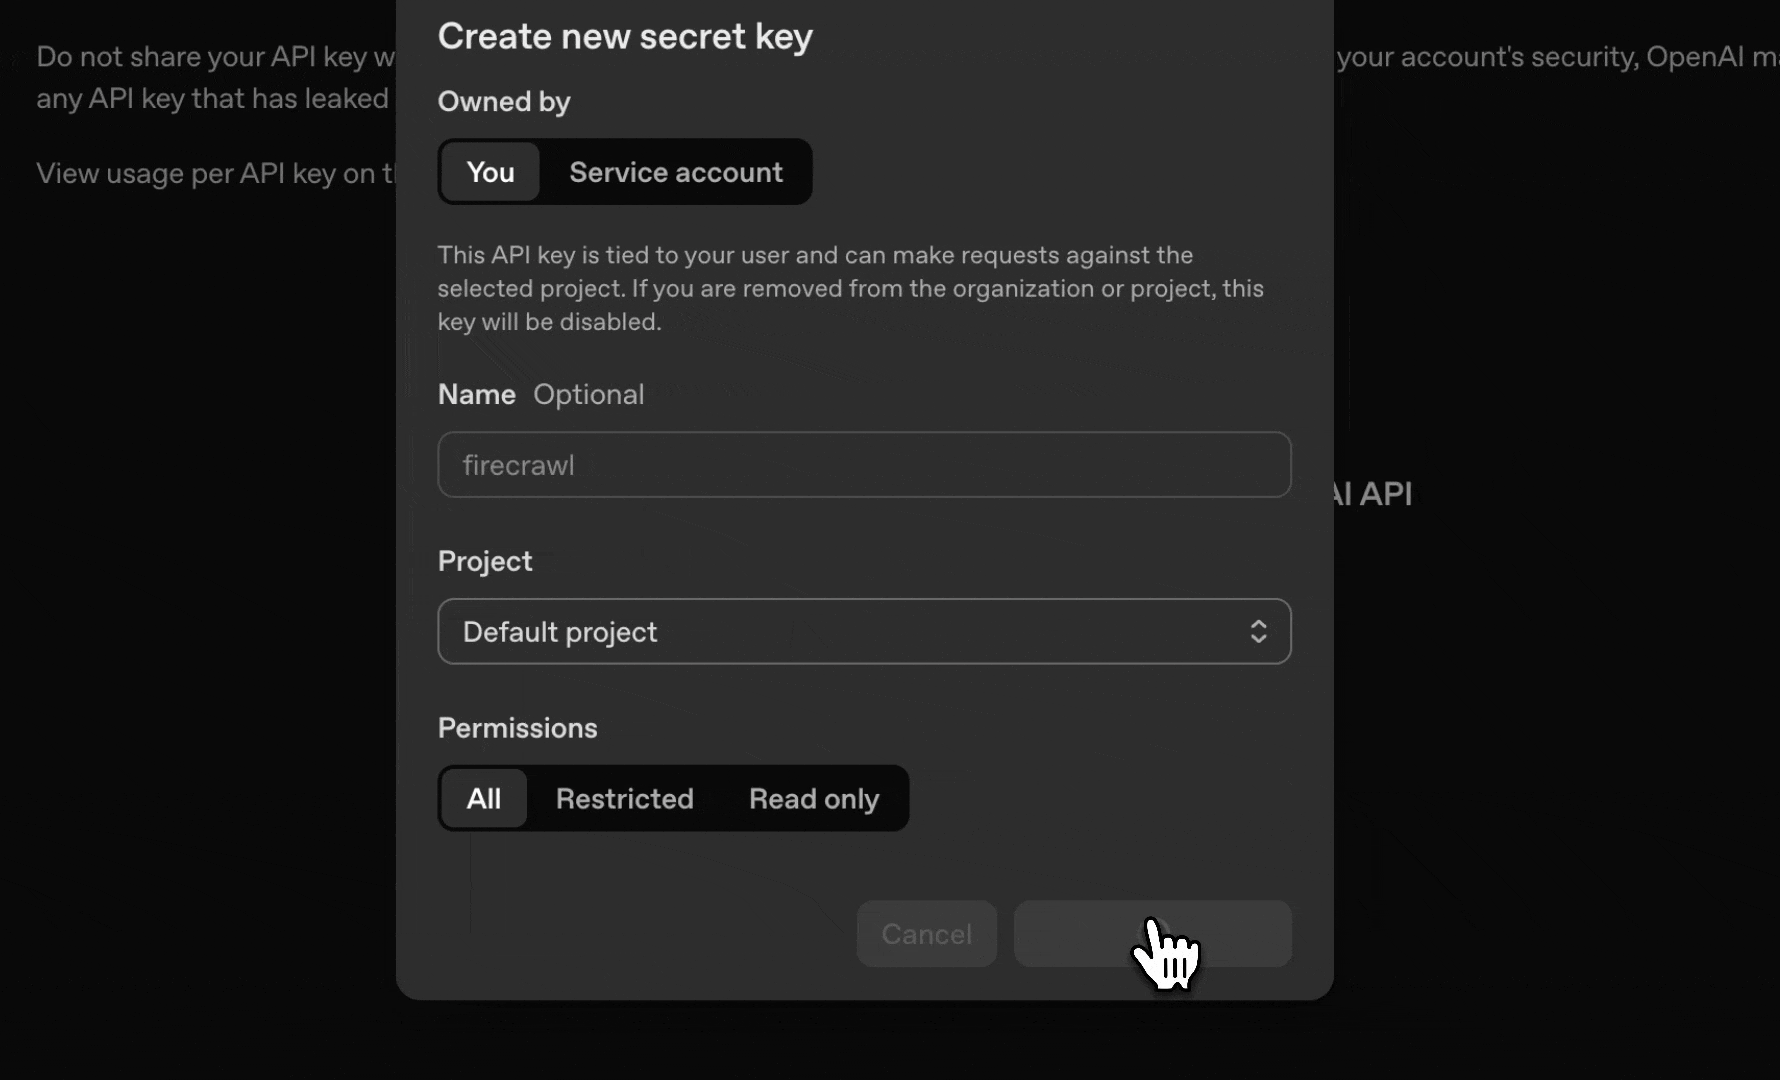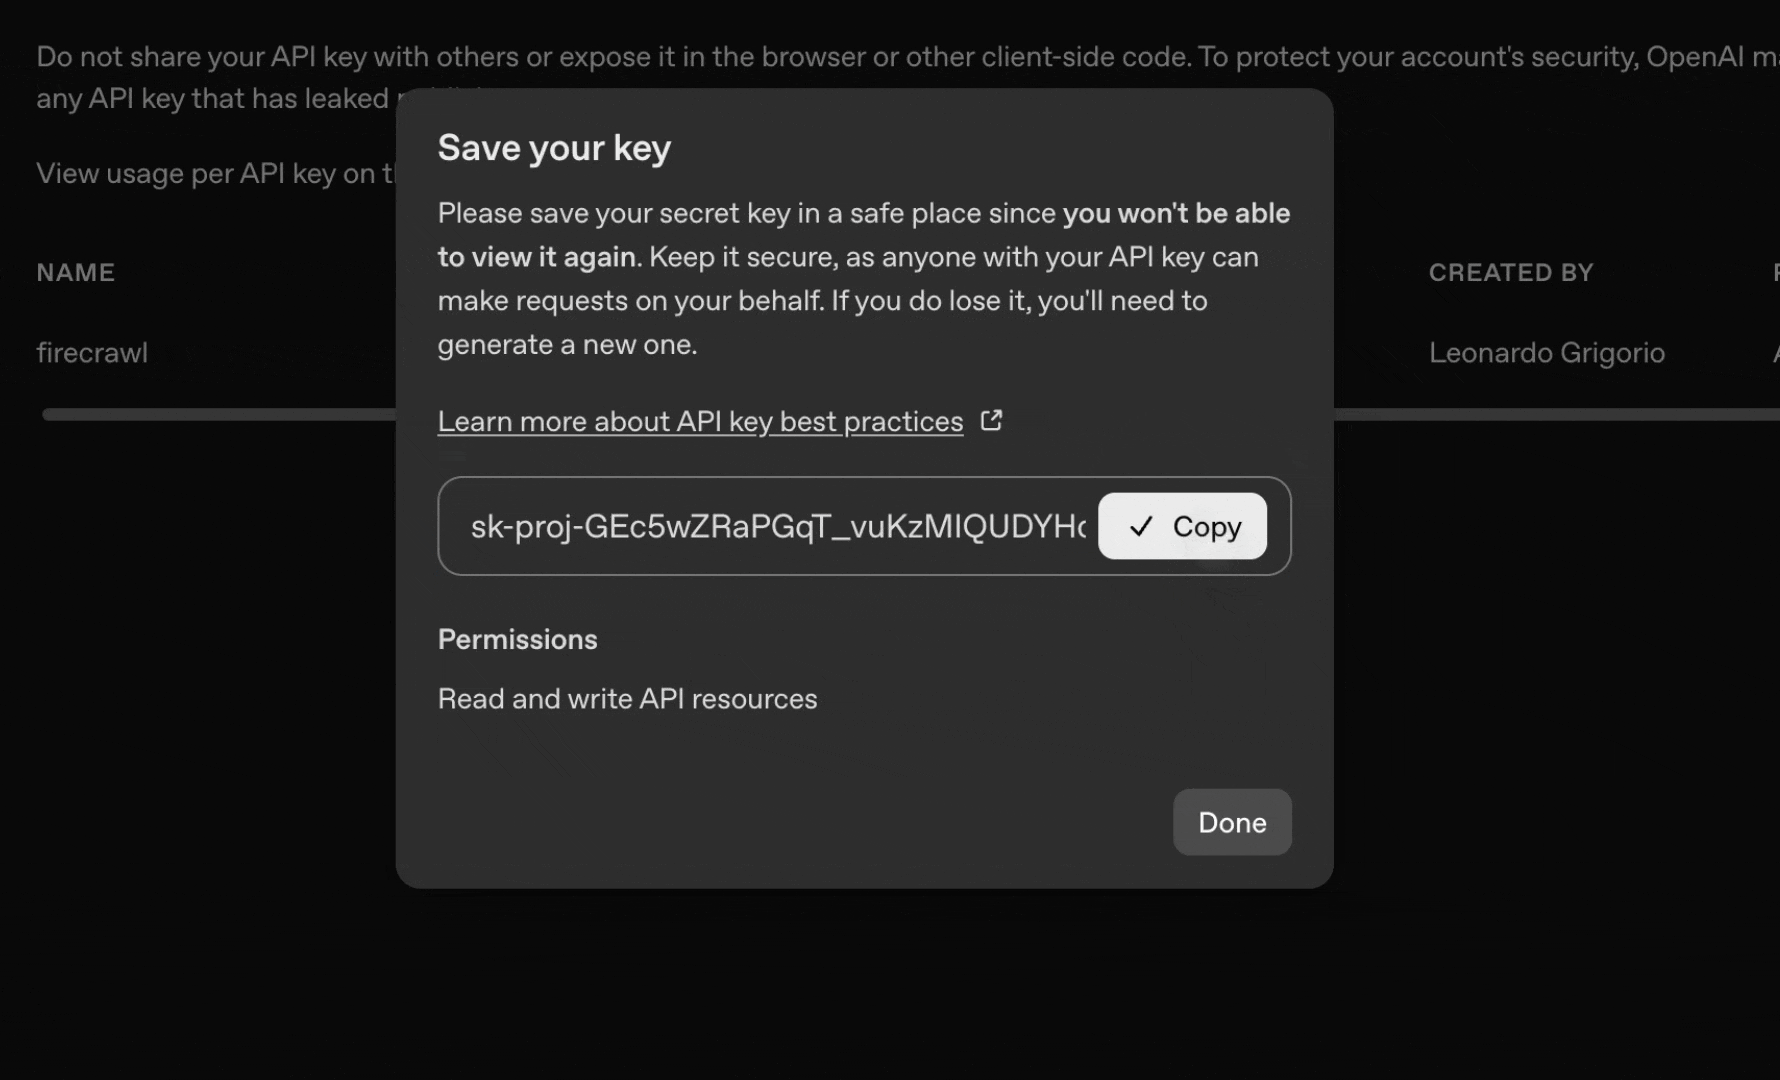
- Haz clic en “Create new secret key”
- Asígnale un nombre (p. ej., “n8n Integration”)
- Copia la clave de API inmediatamente (no podrás volver a verla)
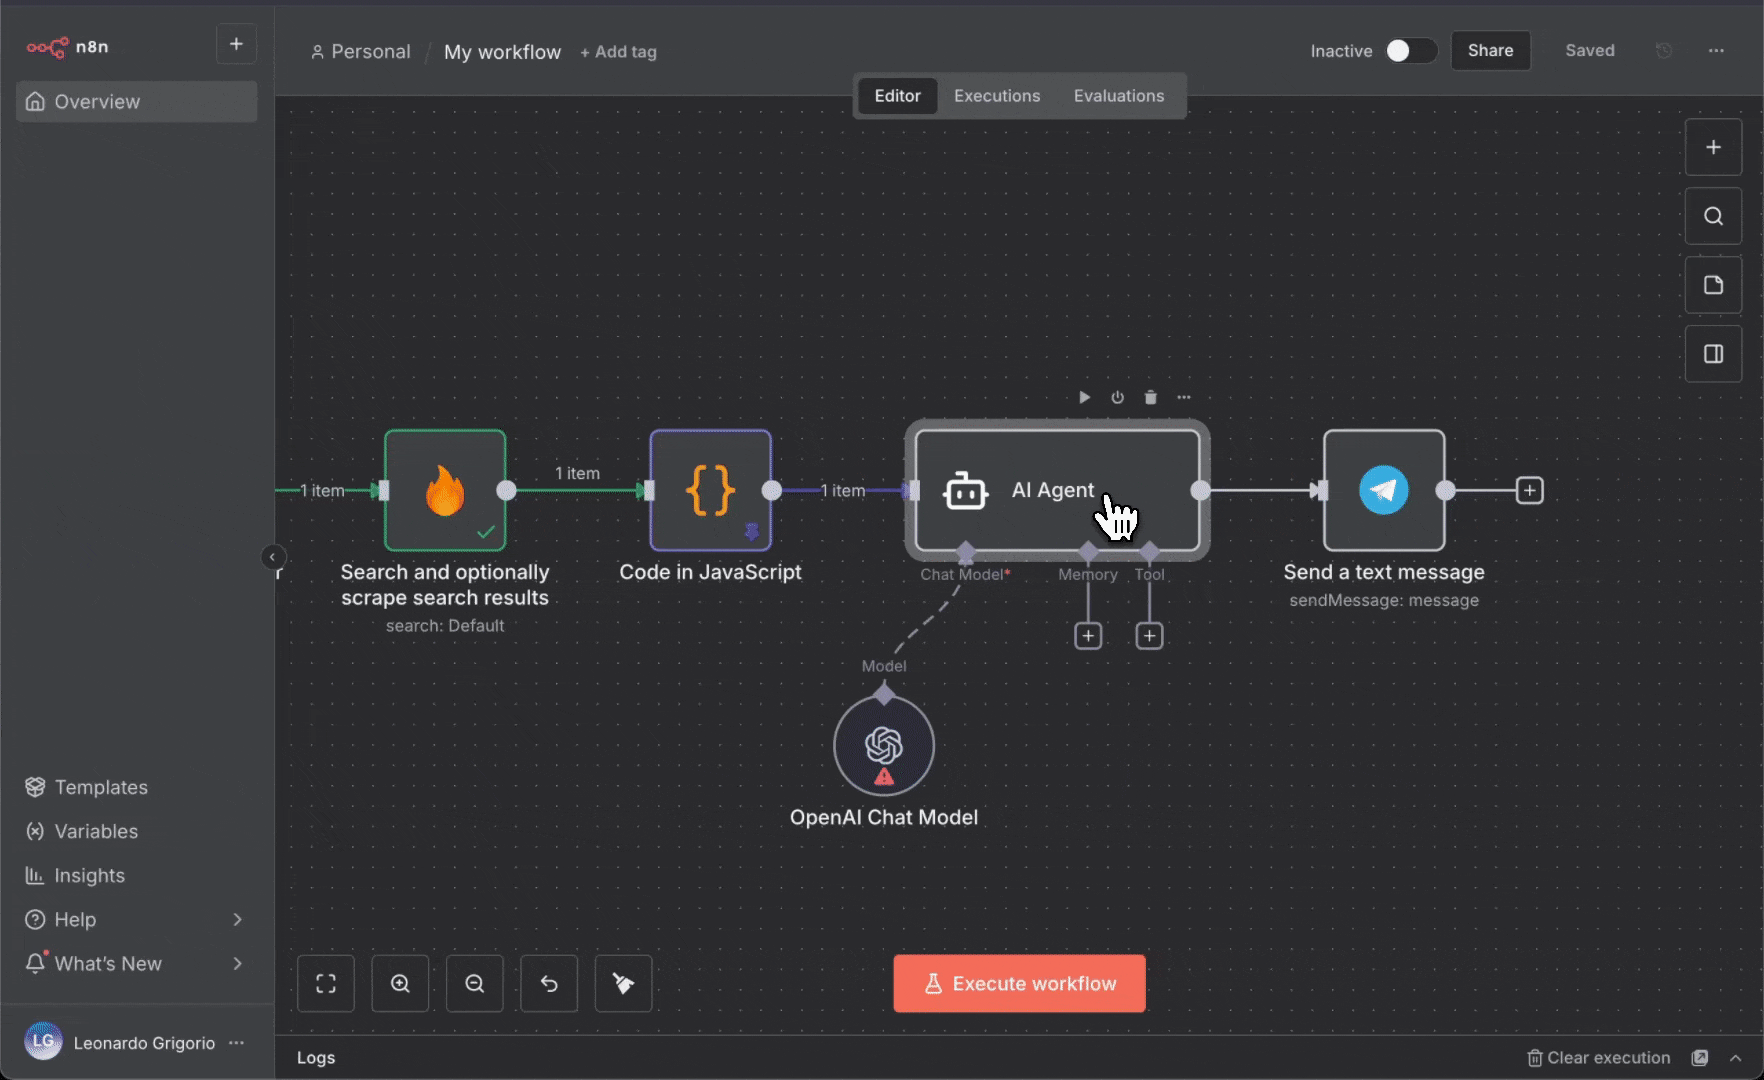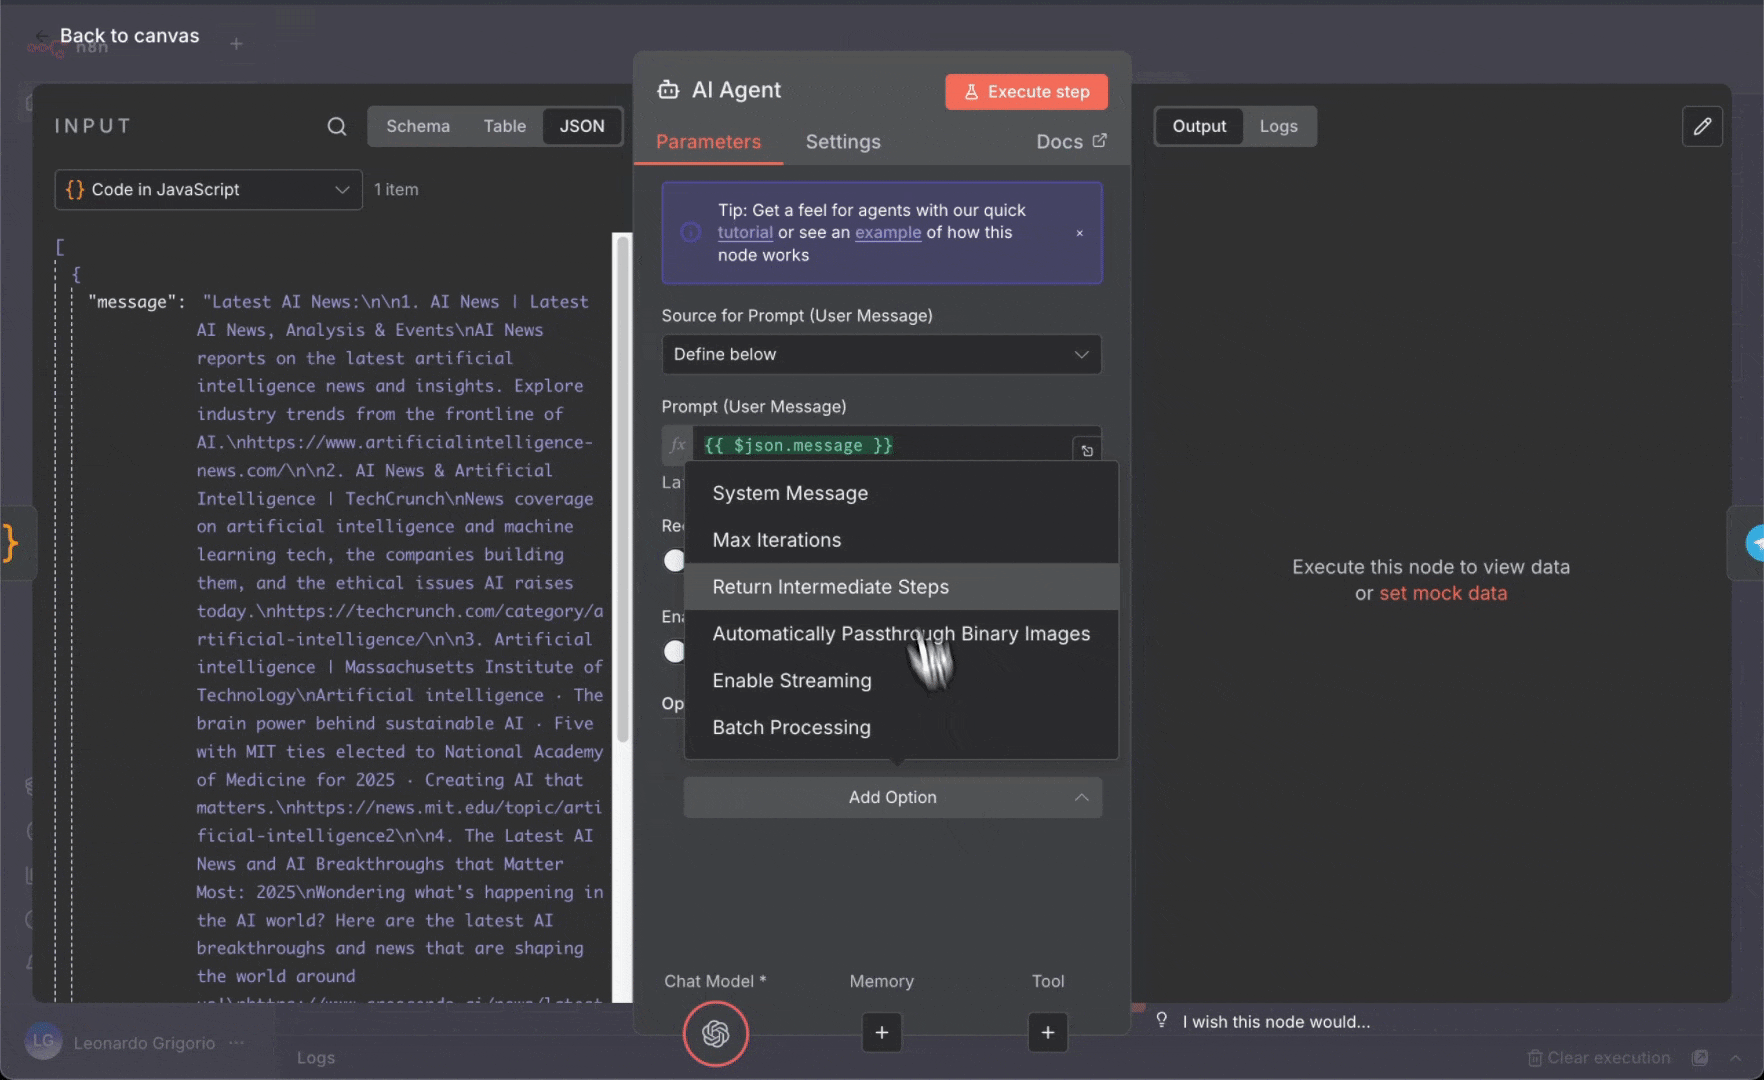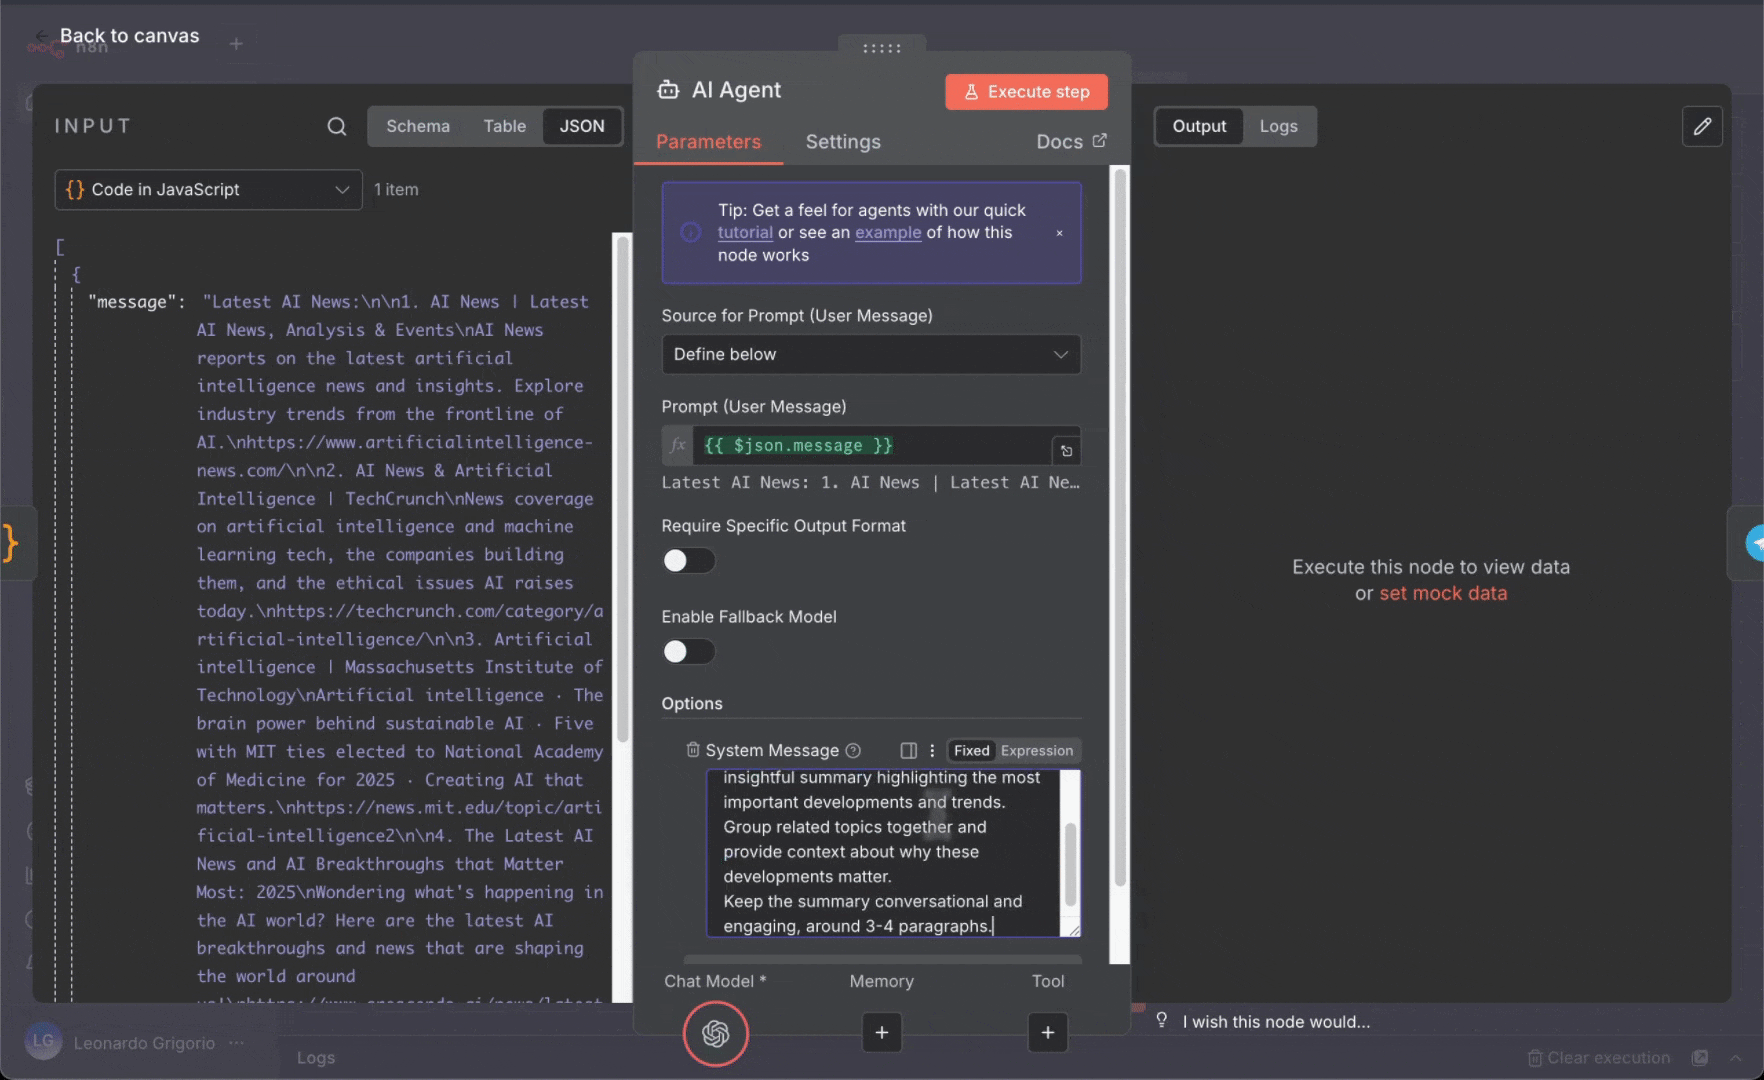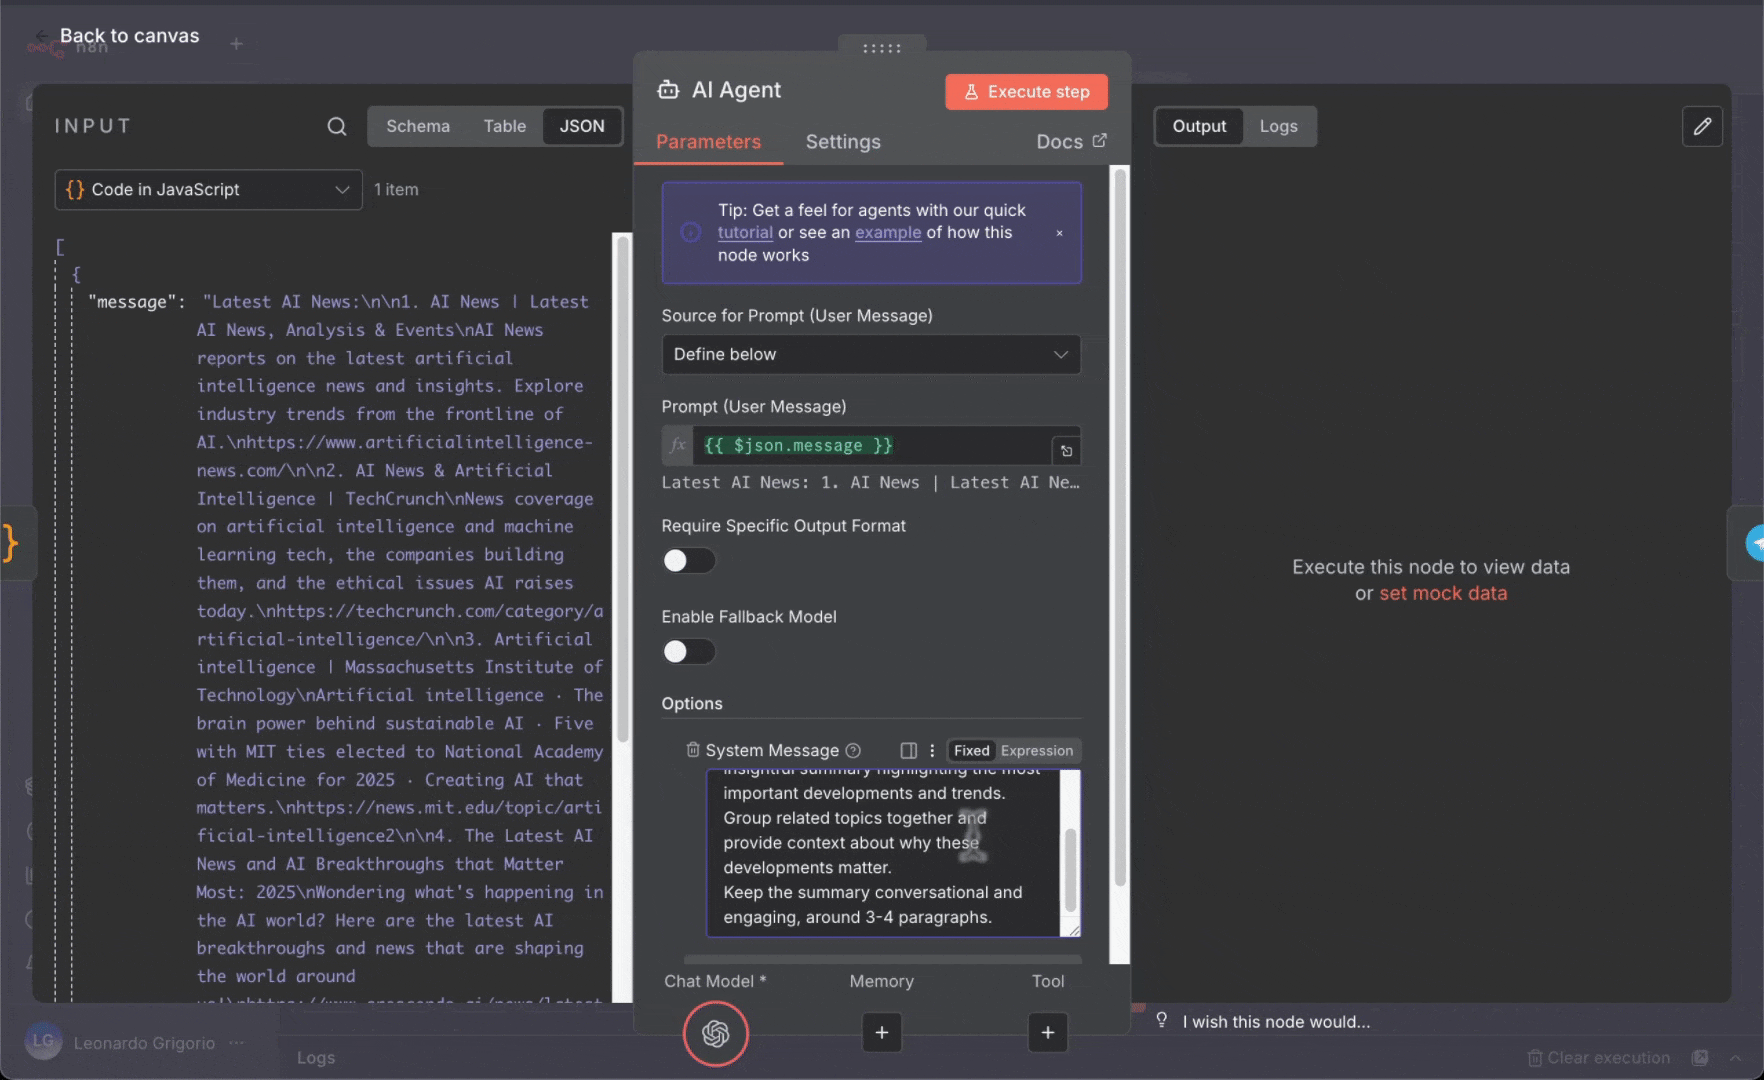
- Añade y conecta el nodo agente de IA:
- Haz clic en ”+” después del nodo Code
- Busca “Basic LLM Chain” o “agente de IA”
- Arrastra el campo
messagedel nodo Code al campo del prompt de entrada de agente de IA - Selecciona OpenAI como proveedor de LLM

- Añade tus credenciales de OpenAI:
- Haz clic en “crear nueva credencial” para OpenAI
- Pega tu clave de API de OpenAI
- Selecciona el modelo: gpt-5-mini (económico) o gpt-5 (más capaz)
- Haz clic en “Save”
- Añade el System prompt a agente de IA:
- En el nodo agente de IA, añade este System prompt:
- Actualiza el nodo de Telegram y pruébalo:
- Actualiza el nodo de Telegram:
- Texto: Arrastra la salida del agente de IA (el resumen generado)
- Elimina el mapeo anterior al mensaje del nodo Code
- Haz clic en “ejecutar flujo de trabajo” para probarlo
- La IA analizará todos los artículos de noticias y creará un resumen
- Revisa Telegram para ver el resumen generado por la IA
- Actualiza el nodo de Telegram:

El agente de IA recibe todos los artículos de noticias con formato y crea un resumen inteligente, lo que facilita identificar de un vistazo las tendencias y los avances importantes.
Operaciones de Firecrawl
Ahora que has creado algunos flujos de trabajo, exploremos las distintas operaciones de Firecrawl disponibles en n8n. En el nodo de Firecrawl, primero eliges un Resource (Scraping, Crawling, Map & Search, Agent, Interact, Browser, Account o Extract (Legacy)) y luego una Operation. Cada operación está diseñada para casos de uso específicos de datos web.Extraer contenido de una URL
Recurso: Scraping. Extrae contenido de una sola página web y lo devuelve en varios formatos. Qué hace:- Hace scraping de una sola URL
- Devuelve markdown limpio, HTML o resúmenes generados por IA
- Devuelve datos estructurados con el formato JSON y un prompt o esquema
- Puede capturar capturas de pantalla y extraer enlaces
- Extracción de artículos
- Monitoreo de páginas de productos
- Scraping de publicaciones de blog
- Generación de resúmenes de páginas
Interact
Recurso: Interact. Permite seguir trabajando con una página después de Scrape URL: hacer clic, rellenar formularios y navegar, mediante un prompt en lenguaje natural o código de Playwright o Bash. Operaciones:- Execute Interaction: ejecuta un prompt o código sobre una página extraída, usando el
scrapeIdde la salida de Scrape URL (data.metadata.scrapeId) - Stop Interaction: finaliza la sesión de Interact para ese
scrapeId - Get Interact Context: devuelve instrucciones de uso para agentes de IA que llaman a estas operaciones como herramientas
scrapeId y un prompt o código. No añadas profile al cuerpo de la solicitud de Interact; Interact hereda el perfil de la tarea de extracción de datos web.
Para guardar las cookies, localStorage y el resto del estado del navegador, ejecuta Stop Interaction cuando termine el flujo de trabajo. Si en una ejecución posterior del flujo de trabajo solo necesitas leer un perfil existente, desactiva Save Changes en la configuración del perfil del paso Scrape.
Si la versión instalada del nodo de Firecrawl para n8n no muestra Profile en la operación Scrape URL, actualízalo a la versión más reciente. También puedes pasar el mismo objeto profile en Additional Fields > Custom Properties (JSON):
Buscar en la web
Recurso: Map & Search. Realiza búsquedas web y devuelve resultados con scraping de contenido opcional. Qué hace:- Busca en la web, noticias o
images - Devuelve títulos, descripciones y URL
- Opcionalmente, hace scraping del contenido completo de los resultados
- Automatización de la investigación
- Supervisión de noticias
- Detección de tendencias
- Encontrar contenido relevante
Crawl Website
Recurso: Crawling. Descubre y scrapea de forma recursiva varias páginas de un sitio web. Qué hace:- Sigue enlaces automáticamente
- Scrapea varias páginas en un solo trabajo
- Puede filtrar URL por patrones
- Devuelve el ID de la tarea de rastreo; añade un segundo nodo de Firecrawl con Get Crawl Status para leer las páginas extraídas
- Extracción completa de documentación
- Archivado de sitios
- Recopilación de datos de varias páginas
Mapear sitio web
Recurso: Map & Search. Devuelve las URL encontradas en un sitio web sin extraer contenido. Qué hace:- Descubre enlaces de un sitio
- Devuelve una lista limpia de URL
- Rápido y ligero
- Descubrimiento de URL
- Generación de mapas de sitio
- Planificación de crawls más grandes
Extracción por Lotes de URLs
Recurso: Extracción de datos. Hace scraping de varias URLs en paralelo en un solo trabajo. Qué hace:- Procesa una lista de URLs de una sola vez, con las mismas opciones de extracción para cada una
- Es más eficiente que usar bucles
- Devuelve un ID de trabajo por lotes; agrega Obtener estado de Extracción por Lotes para leer todos los resultados a la vez
- Procesar listas de URLs
- Recopilación masiva de datos
- Proyectos de scraping a gran escala
Agente
Recurso: Agent. Utiliza un agente de IA para navegar de forma autónoma por sitios web y extraer datos a partir de un prompt en lenguaje natural. Qué hace:- Acepta un prompt que describe los datos que necesitas, además de URLs opcionales y un esquema JSON
- El agente de IA navega y extrae información de forma autónoma
- Disponible como Extract Data With AI Agent (espera los resultados) y Start AI Agent Job (Async) (devuelve un ID de trabajo de inmediato)
- Usa Get Agent Status para consultar los resultados cuando utilices la operación async
- Recopilación compleja de datos en varias páginas guiada por un prompt
- Extraer información cuando no conoces la estructura exacta de la página
- Tareas de investigación que requieren navegar por varias páginas
- Extract Data With AI Agent inicia el trabajo y espera el resultado en un solo paso, la opción más sencilla para la mayoría de los casos de uso. El parámetro Max Wait Time controla durante cuánto tiempo el nodo consulta el estado antes de agotar el tiempo de espera (predeterminado: 300 segundos; máximo: 600 segundos). Si la tarea del agente tarda más, el nodo devuelve un estado
timeoutcon eljobId, aunque el trabajo todavía pueda completarse en Firecrawl. Pasa ese ID a Get Agent Status o usa la operación async para trabajos que puedan superar los 10 minutos. - Start AI Agent Job (Async) devuelve un ID de trabajo de inmediato. Añade un segundo nodo de Firecrawl con la operación Get Agent Status para recuperar los resultados cuando finalice el trabajo.
Extraer datos estructurados (heredado)
Recurso: Extract (Legacy). Usa IA para extraer información estructurada de una lista de URL a partir de un prompt o un esquema, y con Get Extract Status puedes consultar los resultados. Este recurso llama al punto de conexión heredado/extract. Para nuevos flujos de trabajo, usa Agent o, si ya conoces la página, Scrape URL con el formato JSON.
Sandbox del navegador
Recurso: Browser. Proporciona una sesión persistente del navegador que puedes controlar mediante código, lo que permite automatizar el navegador en varios pasos dentro de una misma sesión. Operaciones:- Crear sesión del navegador: inicia una nueva sesión del navegador y devuelve su
id - Ejecutar código del navegador: ejecuta código Node (Playwright), Python o Bash en la sesión, usando el
iddel paso de creación como Session ID - Obtener varias sesiones del navegador: muestra las sesiones activas o eliminadas
- Eliminar sesión del navegador: finaliza una sesión cuando termines
- Obtener contexto del navegador: devuelve instrucciones de uso y las sesiones activas para los agentes de IA que llaman a estas operaciones como herramientas
- Flujos de trabajo del navegador de varios pasos que requieren mantener el estado entre páginas
- Navegación dinámica entre páginas cuando el número de pasos se desconoce de antemano
- Flujos de trabajo que usan perfiles persistentes del navegador para conservar las cookies y el localStorage entre ejecuciones
id de la sesión del paso de creación a cada paso posterior de ejecución o eliminación. Usa el nodo Loop Over Items de n8n para iterar sobre una lista dinámica de páginas y ejecutar código para cada una dentro de la misma sesión.
Para obtener más información sobre la función Sandbox del navegador, consulta la documentación del Sandbox del navegador.
Cuenta
Recurso: Account. Consulta el uso de créditos, el uso de tokens y el estado de la cola de tu equipo, de modo que un flujo de trabajo pueda comprobar los créditos restantes antes de ejecutar un trabajo de gran tamaño.Plantillas y ejemplos de flujos de trabajo
En lugar de empezar desde cero, puedes usar plantillas prediseñadas. La comunidad de n8n ha creado numerosos flujos de trabajo de Firecrawl que puedes copiar y personalizar.Plantillas destacadas
Tutorial completo de n8n
Crea un chatbot de IA con acceso a la web utilizando Firecrawl y n8n
8 flujos de trabajo en producción
Plantillas listas para usar para generar leads, supervisar precios y más
Pipeline RAG de Supabase pgvector
Haz scraping de páginas para generar embeddings y almacenarlos en Supabase pgvector para RAG
Enriquecimiento de leads con IA
Haz scraping de sitios web de empresas y extrae señales empresariales estructuradas
Pipeline RAG de Pinecone
Haz scraping de páginas para generar embeddings y almacenarlos en Pinecone para RAG
Flujos de trabajo de la comunidad de n8n
Explora cientos de flujos de trabajo que utilizan Firecrawl
Integración oficial de n8n
Consulta la documentación de la integración oficial
Cómo importar plantillas
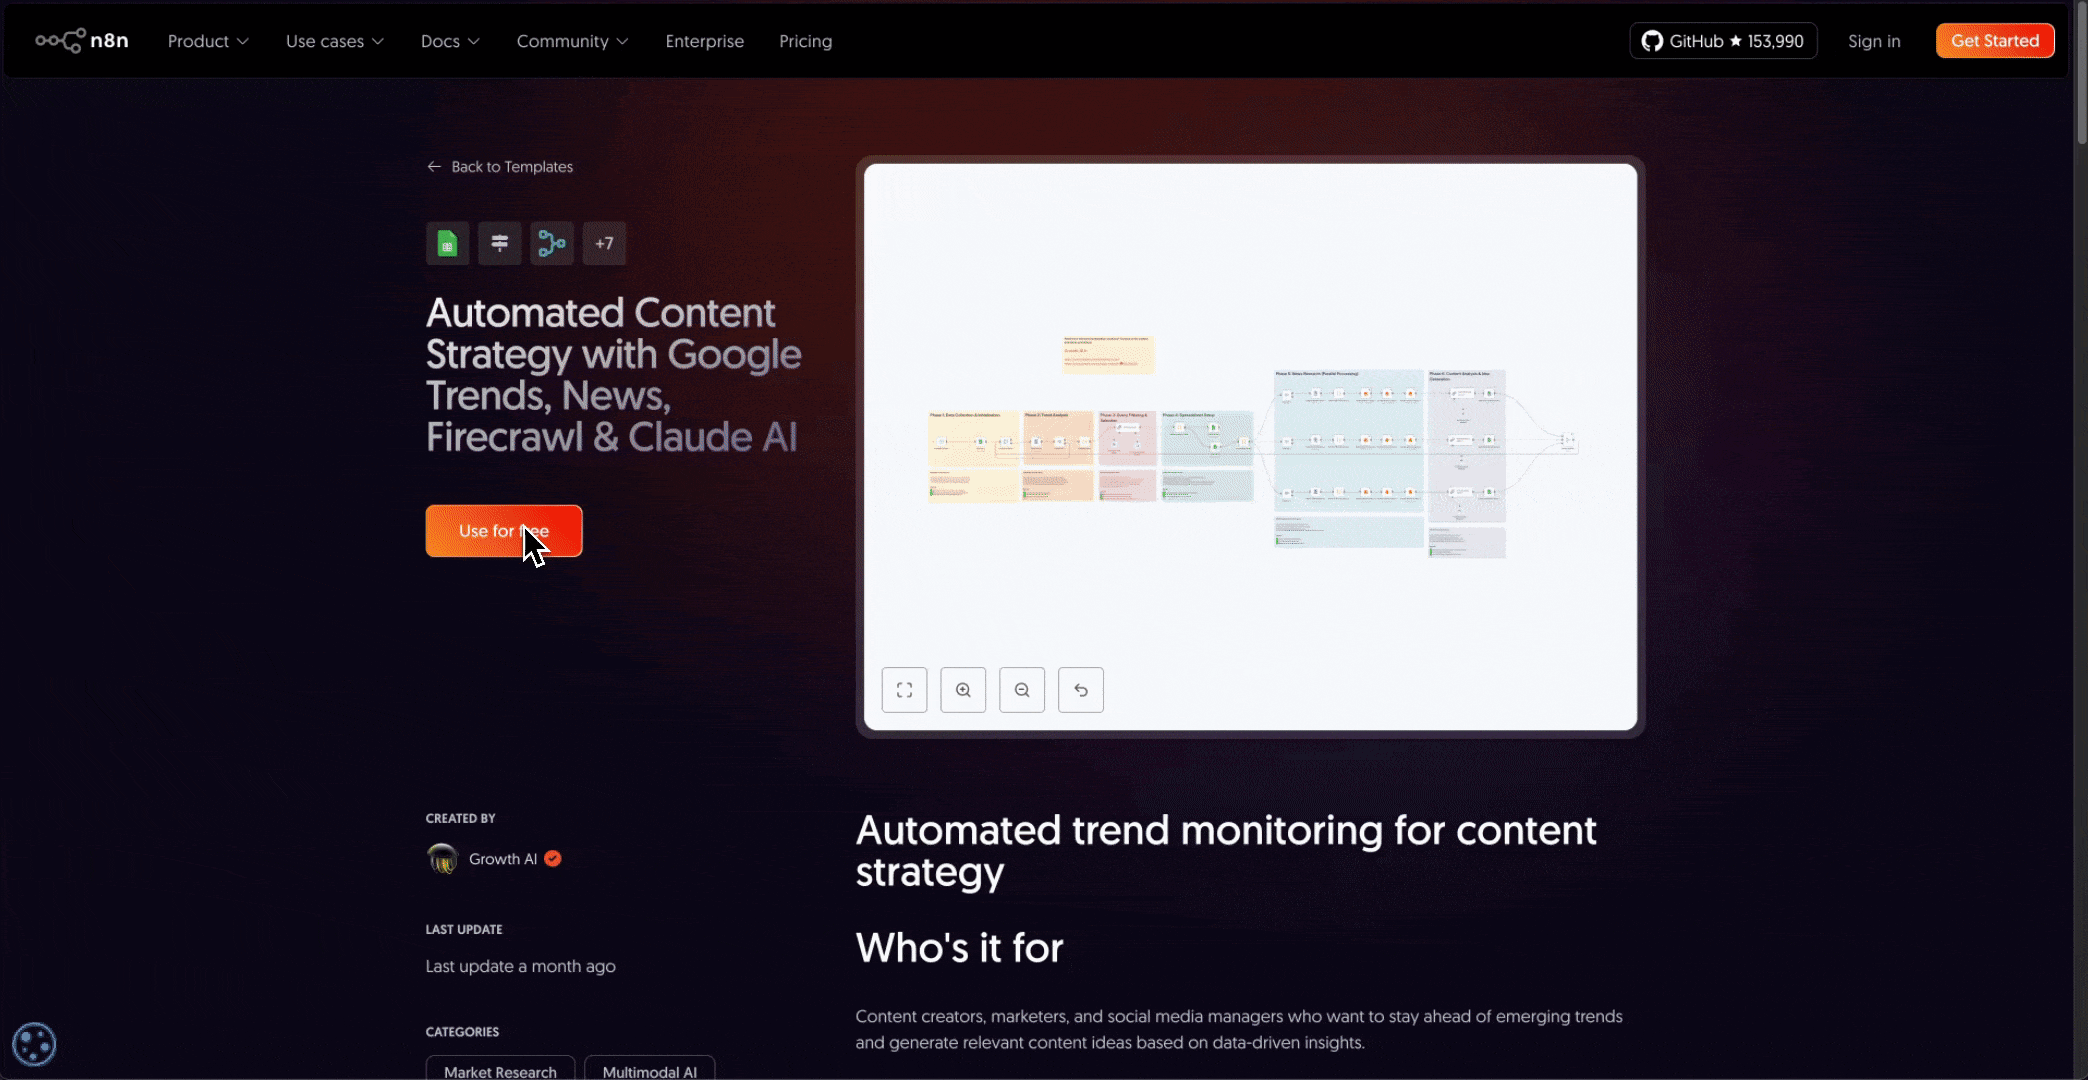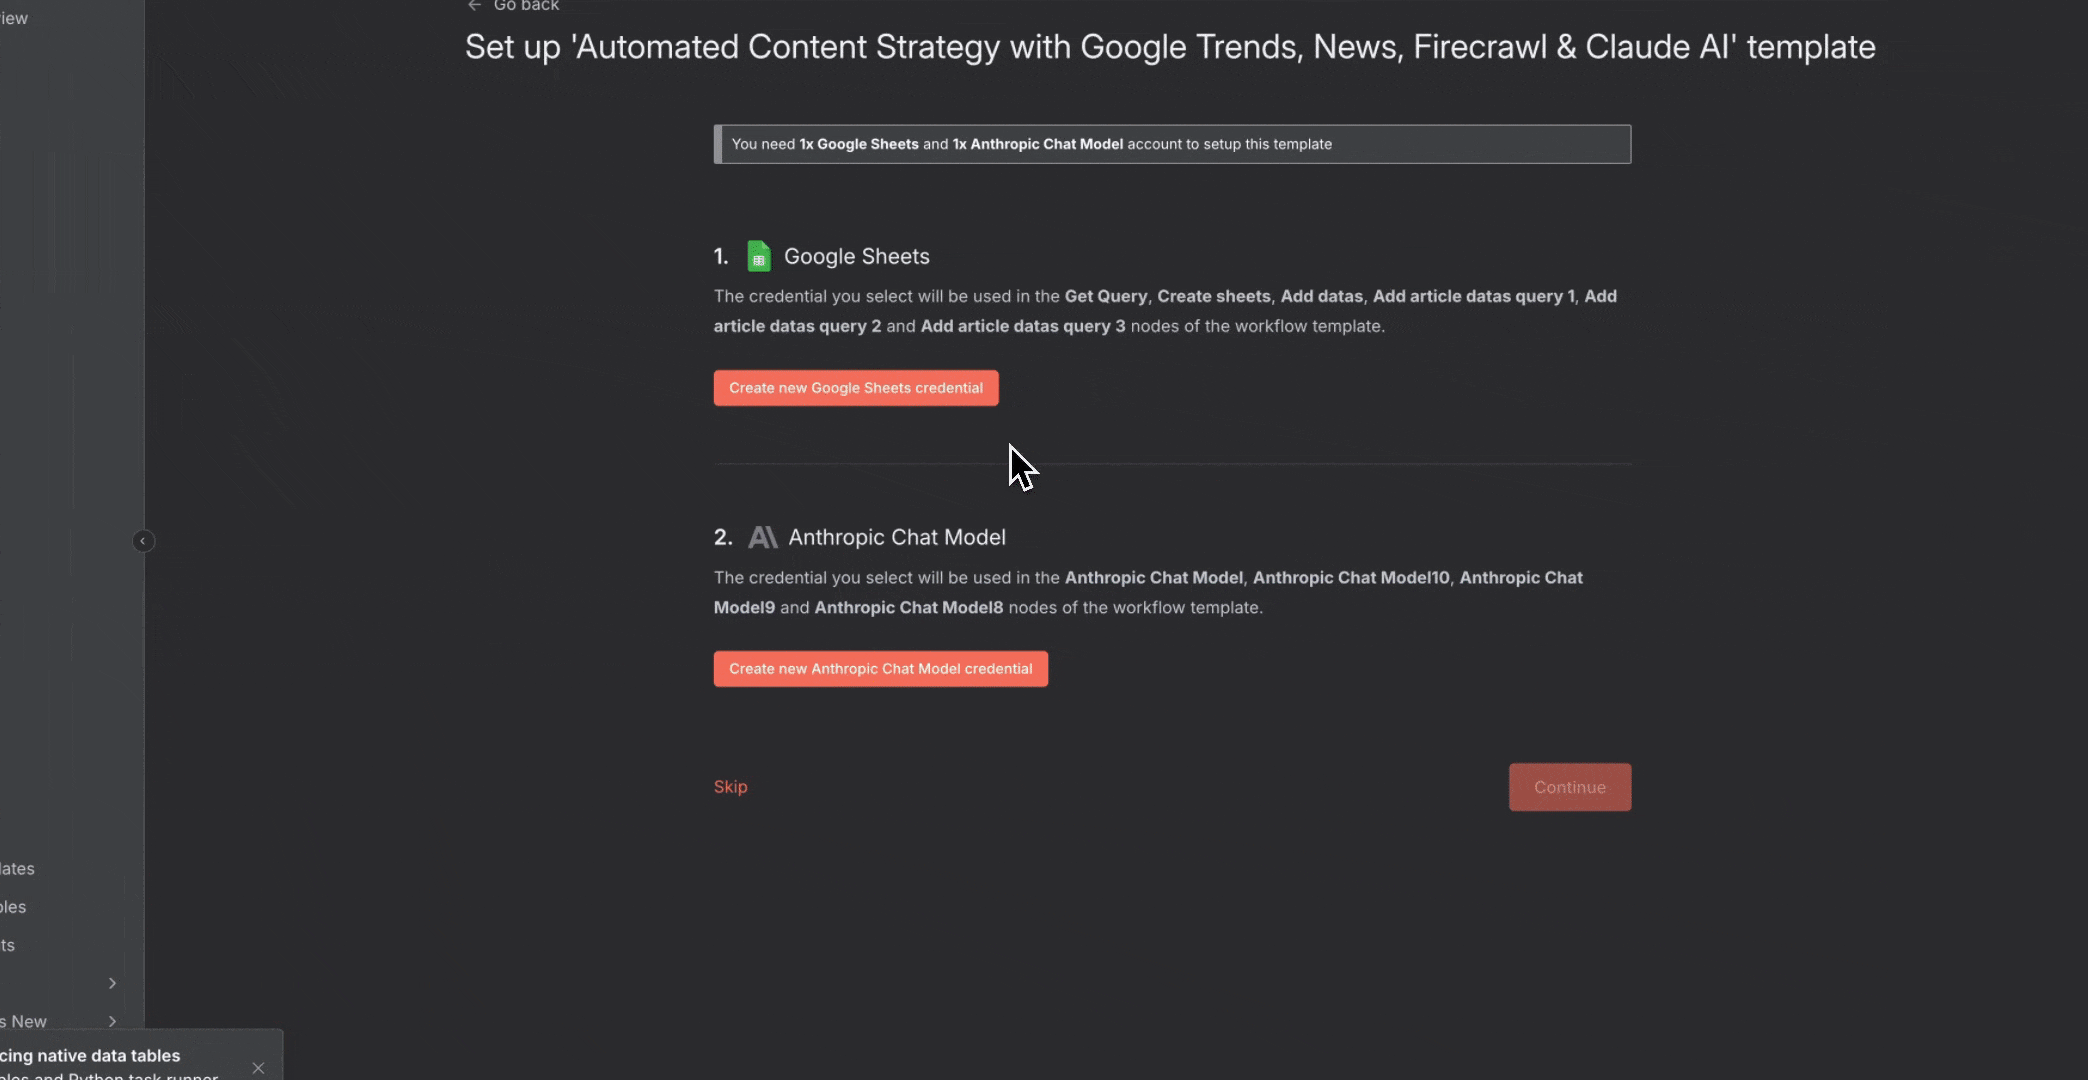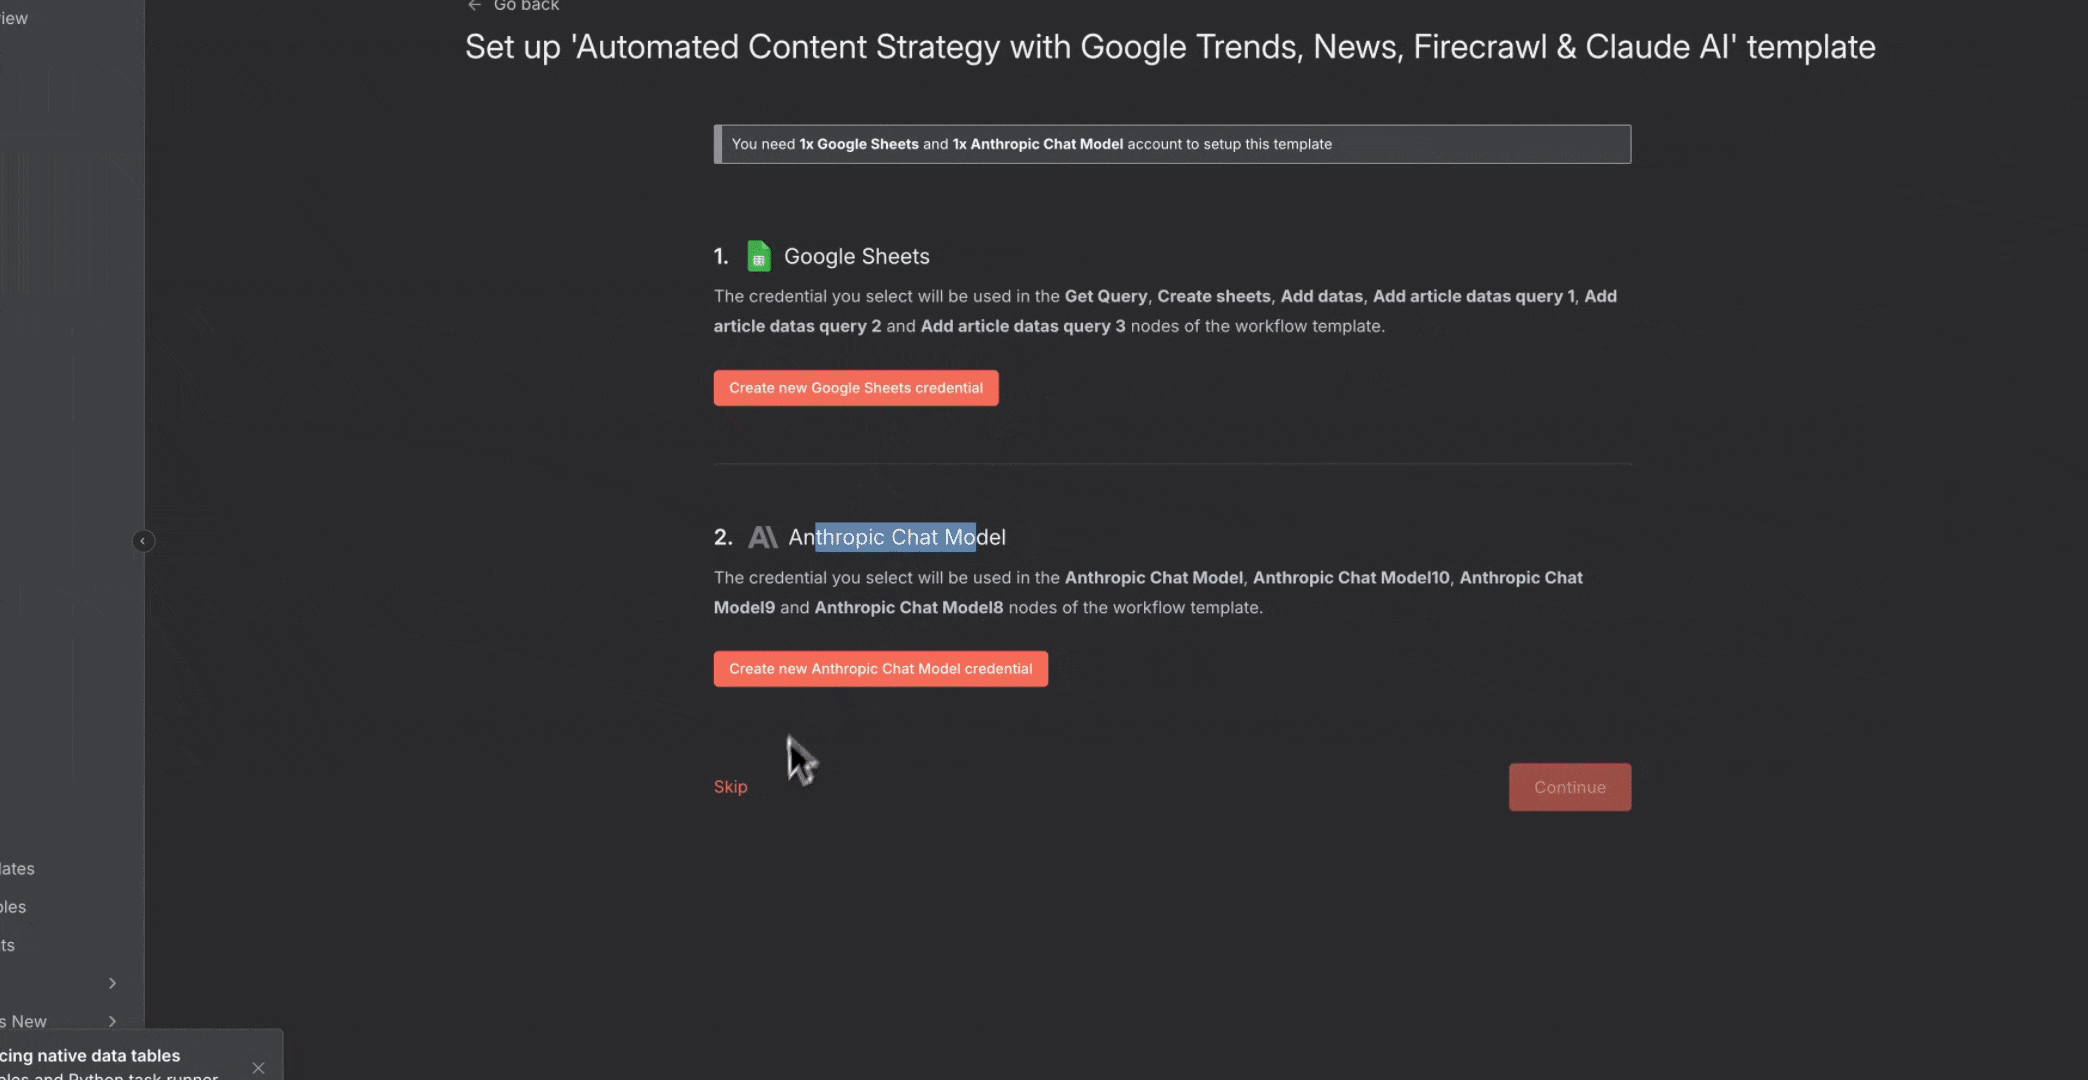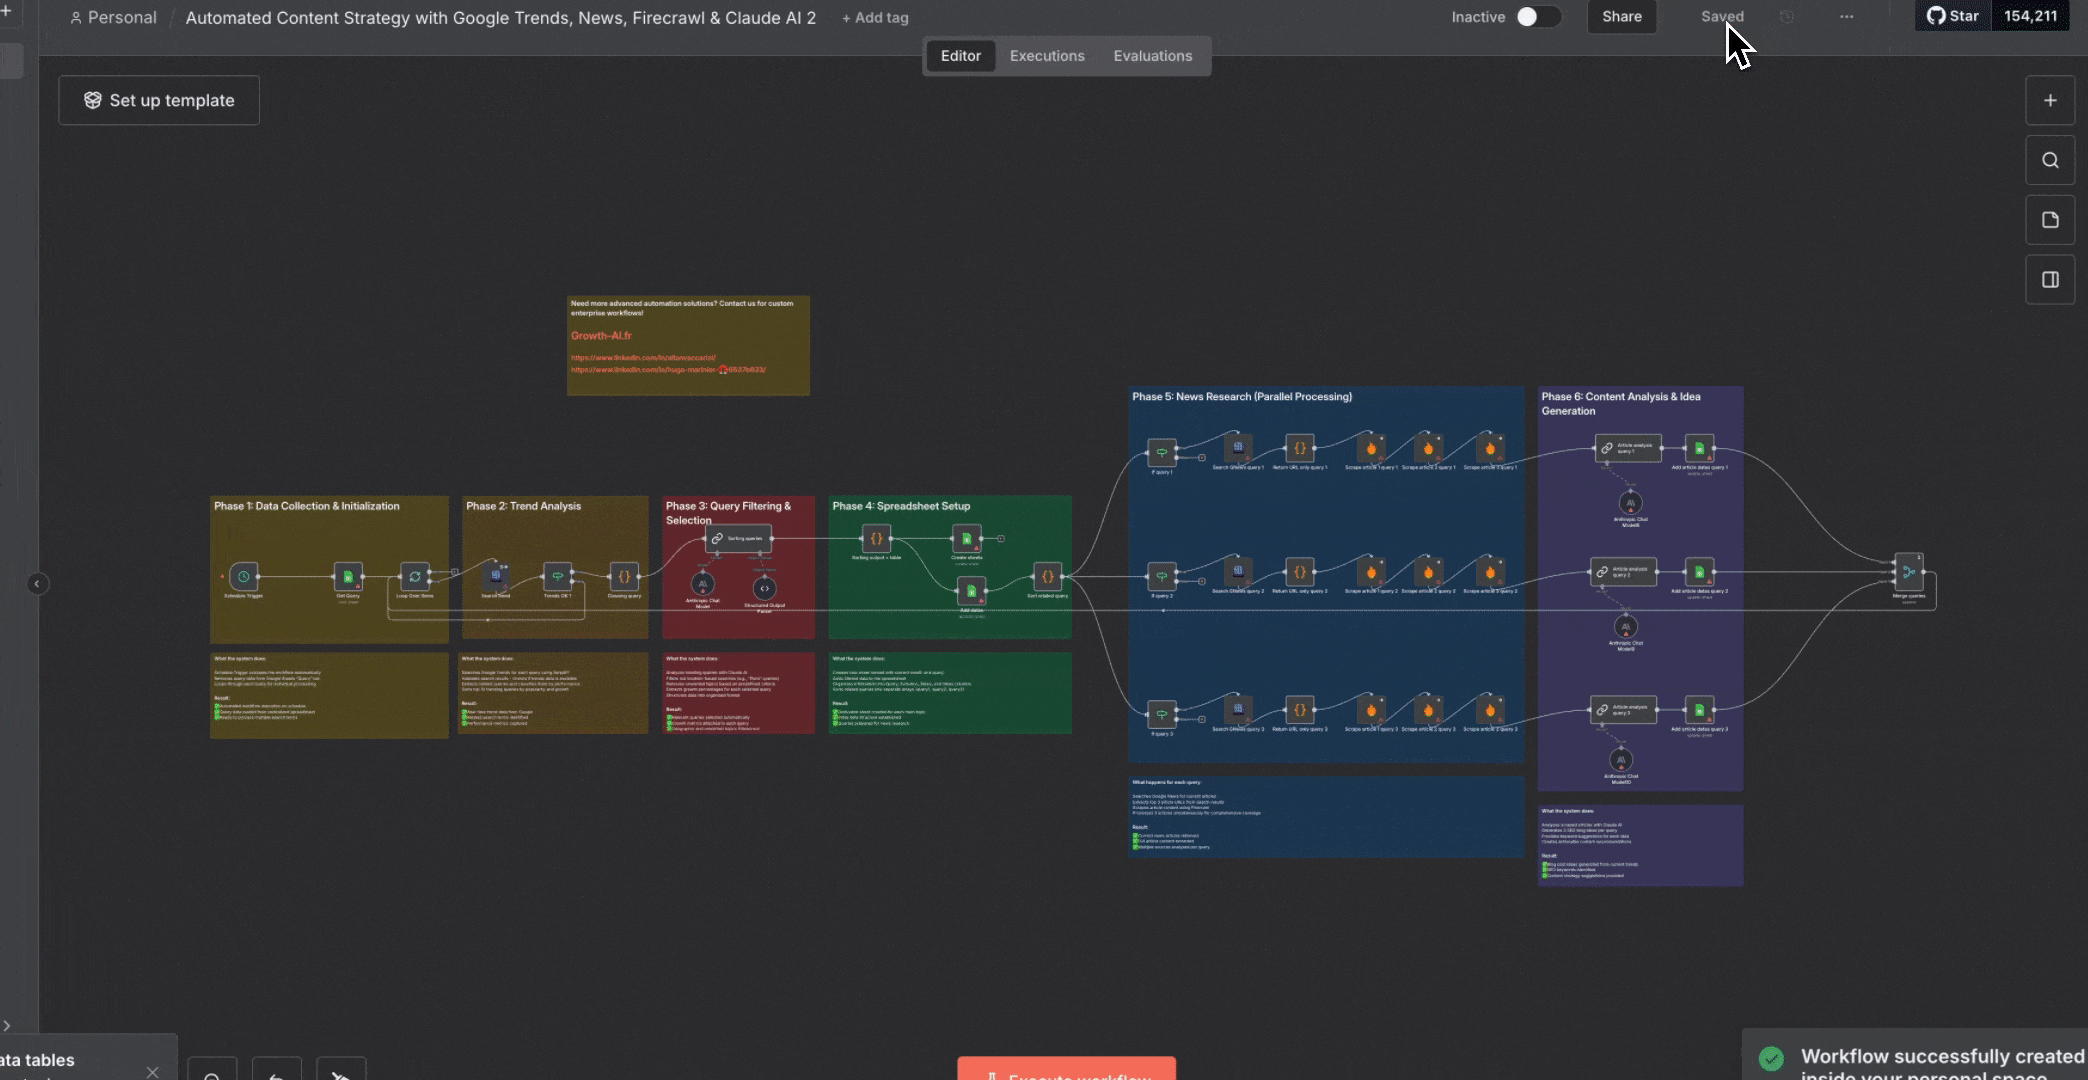
Para usar una plantilla de la comunidad de n8n:- Haz clic en el enlace de una plantilla de flujo de trabajo.
- En la página de la plantilla, haz clic en el botón “Importar plantilla a la instancia autogestionada localhost:5678”.
- El flujo de trabajo se abrirá en tu instancia de n8n.
- Configura las credenciales de cada nodo.
- Personaliza la configuración según tu caso de uso.
- Activa el flujo de trabajo.
Prácticas recomendadas
Sigue estas pautas para crear flujos de trabajo fiables y eficientes:Pruebas y depuración
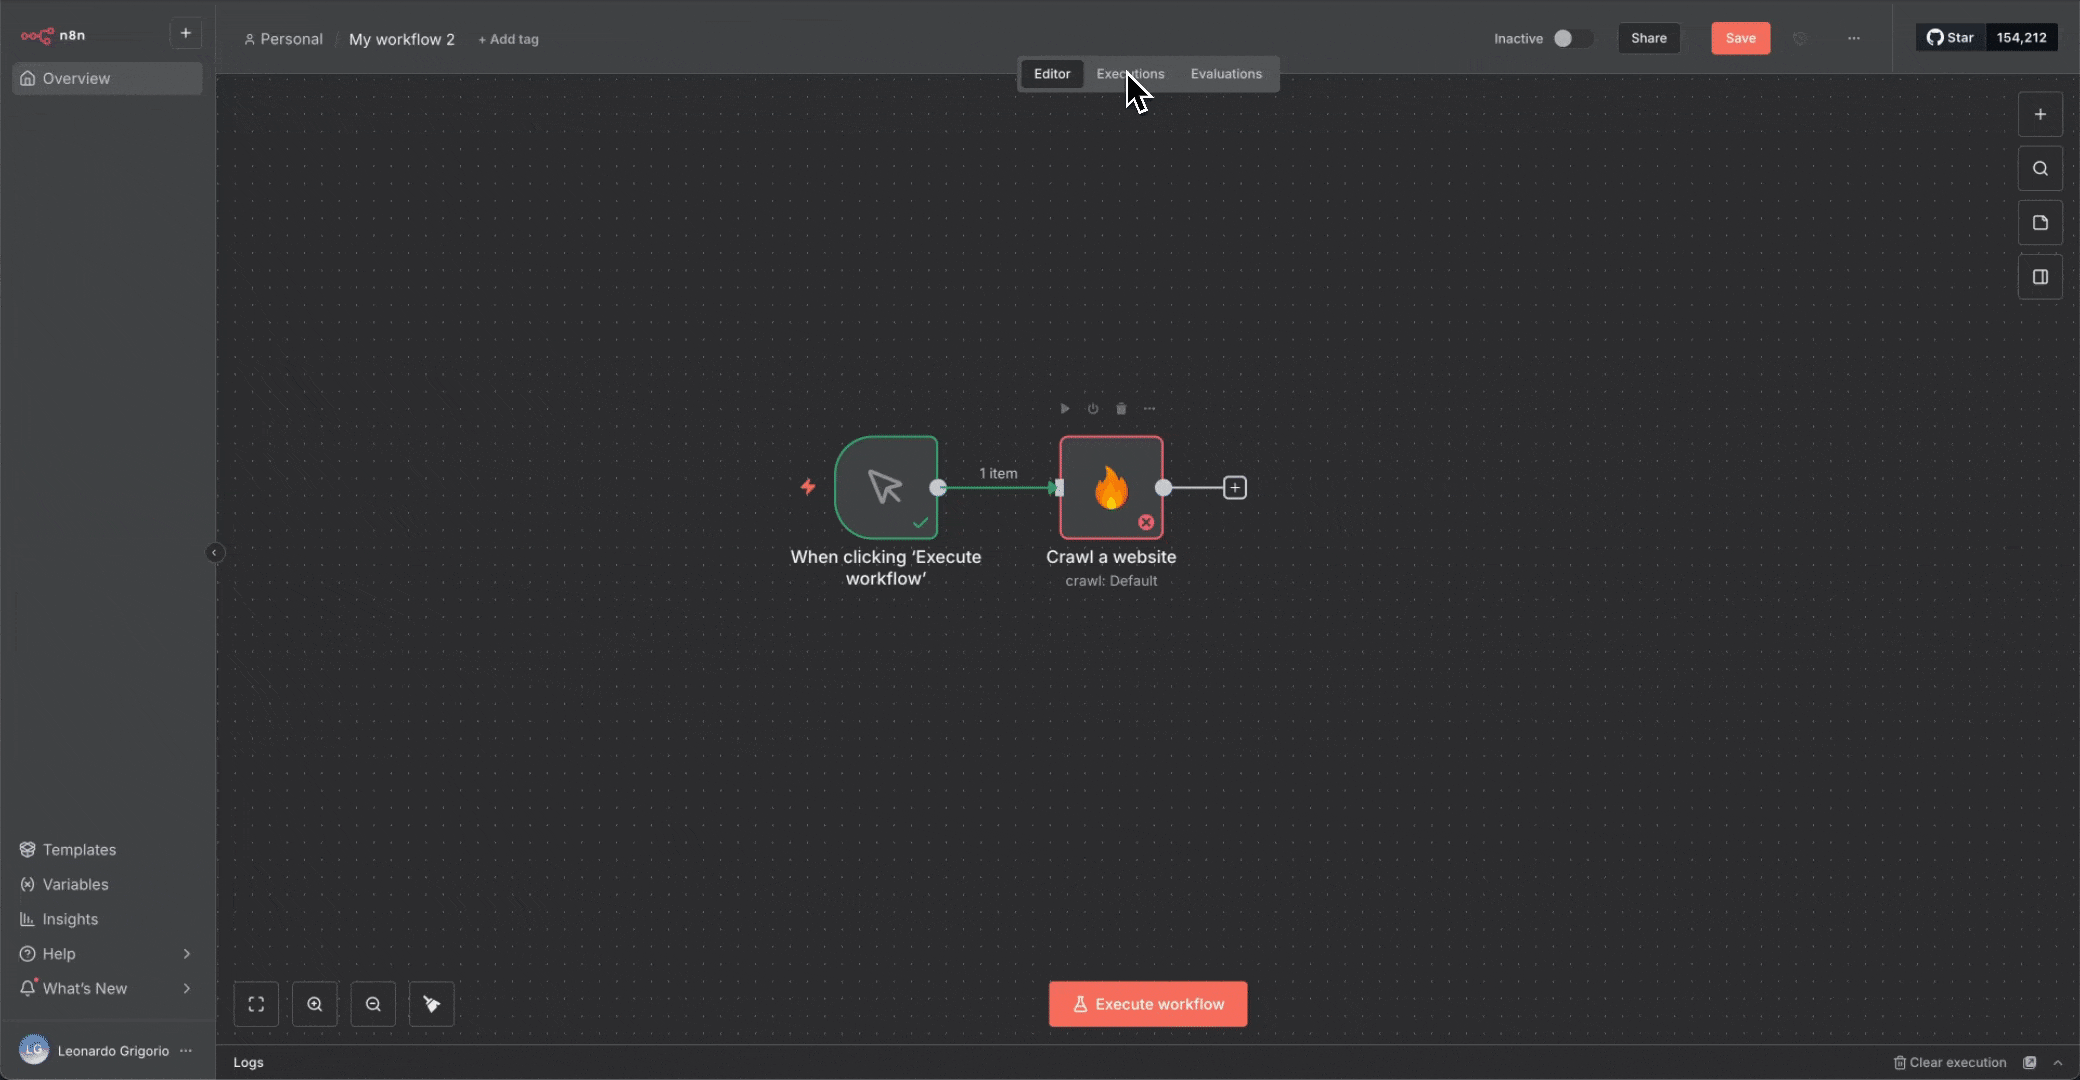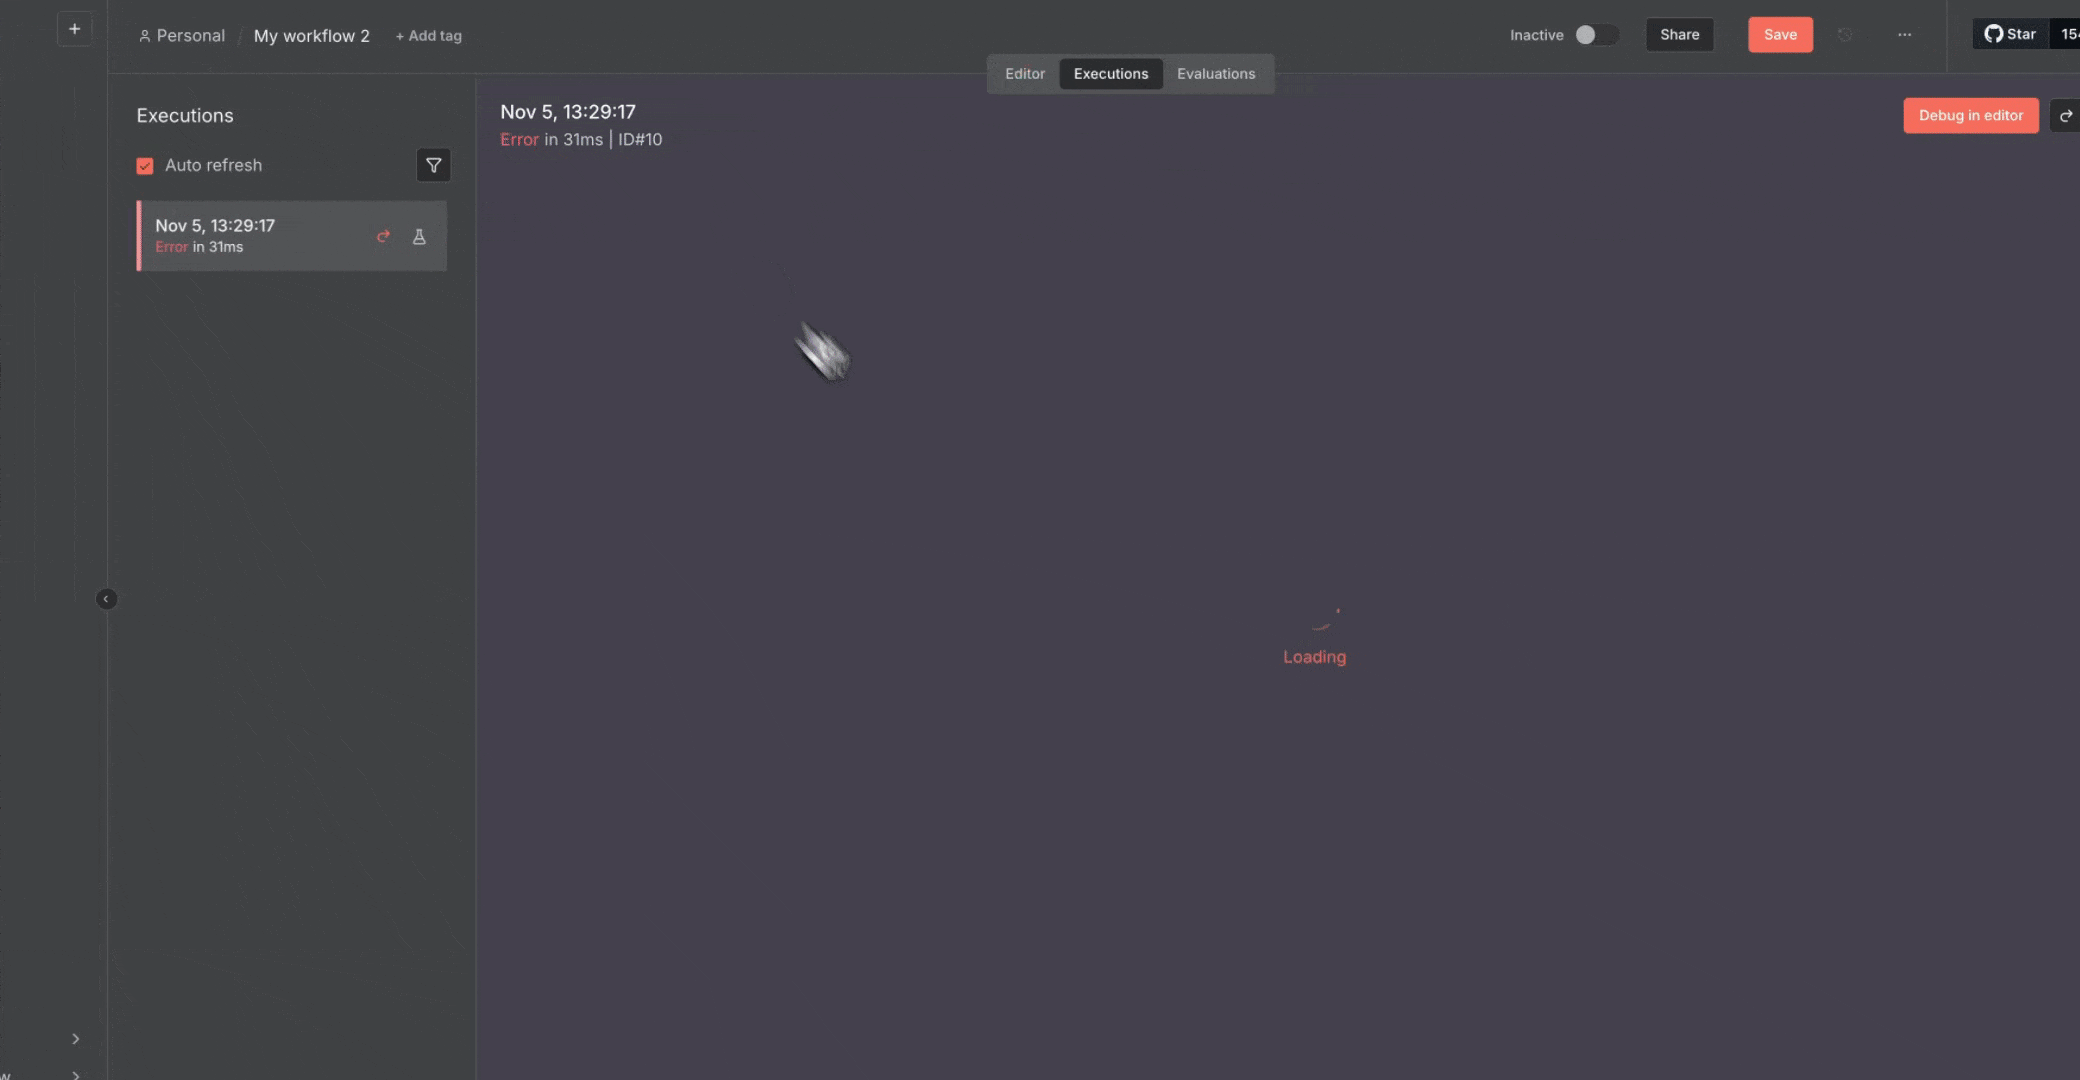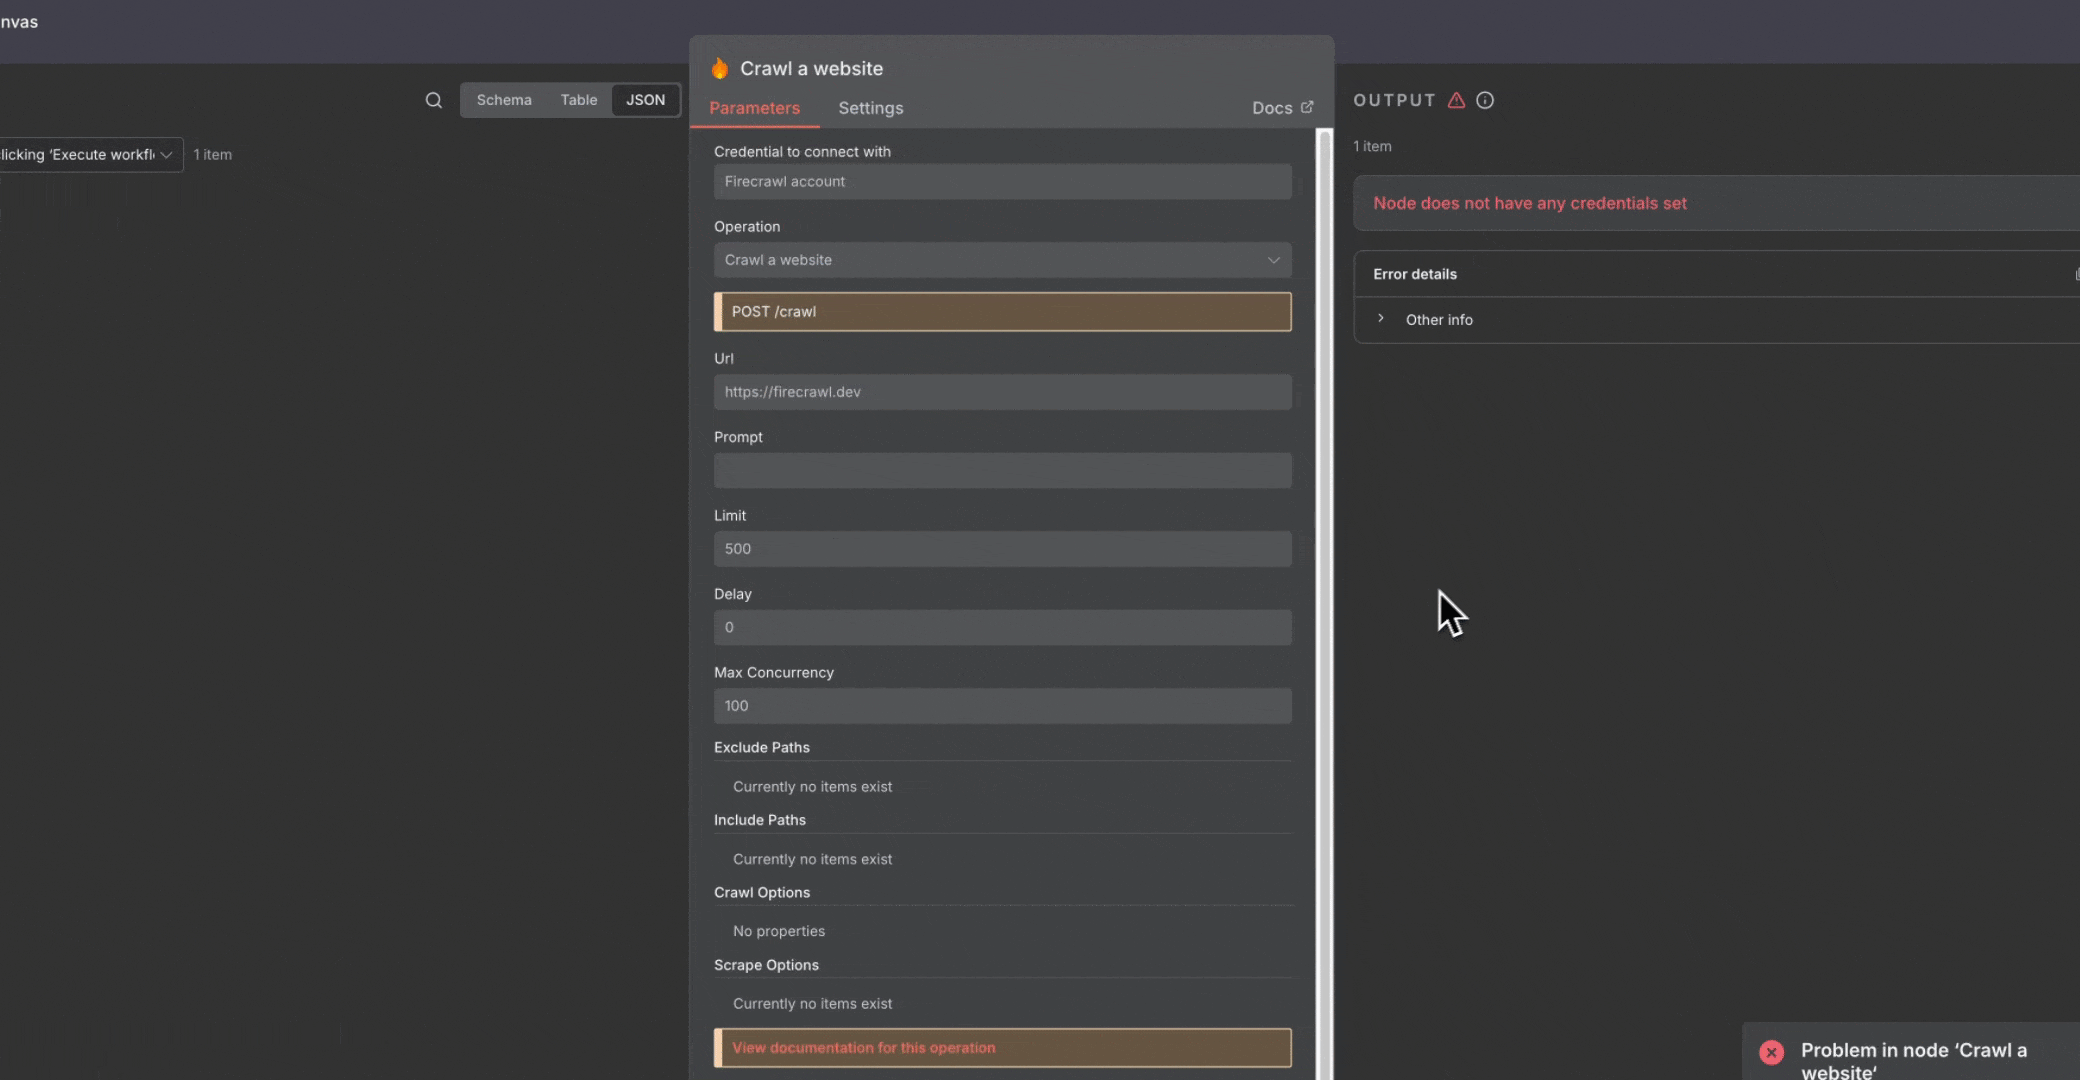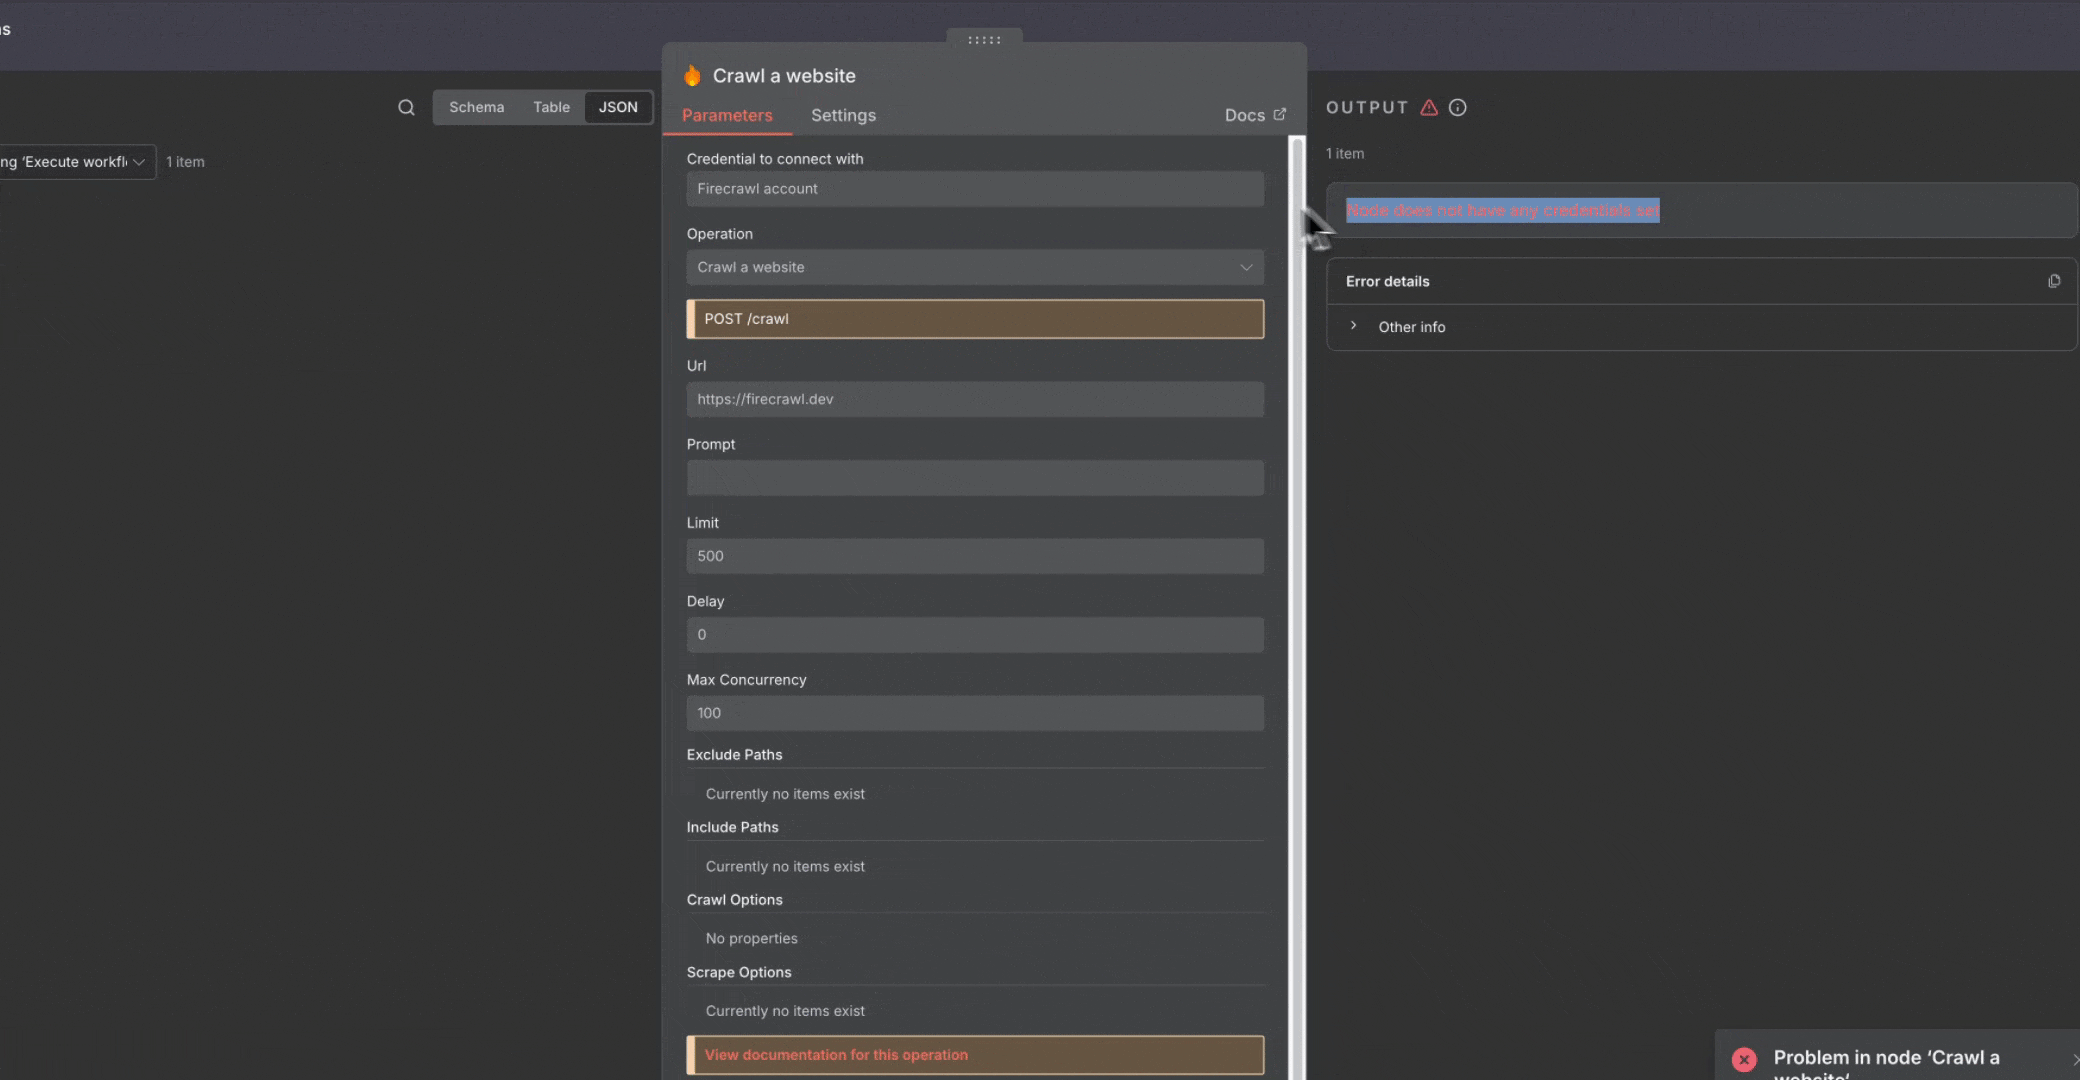
- Prueba siempre los flujos de trabajo manualmente antes de activar las programaciones
- Usa el botón “ejecutar flujo de trabajo” para probar todo el flujo
- Comprueba los datos de salida en cada nodo para verificar que sean correctos
- Usa la pestaña “Executions” para revisar ejecuciones anteriores y depurar problemas
Manejo de errores
- Añade nodos Error Trigger para detectar y gestionar fallos
- Configura notificaciones cuando fallen los flujos de trabajo
- Usa la configuración “Continue On Fail” en nodos no críticos
- Supervisa periódicamente las ejecuciones de tus flujos de trabajo
Optimización del rendimiento
- Usa extracción por lotes para varias URL en lugar de bucles
- Establece límites de tasa adecuados para evitar sobrecargar los sitios de destino
- Almacena los datos en caché cuando sea posible para reducir solicitudes innecesarias
- Programa flujos de trabajo intensivos durante las horas de menor actividad
Seguridad
- Nunca expongas las claves de API en las configuraciones de los flujos de trabajo
- Usa el sistema de credenciales de n8n para almacenar de forma segura la información de autenticación
- Ten cuidado al compartir flujos de trabajo públicamente
- Respeta los términos de servicio y el archivo robots.txt de los sitios web objetivo
Próximos pasos
Ahora tienes los fundamentos para crear automatizaciones de scraping web con Firecrawl y n8n. A continuación, te indicamos cómo seguir aprendiendo:Explora funciones avanzadas
- Consulta las configuraciones de webhook para procesar datos en tiempo real
- Experimenta con la extracción basada en IA mediante prompts y schemas
- Crea flujos de trabajo complejos de varios pasos con lógica condicional
Únete a la comunidad
- Firecrawl Discord - Obtén ayuda con Firecrawl y conversa sobre web scraping
- Foro de la comunidad de n8n - Haz preguntas sobre automatización de flujos de trabajo
- Comparte tus flujos de trabajo y aprende de los demás
Ruta de aprendizaje recomendada
- Completa los flujos de trabajo de ejemplo de esta guía
- Modifica las plantillas de la biblioteca de la comunidad
- Crea un flujo de trabajo para resolver un problema real en tu trabajo
- Explora las operaciones avanzadas de Firecrawl
- Comparte tus propias plantillas para ayudar a otras personas
¿Necesitas ayuda? Si te atascas o tienes dudas, las comunidades de Firecrawl y n8n son activas y están dispuestas a ayudar. No dudes en pedir orientación mientras creas tus automatizaciones.