

Sincroniza datos web en flujos de trabajo de Langflow
Instalación del paquete de Firecrawl
Los bloques de Firecrawl se incluyen en el paquetelfx-firecrawl, que no forma parte de la instalación predeterminada de Langflow. Instálalo en el mismo entorno que Langflow y, después, reinicia Langflow:
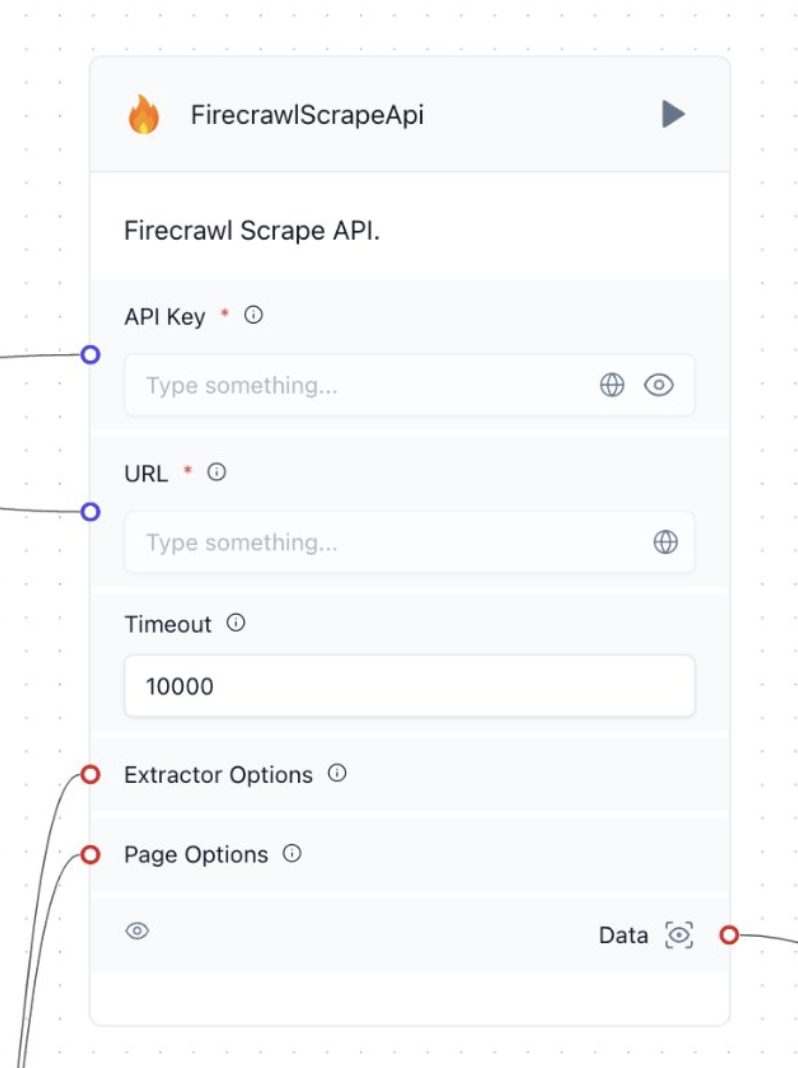
Data. Consulta la documentación del paquete de Firecrawl para Langflow para ver la lista completa de parámetros.
Scraping con bloques de Firecrawl
- Inicia sesión en tu cuenta de Firecrawl y obtén tu clave de API; luego ingrésala en el bloque o pásala desde otra parte del flujo de trabajo.
- Agrega el bloque Firecrawl Scrape API para capturar una sola página.
- Ingresa la URL de destino a extraer o pásala desde otra parte del flujo de trabajo.
- Configura las opciones de extracción según el sitio web y los datos que necesitas, como los formatos de salida y si se debe devolver solo el contenido principal. También puedes pasarlas desde otra parte del flujo de trabajo.
- (Opcional) Configura las Opciones del Extractor para obtener JSON estructurado de la página.
- Usa los datos en tus flujos de trabajo.
Rastreo, mapeo y búsqueda
- Firecrawl Crawl API rastrea una URL y sus subpáginas. Define los límites y las rutas en Crawler Options (opciones del rastreador) y la configuración per-page en Scrape Options (opciones de extracción).
- Firecrawl Map API devuelve las URL de uno o varios sitios.
- Firecrawl Search API busca en la web a partir de una query, con un Limit de resultados y una Location (ubicación) opcionales.