

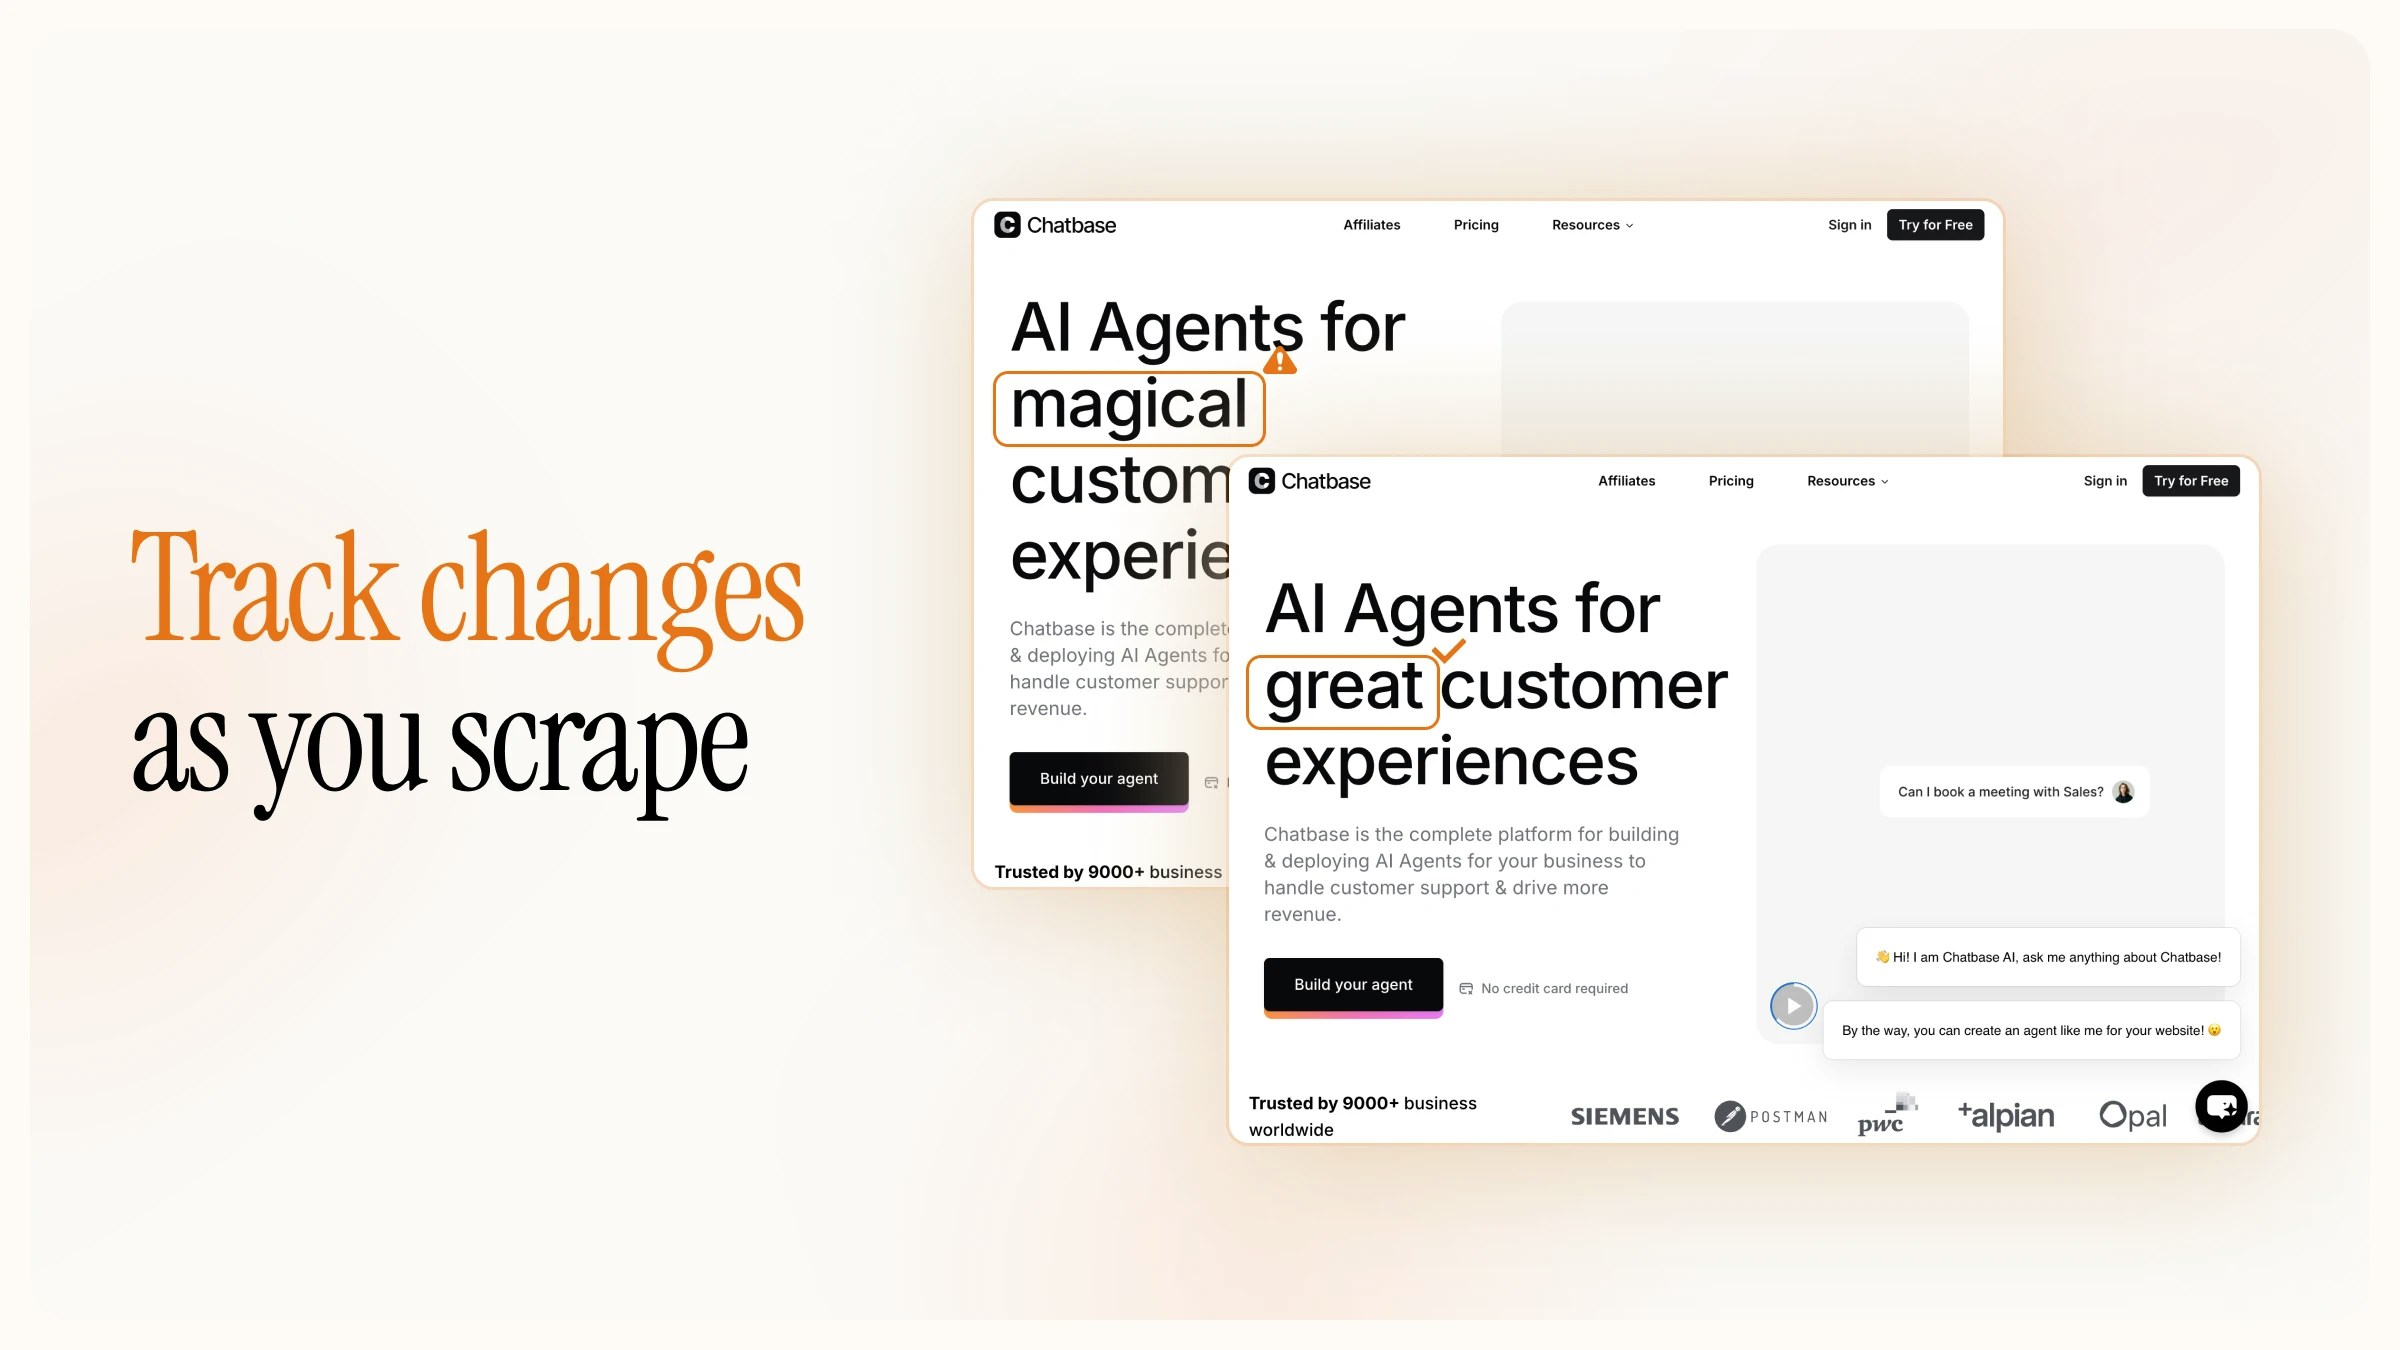
changeTracking ao seu array de formats para detectar se uma página é nova, inalterada ou modificada e, opcionalmente, obter um diff estruturado do que mudou.
- Funciona com
/scrape,/crawle/batch/scrape - Dois modos de diff:
git-diffpara mudanças em nível de linha ejsonpara comparação em nível de campo - Restrito à sua equipe e, opcionalmente, a uma tag que você especificar
/scrape por conta própria em intervalos regulares.
Como funciona
Cada scrape comchangeTracking habilitado armazena um snapshot e o compara com o snapshot anterior para essa URL. Snapshots são armazenados de forma persistente e não expiram, por isso as comparações permanecem precisas, independentemente de quanto tempo se passou entre os scrapes.
A resposta inclui estes campos no objeto
changeTracking:
Uso básico
Inclua tantomarkdown quanto changeTracking no array formats. O formato markdown é obrigatório porque o rastreio de mudanças compara as páginas com base no conteúdo em markdown.
Resposta
No primeiro scrape,changeStatus é "new" e previousScrapeAt é null:
changeStatus indica se o conteúdo foi alterado:
Modo git-diff
O modogit-diff retorna alterações linha a linha em um formato semelhante ao git diff. Passe um objeto no array formats com modes: ["git-diff"]:
Resposta
O objetodiff contém um diff em texto simples e uma representação JSON estruturada:
diff.json contém:
files: array de arquivos modificados (geralmente um por página da web)chunks: seções de alterações dentro de um arquivochanges: alterações individuais de linha comtype("add","del"ou"normal"), número da linha (ln) econtent
Modo JSON
json extrai campos específicos tanto da versão atual quanto da versão anterior da página usando um schema que você define. Isso é útil para acompanhar mudanças em dados estruturados, como preços, níveis de estoque ou metadados, sem precisar analisar um diff completo.
Passe modes: ["json"] com um schema definindo os campos a serem extraídos:
Resposta
Cada campo do schema é retornado com os valoresprevious e current:
prompt opcional para orientar a extração do LLM em conjunto com o schema.
O modo JSON usa extração com LLM e custa 5 créditos por página. O rastreamento básico de alterações e o modo
git-diff não têm custo adicional.Usando tags
Por padrão, o rastreamento de mudanças compara com a raspagem mais recente da mesma URL feita pela sua equipe. Tags permitem que você mantenha históricos de rastreamento separados para a mesma URL, o que é útil quando você monitora a mesma página em intervalos diferentes ou em contextos distintos.Crawl com rastreio de mudanças
Adicione rastreio de mudanças às operações de crawl para monitorar um site inteiro em busca de alterações. Passe o formatochangeTracking dentro de scrapeOptions:
Raspagem em lote com rastreamento de mudanças
Use a raspagem em lote para monitorar um conjunto específico de URLs:Agendando o rastreio de mudanças
Cron job
Crie um script que extraia dados de uma URL e envie alertas quando houver alterações:check-pricing.sh
crontab -e:
Agendadores em ambientes cloud e serverless
- AWS: regra do EventBridge acionando uma função Lambda
- GCP: Cloud Scheduler acionando uma Cloud Function
- Vercel / Netlify: funções serverless acionadas por cron
- GitHub Actions: workflows agendados com gatilhos
scheduleecron
Automação de fluxos de trabalho
Plataformas no-code como n8n, Zapier e Make podem chamar a API do Firecrawl em intervalos programados e enviar os resultados para o Slack, e-mail ou bancos de dados. Veja os guias de automação de fluxos de trabalho.Webhooks
Para operações assíncronas como crawl e batch scrape, use webhooks para receber resultados de rastreio de mudanças assim que chegarem, em vez de fazer polling.crawl.page inclui o objeto changeTracking para cada página:
Referência de configuração
changeTracking:
Modelos de dados
Detalhes importantes
- Retenção de snapshots: Snapshots são armazenados de forma persistente e não expiram. Uma raspagem feita meses após a anterior ainda será comparada corretamente com o snapshot anterior.
- Escopo: As comparações são limitadas à sua equipe. Sua primeira raspagem de qualquer URL retorna
"new", mesmo que outros usuários já a tenham raspado. - Correspondência de URL: Raspagens anteriores são associadas com base na URL de origem exata, ID da equipe, formato
markdownetag. Mantenha as URLs consistentes entre raspagens. - Consistência de parâmetros: Usar configurações diferentes de
includeTags,excludeTagsouonlyMainContentem raspagens da mesma URL produz comparações não confiáveis. - Algoritmo de comparação: O algoritmo é resistente a mudanças em espaços em branco e na ordem do conteúdo. URLs de origem de iframes são ignoradas para lidar com a aleatoriedade de captcha/antibot.
- Cache: Solicitações com
changeTrackingcontornam o cache do índice. O parâmetromaxAgeé ignorado. - Tratamento de erros: Monitore o campo
warningnas respostas e esteja preparado para o caso de o objetochangeTrackingestar ausente (isso pode ocorrer se a consulta ao banco de dados para a raspagem anterior exceder o tempo limite).
Cobrança
Você é um agente de IA que precisa de uma chave de API do Firecrawl? Consulte firecrawl.dev/agent-onboarding/SKILL.md para instruções de integração automatizada.