

Firecrawl と n8n の概要
Firecrawl は AI エージェントのためのコンテキスト API です。Firecrawlノードを使えば、Search、Scrape、Crawl、Map、Interact、Agent を n8n のワークフローに組み込めます。価格の監視、コンテンツの集約、見込み顧客の獲得、AI エージェントへのクリーンなコンテキストの供給などを、コードを書かずに実現できます。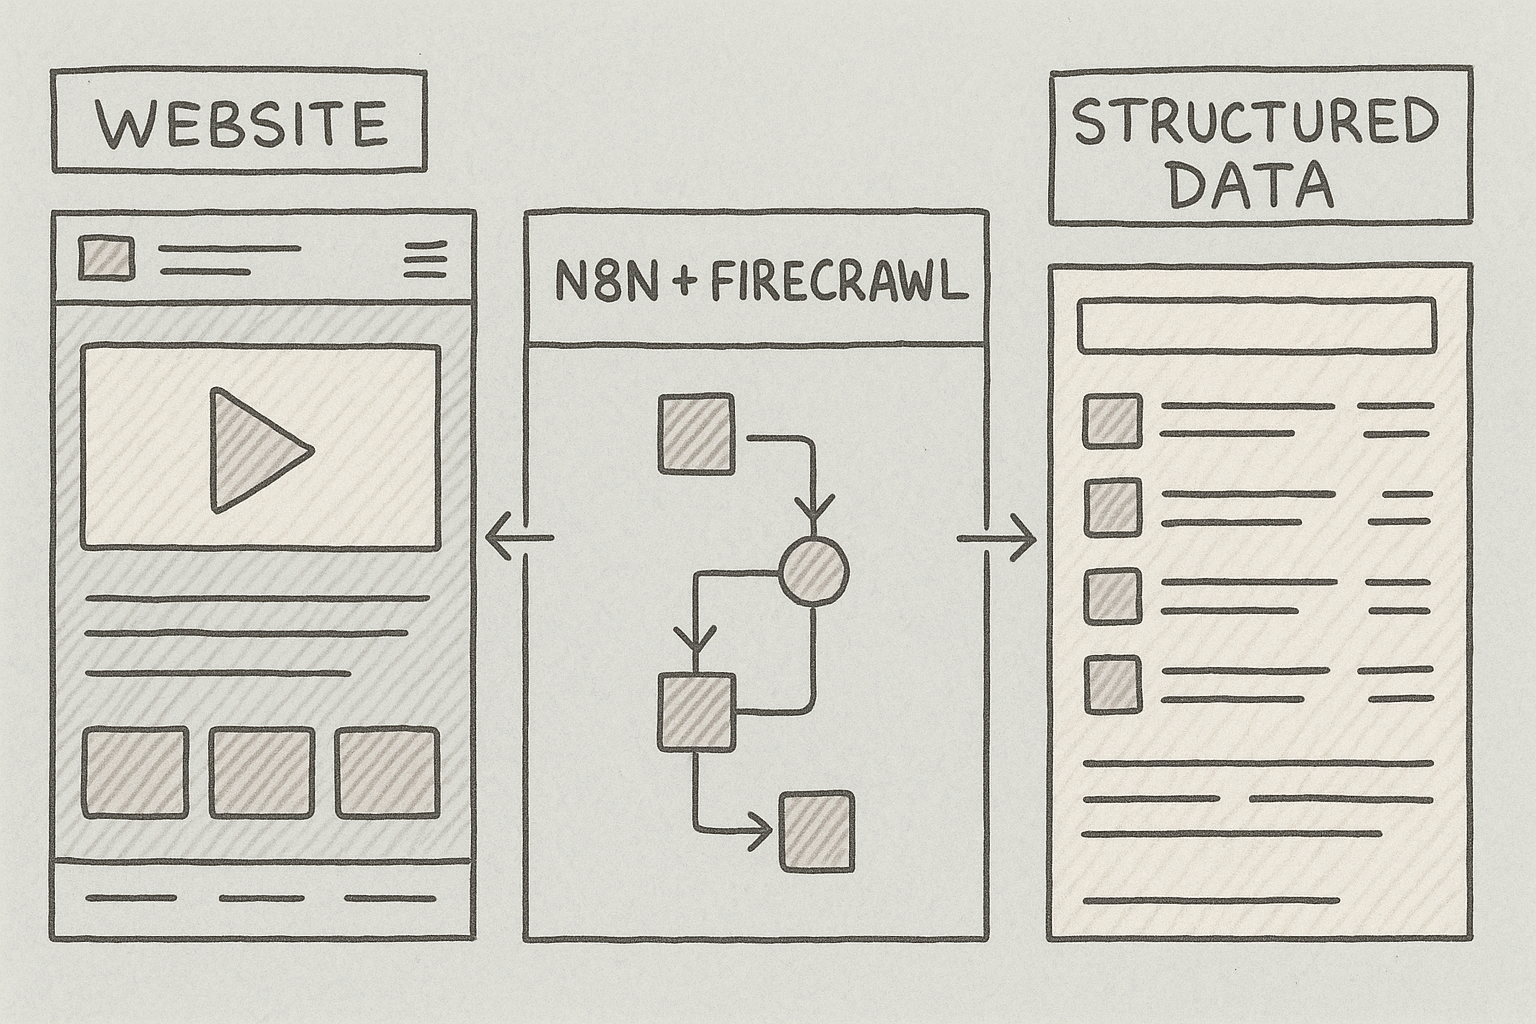
n8n で Firecrawl を使用する理由
従来の Web スクレイピングには、いくつかの課題があります。Web サイトの構造が更新されると、カスタムスクリプトは動作しなくなります。JavaScript を多用する複雑なサイトは適切にレンダリングされません。インフラストラクチャにも継続的なメンテナンスが必要です。 Firecrawl はスクレイピングに伴うこうした技術的な複雑さを処理し、n8n は自動化のためのフレームワークを提供します。両者を組み合わせることで、次のような本番環境対応のワークフローを構築できます。- あらゆる Web サイトからデータを確実に抽出
- スクレイピングしたデータを他の業務ツールに連携
- スケジュールまたはイベントをトリガーに実行
- シンプルなタスクから複雑なパイプラインまで拡張
ステップ1:Firecrawl アカウントを作成する
Firecrawl は、AIエージェントやワークフローに検索、スクレイピング、ブラウザ操作の機能を提供します。アカウントを設定し、API認証情報を取得しましょう。Firecrawl に登録する
- ウェブブラウザで firecrawl.dev にアクセスします
- 「Get Started」または「Sign Up」ボタンをクリックします
- メールアドレスまたは GitHub アカウントでアカウントを作成します
- 求められた場合は、メールアドレスを確認します
APIキーを取得する
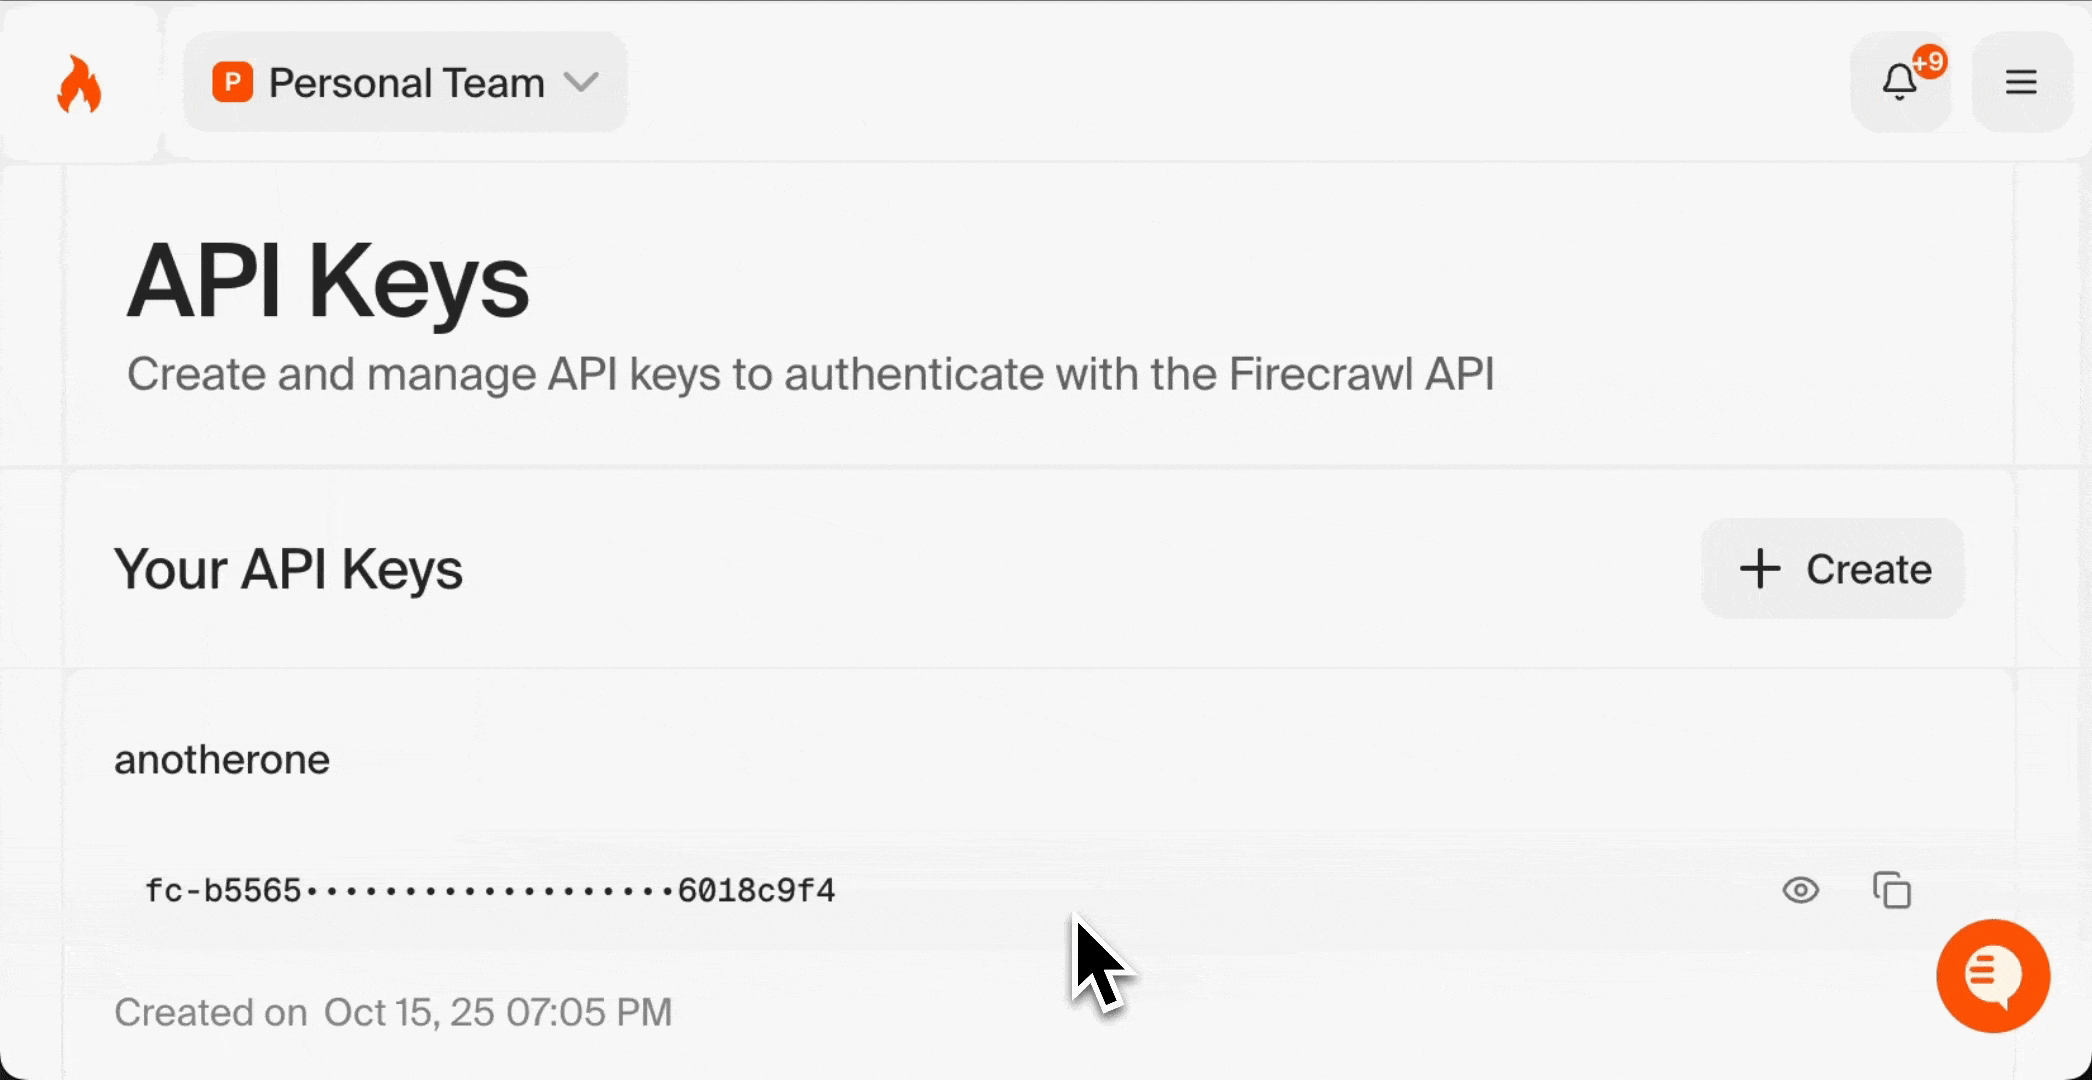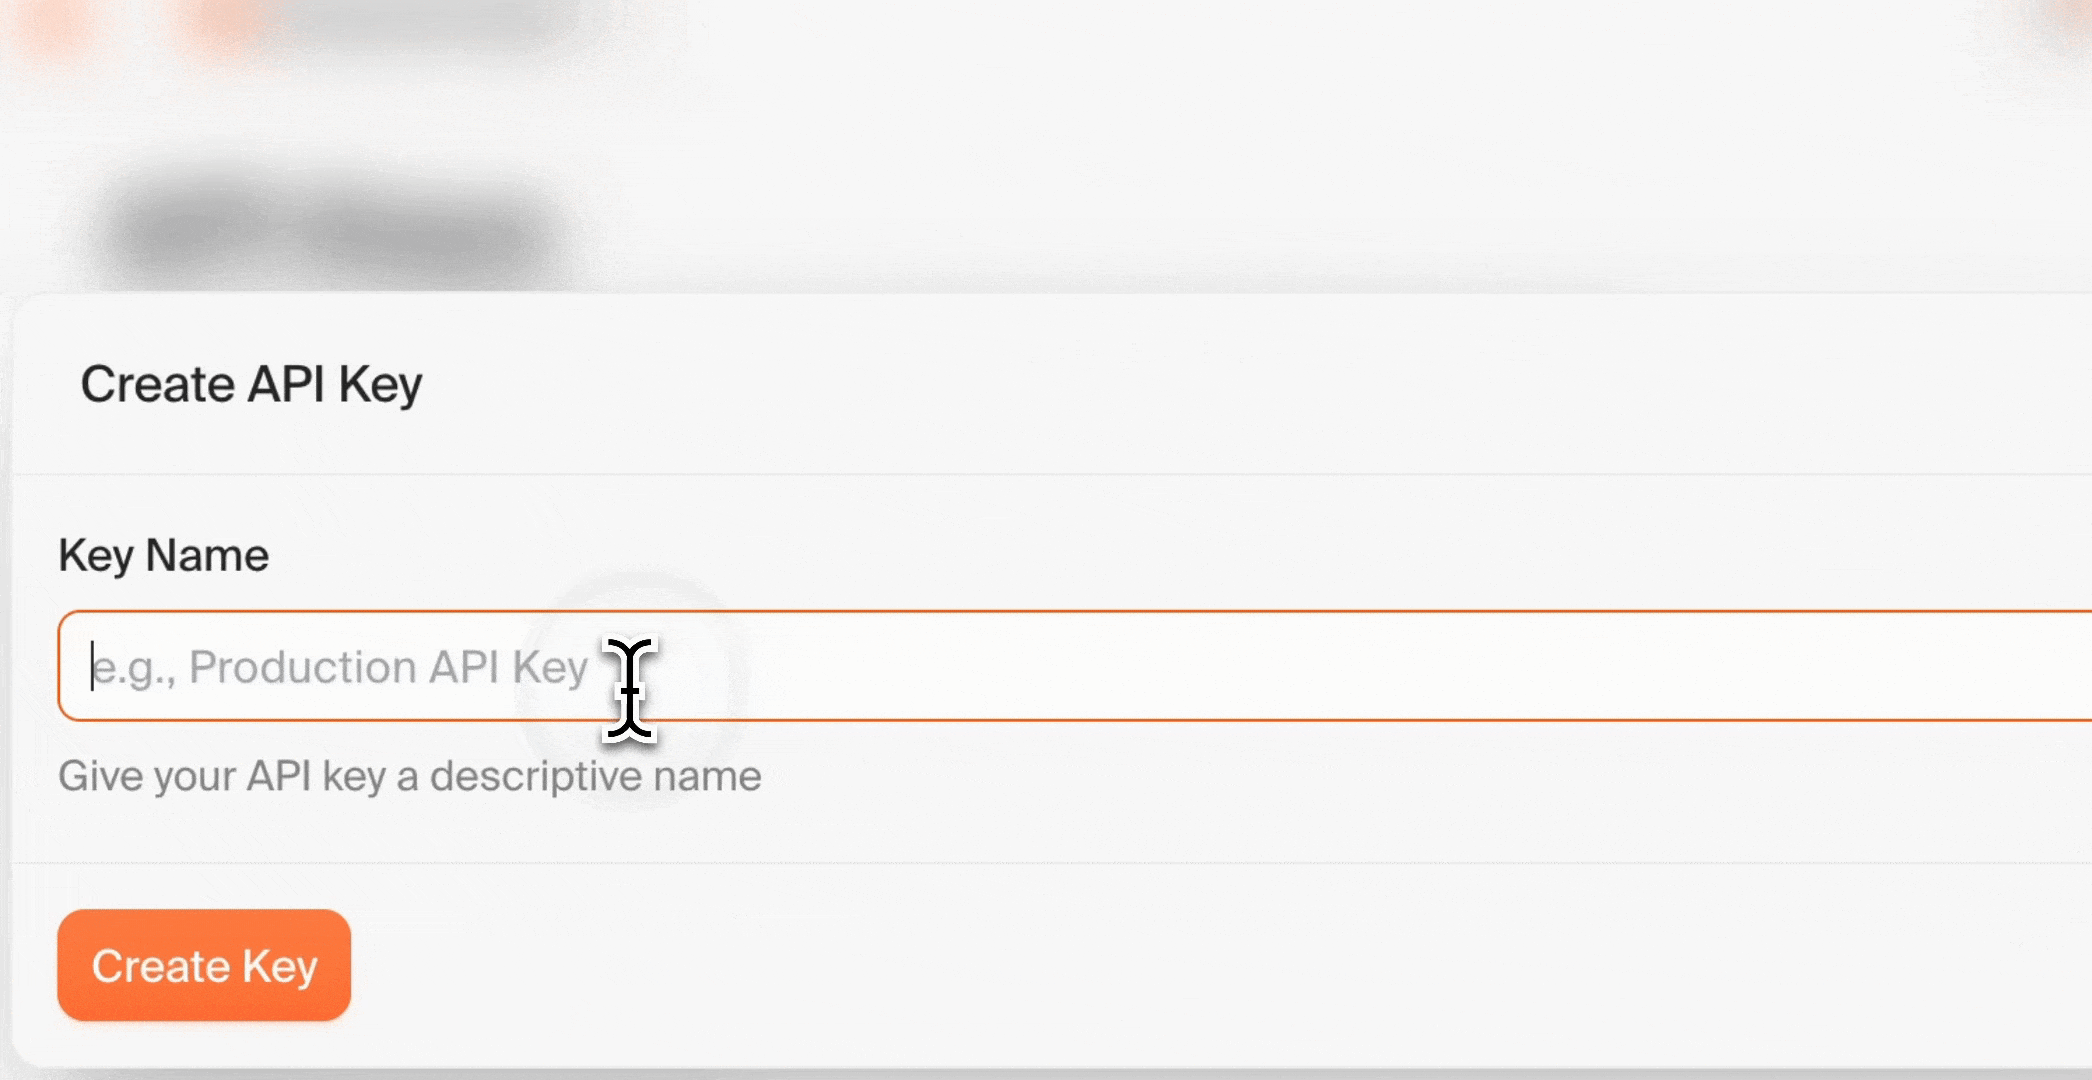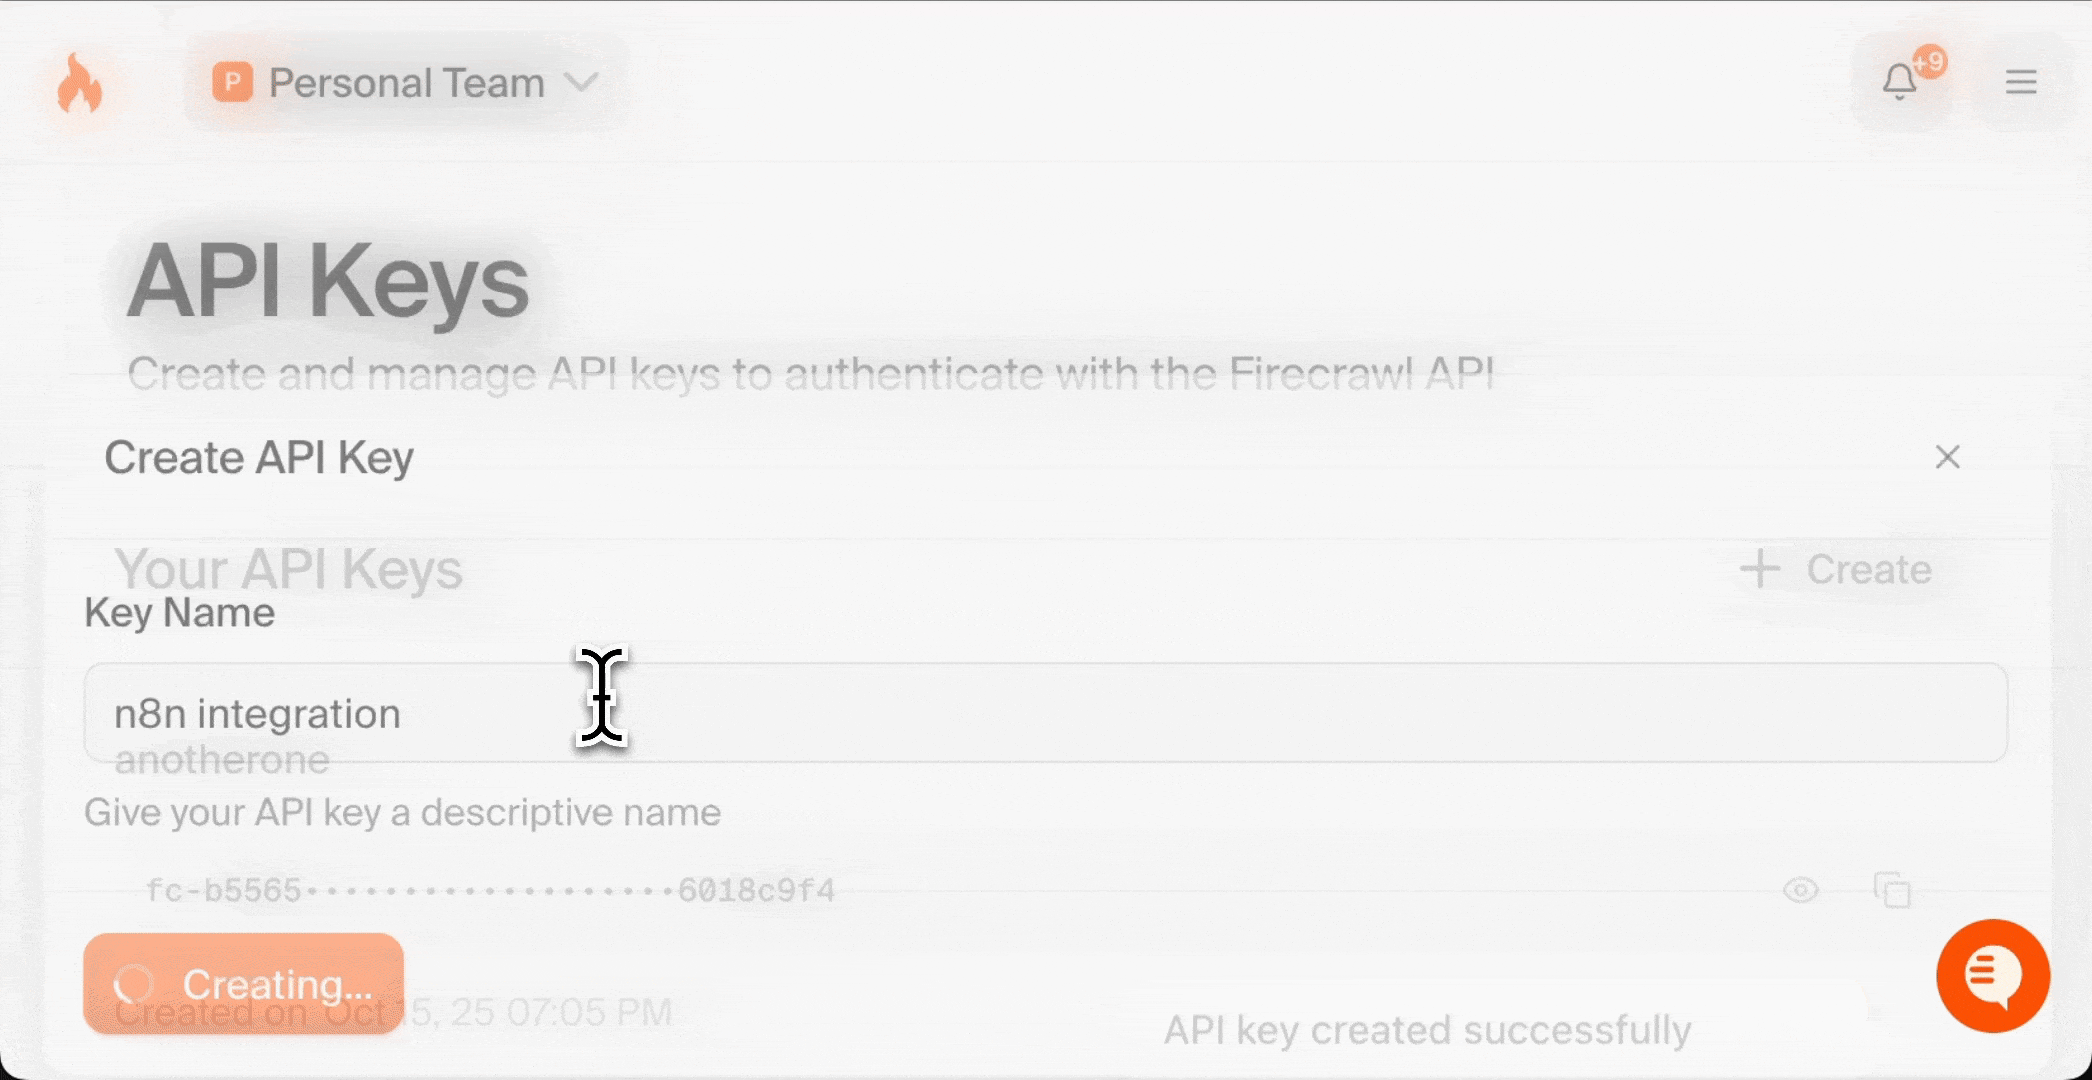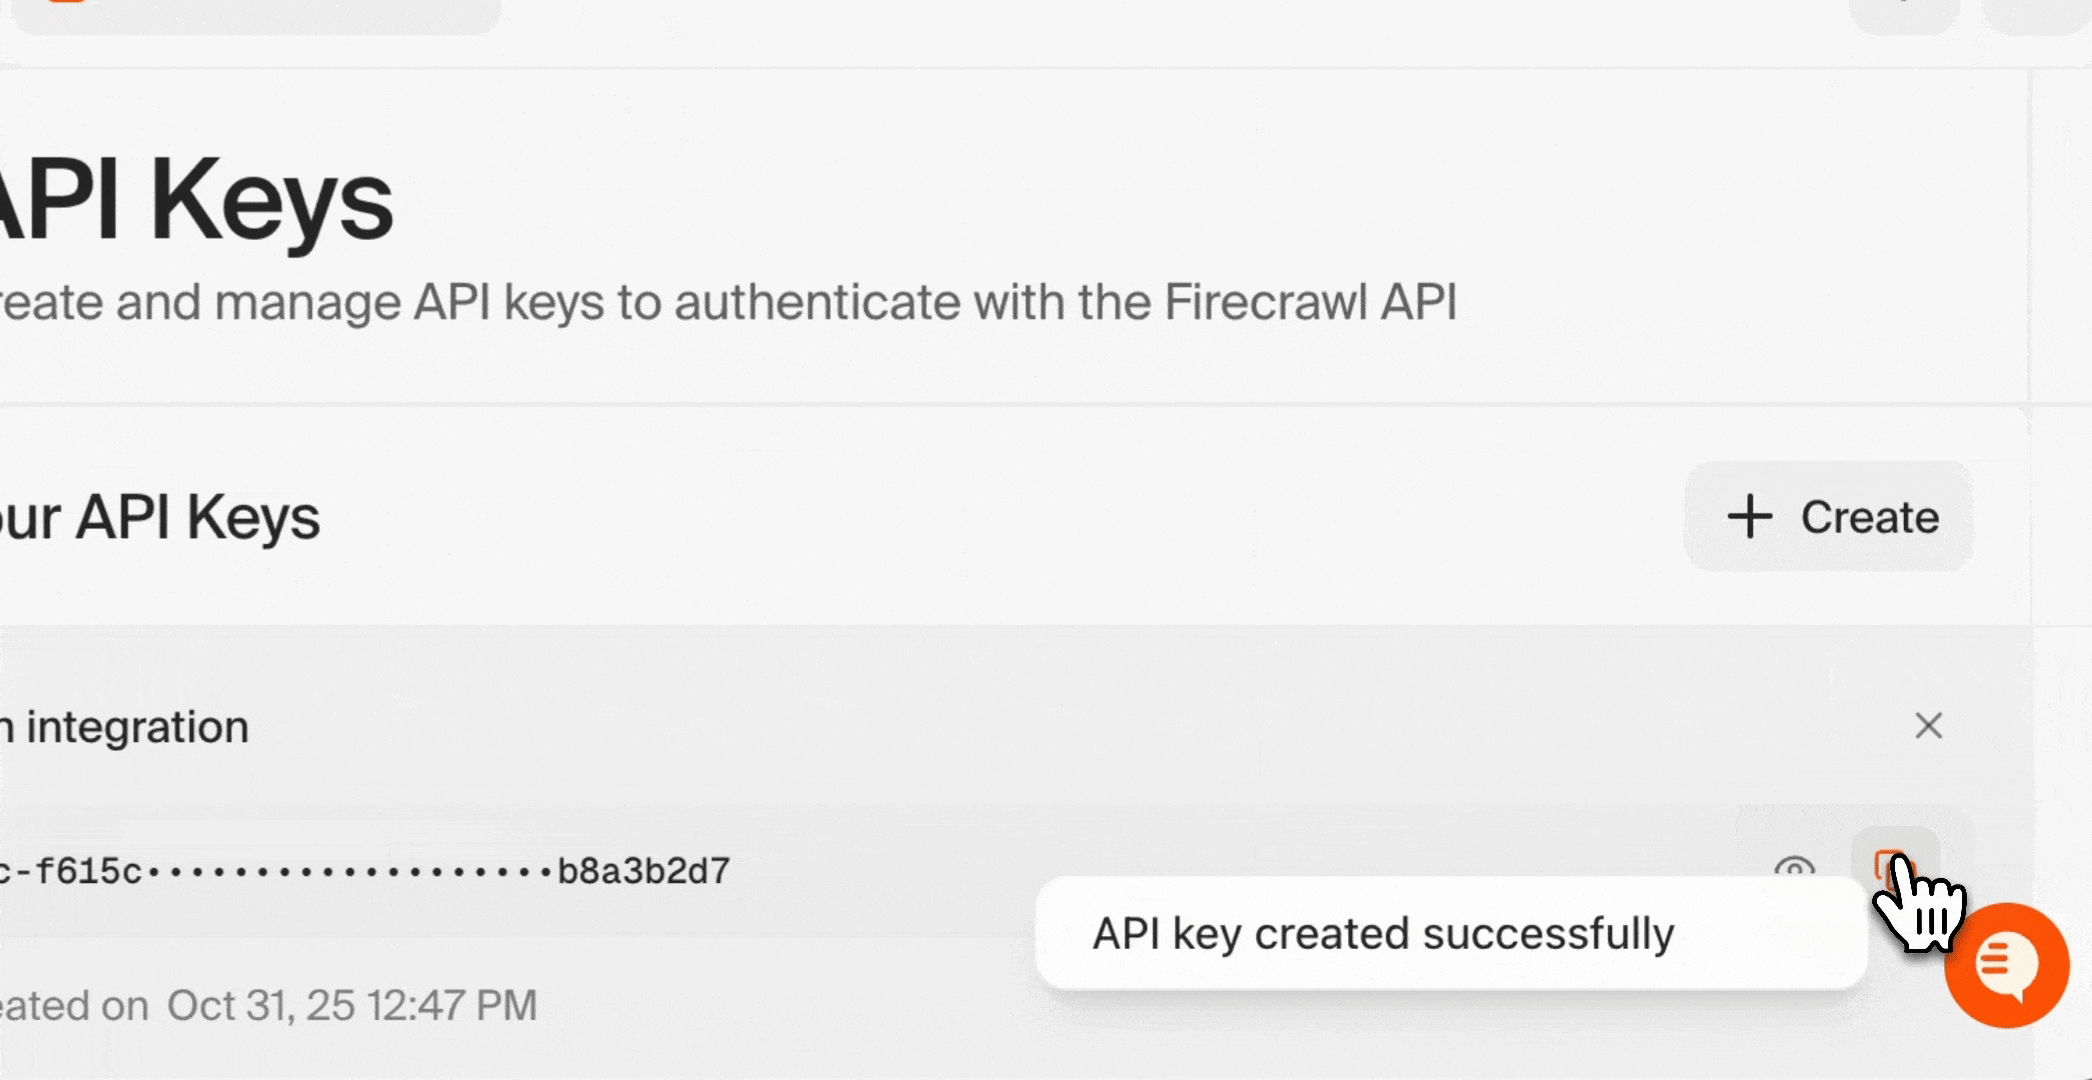
サインイン後、Firecrawl を n8n に接続するには APIキーが必要です。- Firecrawlダッシュボードに移動します
- APIキーのページに移動します
- 「Create New API Key」をクリックします
- キーにわかりやすい名前を付けます (例:「n8n Integration」)
- 生成されたAPIキーをコピーし、安全な場所に保管します
APIキーはパスワードのようなものです。安全に保管し、公開の場で共有しないでください。このキーは次のセクションで必要になります。
ステップ2: n8n をセットアップする
n8n には、クラウドホスト型とセルフホスト型の 2 つのデプロイオプションがあります。初心者には、クラウド版が最も手軽に始められます。n8nのバージョンを選択
n8n Cloud (初心者におすすめ) :- インストール不要
- Free tierあり
- インフラは管理済み
- 自動アップデート
- データを完全に管理可能
- 自分のserverで実行
- Dockerのインストールが必要
- 特定のセキュリティ要件がある上級ユーザーに適しています
オプションA: n8n Cloud (初心者におすすめ)
- n8n.cloudにアクセスします
- 「Start Free」または「Sign Up」をクリックします
- メールアドレスまたはGitHubアカウントで登録します
- 確認手続きを完了します
- n8nのダッシュボードが表示されます
オプションB:Docker でセルフホストする
独自のインフラで n8n を実行する場合は、Docker を使ってすばやくセットアップできます。 前提条件:- コンピュータに Docker Desktop がインストールされていること
- コマンドライン/ターミナルの基本的な知識
- ターミナルまたはコマンドプロンプトを開きます
- ワークフローデータを永続化するための Docker ボリュームを作成します:
- n8n の Docker コンテナを実行します。
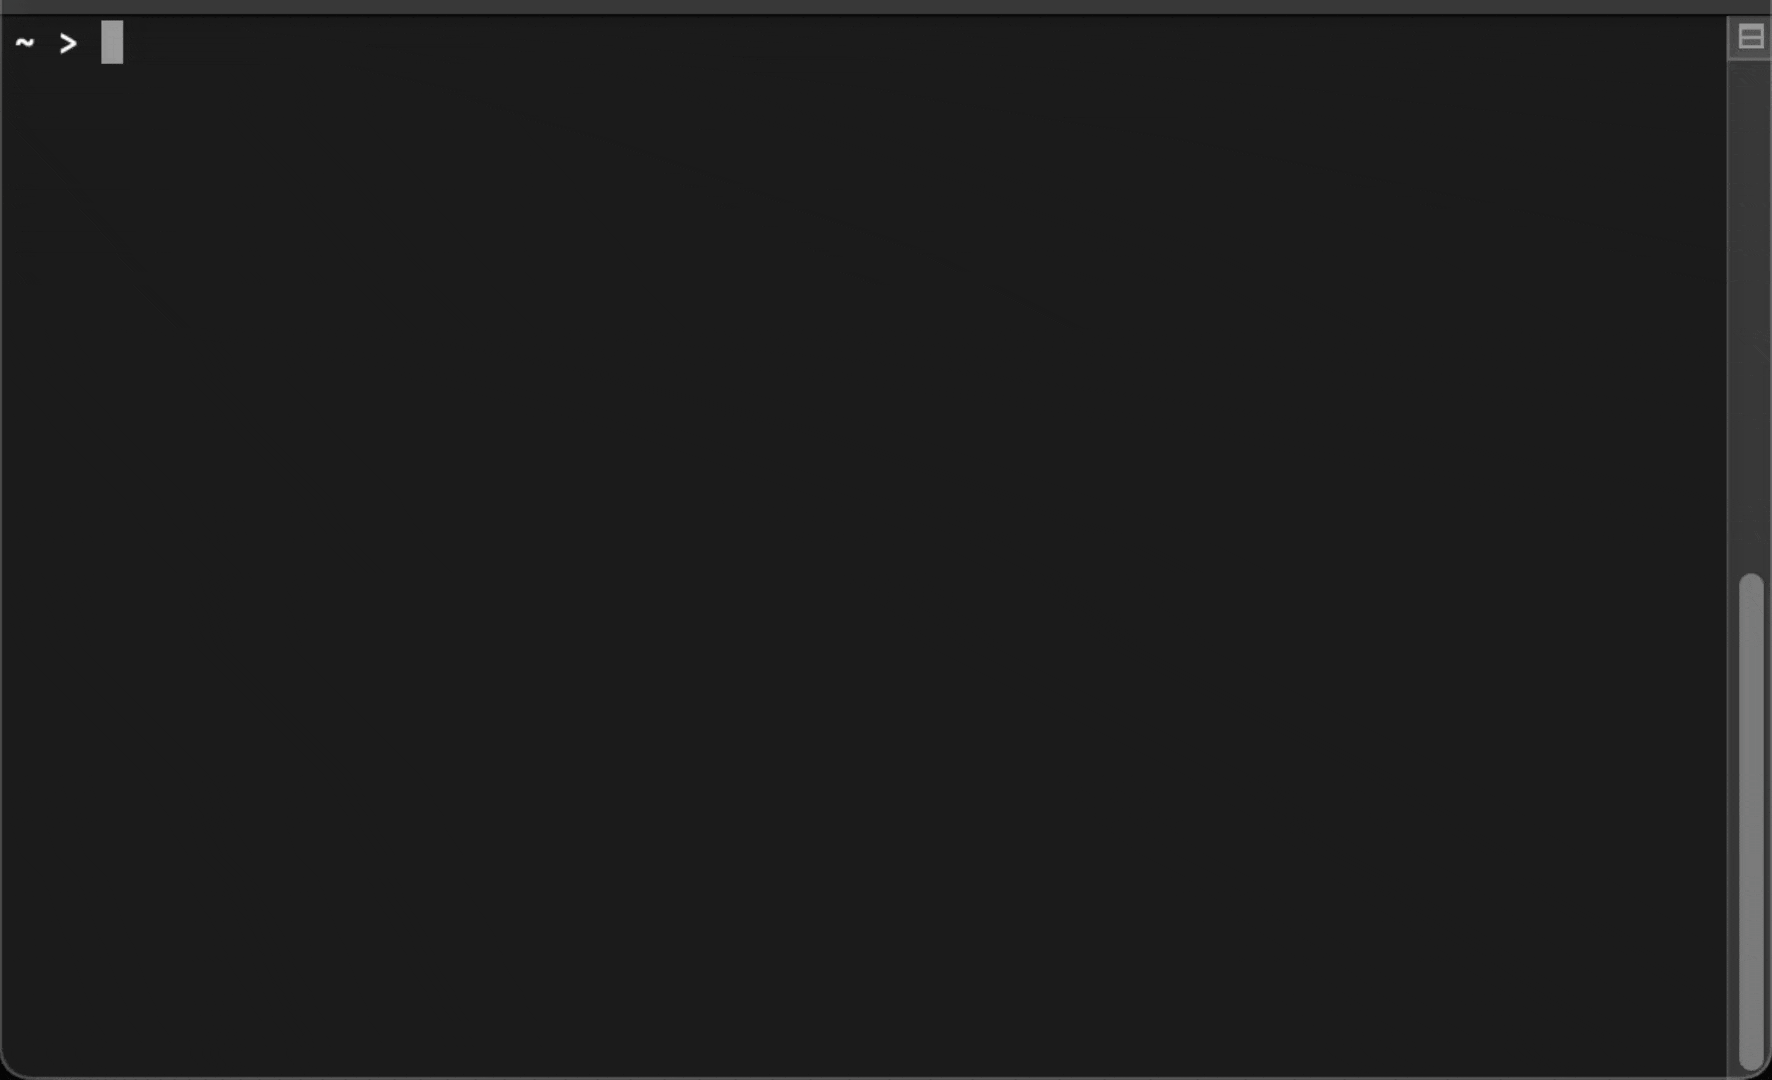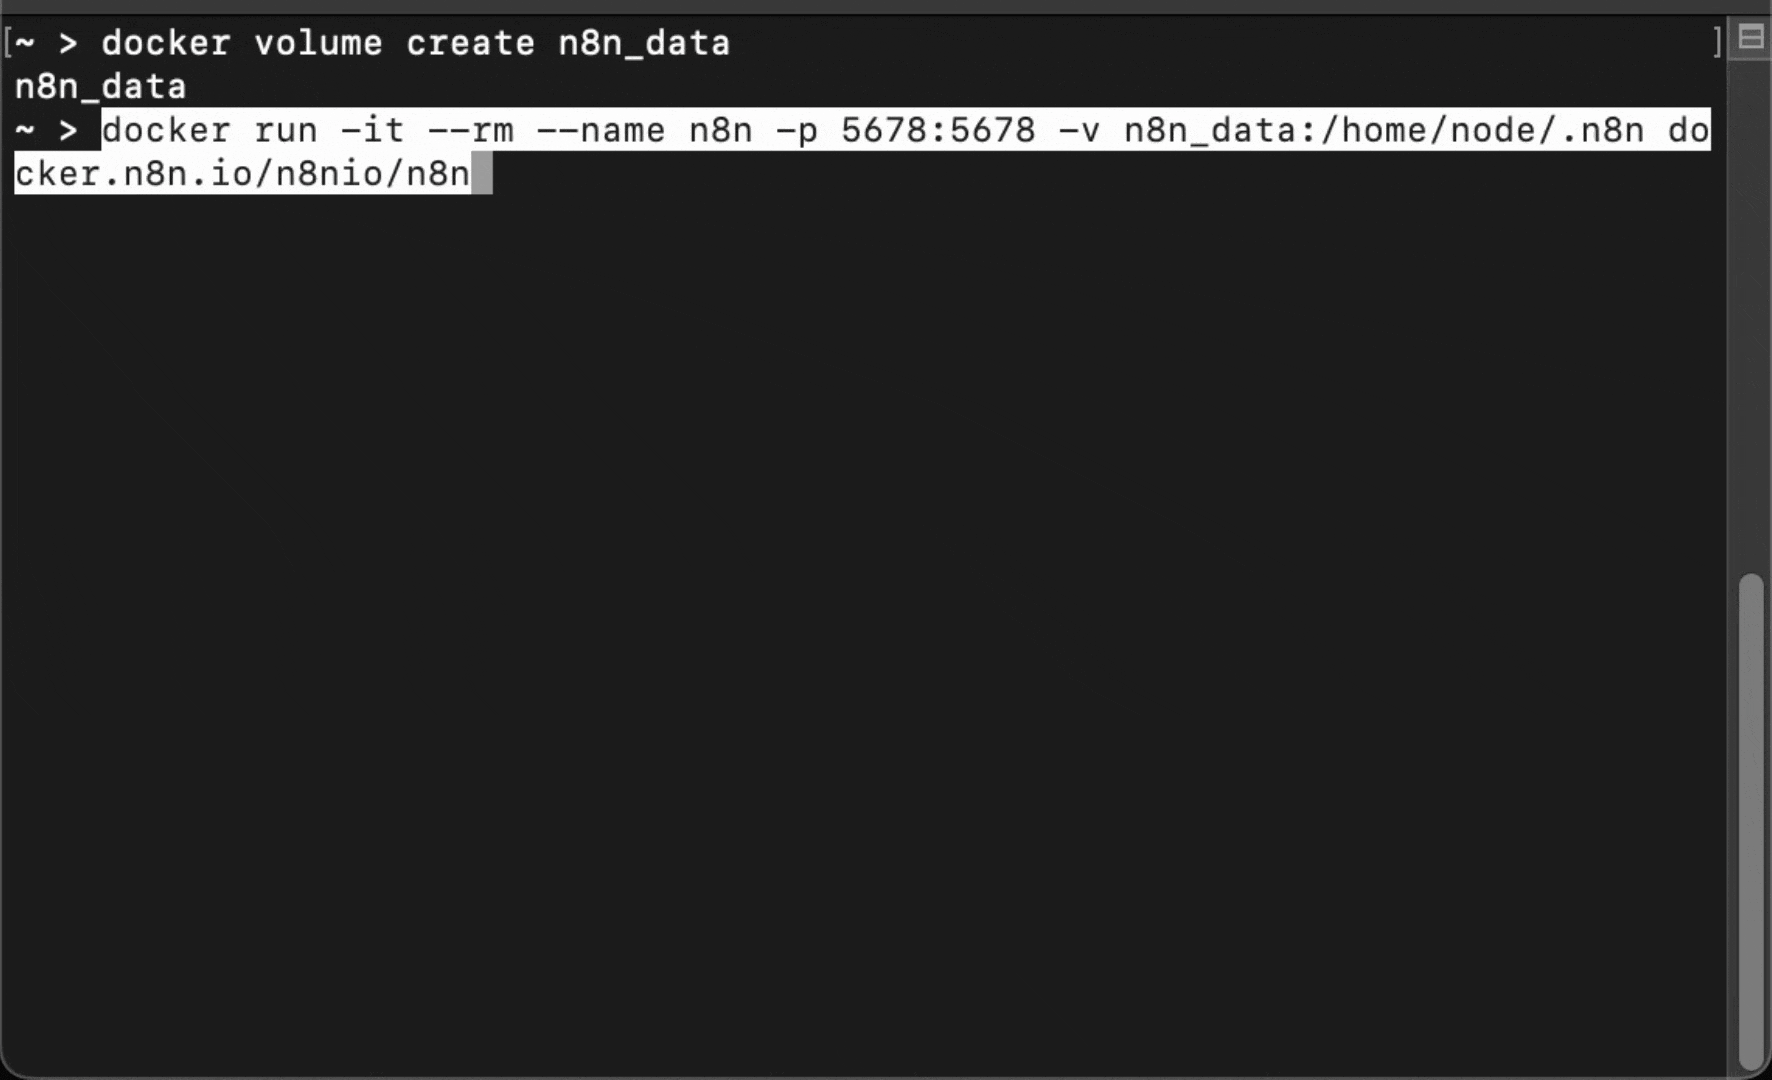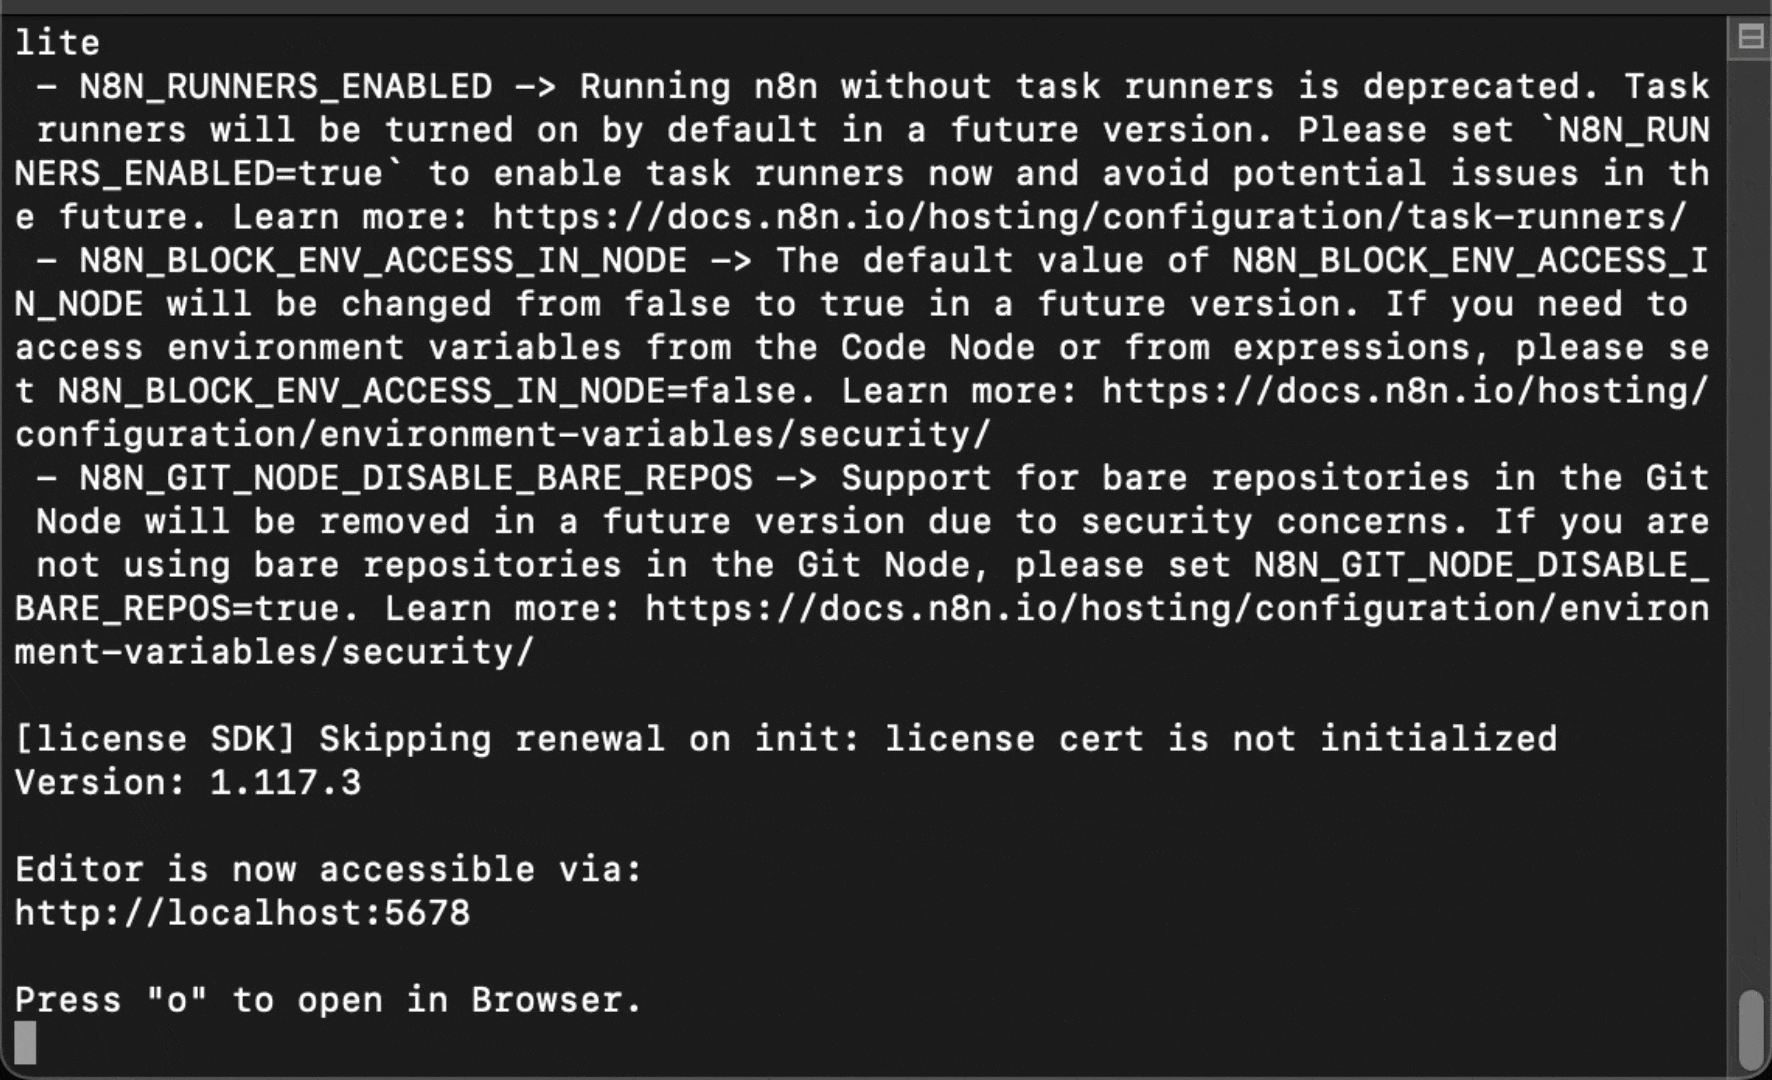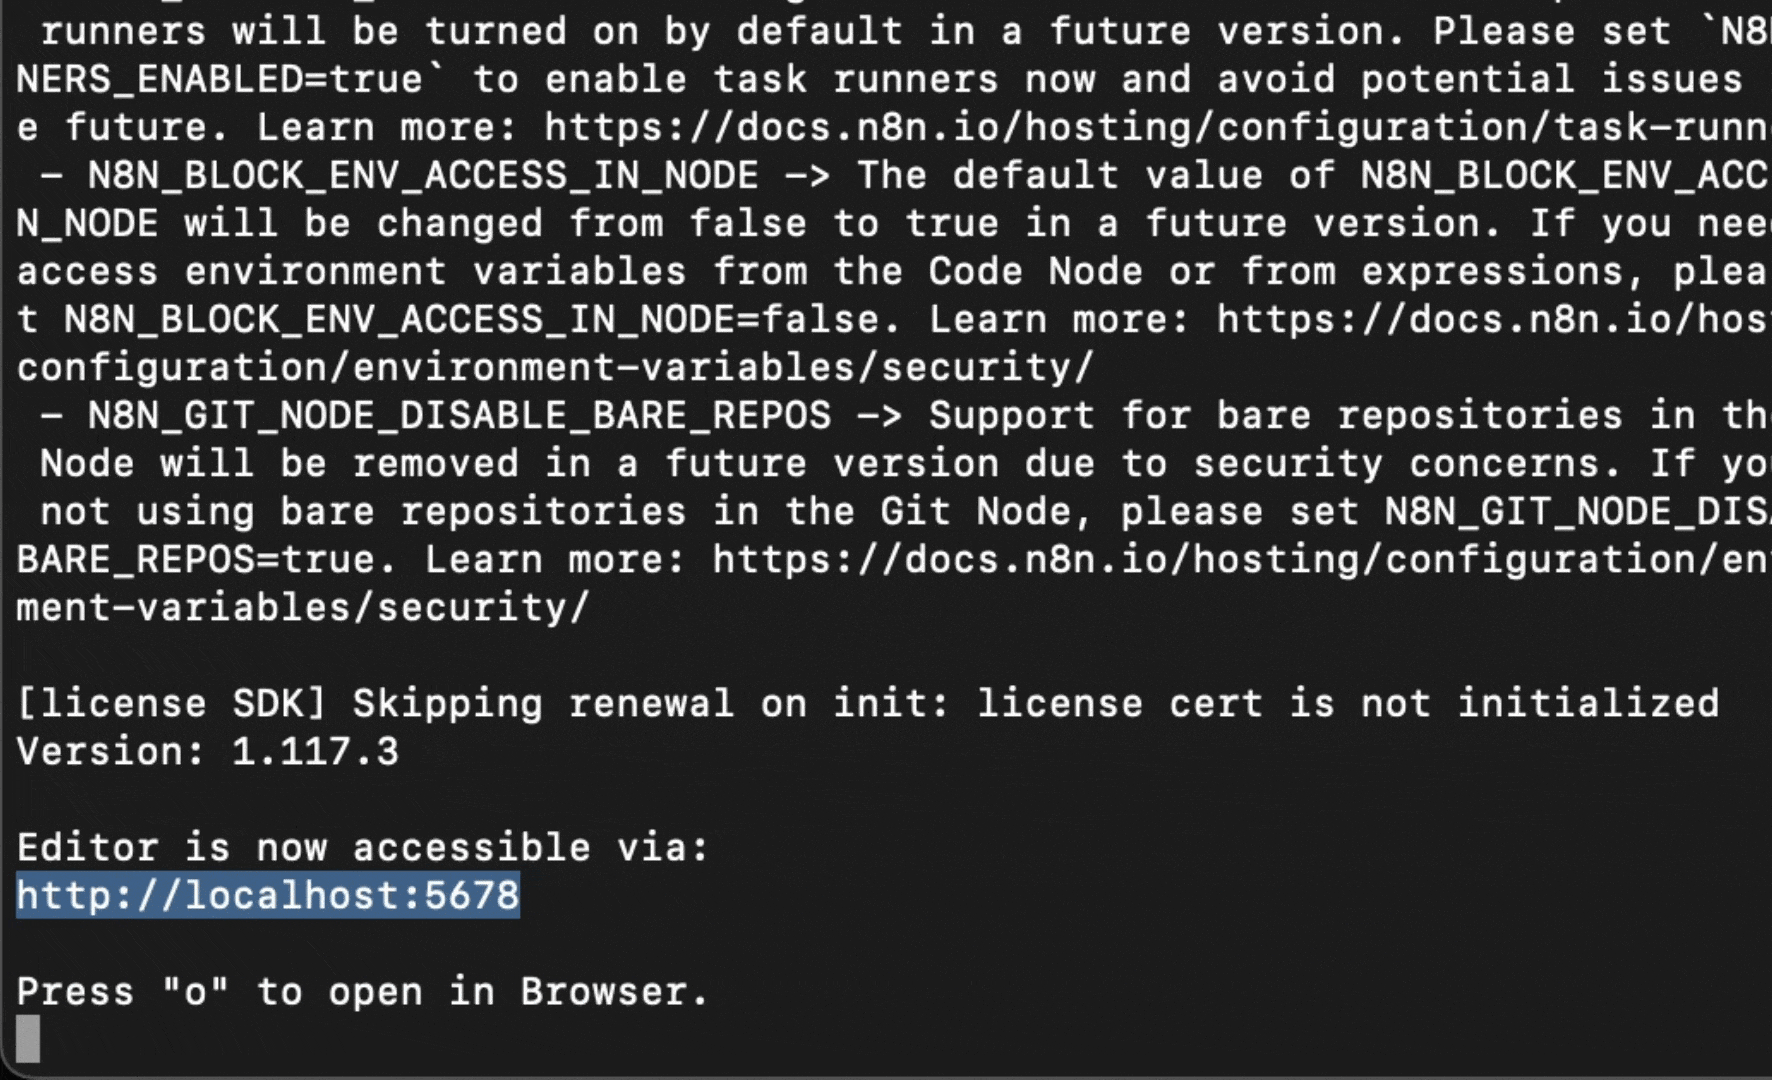
- n8n が起動するまで待ちます。サーバーが実行中であることを示す出力が表示されます
- Web ブラウザを開き、
http://localhost:5678にアクセスします - メールアドレスを登録して n8n アカウントを作成します
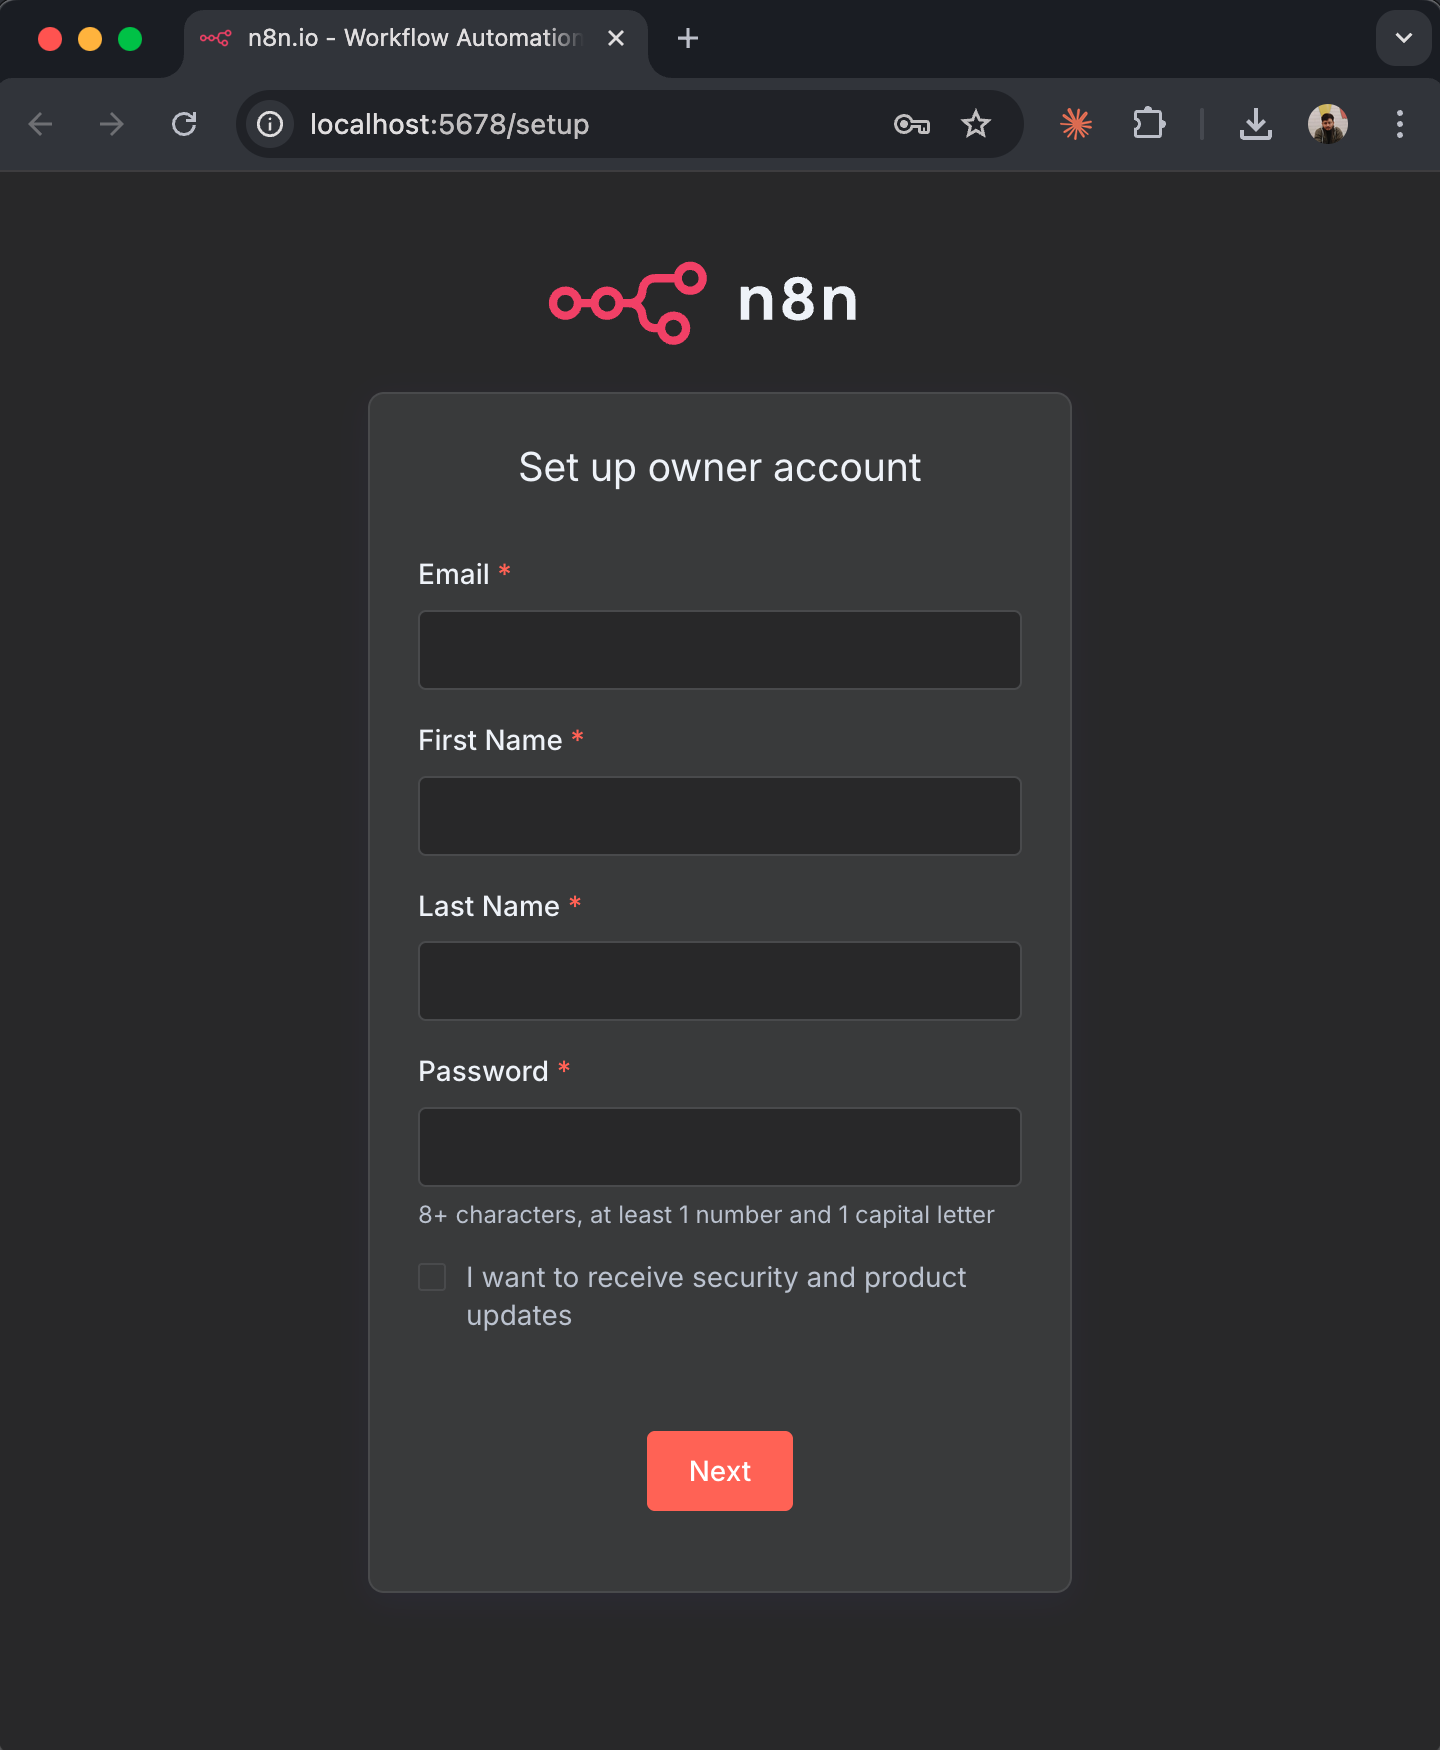
--rm フラグを使用すると、停止時にコンテナが自動的に削除されますが、データは n8n_data ボリュームに安全に保持されます。本番環境へのデプロイでは、より高度な構成オプションについて n8n self-hosting documentation を参照してください。n8nのインターフェースを理解する
n8nに初めてログインすると、メインダッシュボードが表示されます。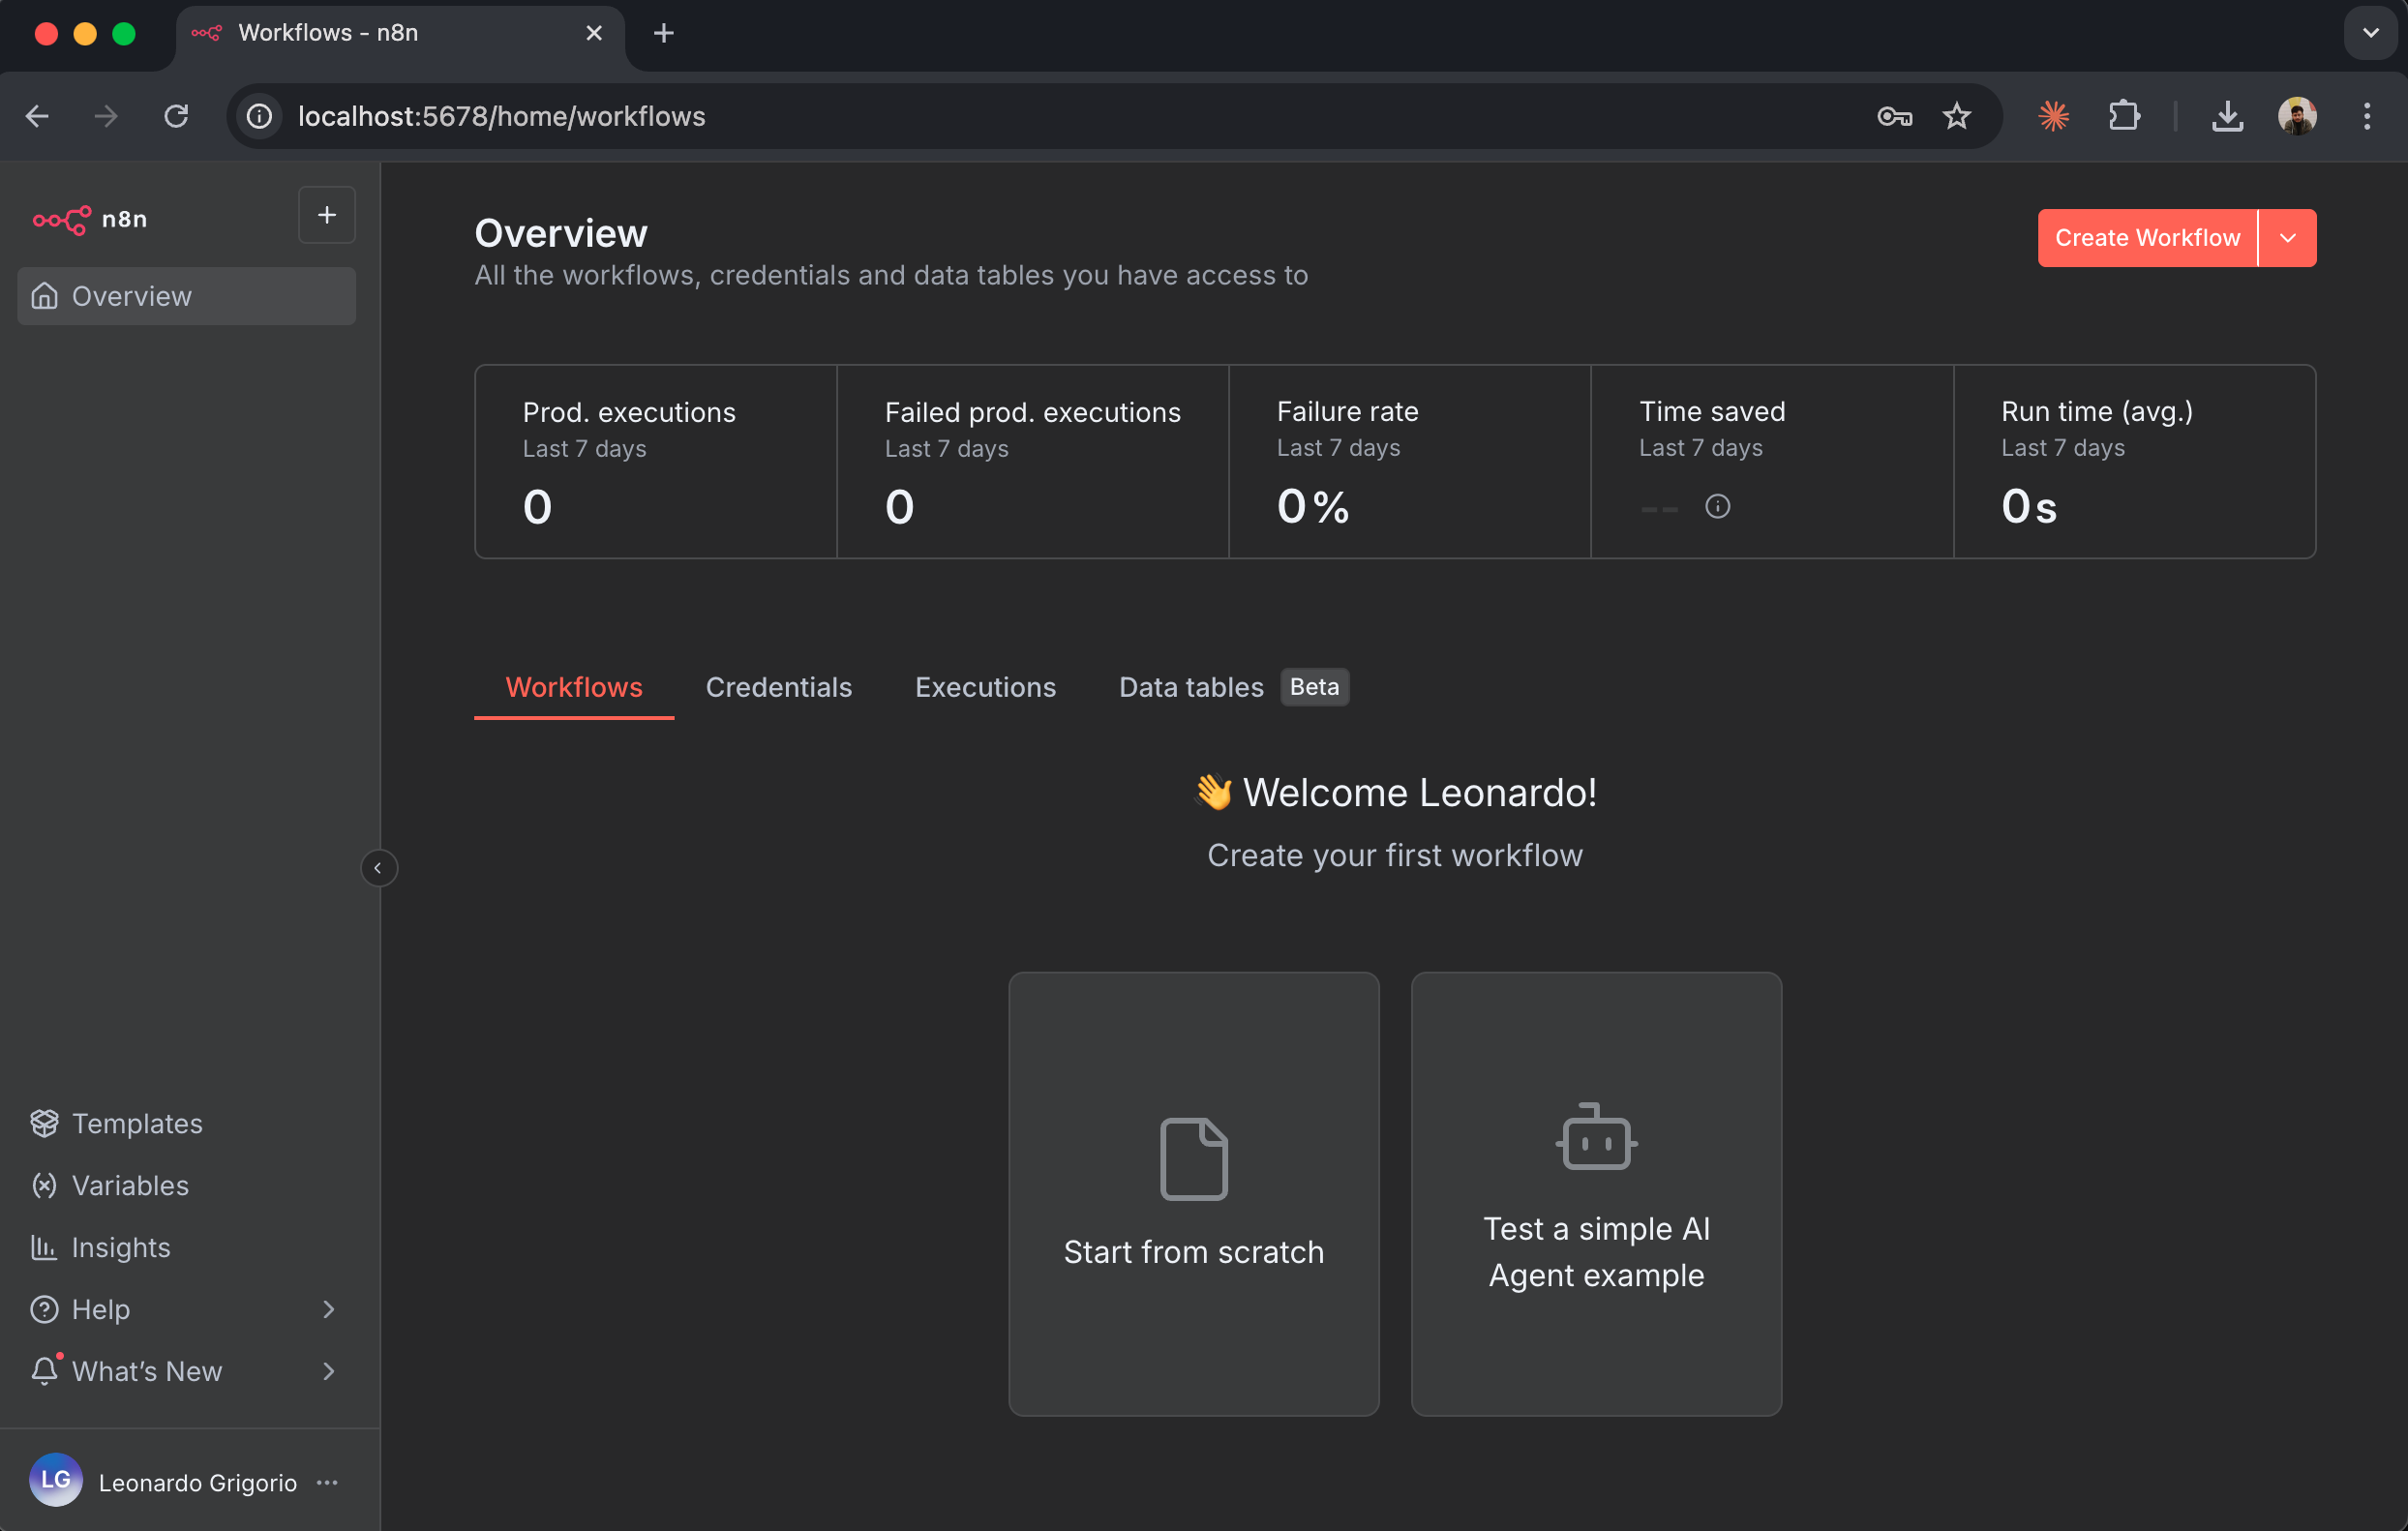
- Workflows: 保存した自動化がここに表示されます
- Executions: ワークフローの実行履歴
- 認証情報: 保存されたAPIキーと認証トークン
- Settings: アカウントとワークスペースの設定
ワークフローキャンバス
ワークフローエディターで自動化を構築します。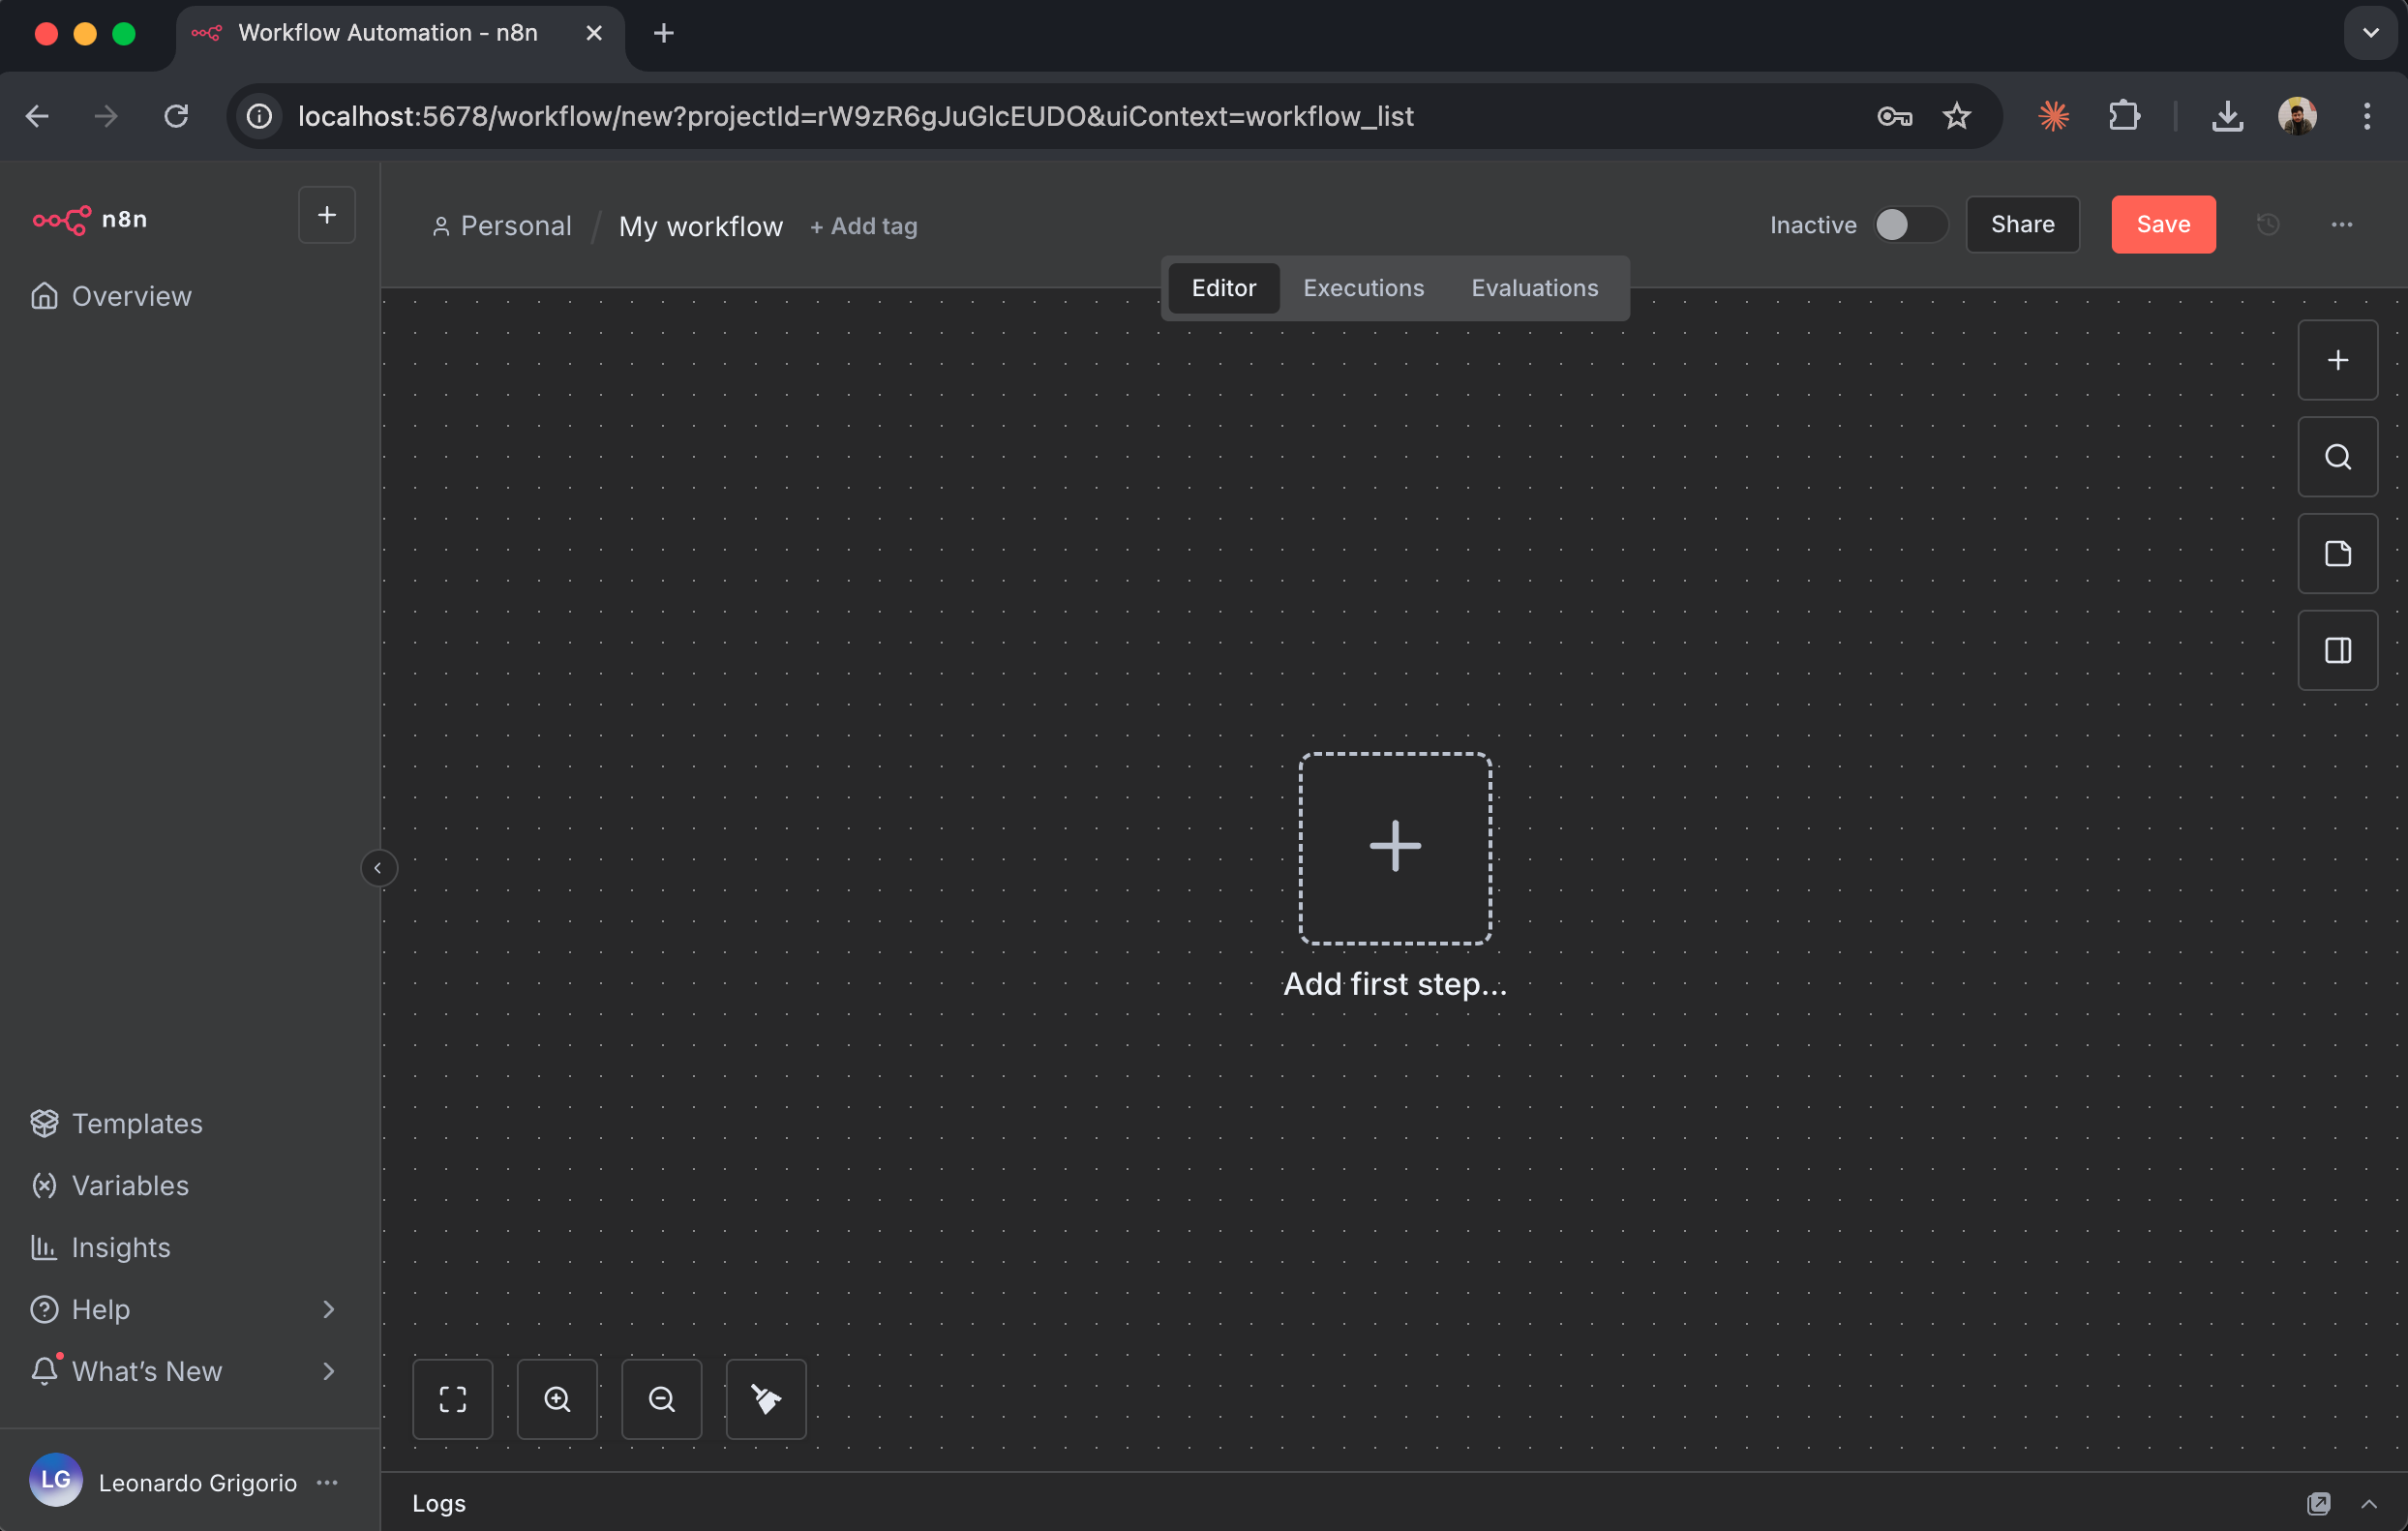
- キャンバス:ノードを配置して接続するメインエリア
- ノード追加ボタン (+) :クリックしてワークフローに新しいノードを追加します
- ノードパネル:「+」をクリックすると開き、利用可能なすべてのノードが表示されます
- ワークフローを実行:テスト用にワークフローを手動で実行します
- 保存:ワークフローの構成を保存します
ステップ3: Firecrawlノードをインストールして設定する
Firecrawl は、n8n の検証済みノード (@mendable/n8n-nodes-firecrawl) として提供されており、Firecrawl が開発・保守しています。ノードをインストールし、先ほど作成した API キーを使用して Firecrawl アカウントに接続します。セルフホスト型の n8n では、インスタンスのオーナーが検証済みノードを一度インストールすれば、そのインスタンスのすべてのユーザーが使用できます。
ワークフローにFirecrawlノードを追加する
- 新しいワークフローキャンバスの中央にある「+」ボタンをクリックします
- 右側にノード選択パネルが開きます
- 上部の検索ボックスに「Firecrawl」と入力します
- 検索結果にFirecrawlノードが表示されます
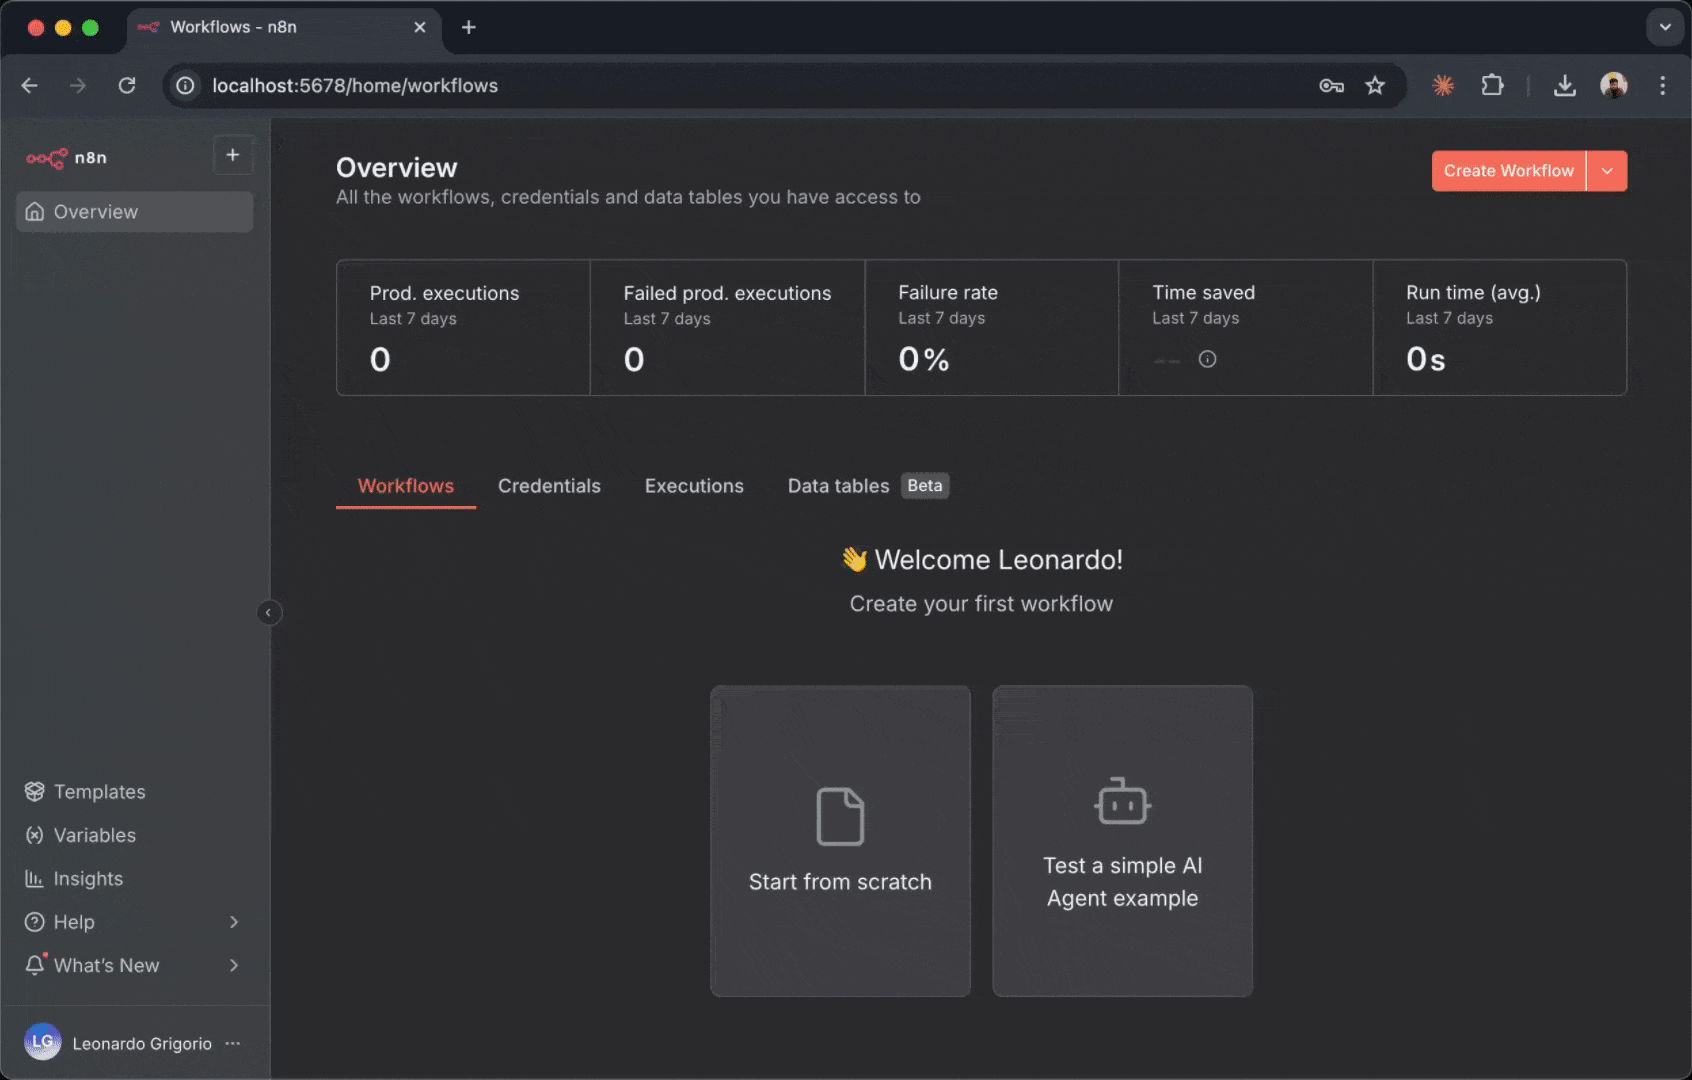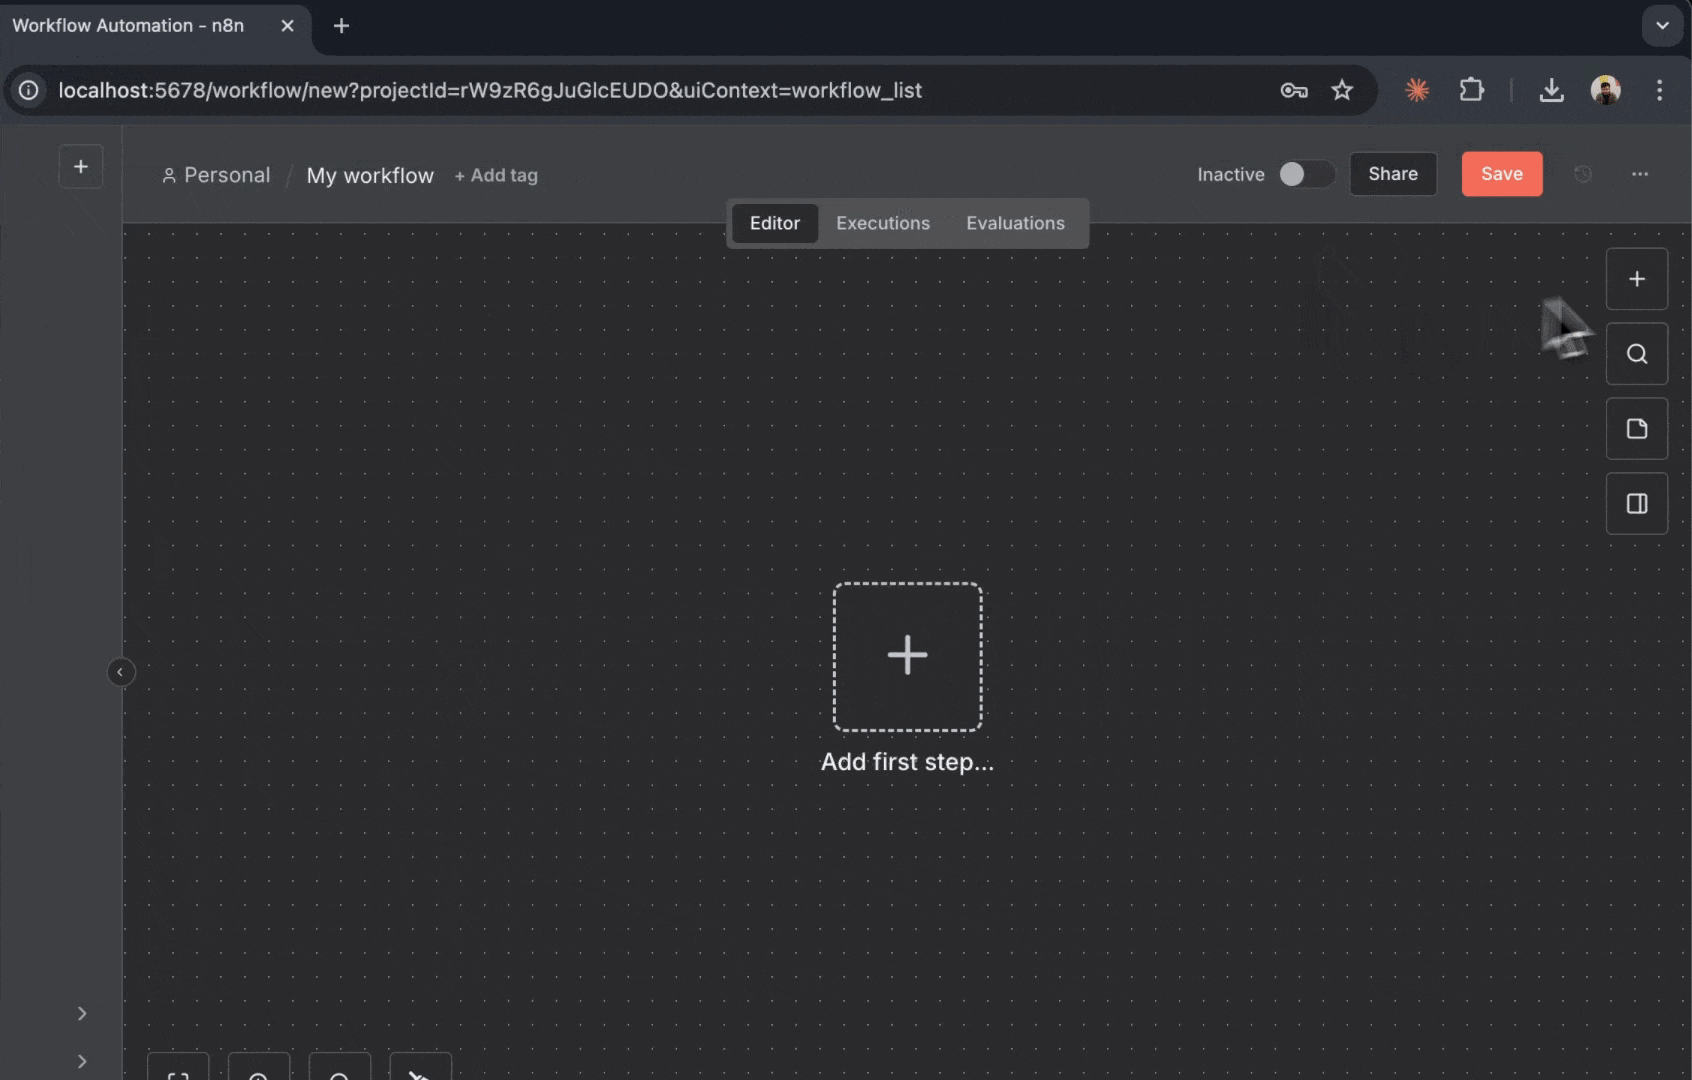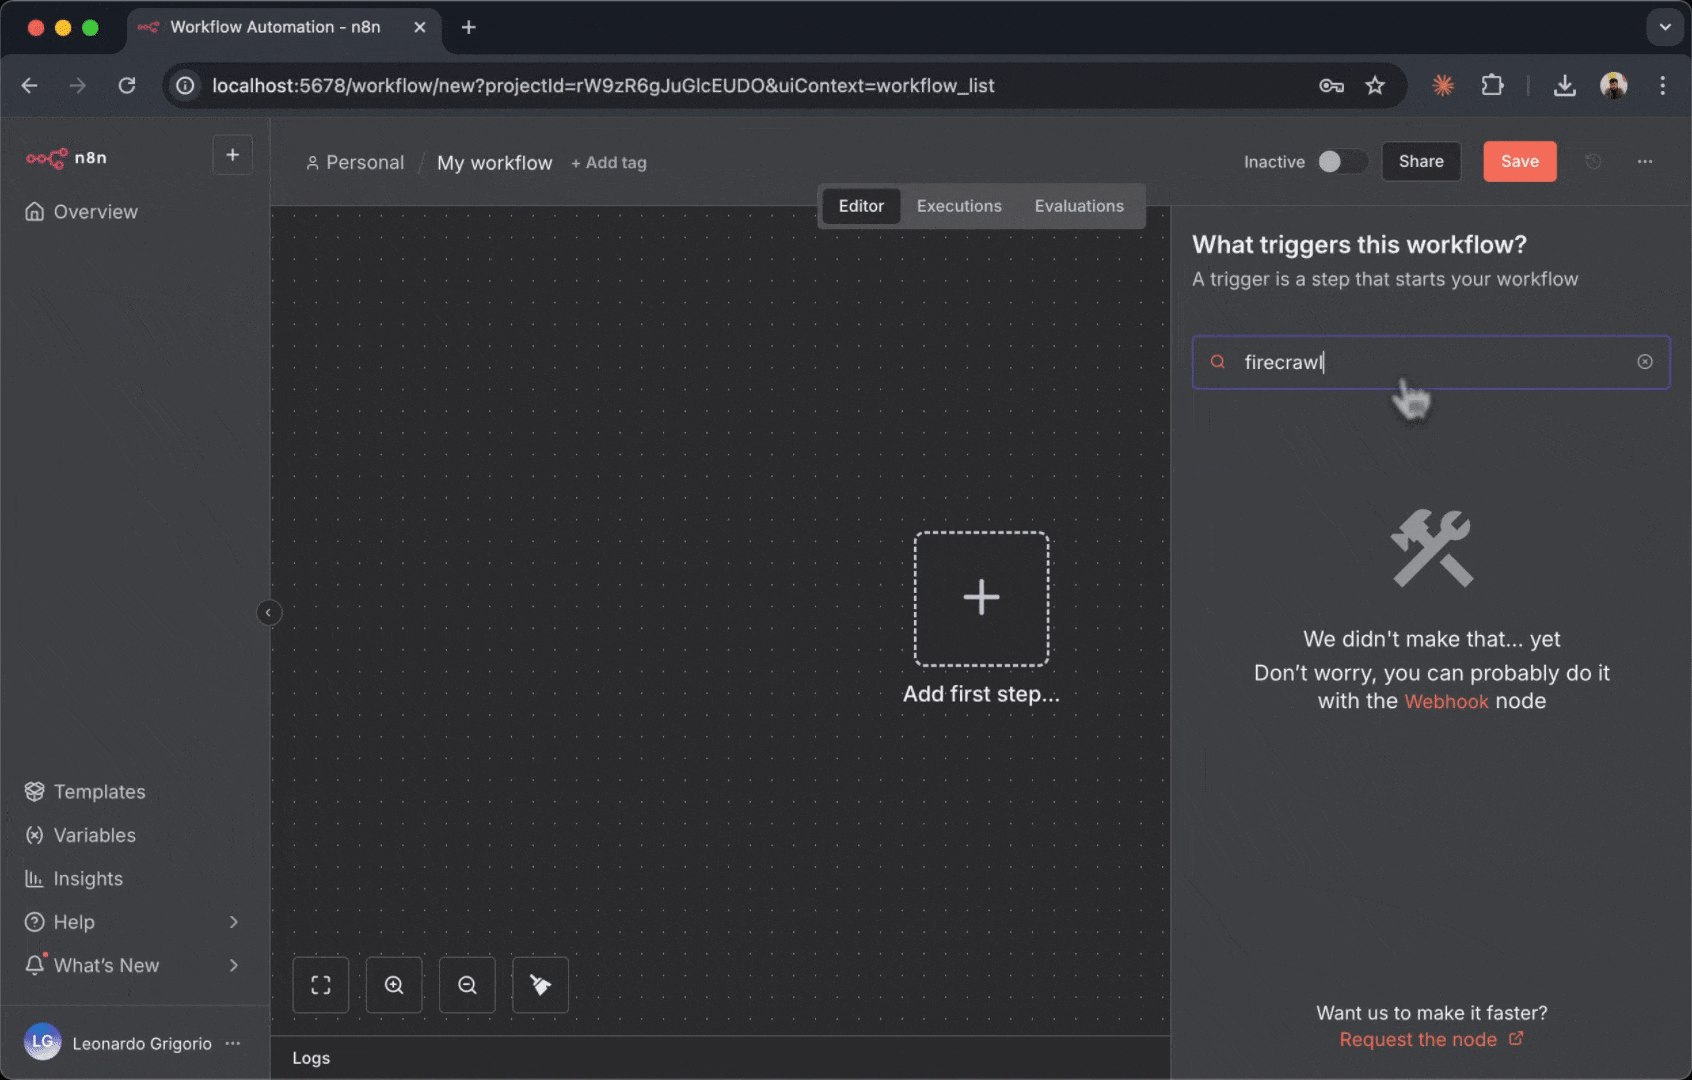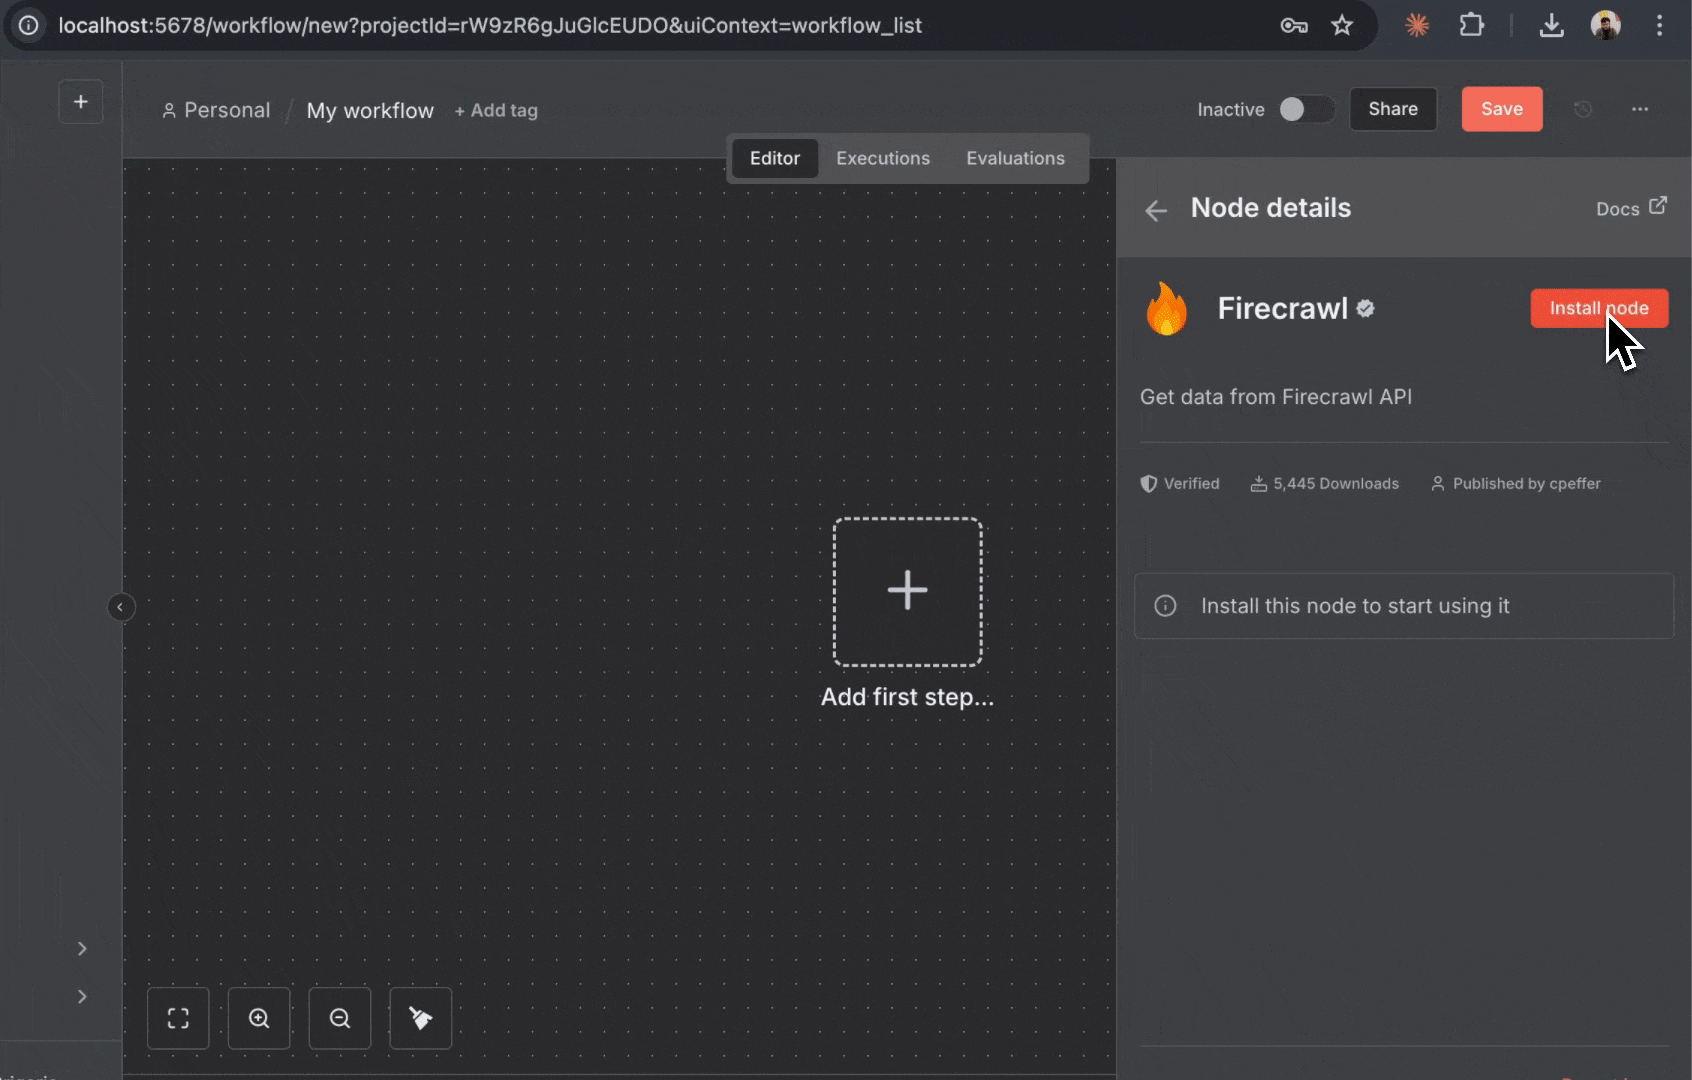
- Firecrawlノードの横にある「Install」をクリックします
- インストールが完了するまで待ちます (数秒かかります)
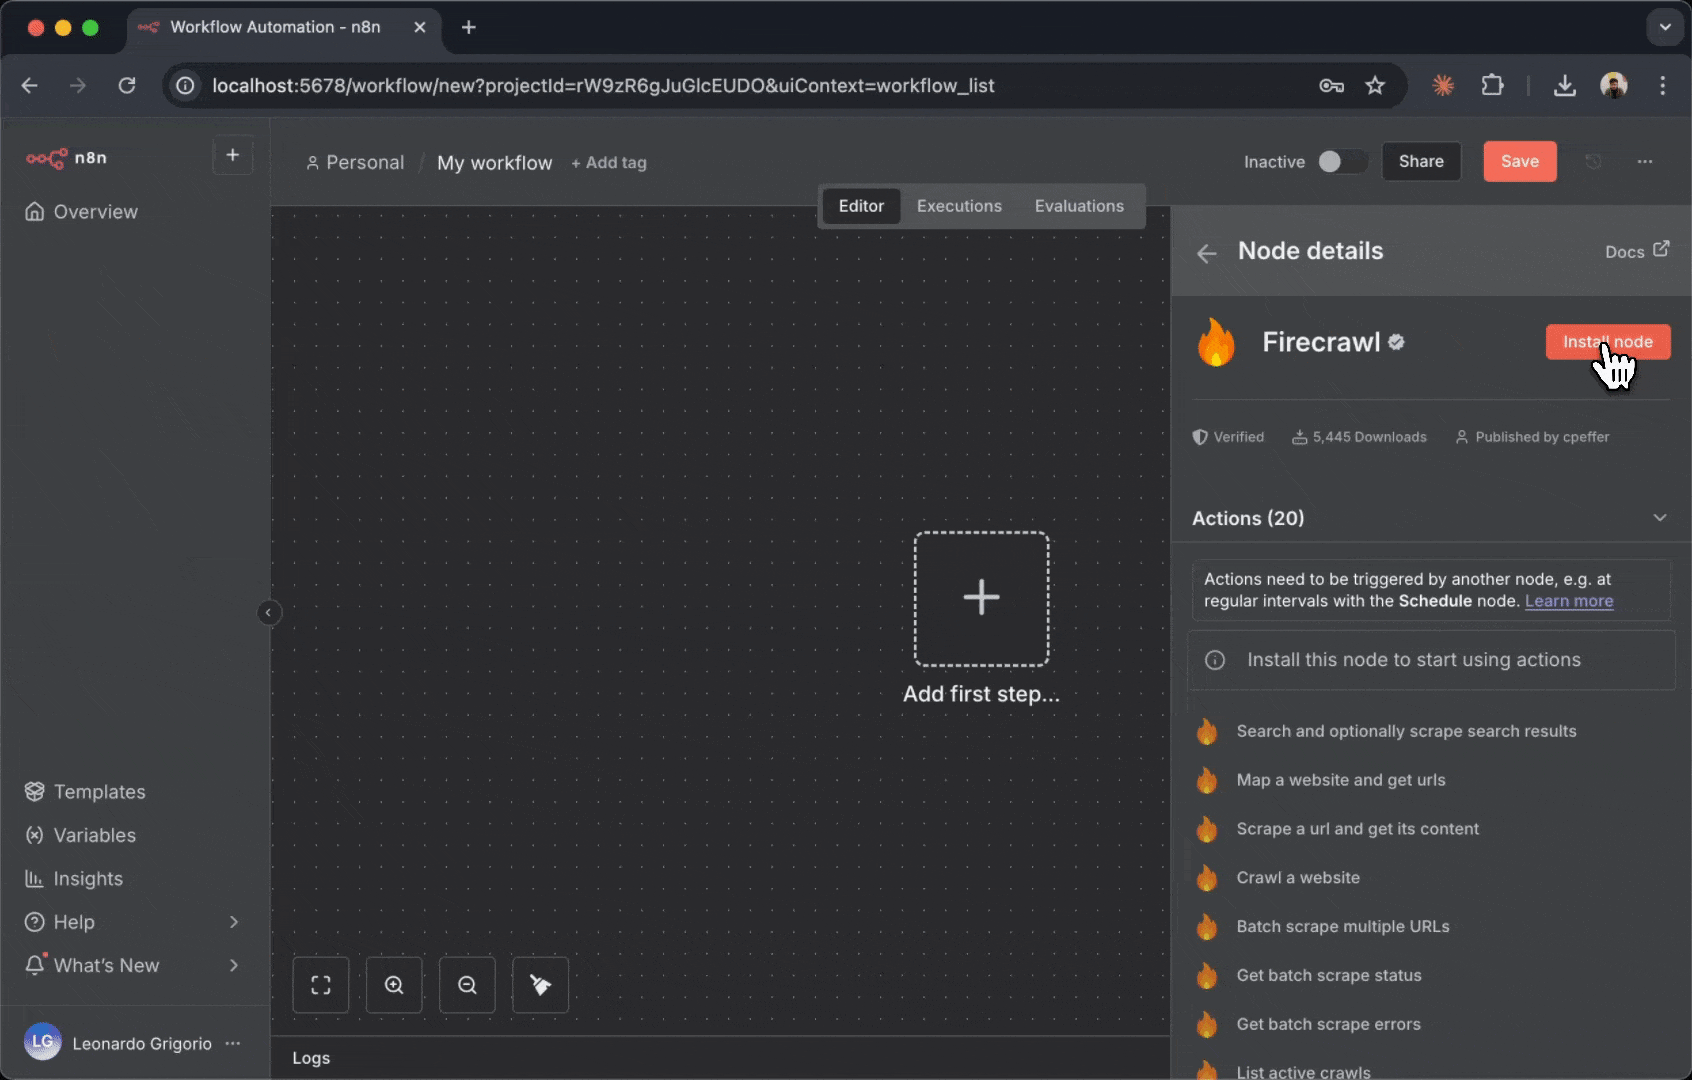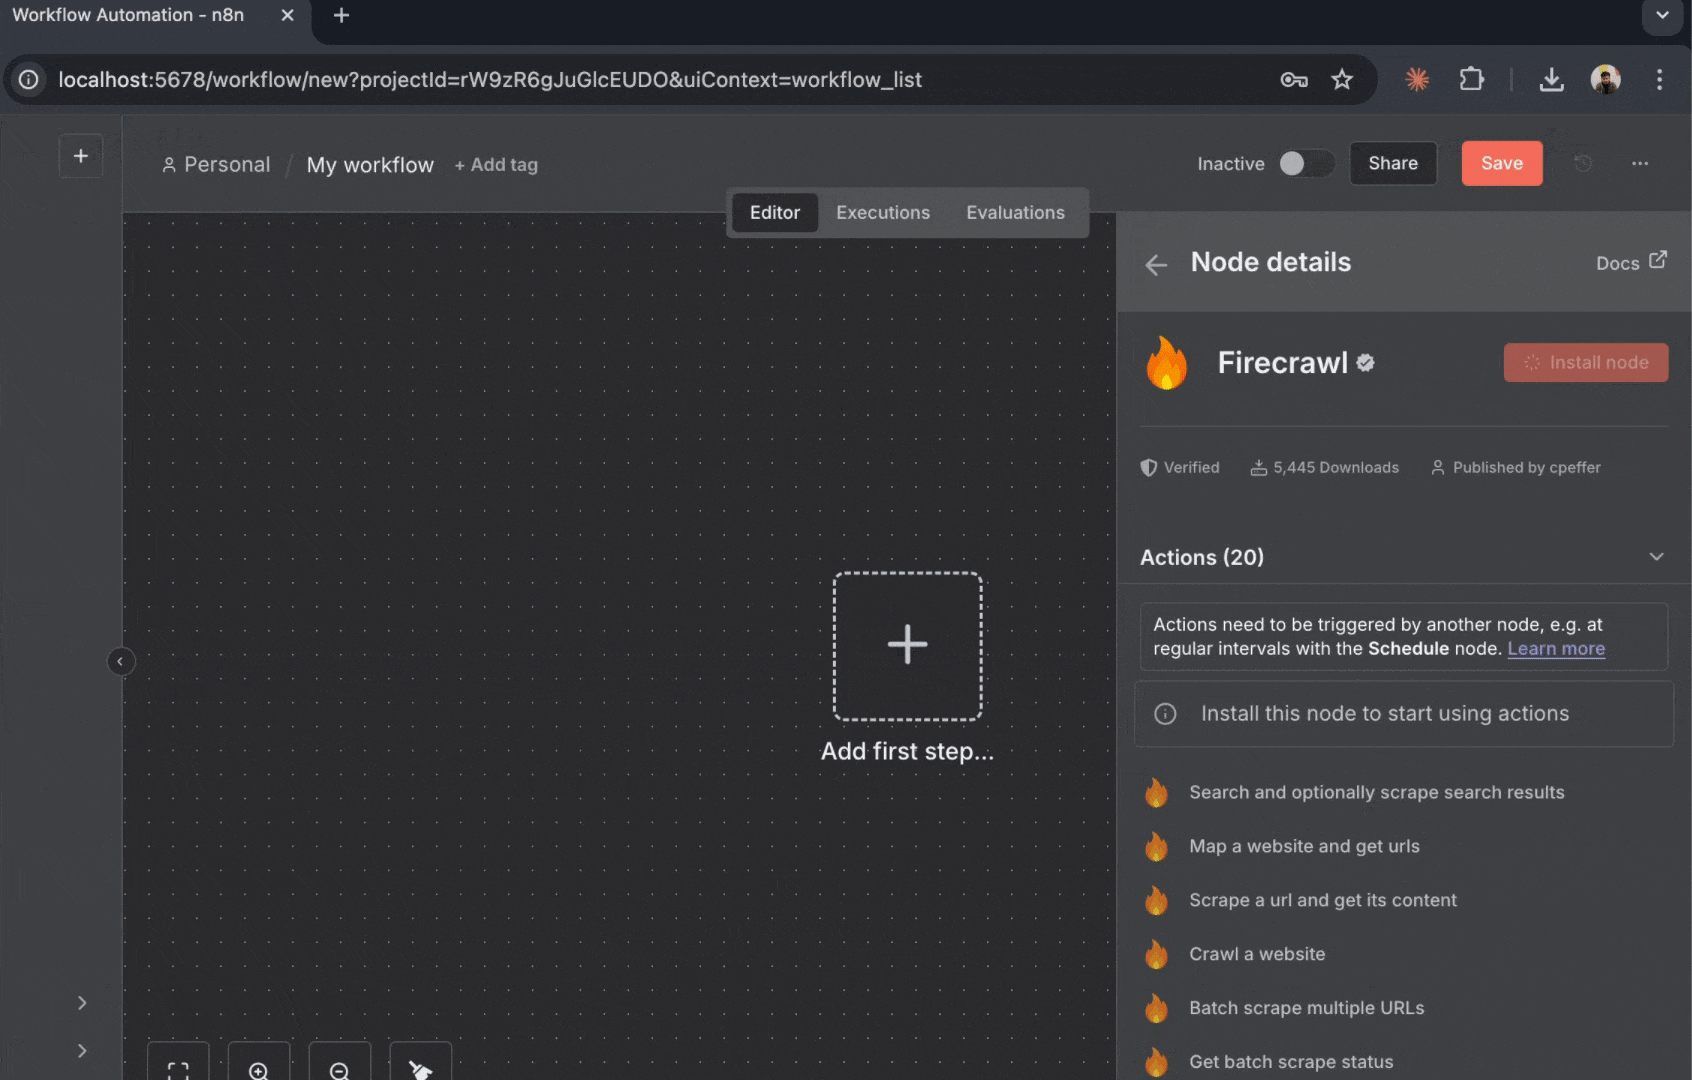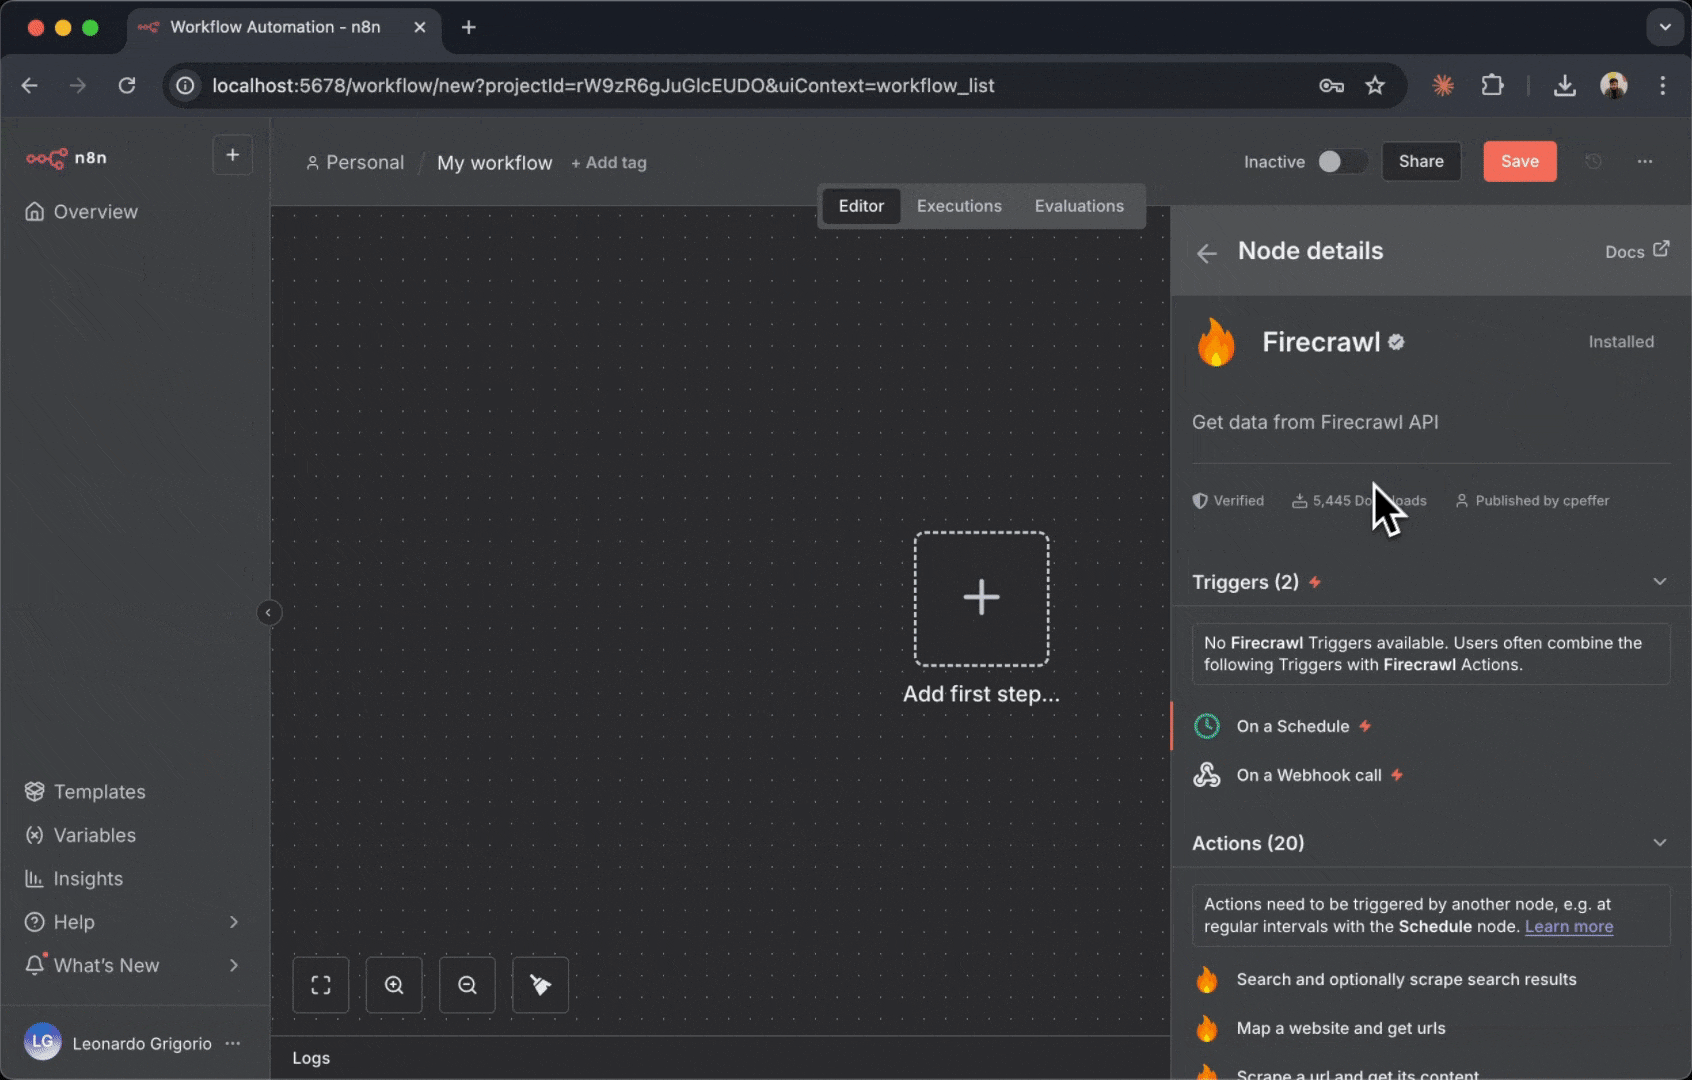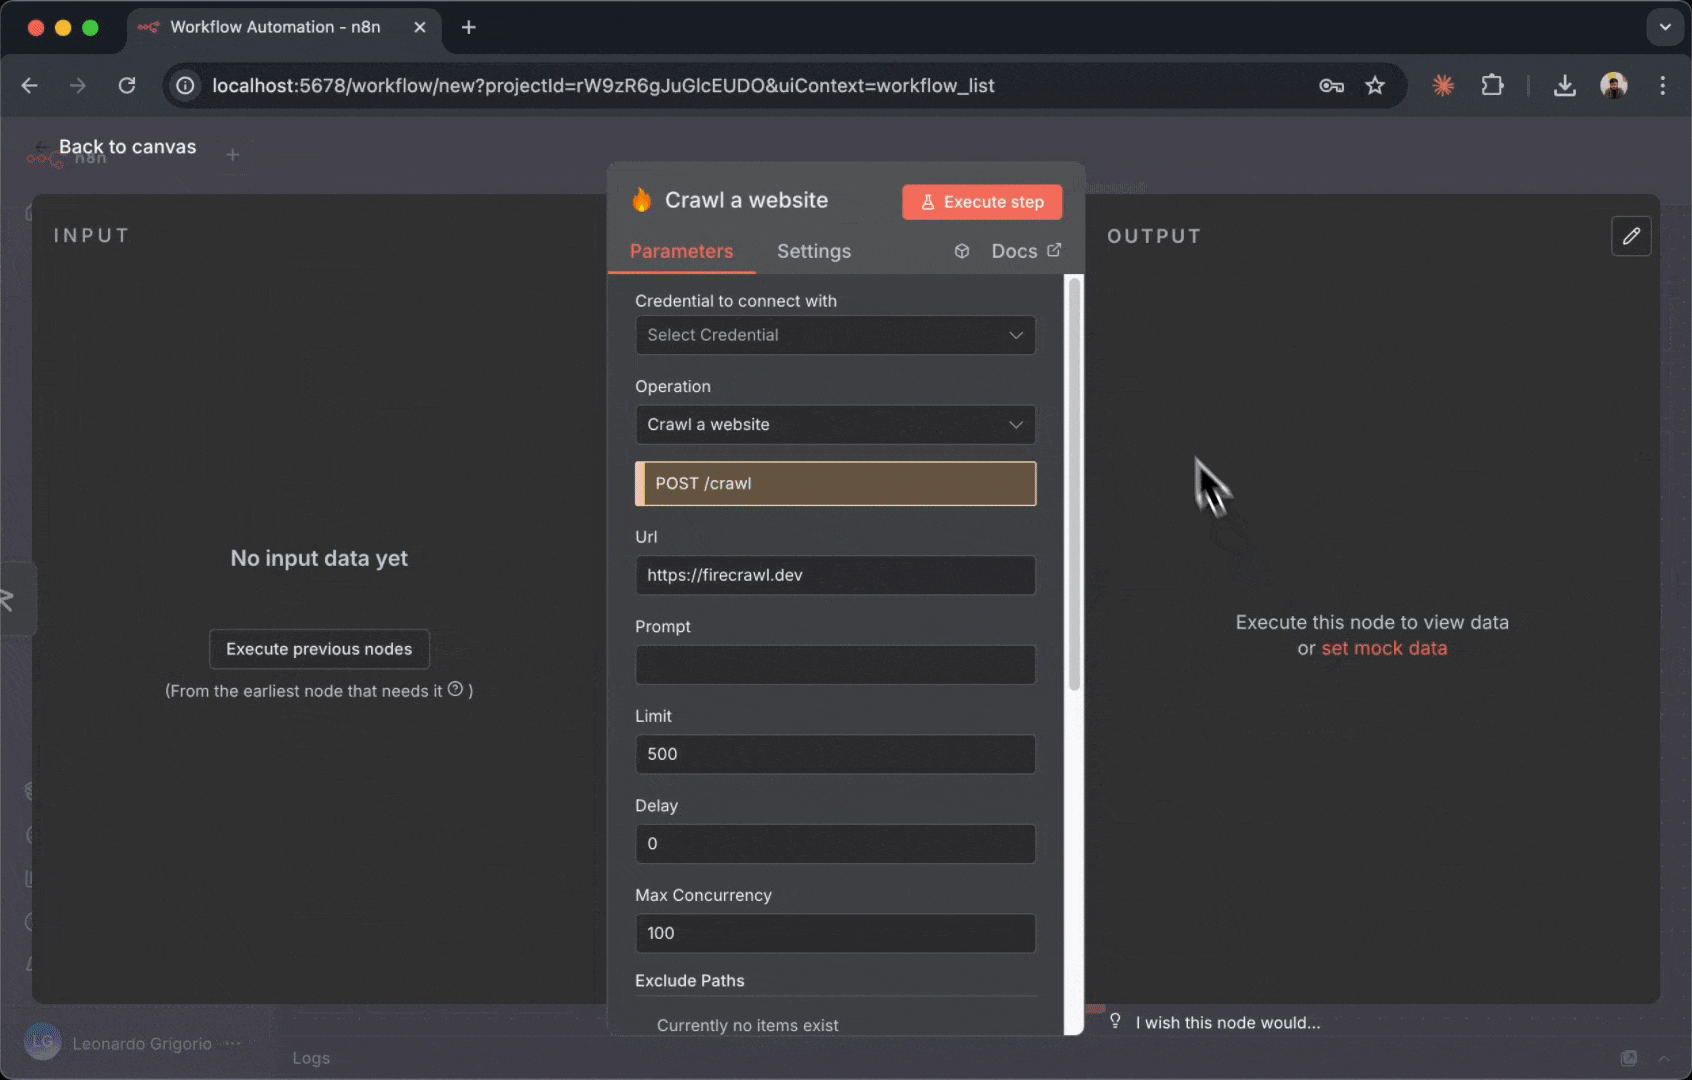
- インストール後、Firecrawlノードをクリックしてキャンバスに追加します
Firecrawl APIキーを接続する
Firecrawlノードを使用する前に、APIキーで認証する必要があります。- Firecrawlノードのボックスをクリックして、右側の構成パネルを開きます
- 上部に「接続に使用する認証情報」のドロップダウンが表示されます
- 初めての場合は、「新しい認証情報を作成」をクリックします
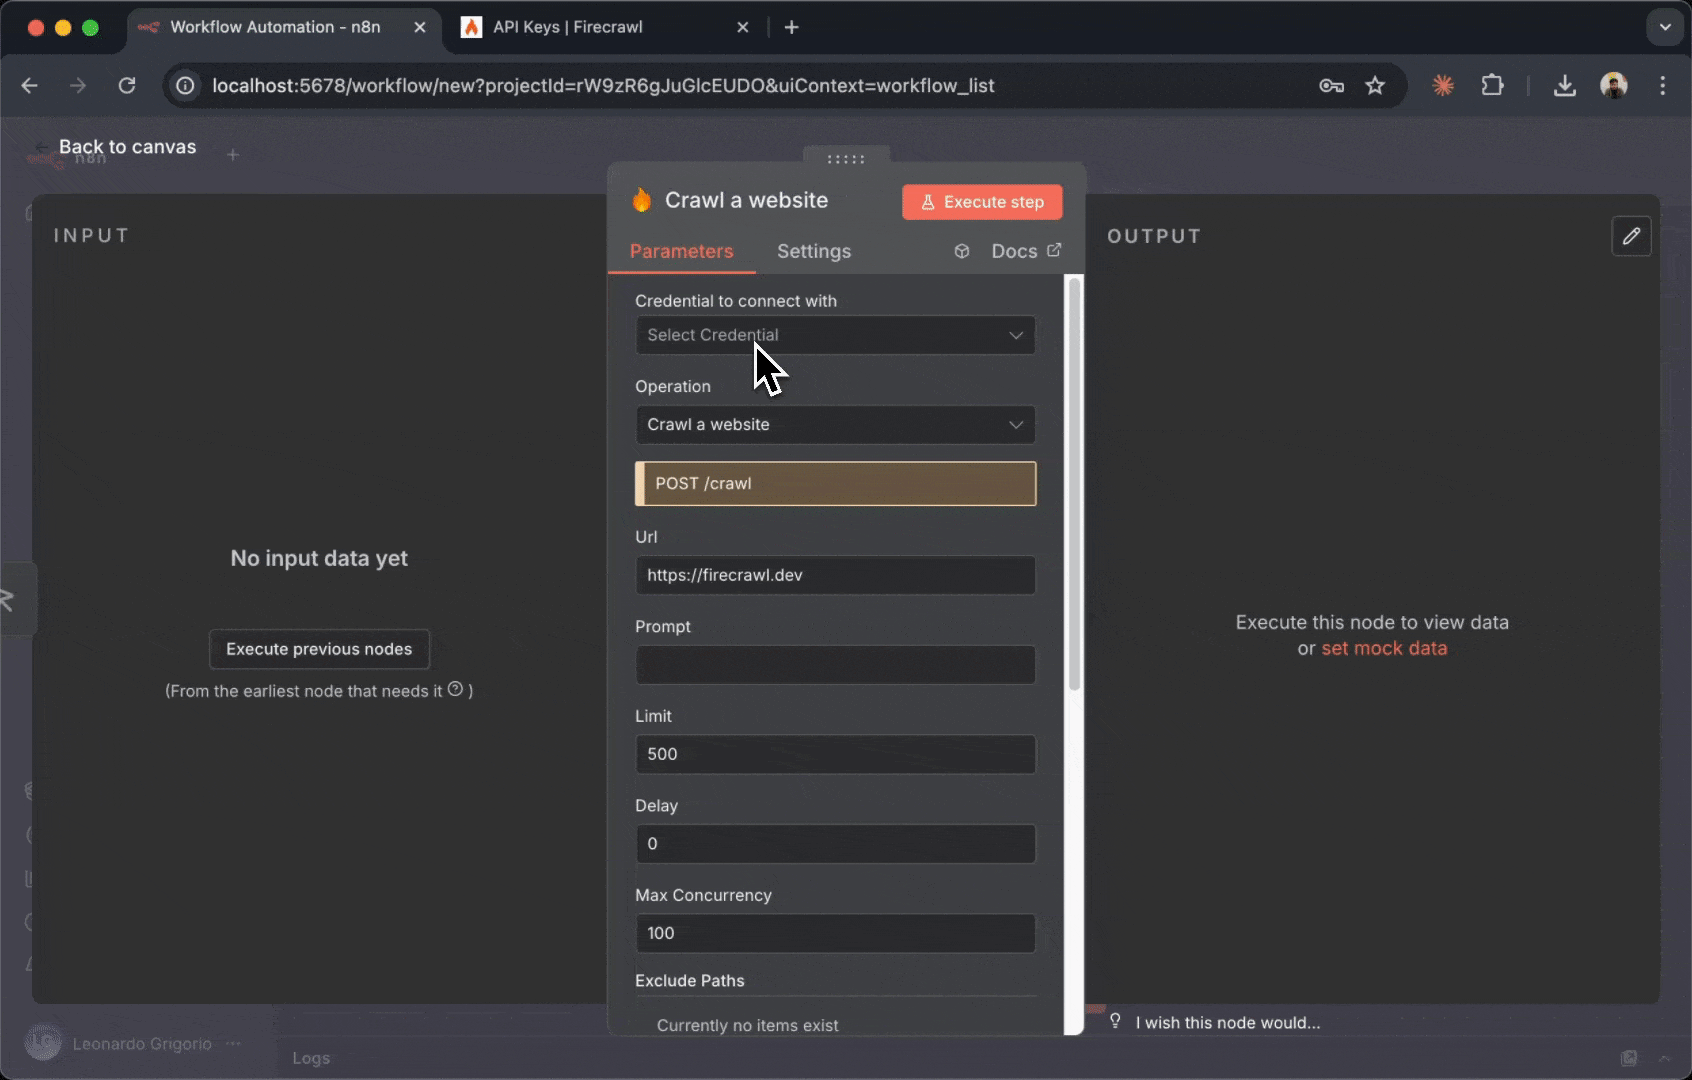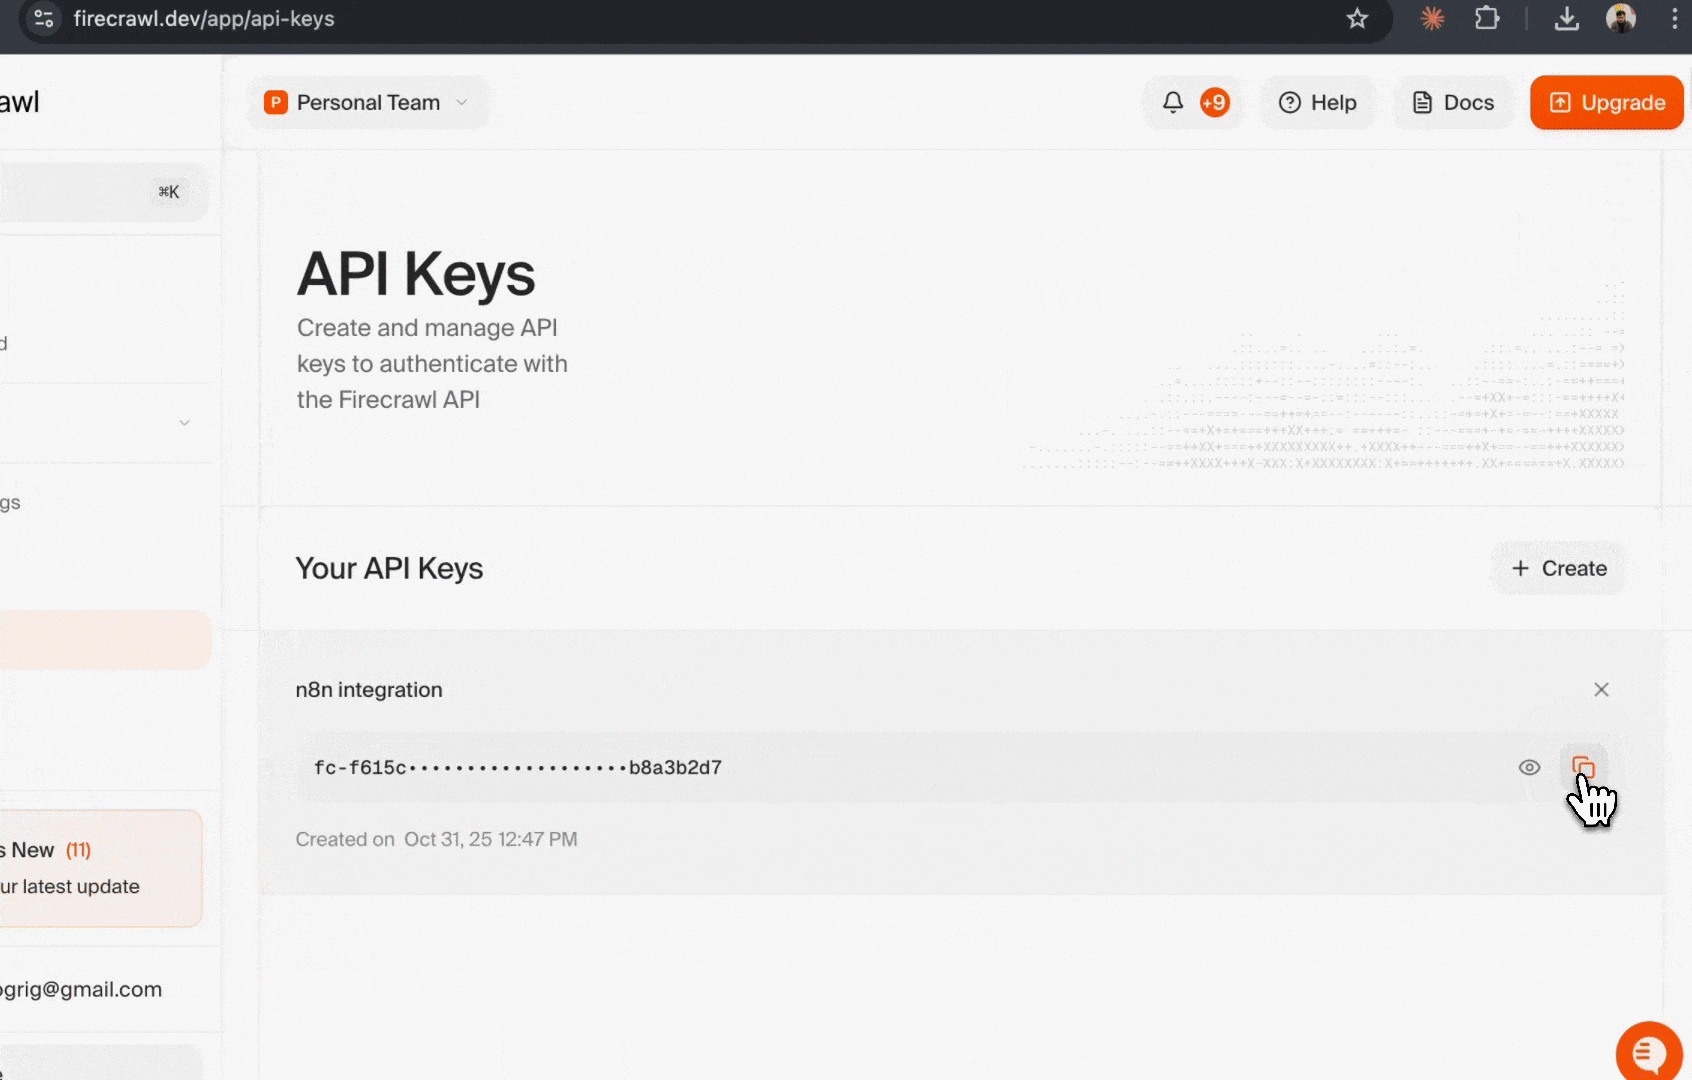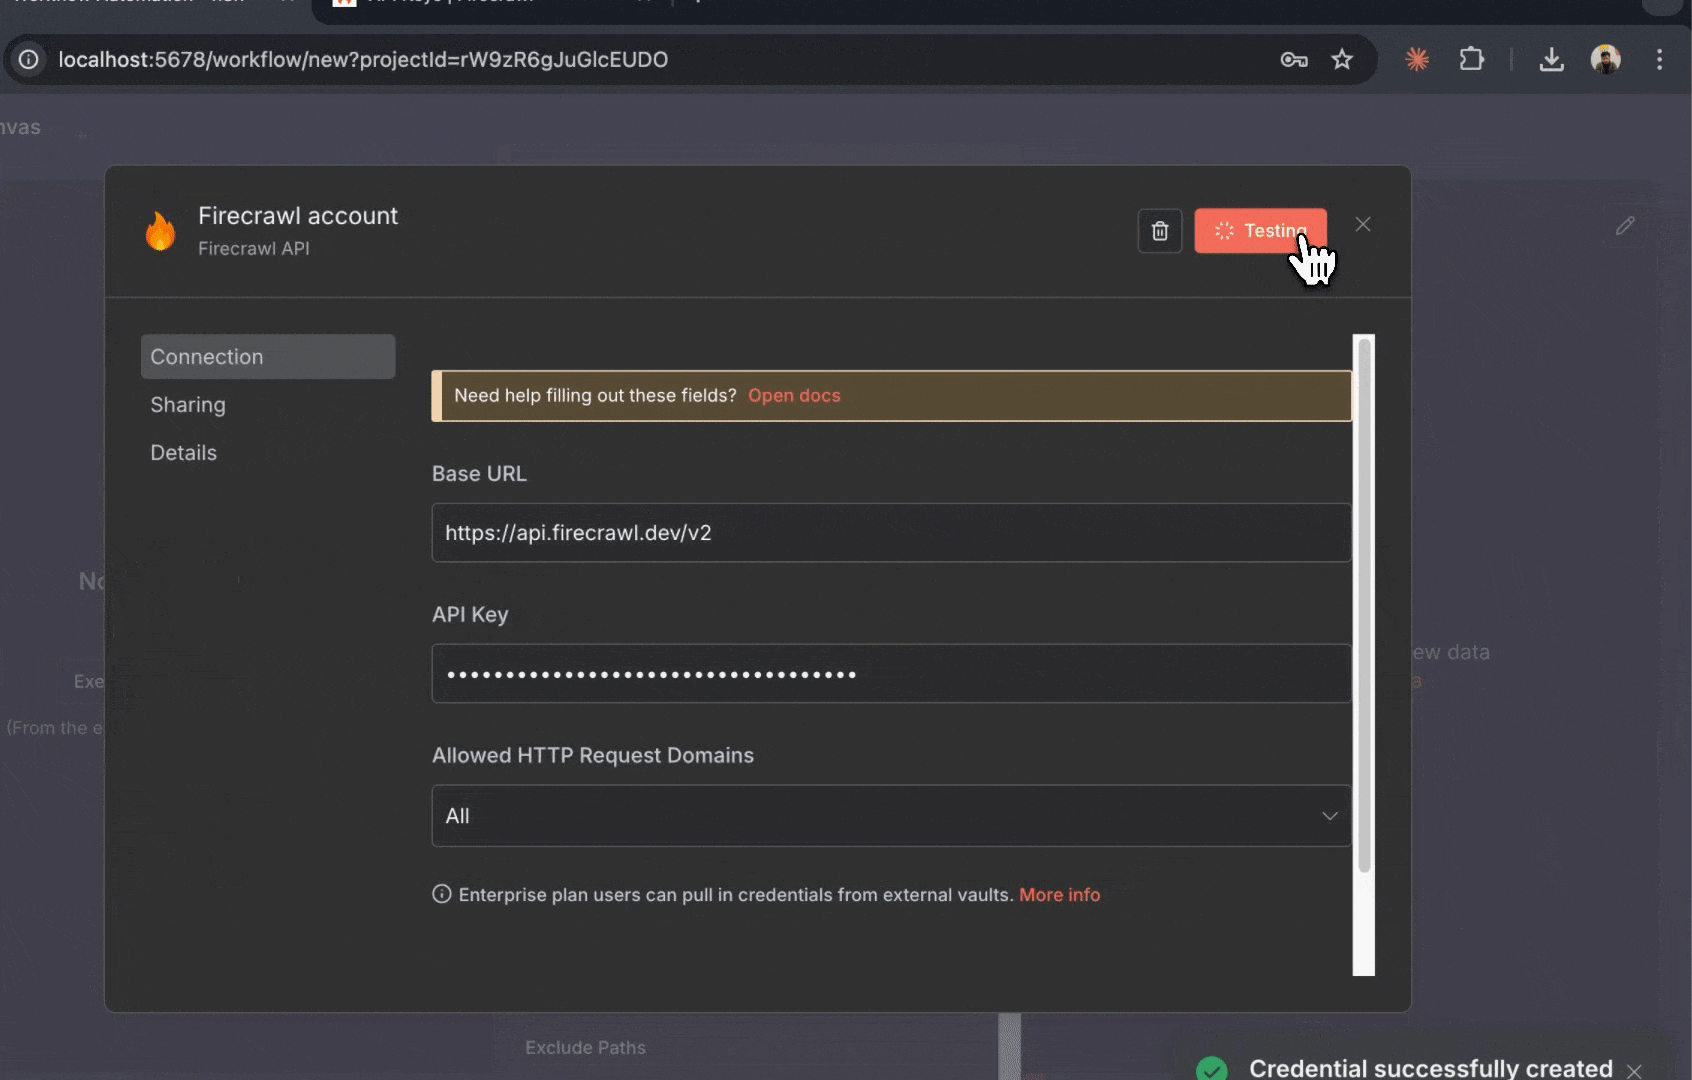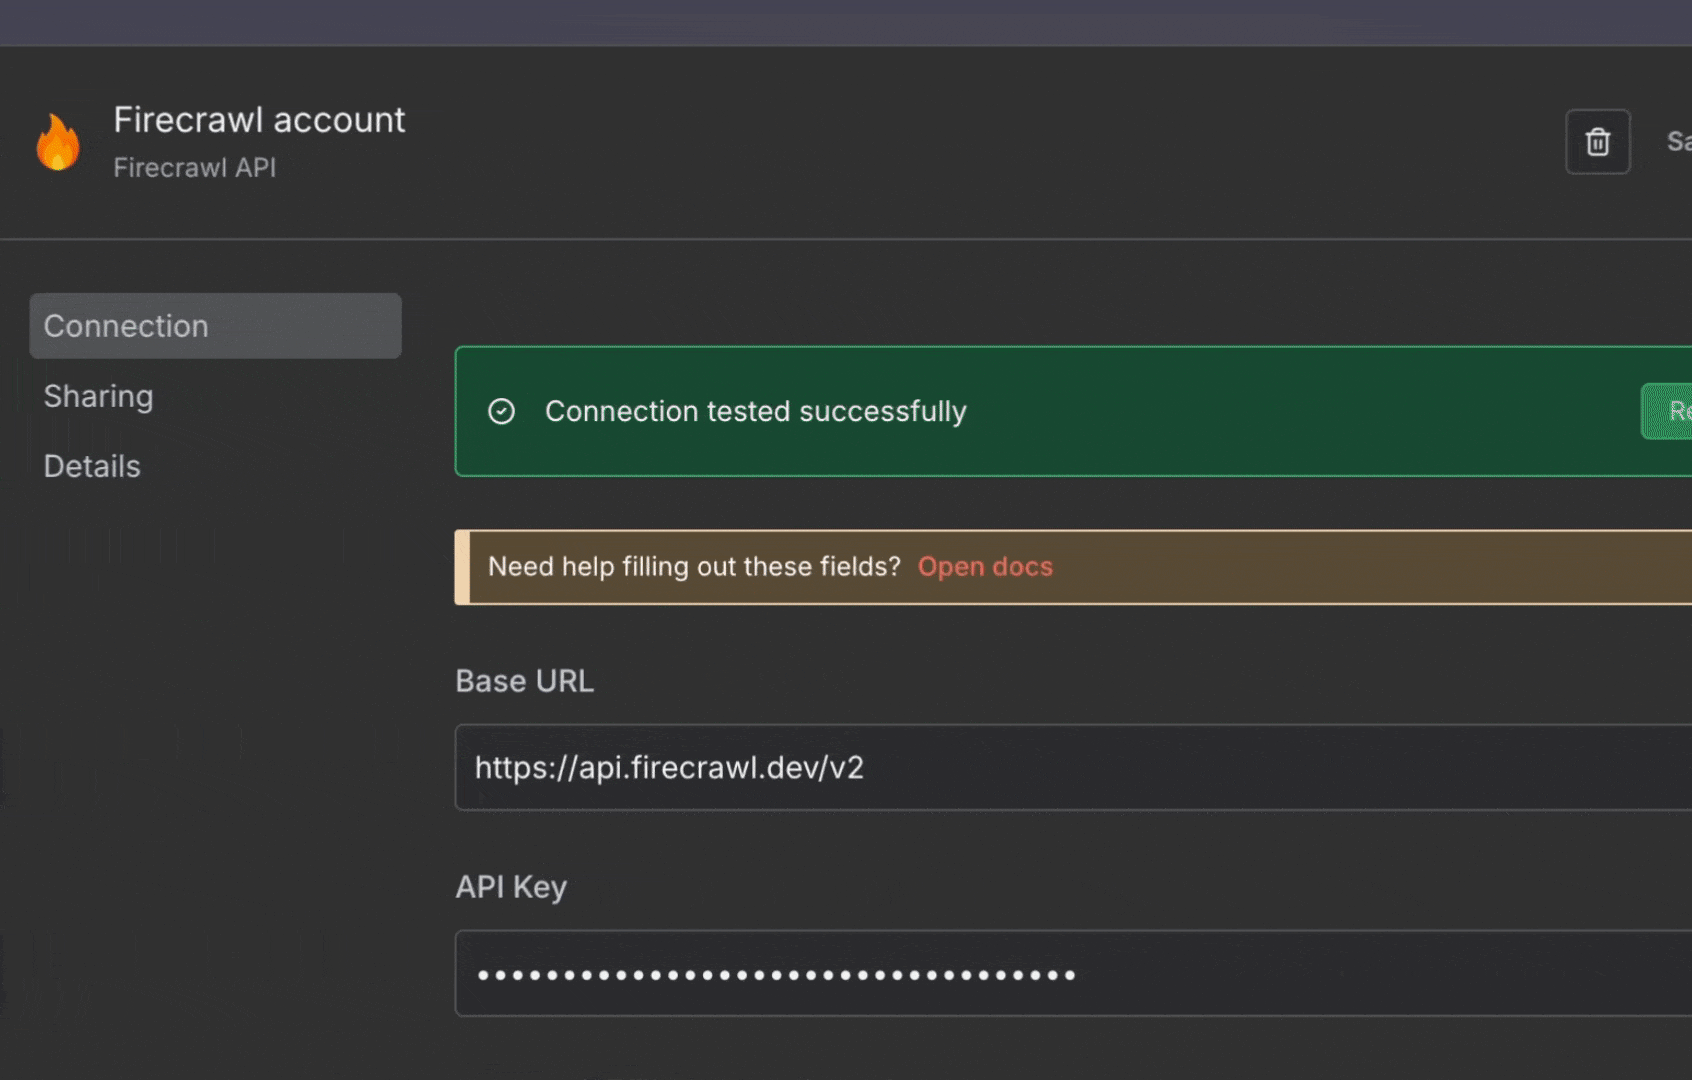
- 認証情報の構成ウィンドウが開きます
- この認証情報の名前を入力します (例: 「My Firecrawl Account」)
- 「API Key」フィールドにFirecrawl APIキーを貼り付けます
- 下部の「保存」をクリックします
認証情報には Base URL フィールドもあり、デフォルト値は
https://api.firecrawl.dev/v2 です。古いバージョンのノードで作成した認証情報では、https://api.firecrawl.dev/v1 が設定されたままになっている場合があります。Base URL が v1 のままだと、Agent、Browser、Interact など v2 でのみ提供されているオペレーションが 404 エラー (“The resource you are requesting could not be found”) で失敗します。その場合は認証情報を開き、Base URL を https://api.firecrawl.dev/v2 に変更してください。接続をテストする
Firecrawl ノードが正しく接続されていることを確認しましょう。- Firecrawl ノードを選択したまま、構成パネルを確認します
- リソース を「Scraping」に、オペレーション を「Scrape URL」に設定します
- 「URL」フィールドに
https://firecrawl.devと入力します - その他の設定は、ひとまずデフォルトのままにします
- 「Execute step」ボタンをクリックします
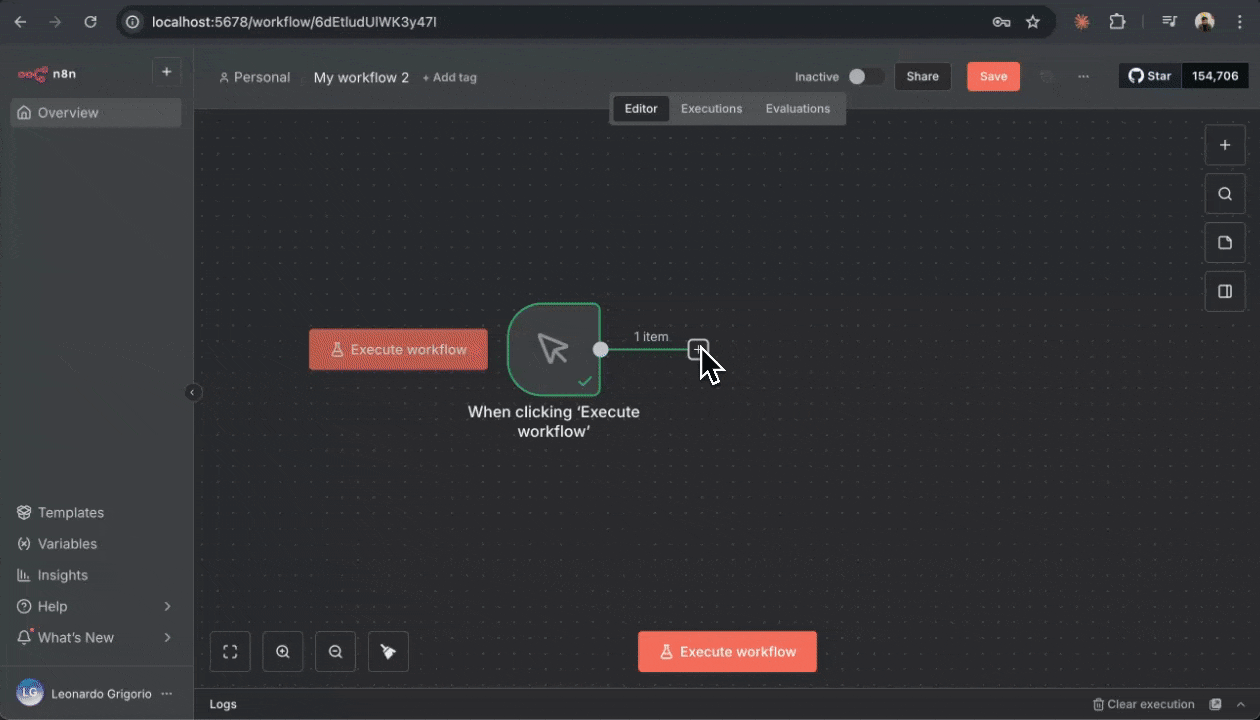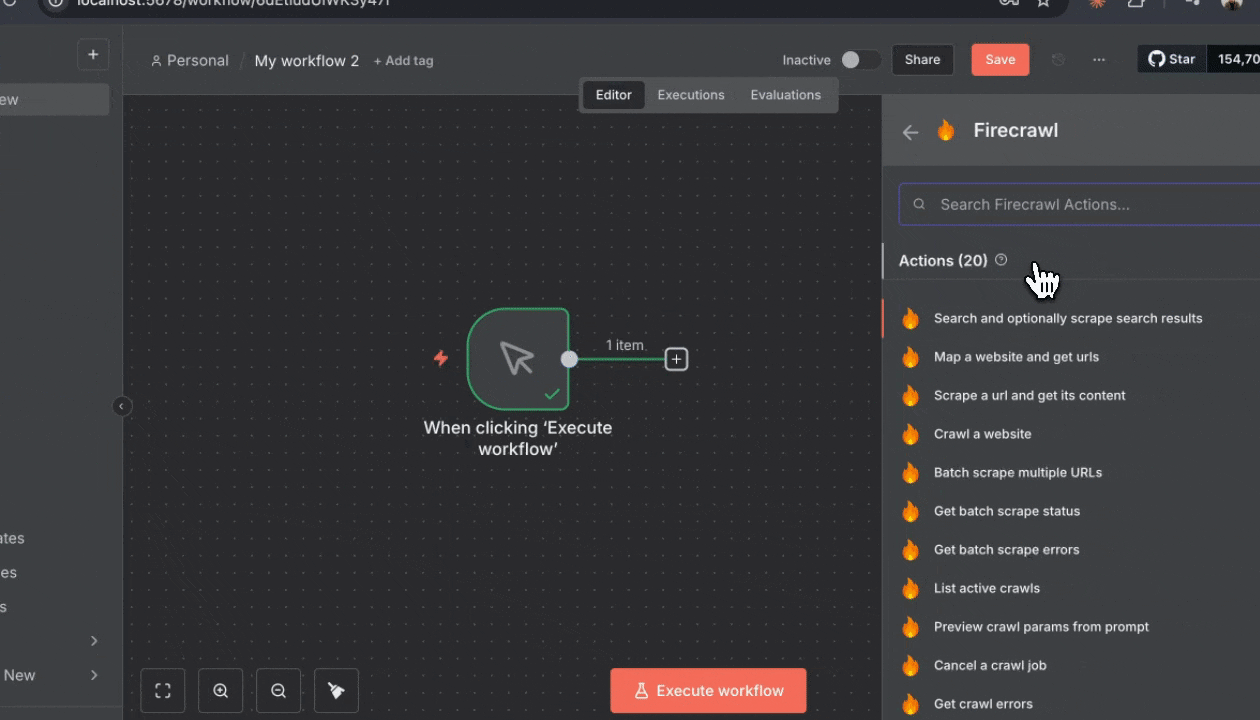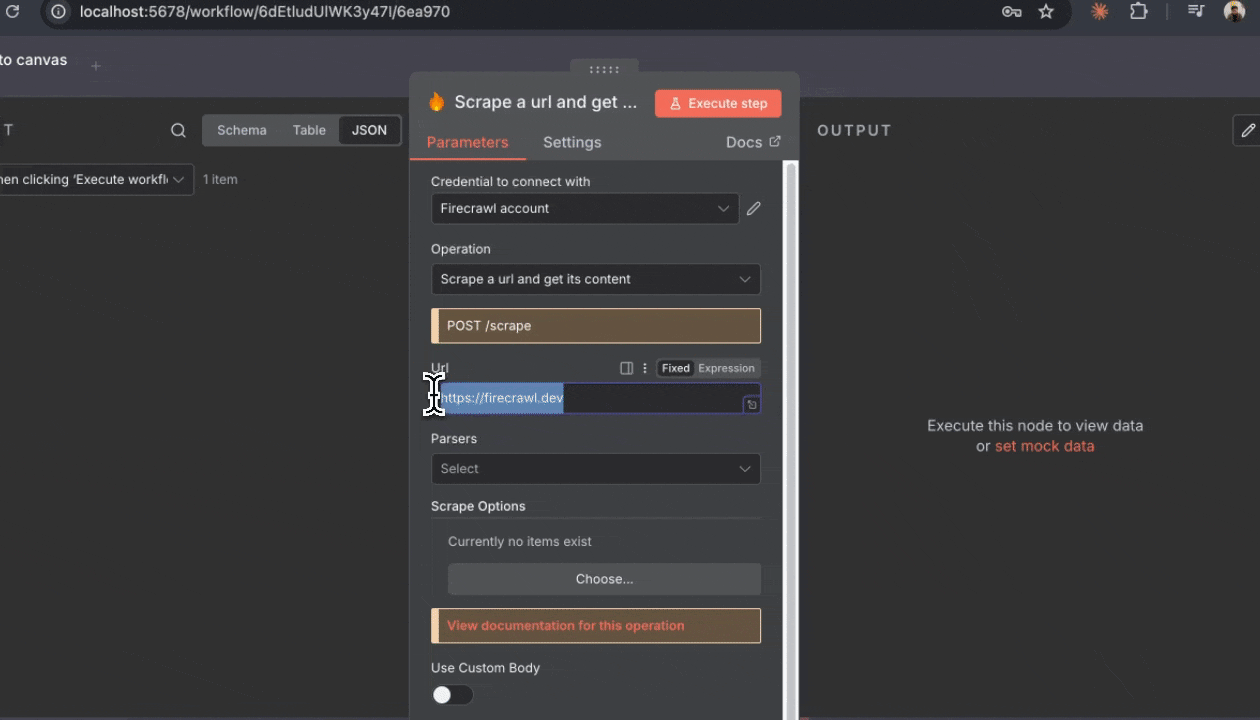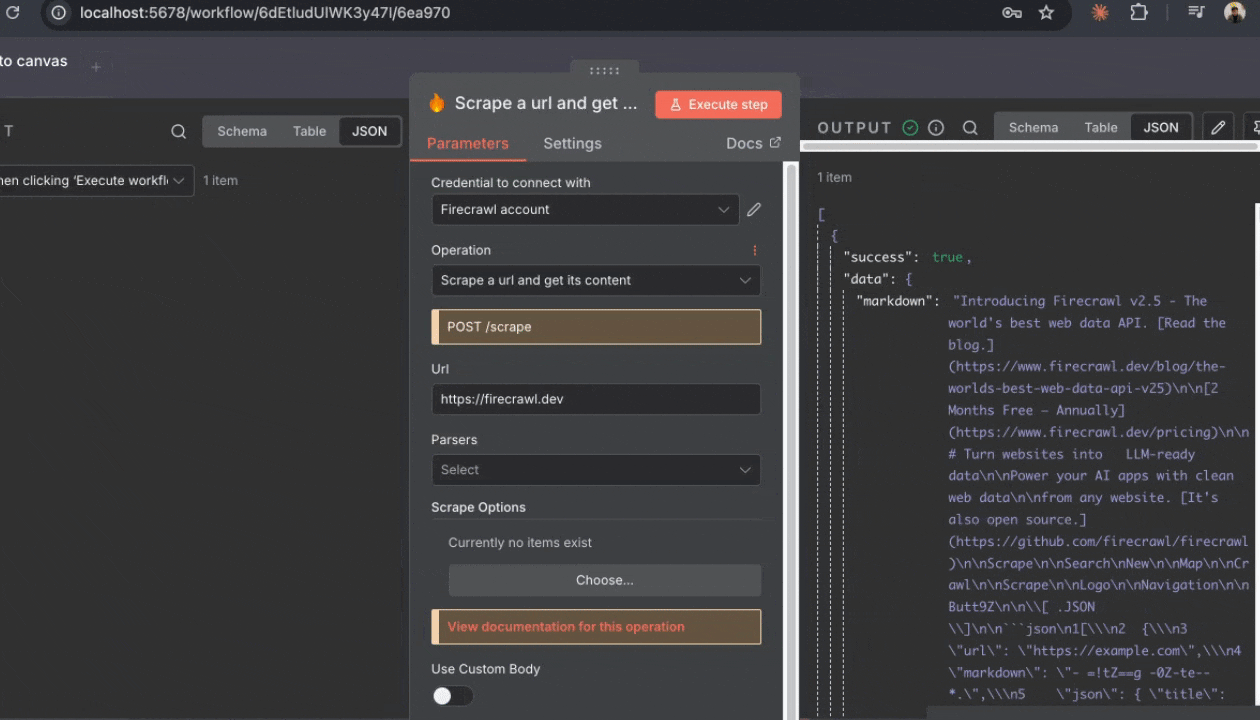
ステップ4: Telegramボットを作成する
最初のワークフローを構築する前に、通知を受け取るためのTelegramボットを作成します。Telegramボットは無料で、TelegramのBotFatherから簡単に作成できます。BotFather でボットを作成する
- スマートフォンまたはデスクトップで Telegram を開きます
- Telegram 公式ボットの「@BotFather」を検索します
- 「Start」をクリックして BotFather との会話を開始します
/newbotコマンドを送信して新しいボットを作成します- BotFather からボット名を選ぶよう求められます (ユーザーに表示される名前です)
- 「My Firecrawl Bot」のような名前を入力します
- 次に、ボットのユーザー名を選択します。末尾は「bot」である必要があります (例: 「my_firecrawl_updates_bot」)
- ユーザー名が利用可能な場合、BotFather がボットを作成し、ボットトークンを含むメッセージを送信します
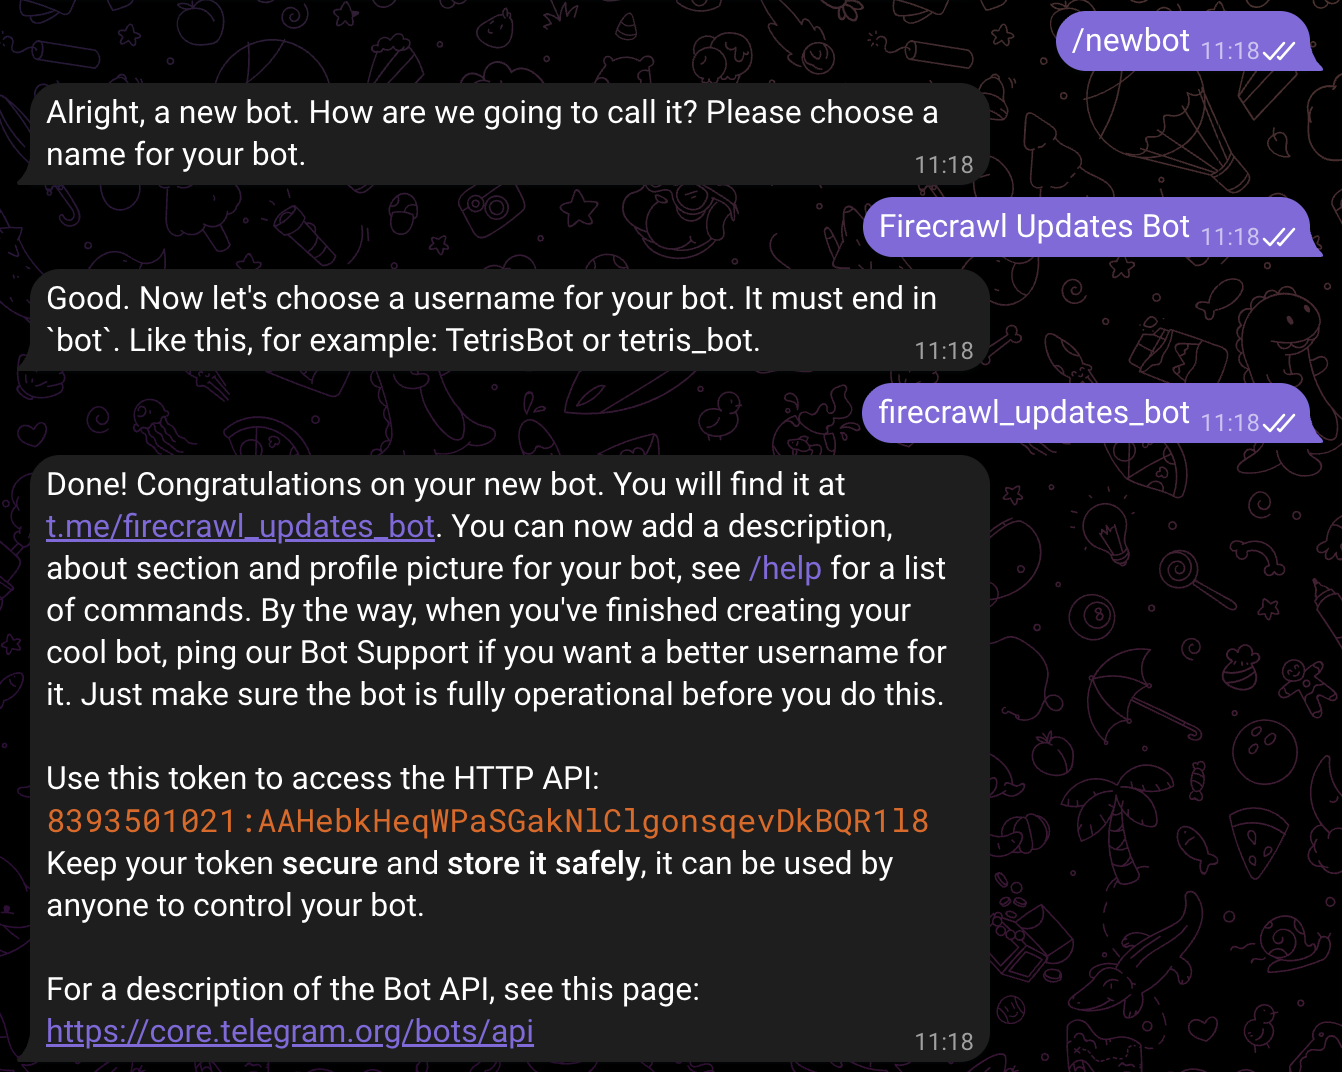
ボットトークンは安全に保存してください。このトークンは、n8n があなたのボットとしてメッセージを送信するためのパスワードのようなものです。絶対に公開しないでください。
チャットIDを取得する
自分宛てにメッセージを送信するには、TelegramのチャットIDが必要です。- Webブラウザを開き、次のURLにアクセスします (
YOUR_BOT_TOKENを実際のボットトークンに置き換えてください) 。 - このブラウザタブは開いたままにしておきます
- Telegramで、先ほど作成したボットのユーザー名を検索します
- “Start” をクリックして、ボットとの会話を開始します
- ボットに任意のメッセージを送信します (例: “hello”)
- ブラウザタブに戻り、ページを更新します
- JSONレスポンス内の
"chat":{"id":フィールドを探します "id":の横にある数字がチャットIDです (例:123456789)- このチャットIDは後で使うために保存しておきます
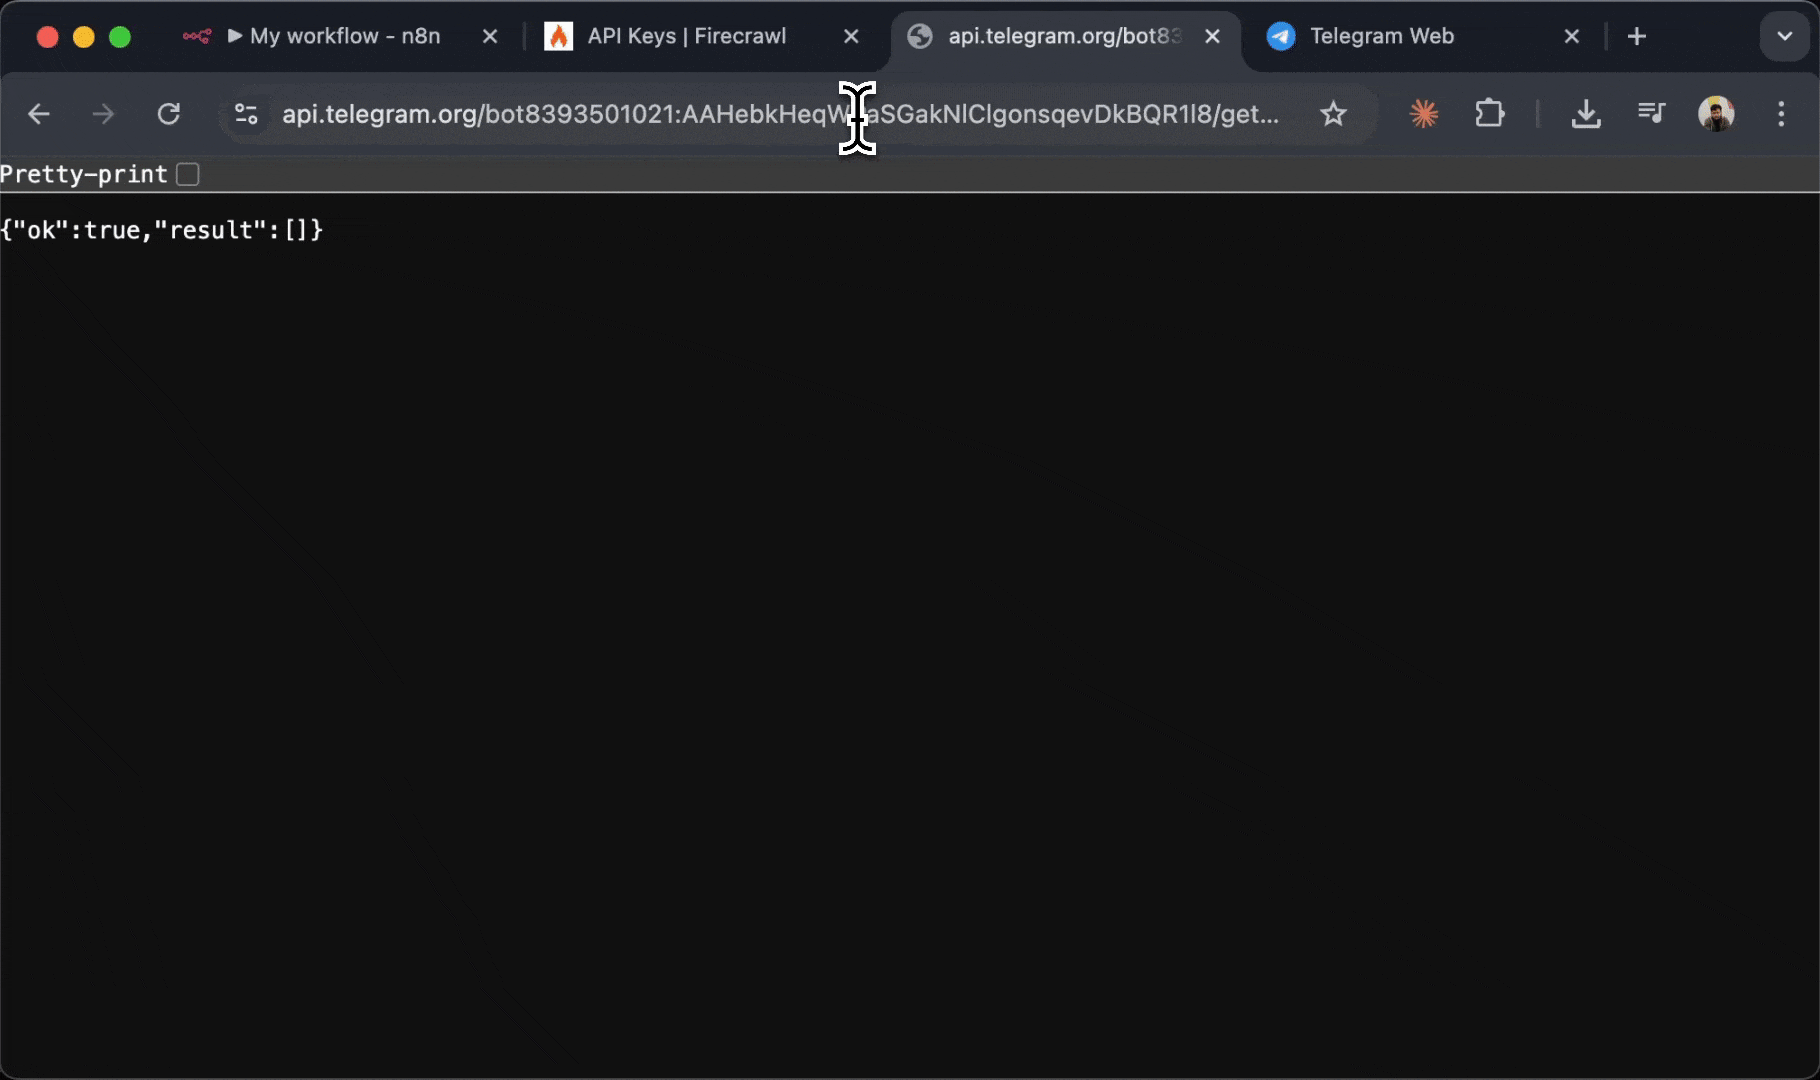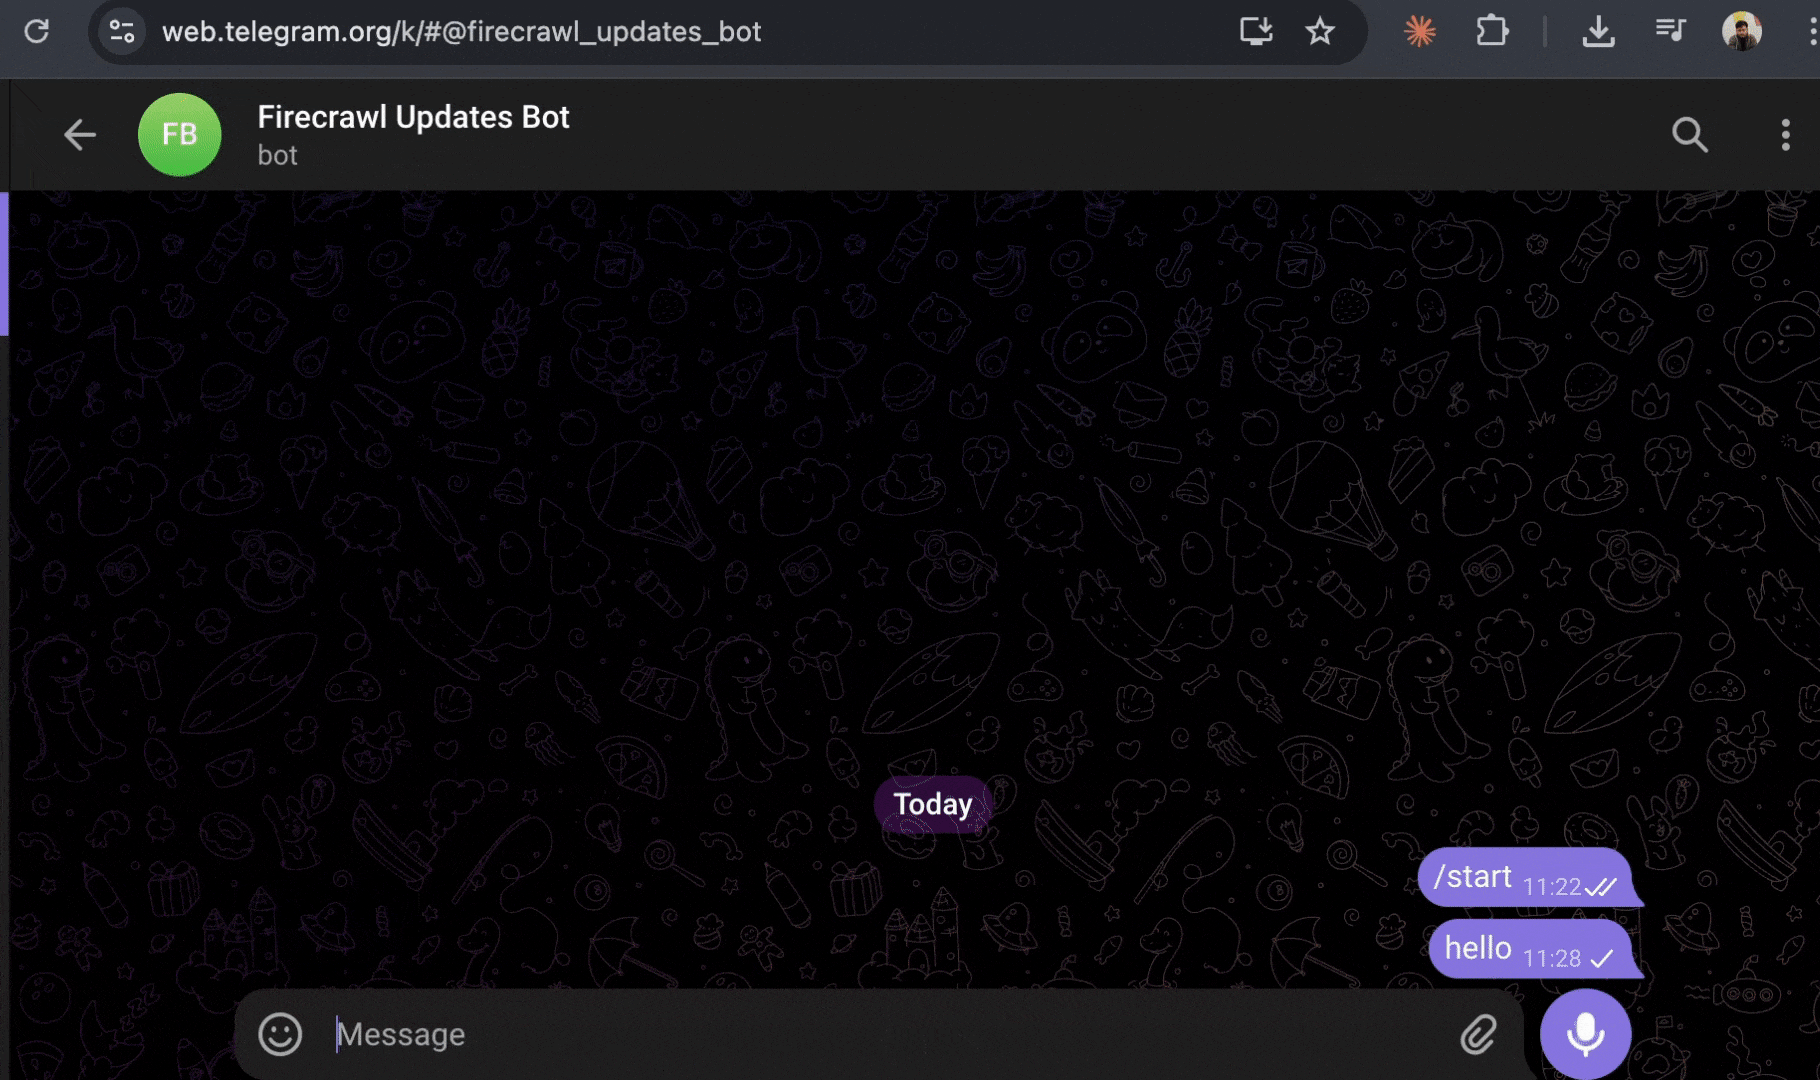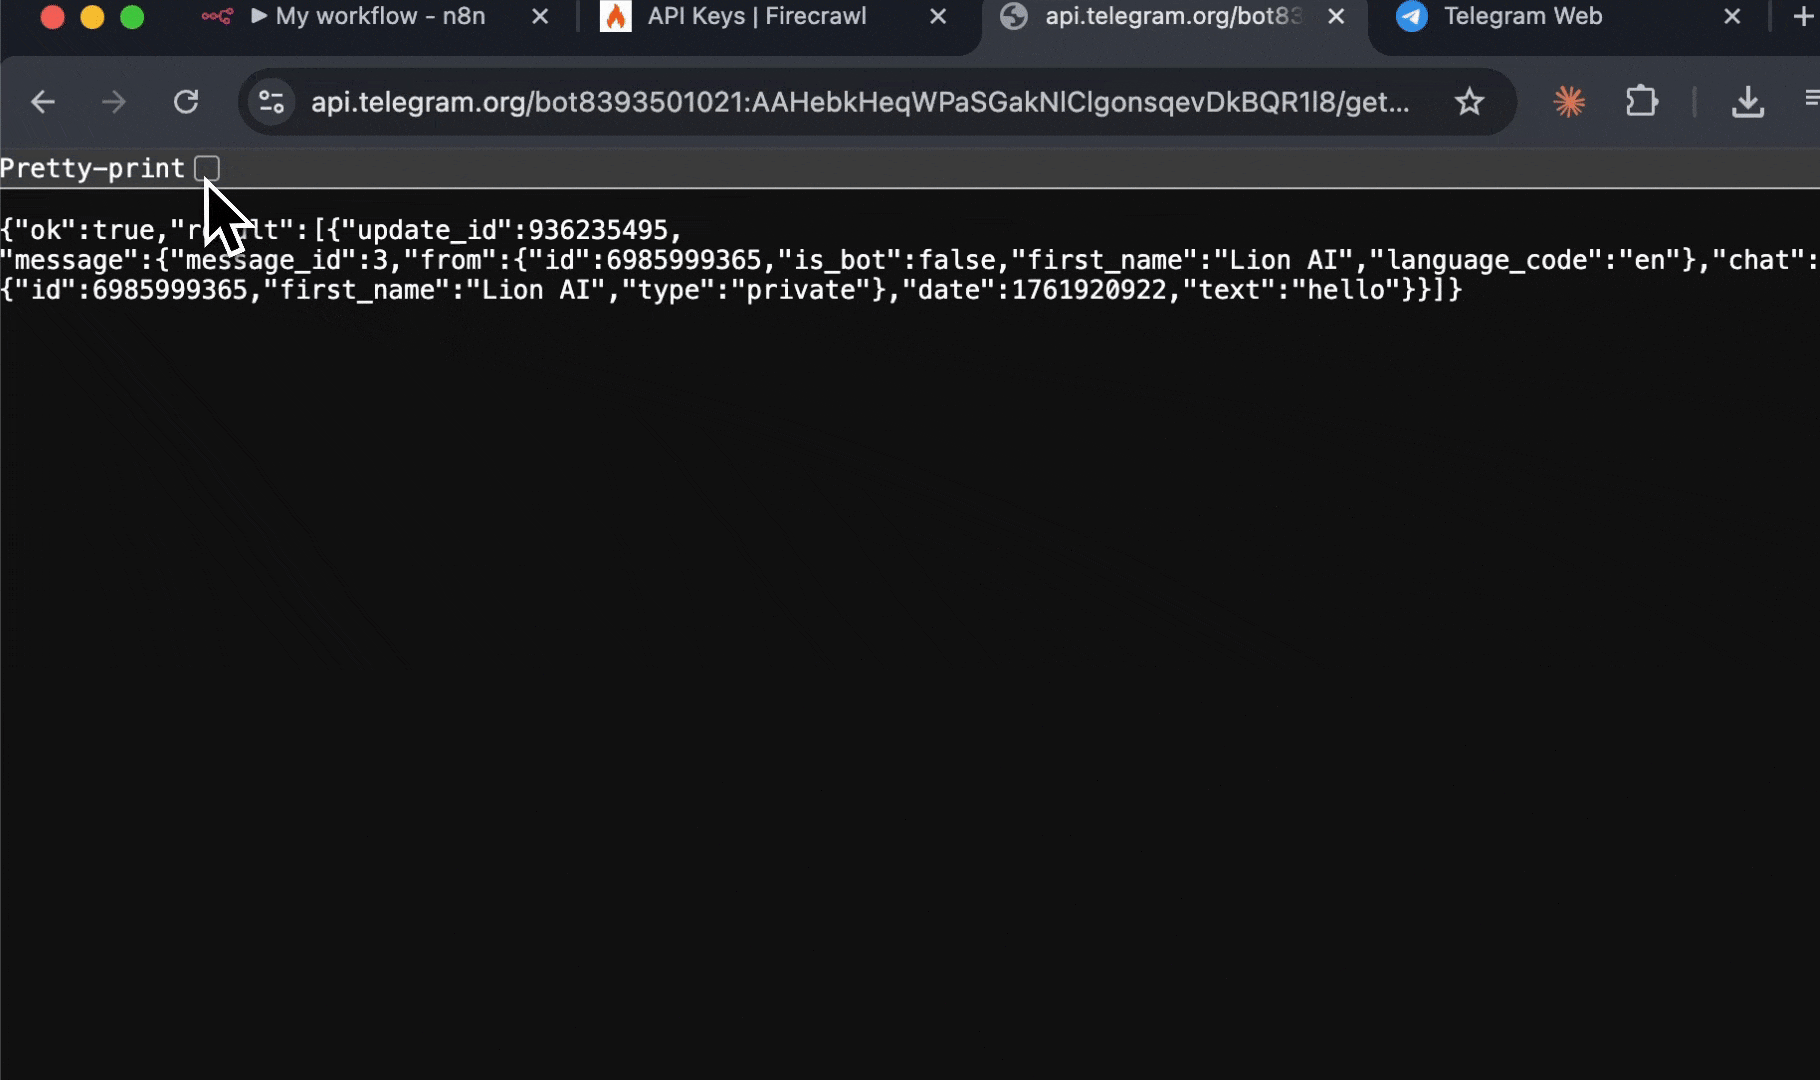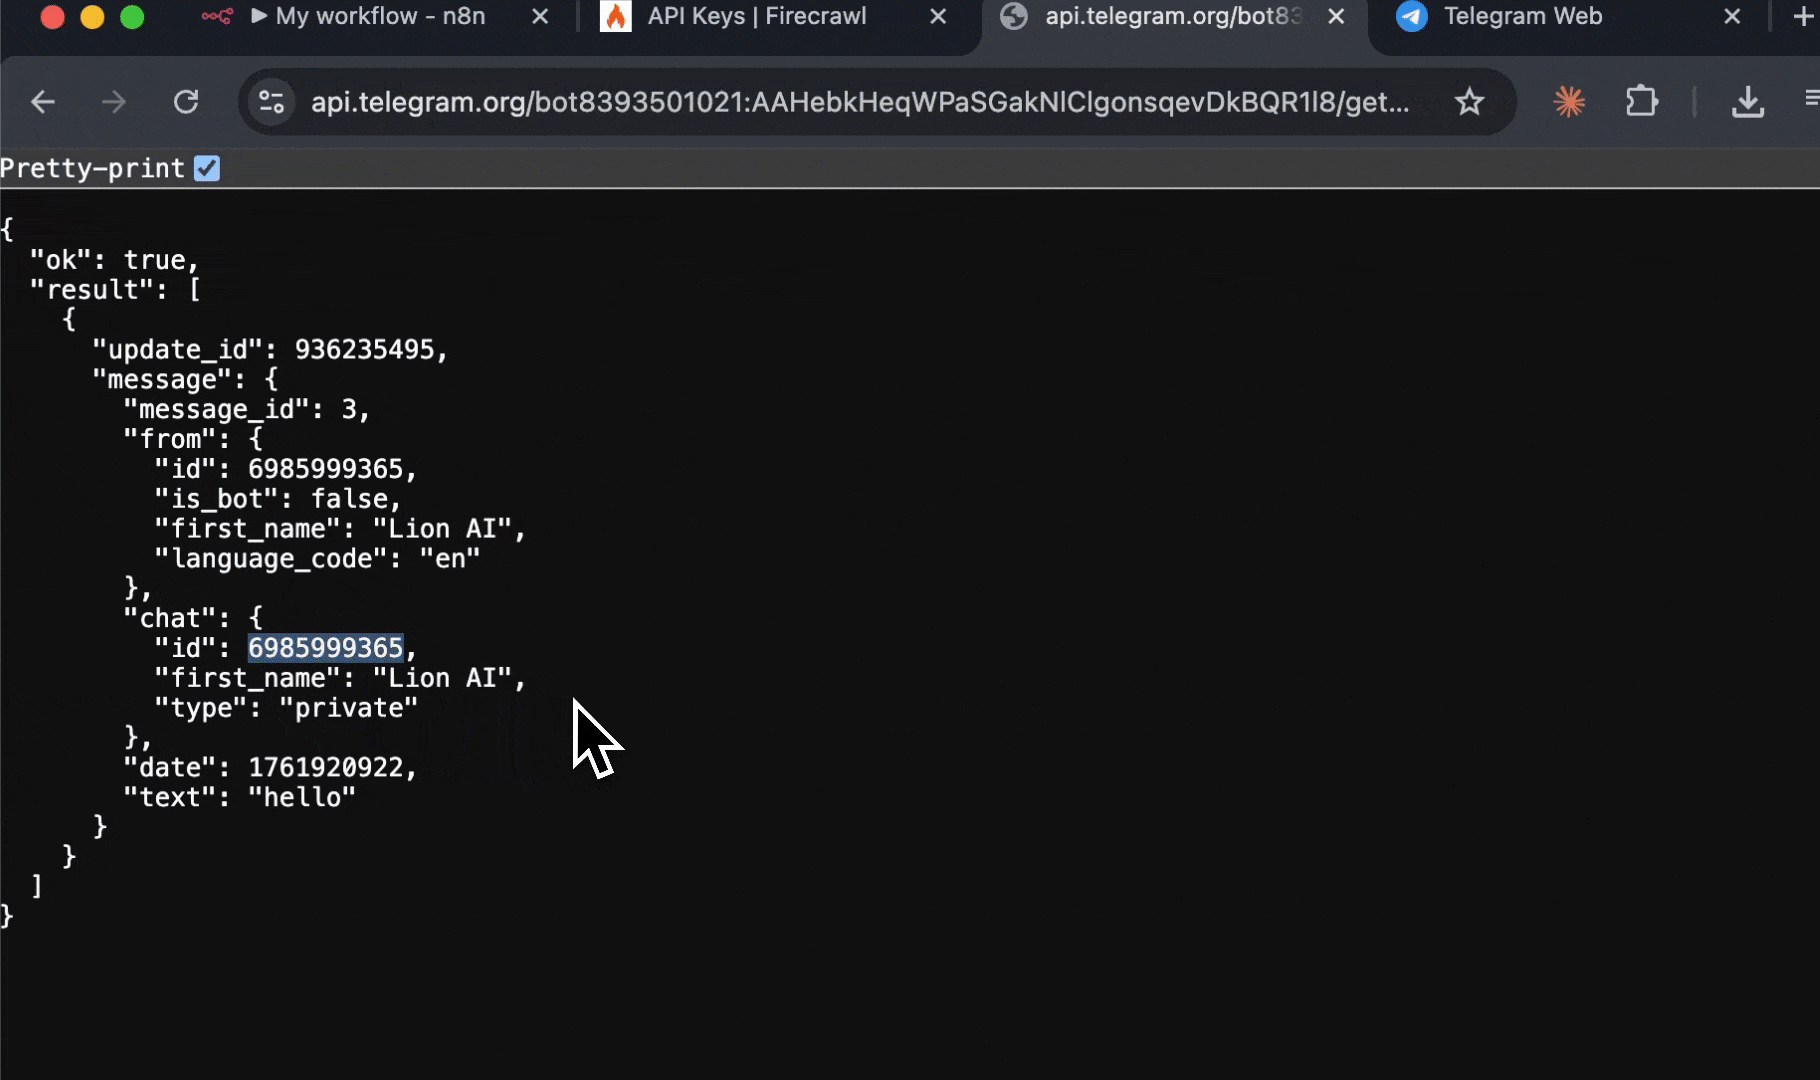
チャットIDは、ボットとの会話を一意に識別するIDです。これを使って、メッセージの送信先をn8nに指定します。
ステップ5: Telegramを使った実用的なワークフローの構築
Telegramに情報を直接送信する、実践的なワークフローを3つ構築してみましょう。これらの例では、さまざまなFirecrawlオペレーションと、Telegram通知への統合方法を紹介します。例 1: Firecrawl プロダクトアップデートの毎日の要約
Firecrawl のプロダクトアップデートの要約を毎朝 Telegram に配信します。 作成するもの:- Firecrawl のプロダクトアップデートブログを毎日午前 9 時にスクレイピング
- AI を使用してコンテンツの要約を生成
- 要約を Telegram に送信
- n8n で新しいワークフローを作成します
- Schedule Trigger ノードを追加します:
- キャンバス の ”+” ボタンをクリックします
- “Schedule Trigger” を検索します
- 次のように構成します: 毎日午前 9:00
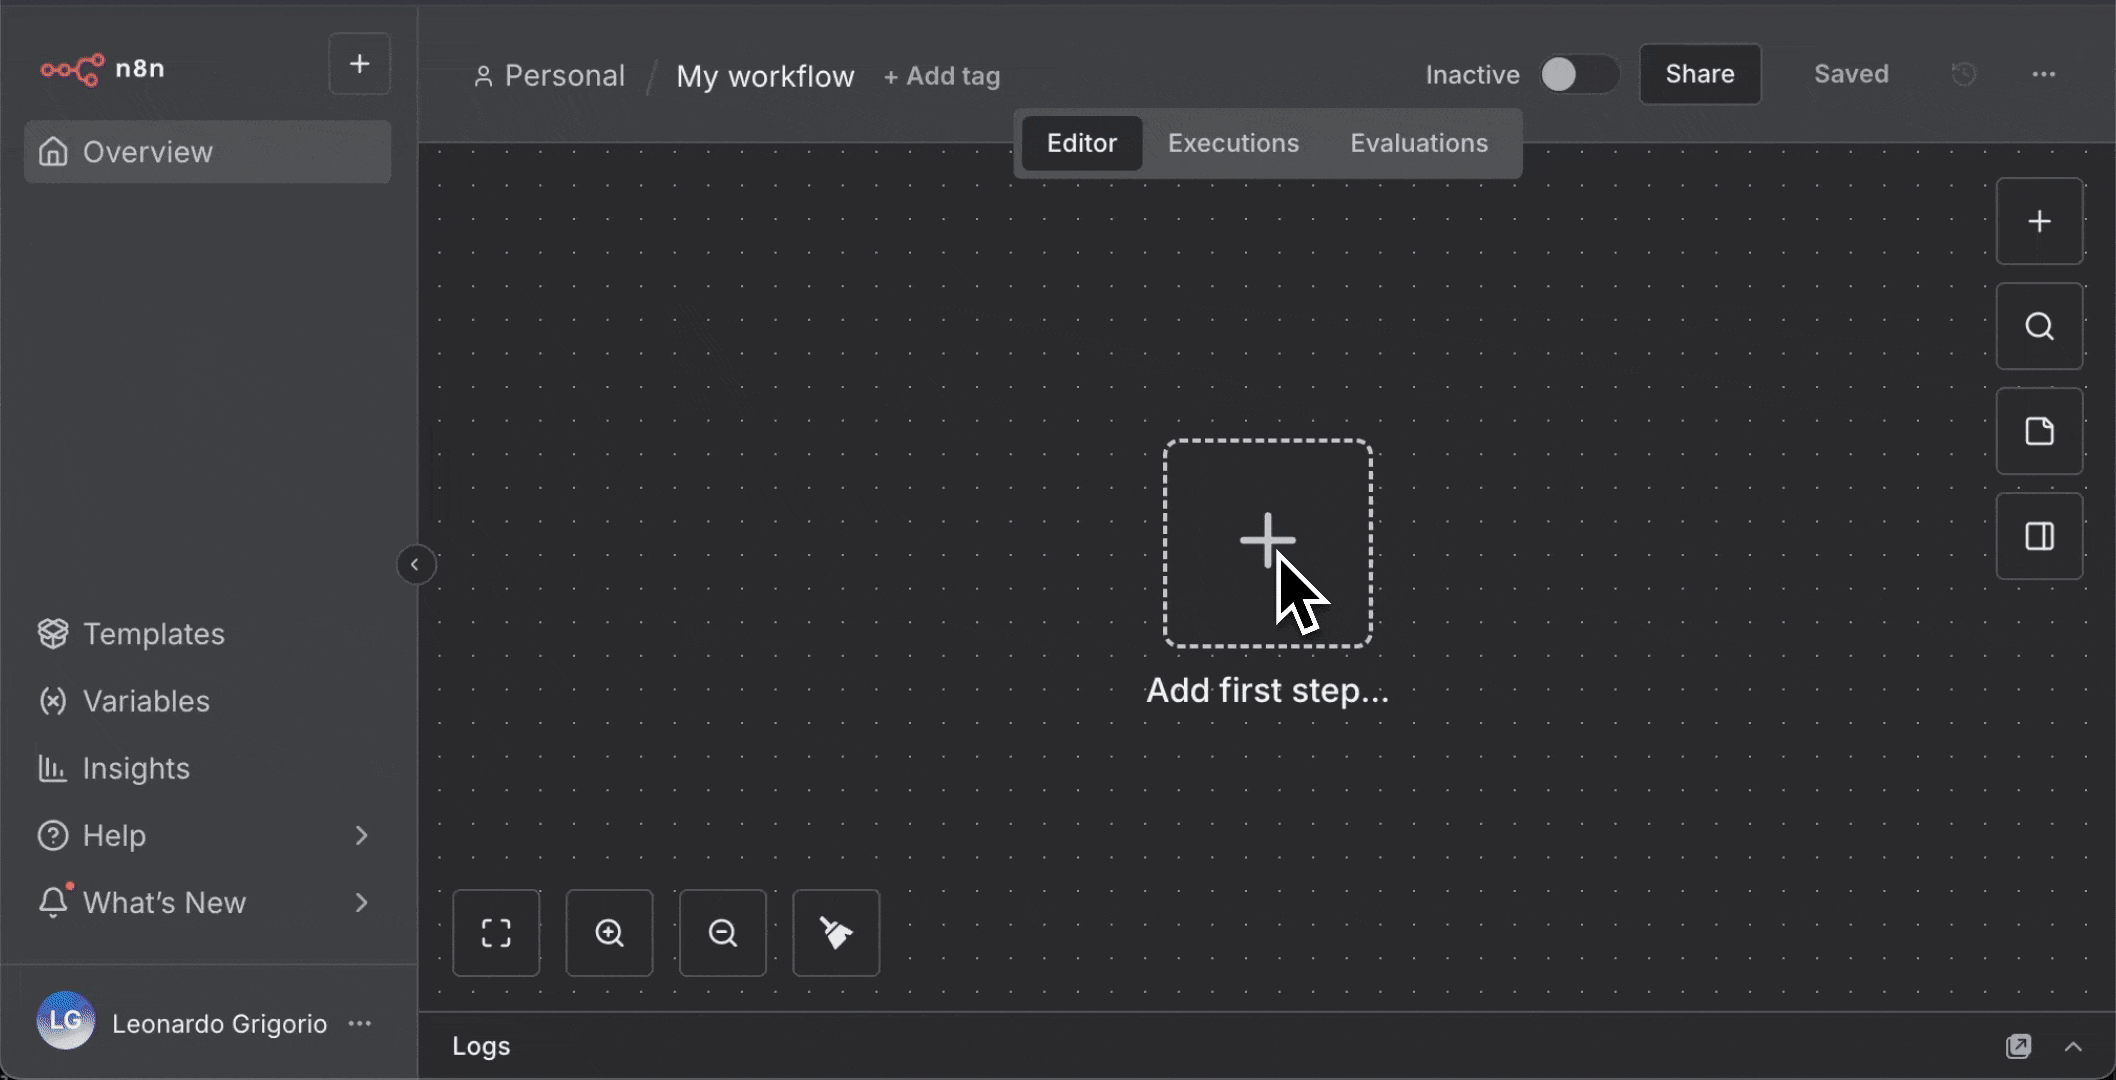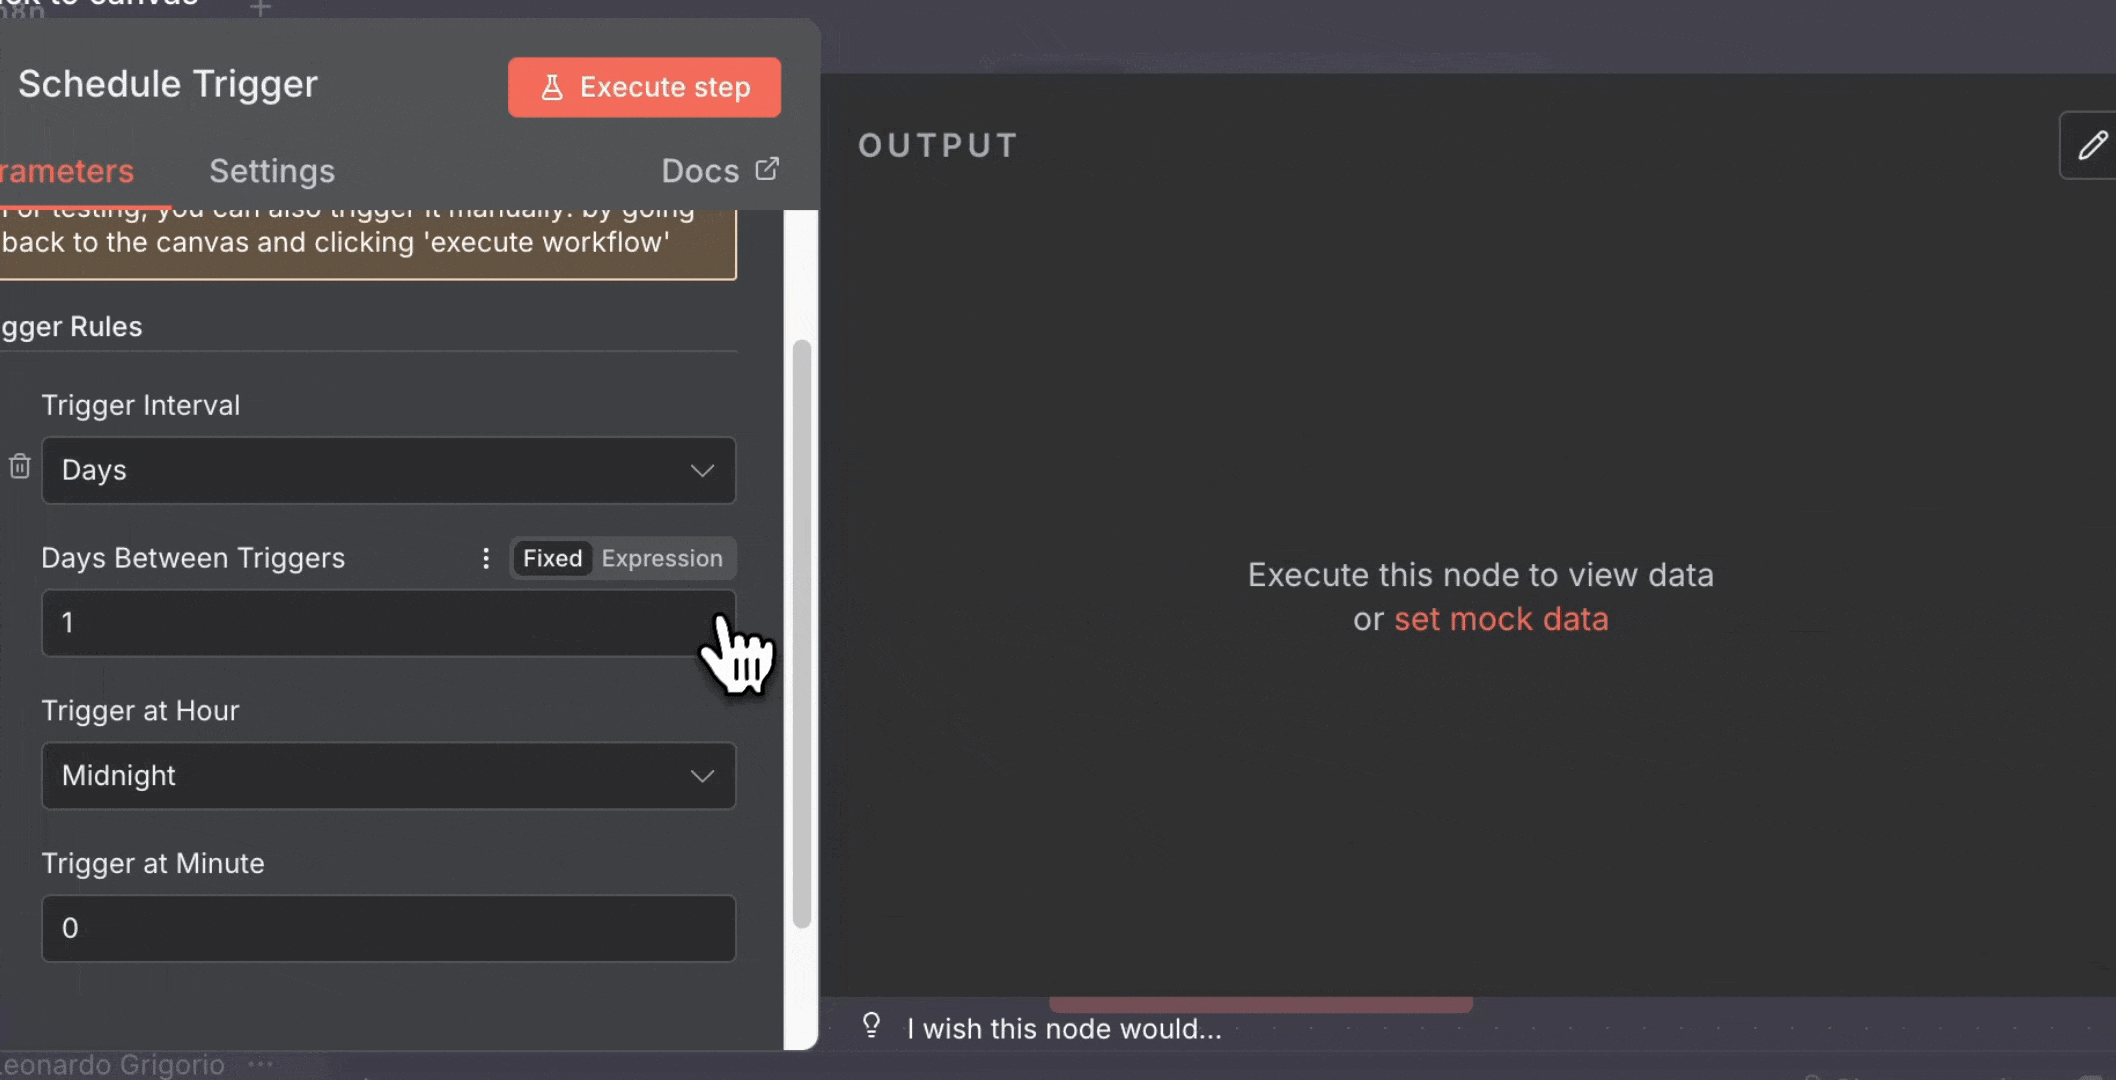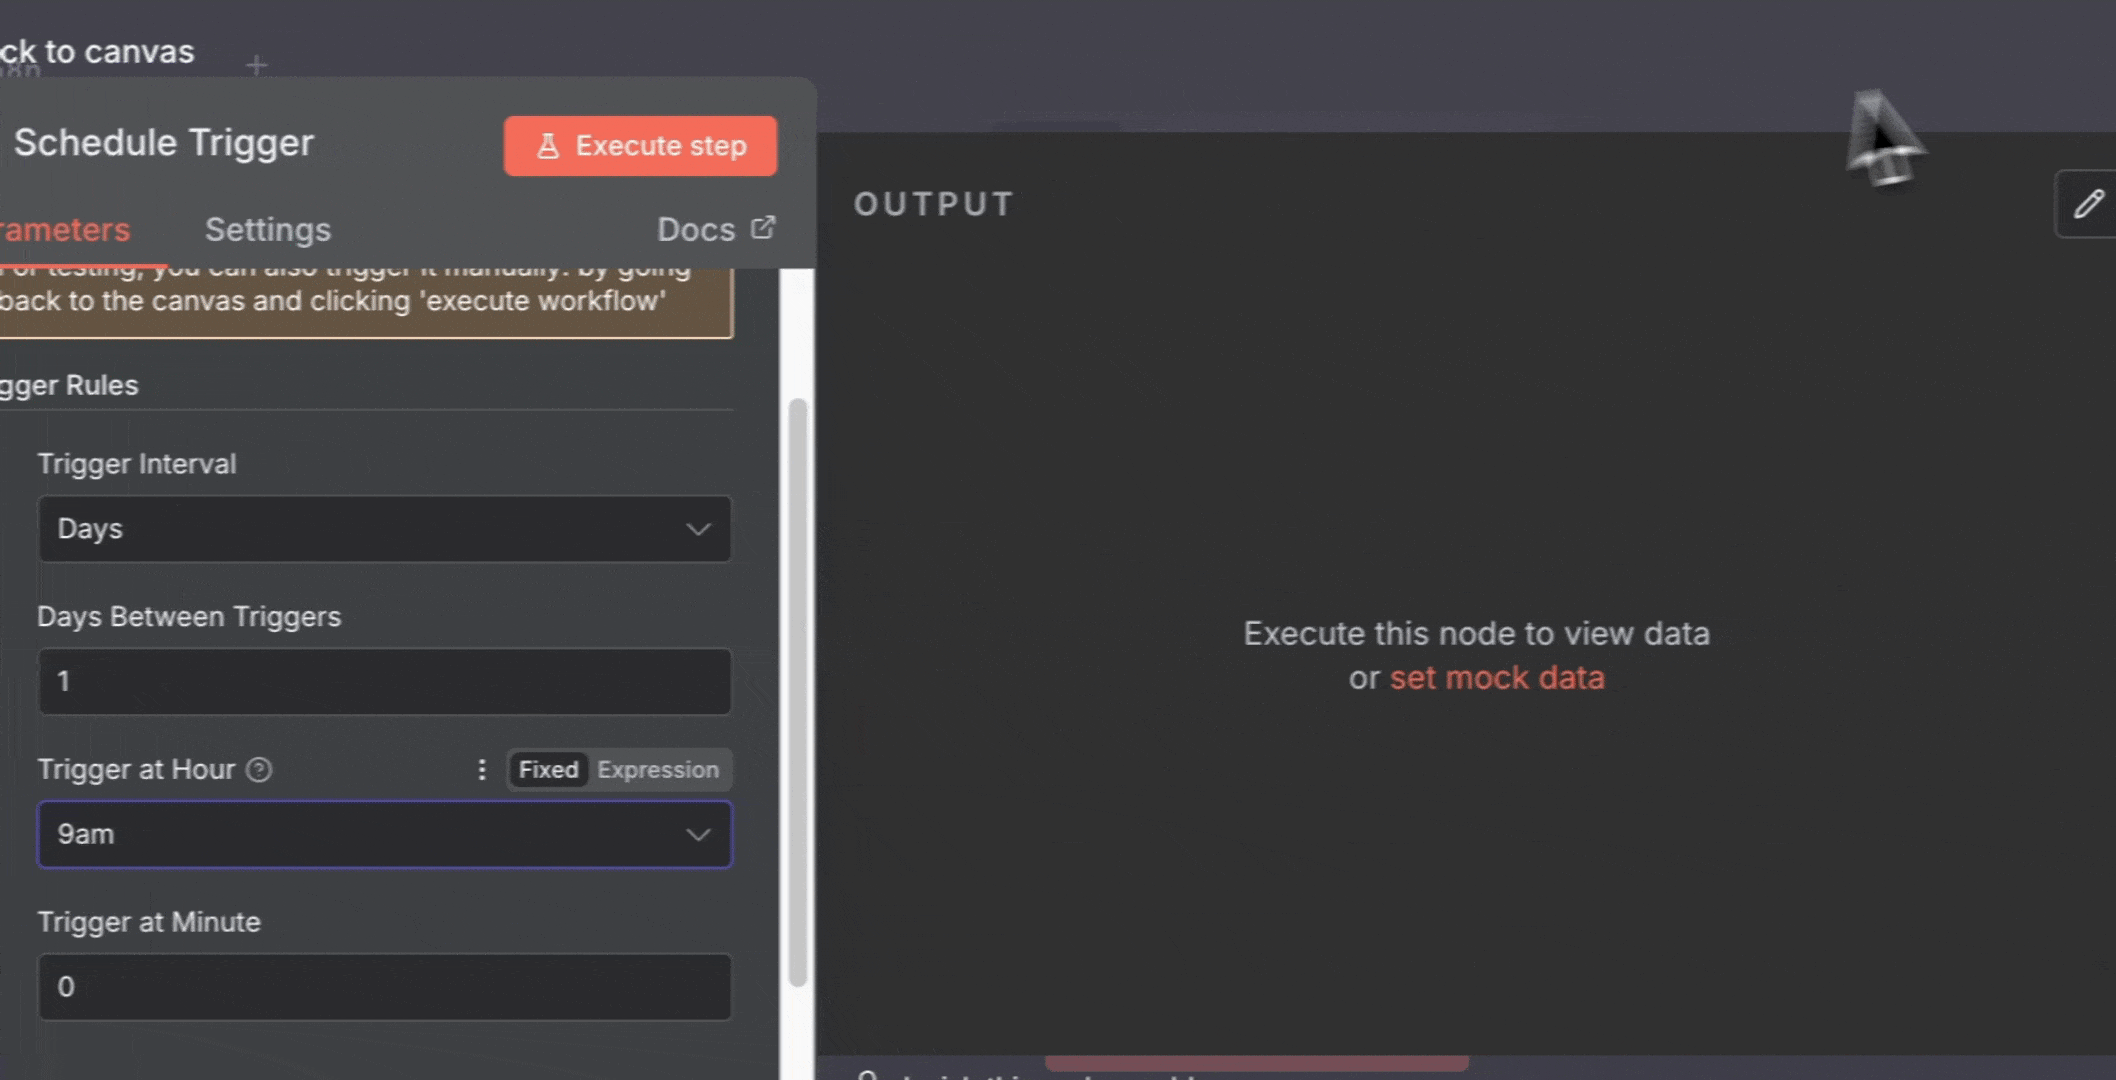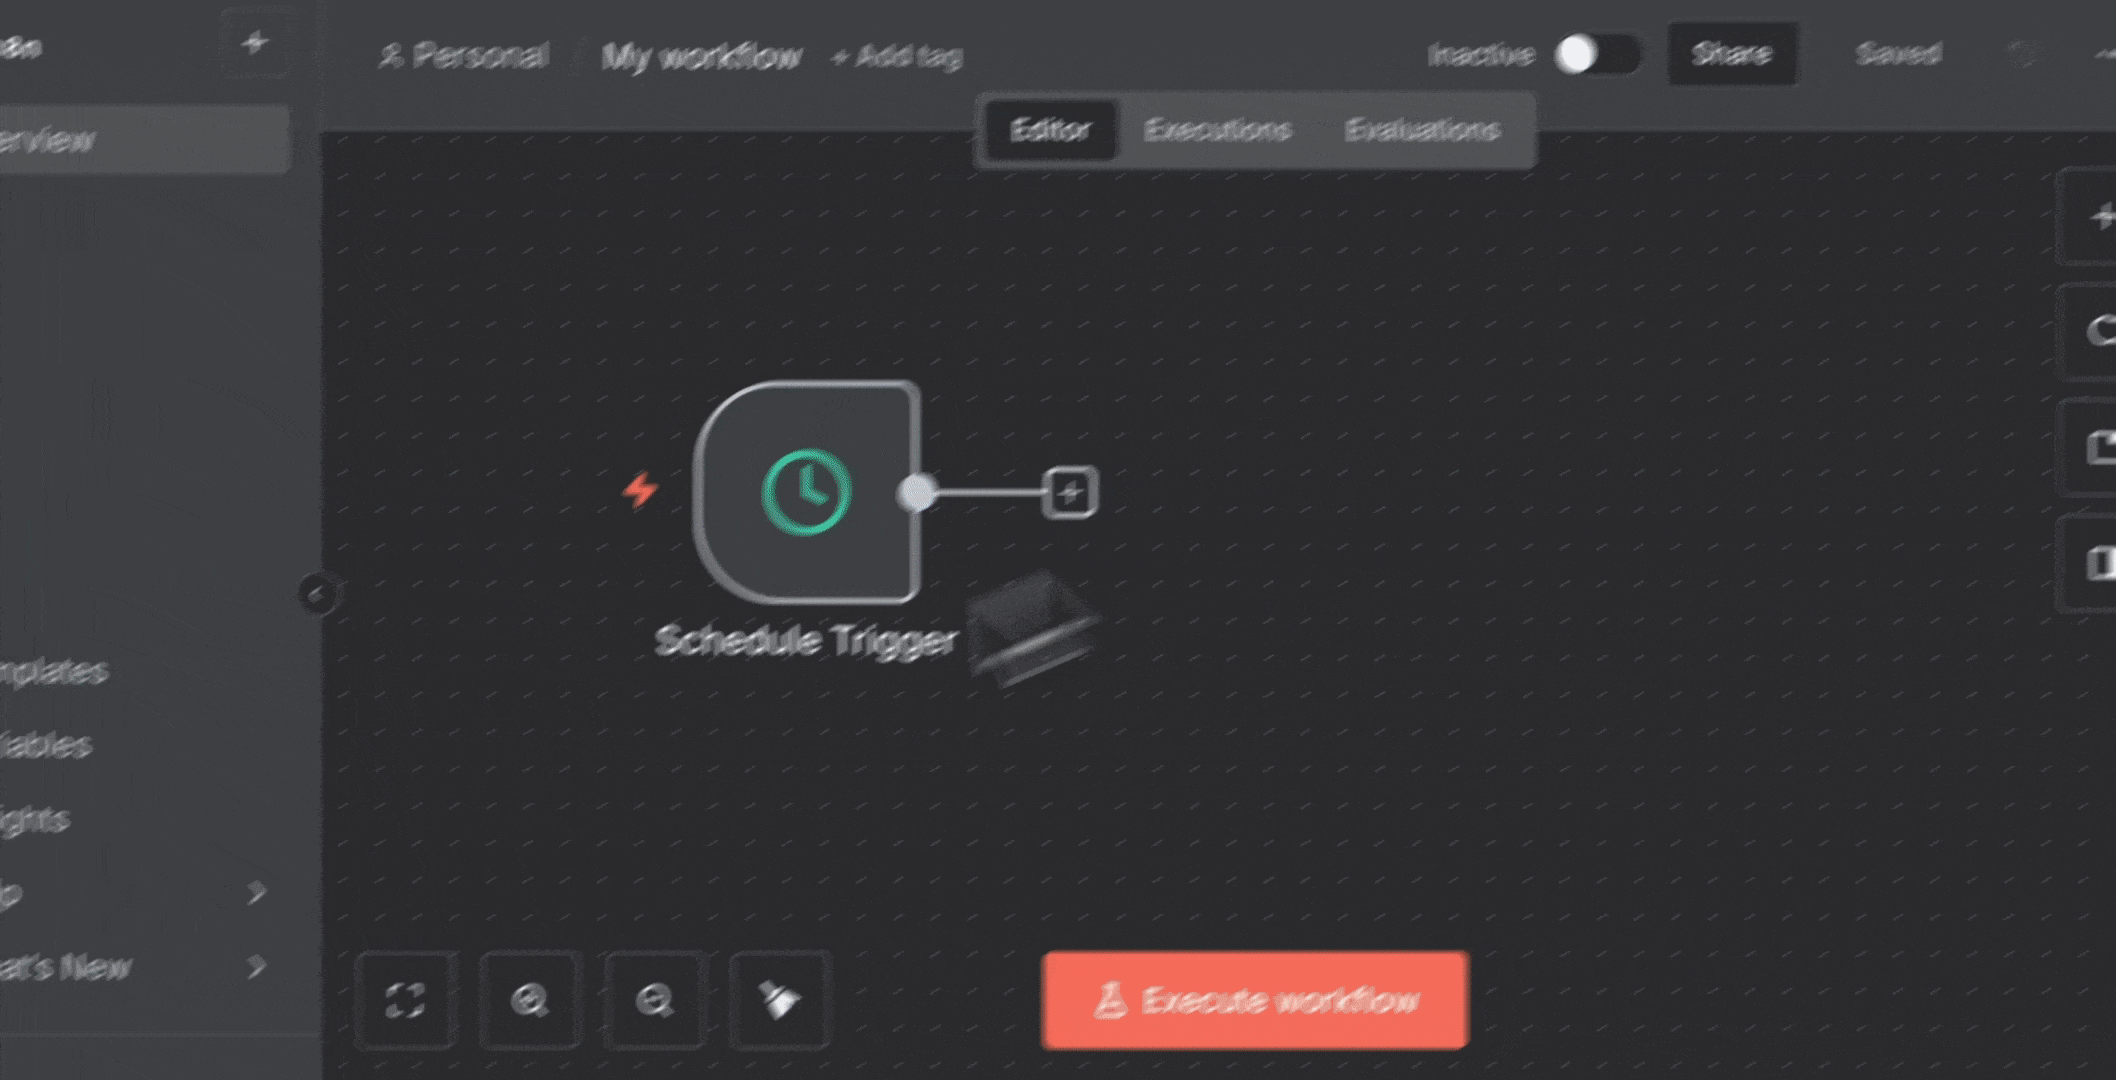
- Firecrawl ノードを追加します:
- Schedule Trigger の横にある ”+” をクリックします
- “Firecrawl” を検索して追加します
- Firecrawl の認証情報を選択します
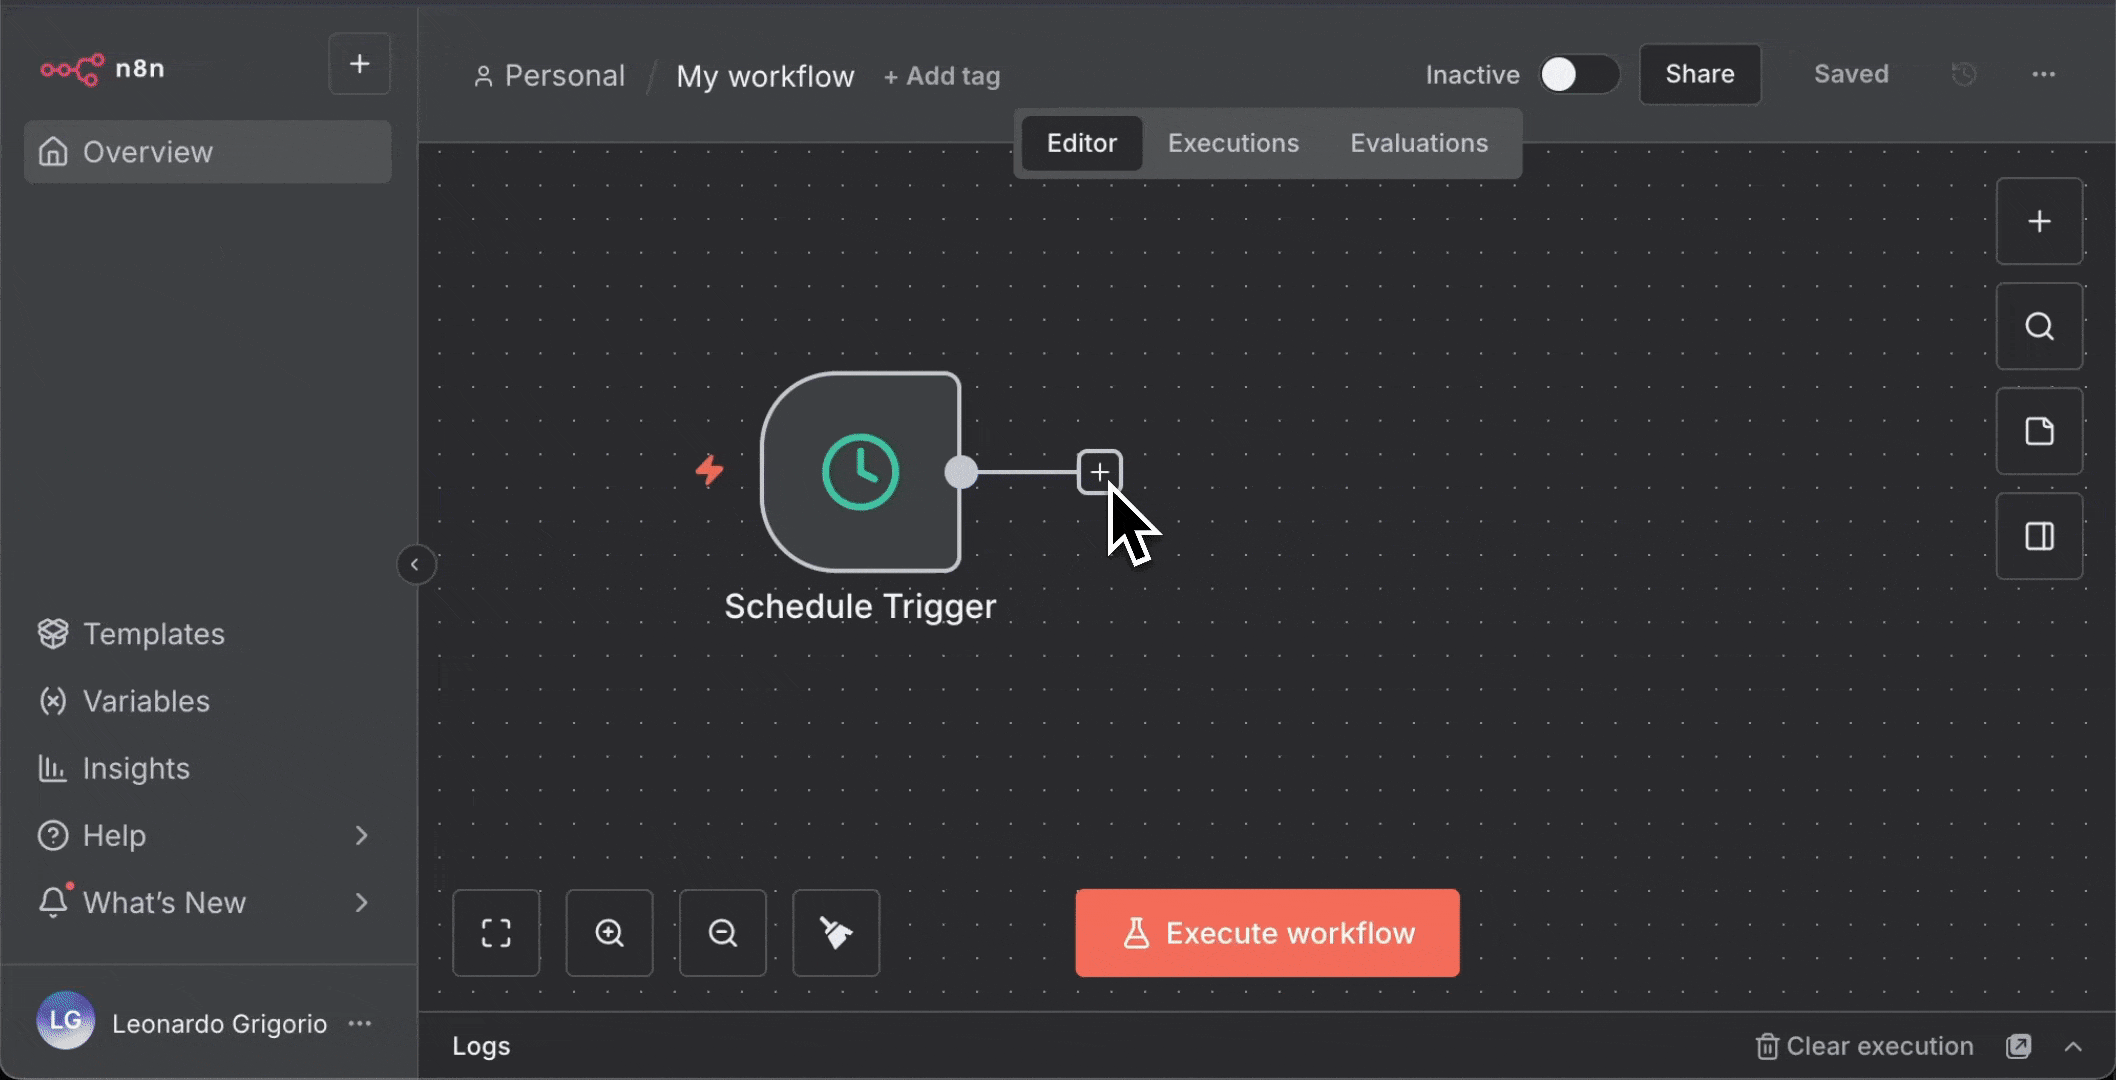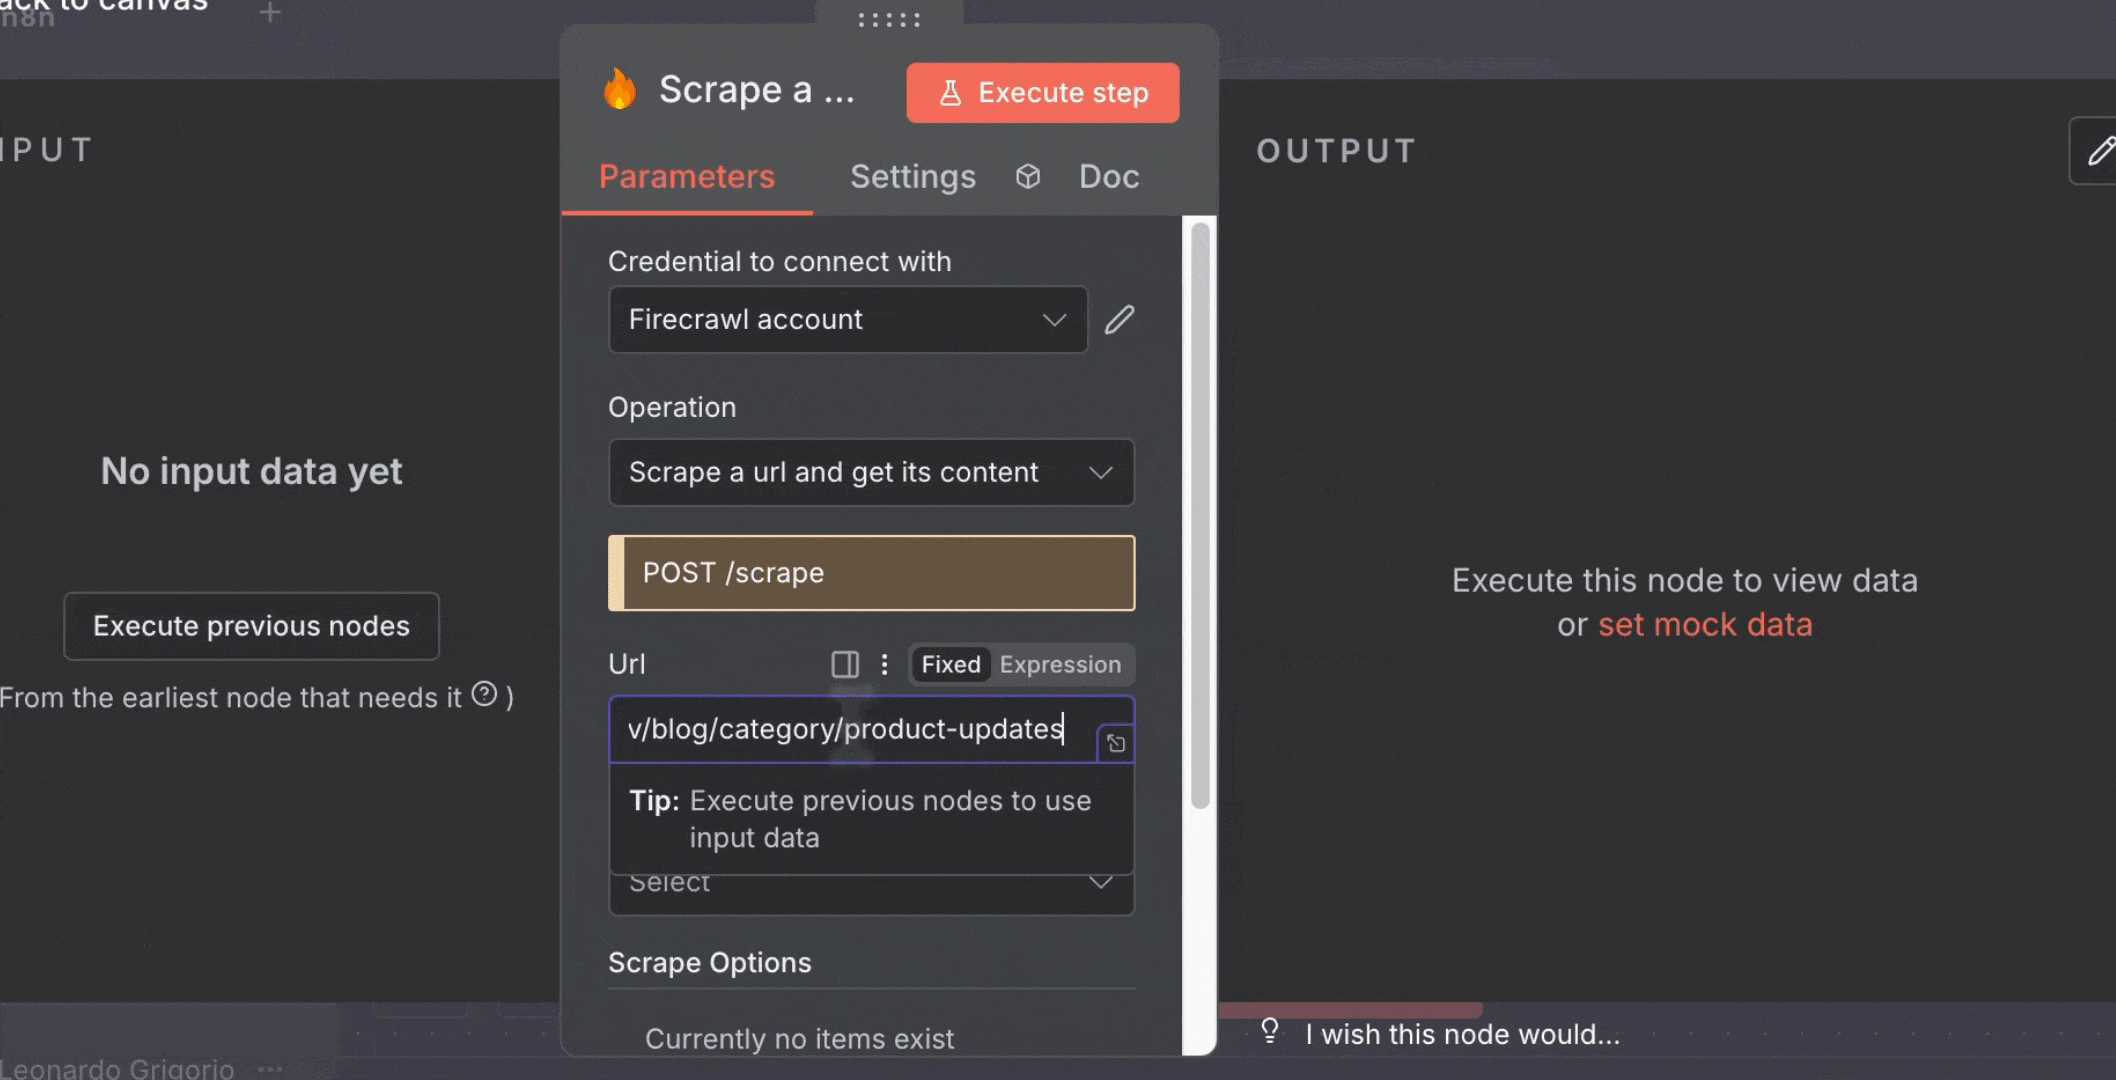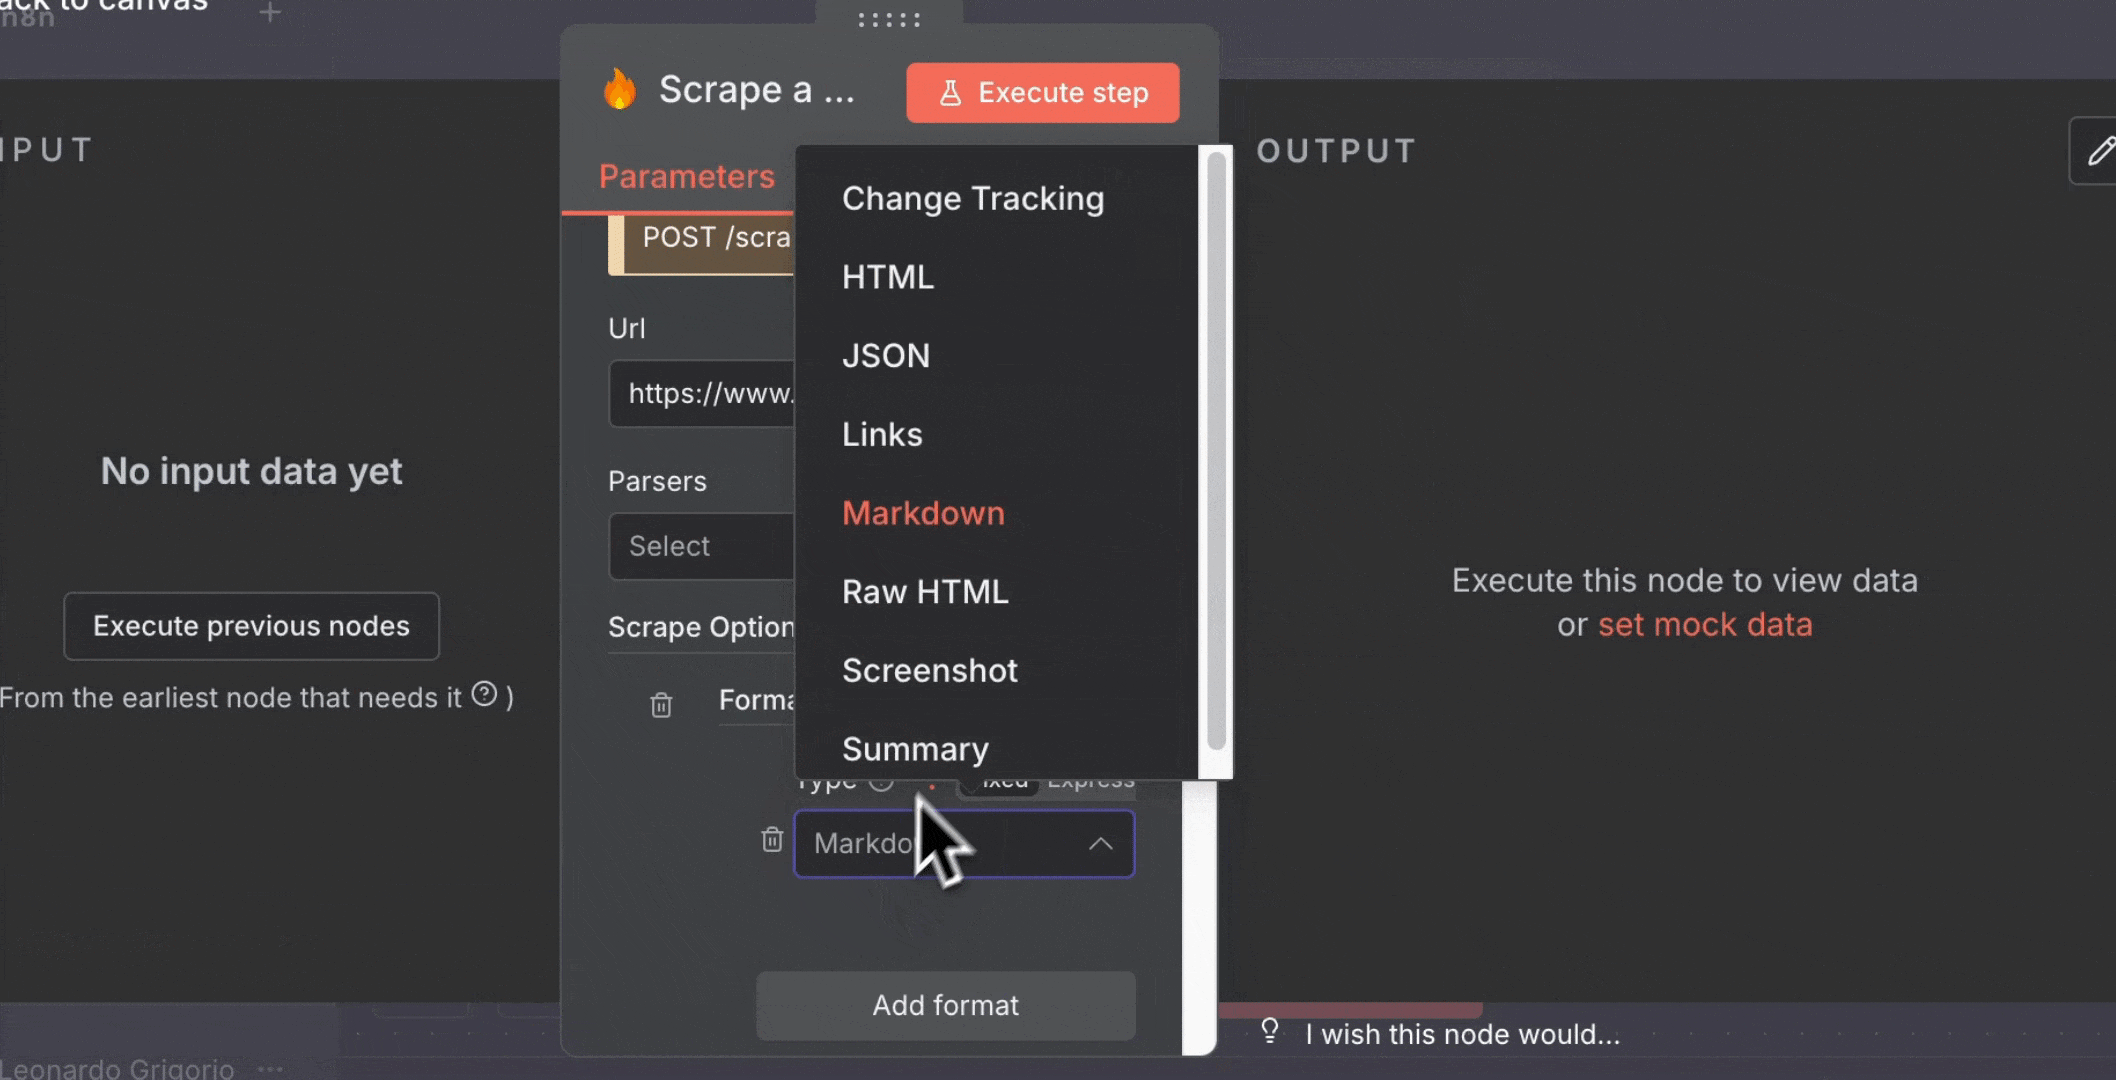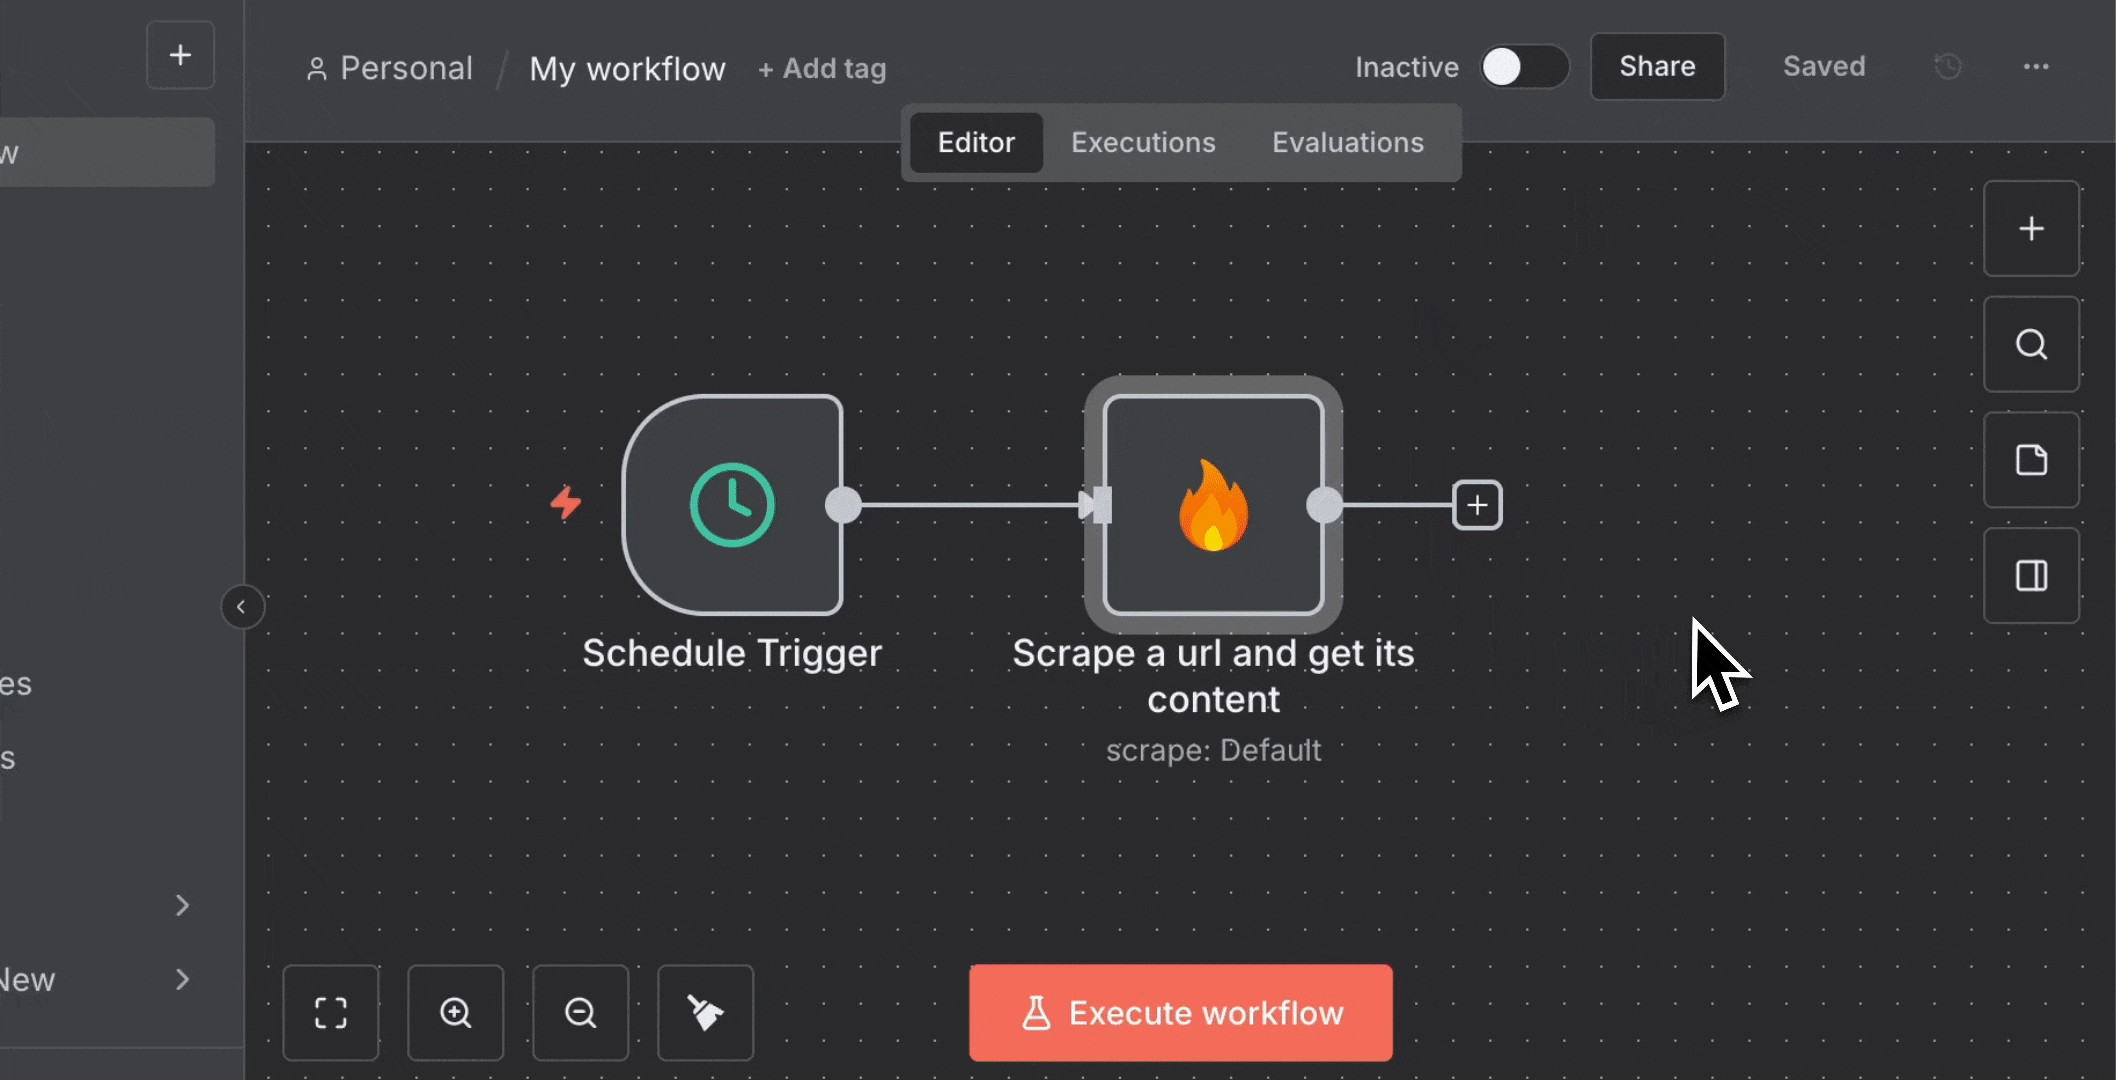
- 次のように構成します:
- リソース: Scraping
- オペレーション: Scrape URL
- URL:
https://www.firecrawl.dev/blog/category/product-updates - Scrape Options: Formats を追加し、“Summary” を選択
-
Telegram ノードを追加します:
- Firecrawl の横にある ”+” をクリックします
- “Telegram” を検索します
- “Send a text message” をクリックして キャンバス に追加します
-
Telegram の認証情報を設定します:
- Telegram ノードをクリックして構成を開きます
- “接続に使用する認証情報” ドロップダウンで、“新しい認証情報を作成” をクリックします
- BotFather から取得したボットトークンを貼り付けます
- “保存” をクリックします

- Telegram メッセージを構成します:
- オペレーション: メッセージを送信
- Chat ID: チャット ID を入力します
- Text: ひとまず “hello” メッセージのままにします
- Execute step をクリックして、Firecrawl から要約を受け取りながらメッセージ送信をテストします。

- Firecrawl の要約の構造を確認したら、Firecrawl ノードの output から
summaryフィールド (dataの下) をドラッグしてメッセージテキストに追加します。
- ワークフローをテストします:
- “ワークフローを実行” をクリックします
- Telegram で要約メッセージを確認します
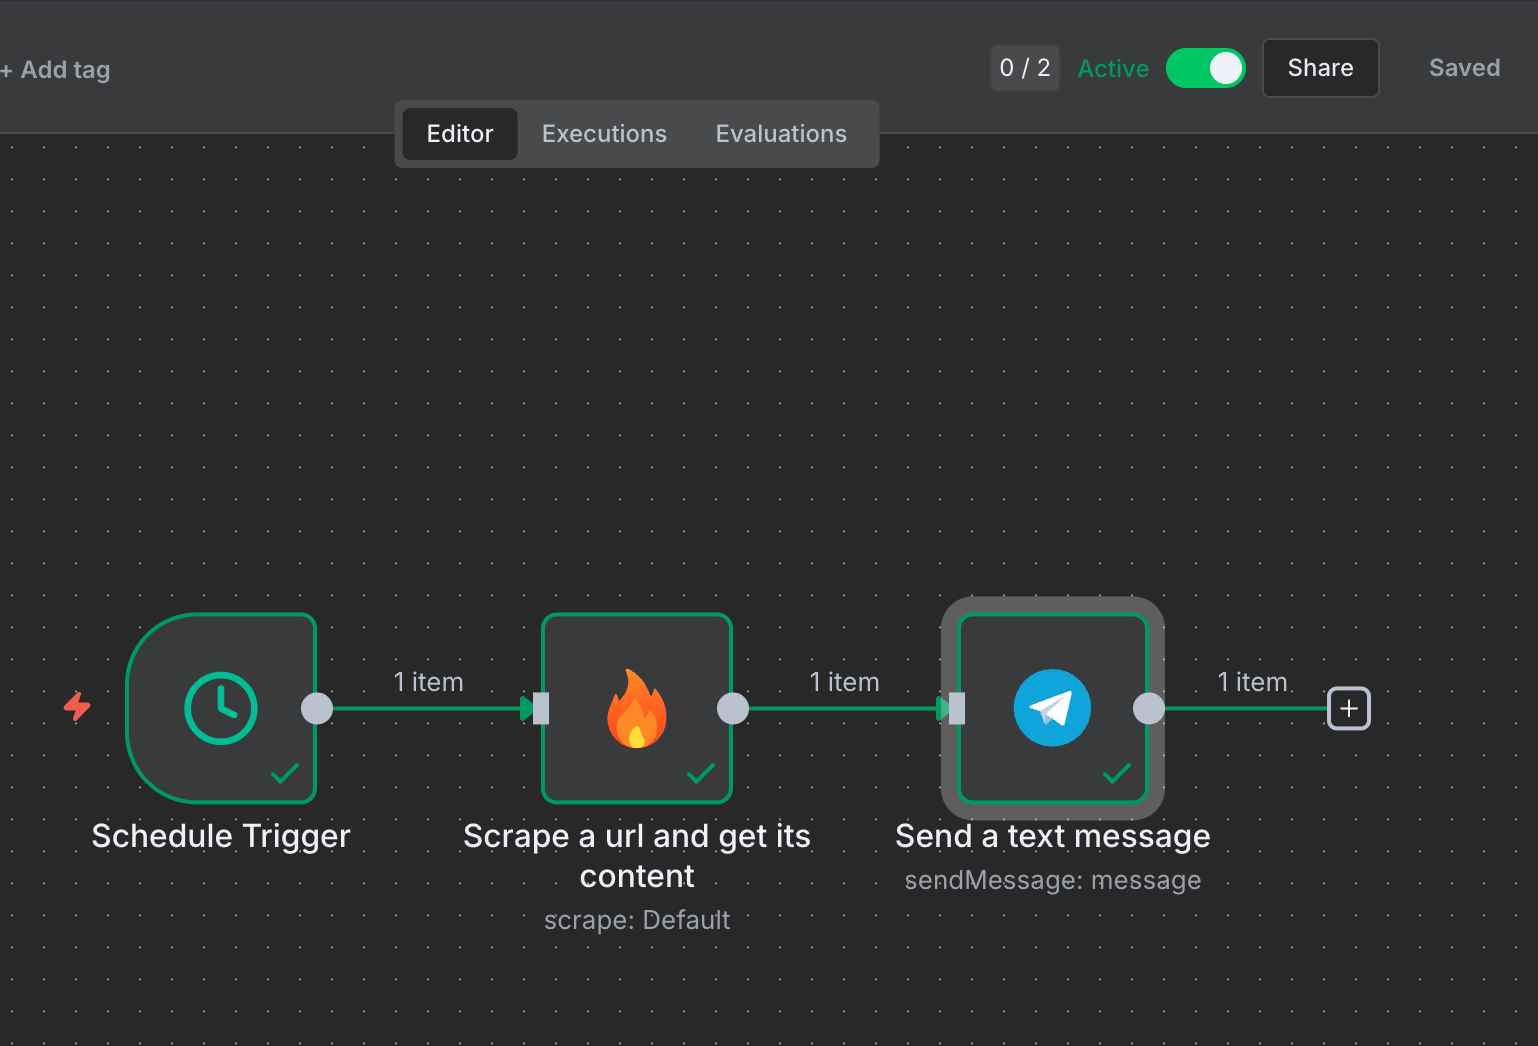
- “Active” スイッチを切り替えてワークフローを有効化します
例2: AIニュースを検索してTelegramに送信
このワークフローでは、FirecrawlのSearchオペレーションを使用してAIニュースを検索し、整形した結果をTelegramに送信します。 例1との主な違い:- ScheduleではなくManual Triggerを使用 (必要に応じて実行)
- ScrapeオペレーションではなくSearchオペレーションを使用
- 複数の結果を整形するためのCodeノードを使用
- 新しいワークフローを作成し、Manual Triggerノードを追加します
-
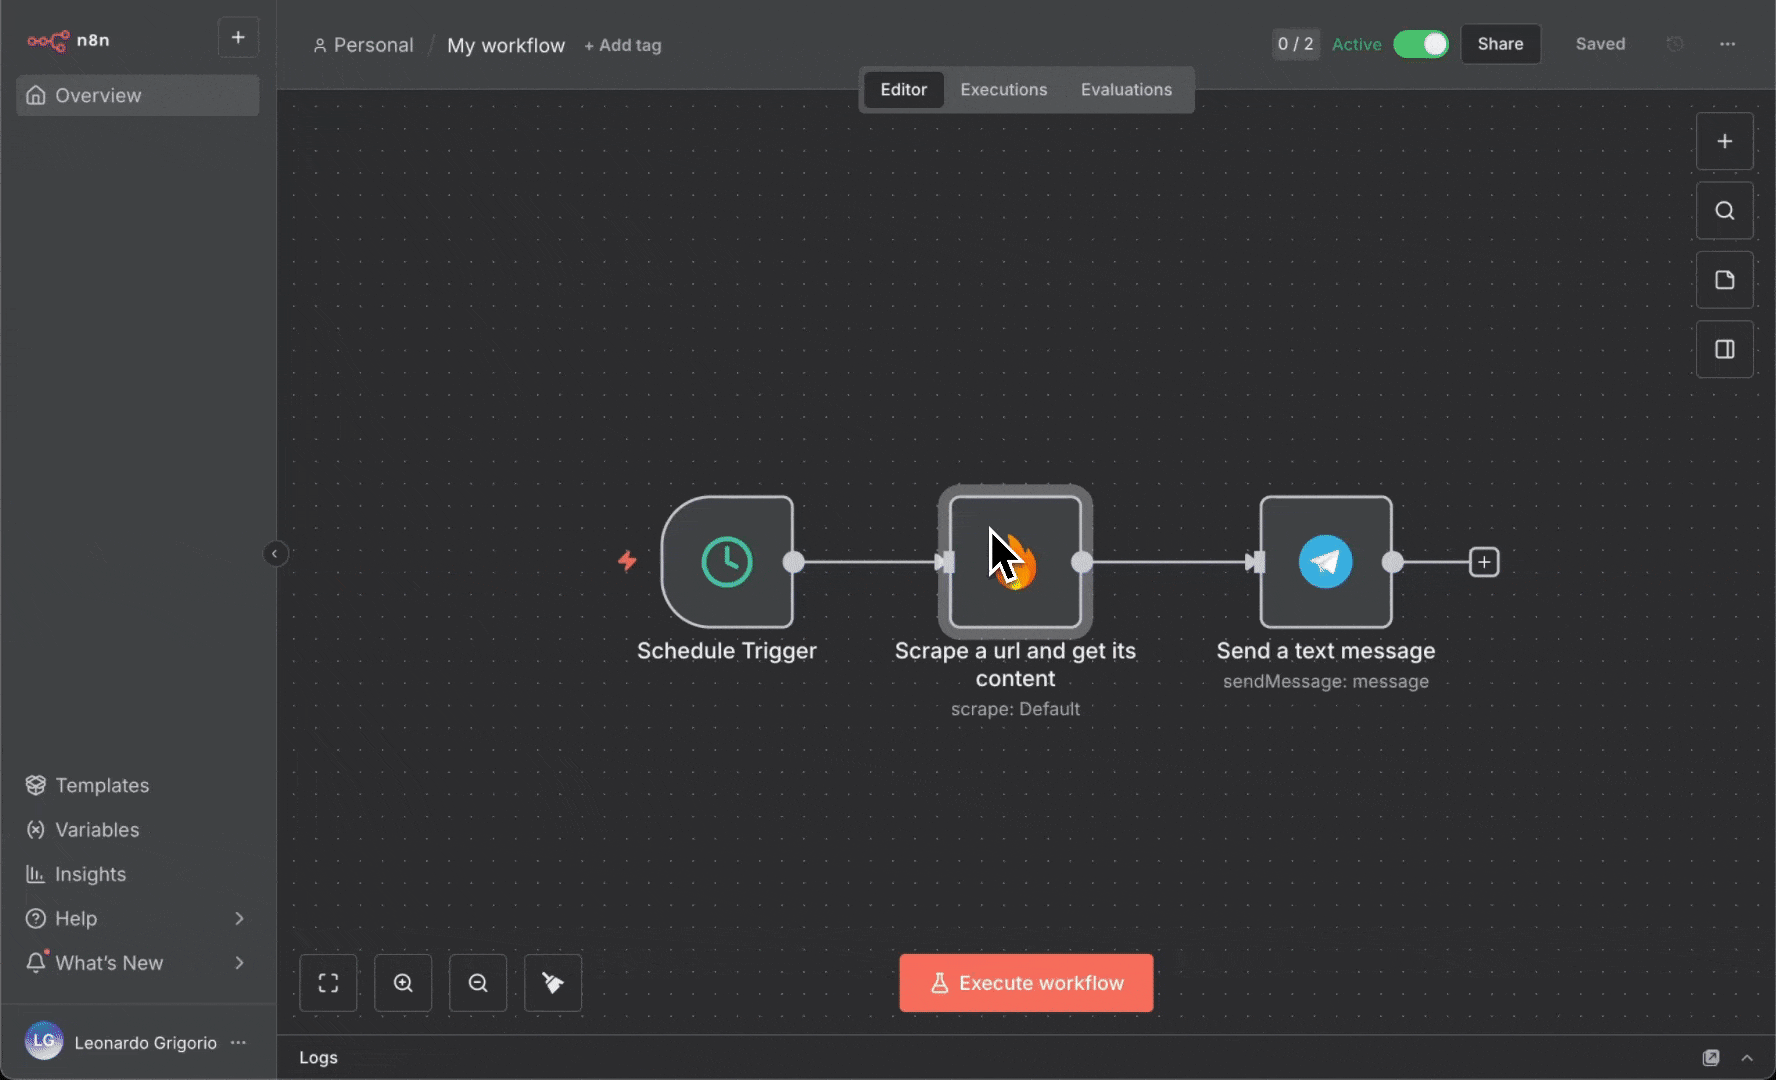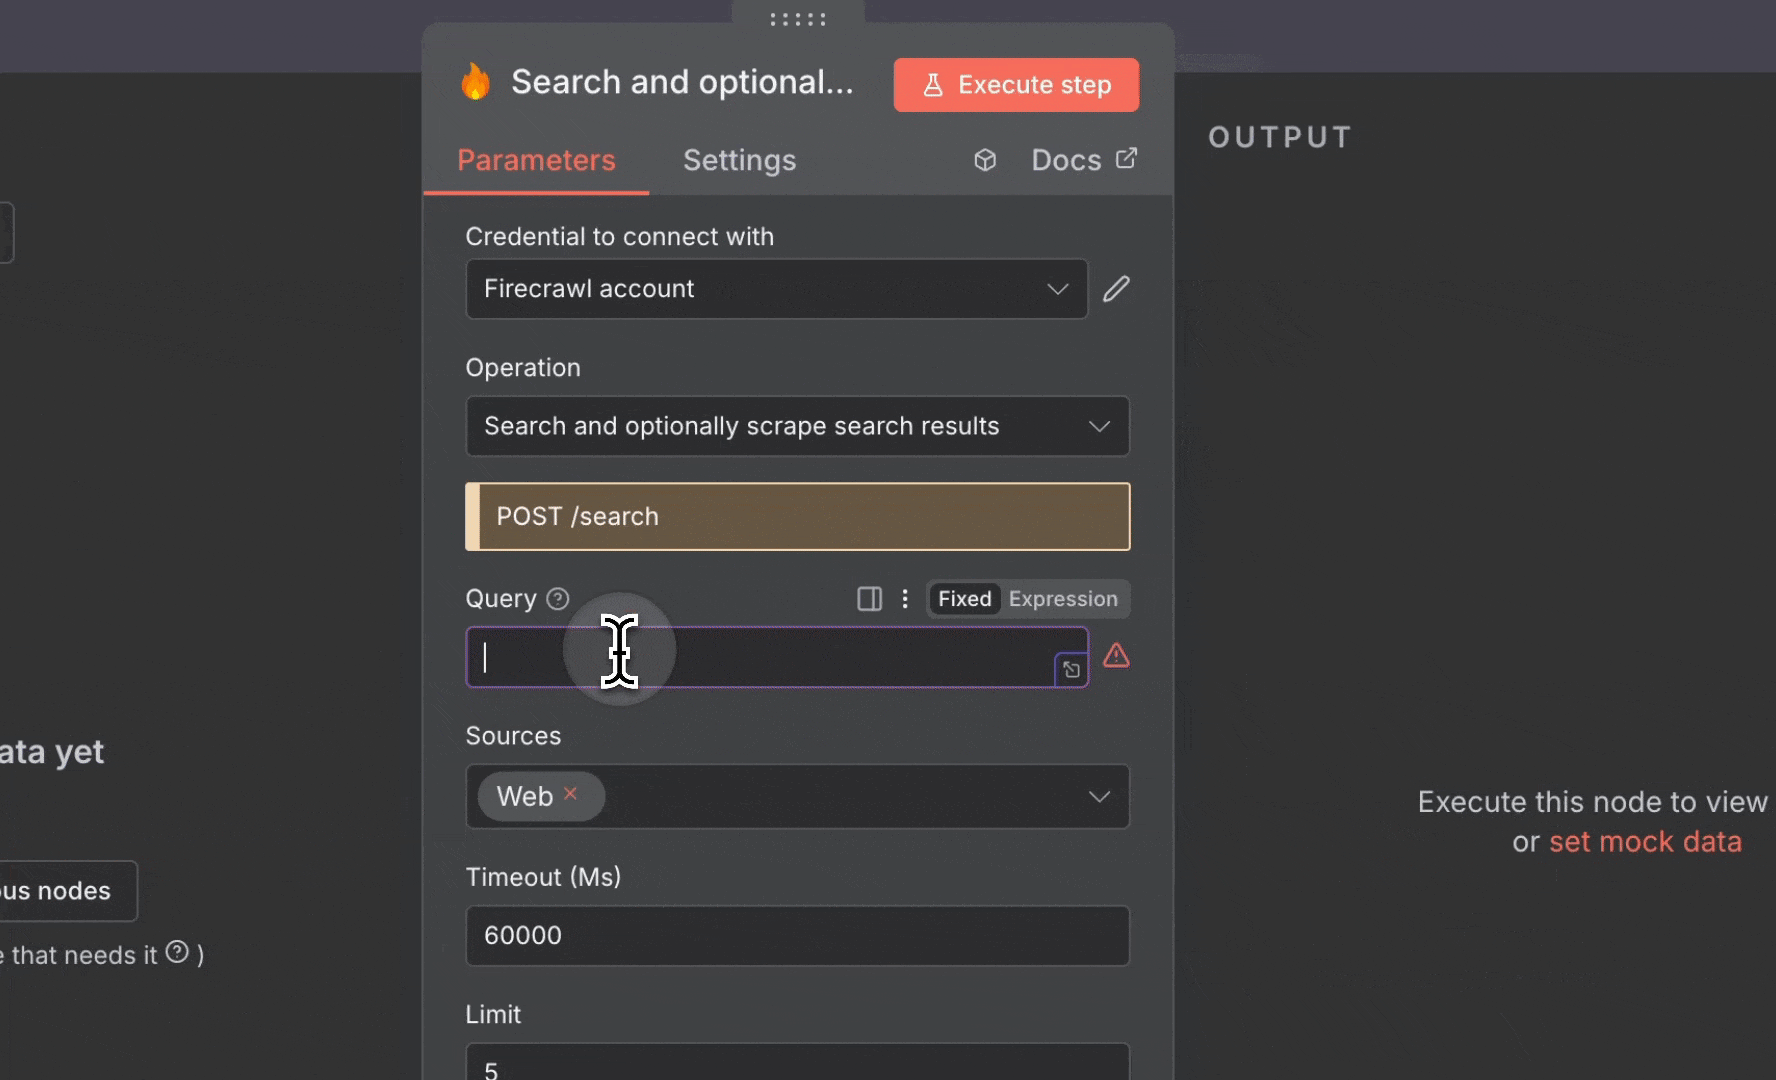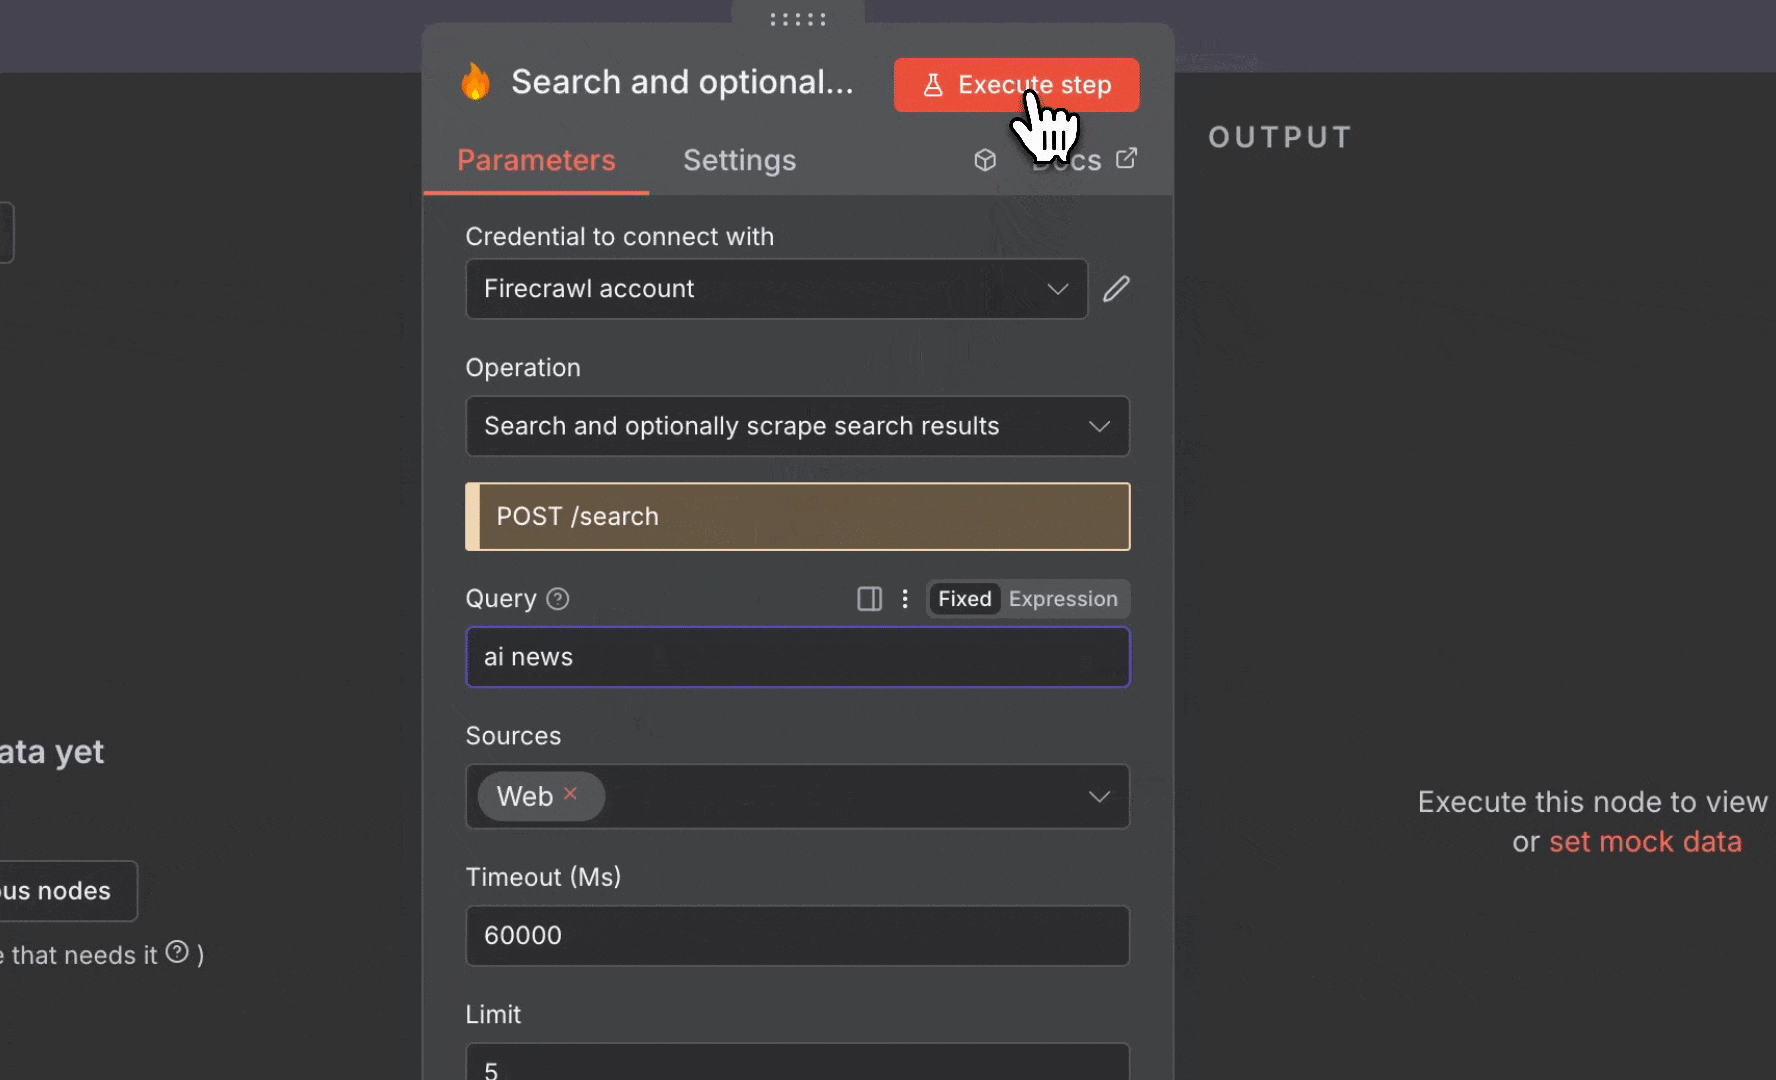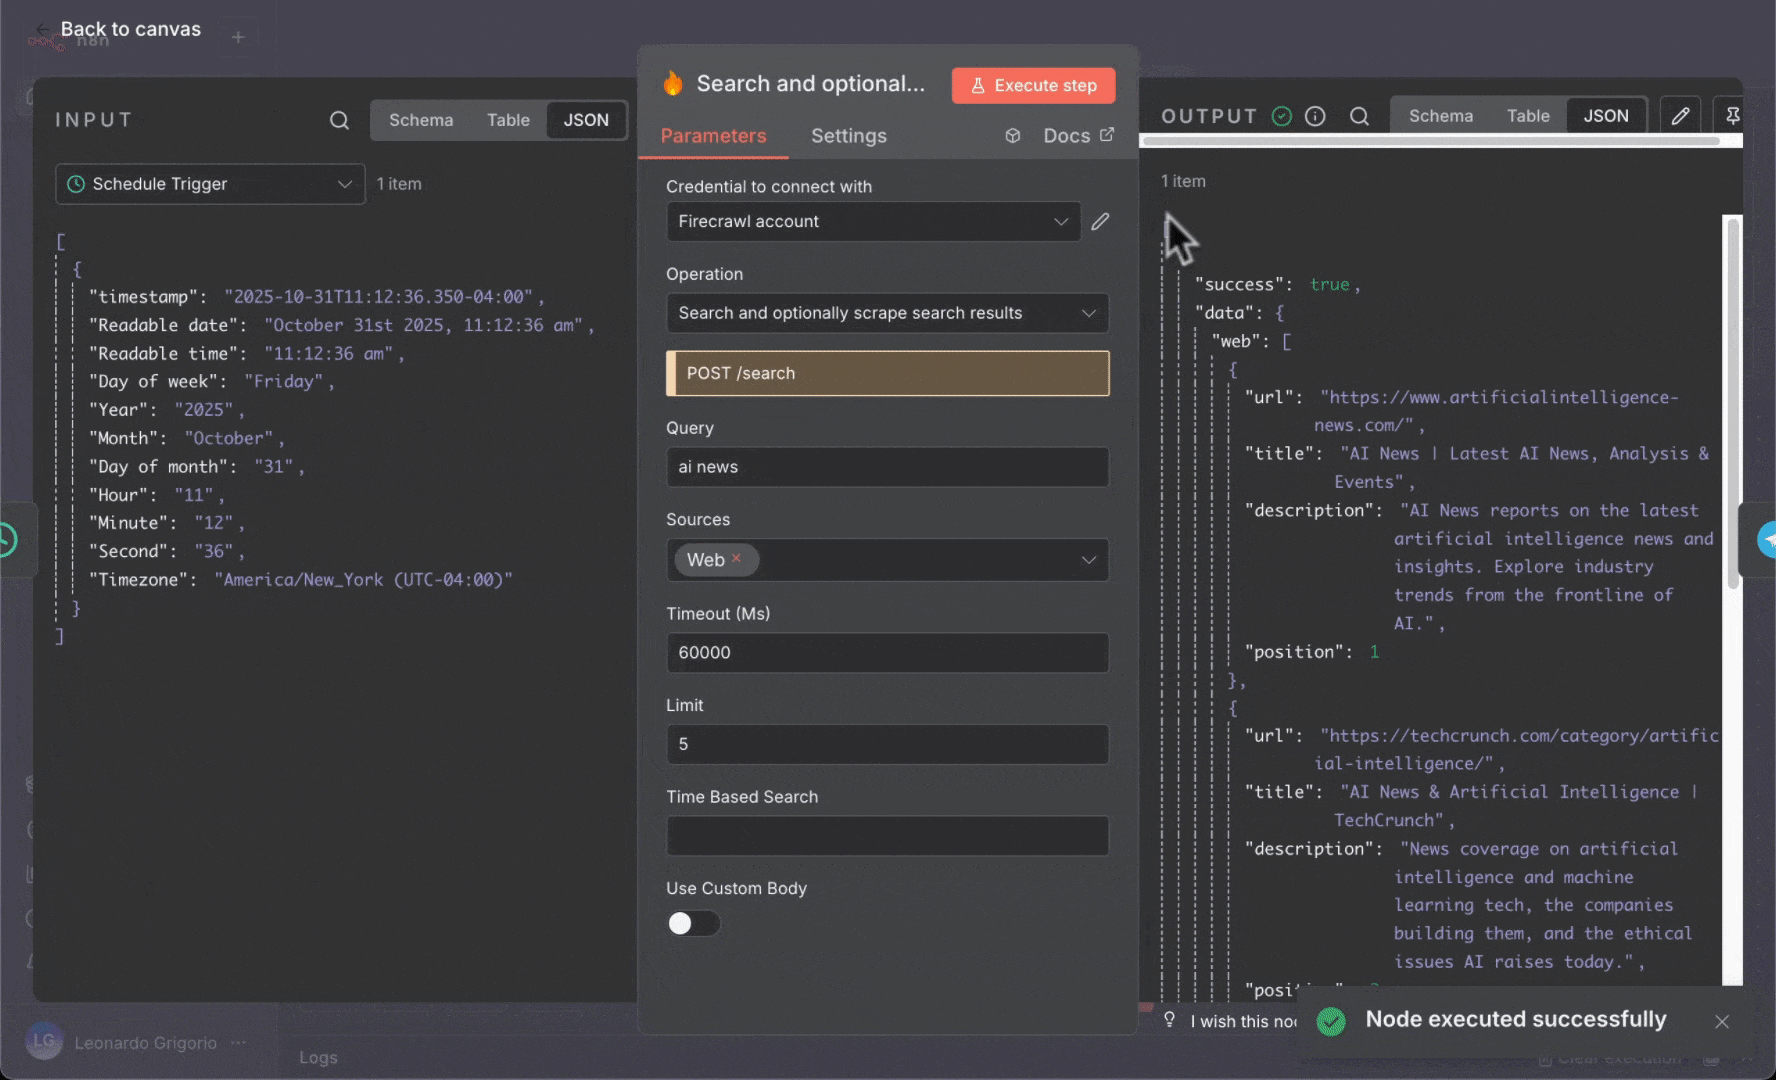
次の設定でFirecrawlノードを追加します:
- リソース: Map & Search
- オペレーション: Search Web
- Query:
ai news - Limit: 5
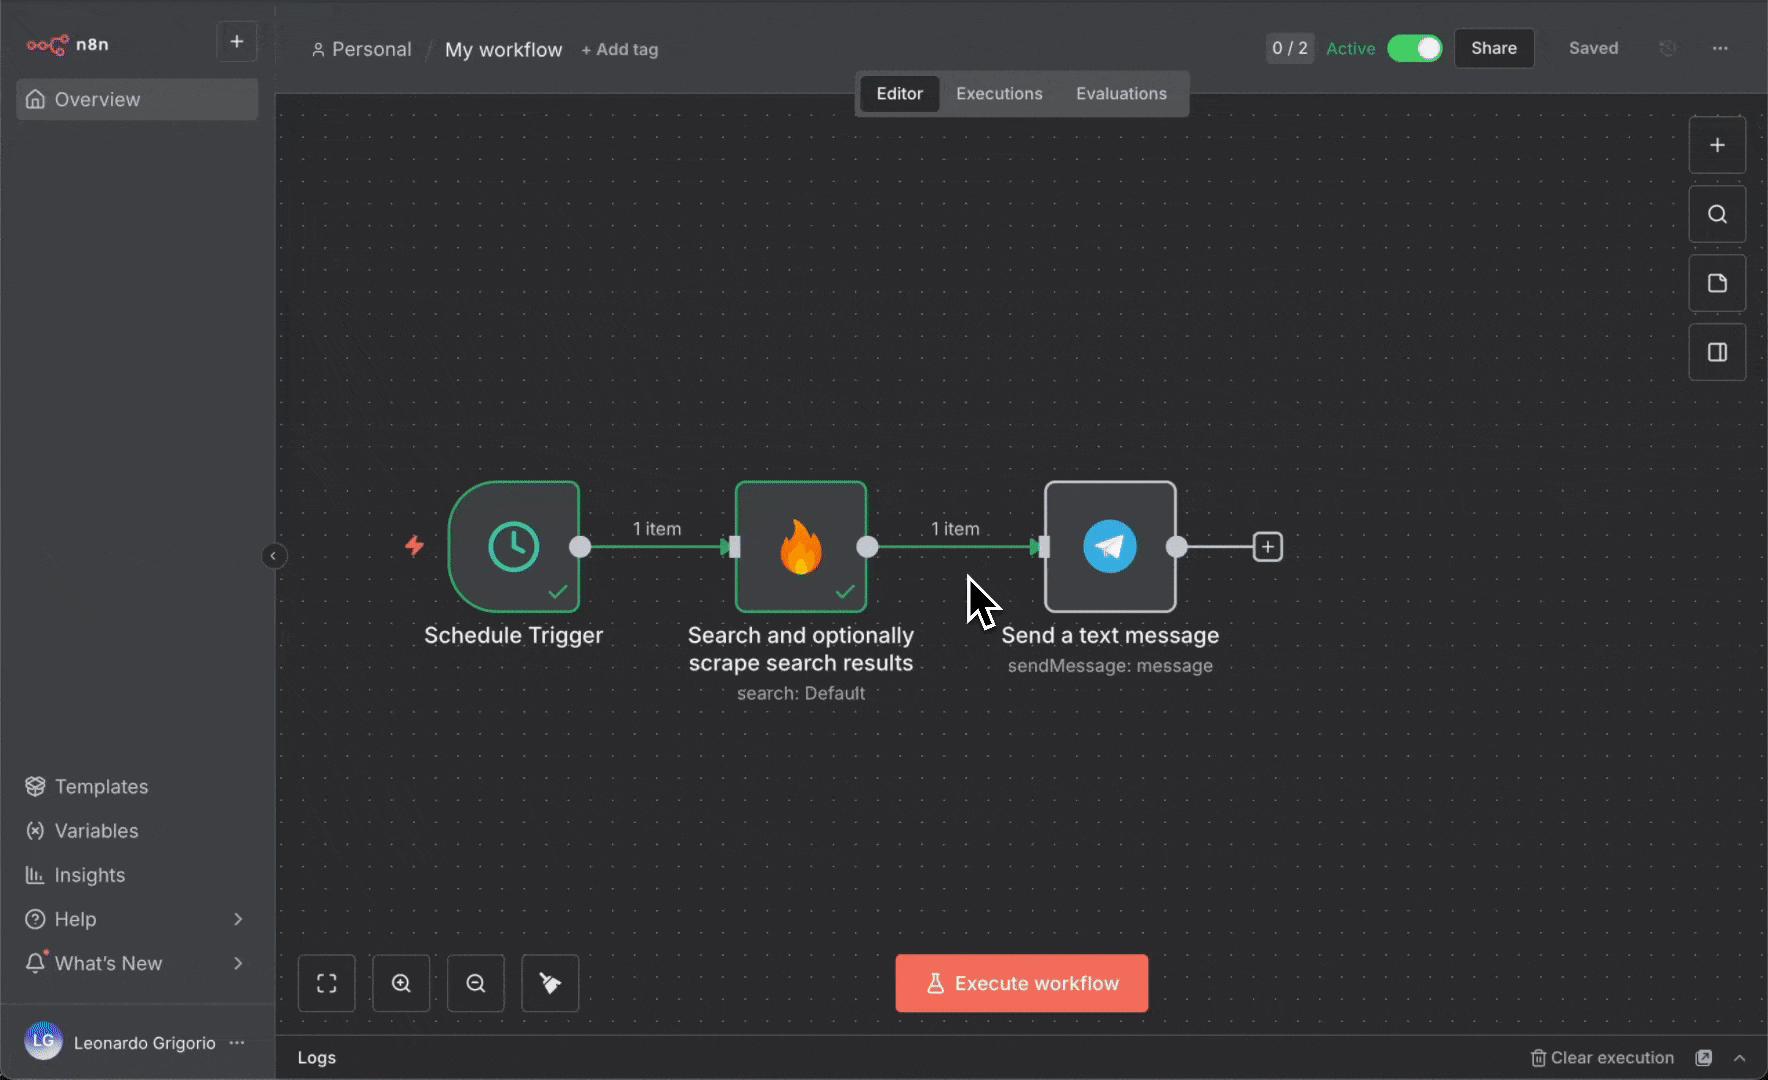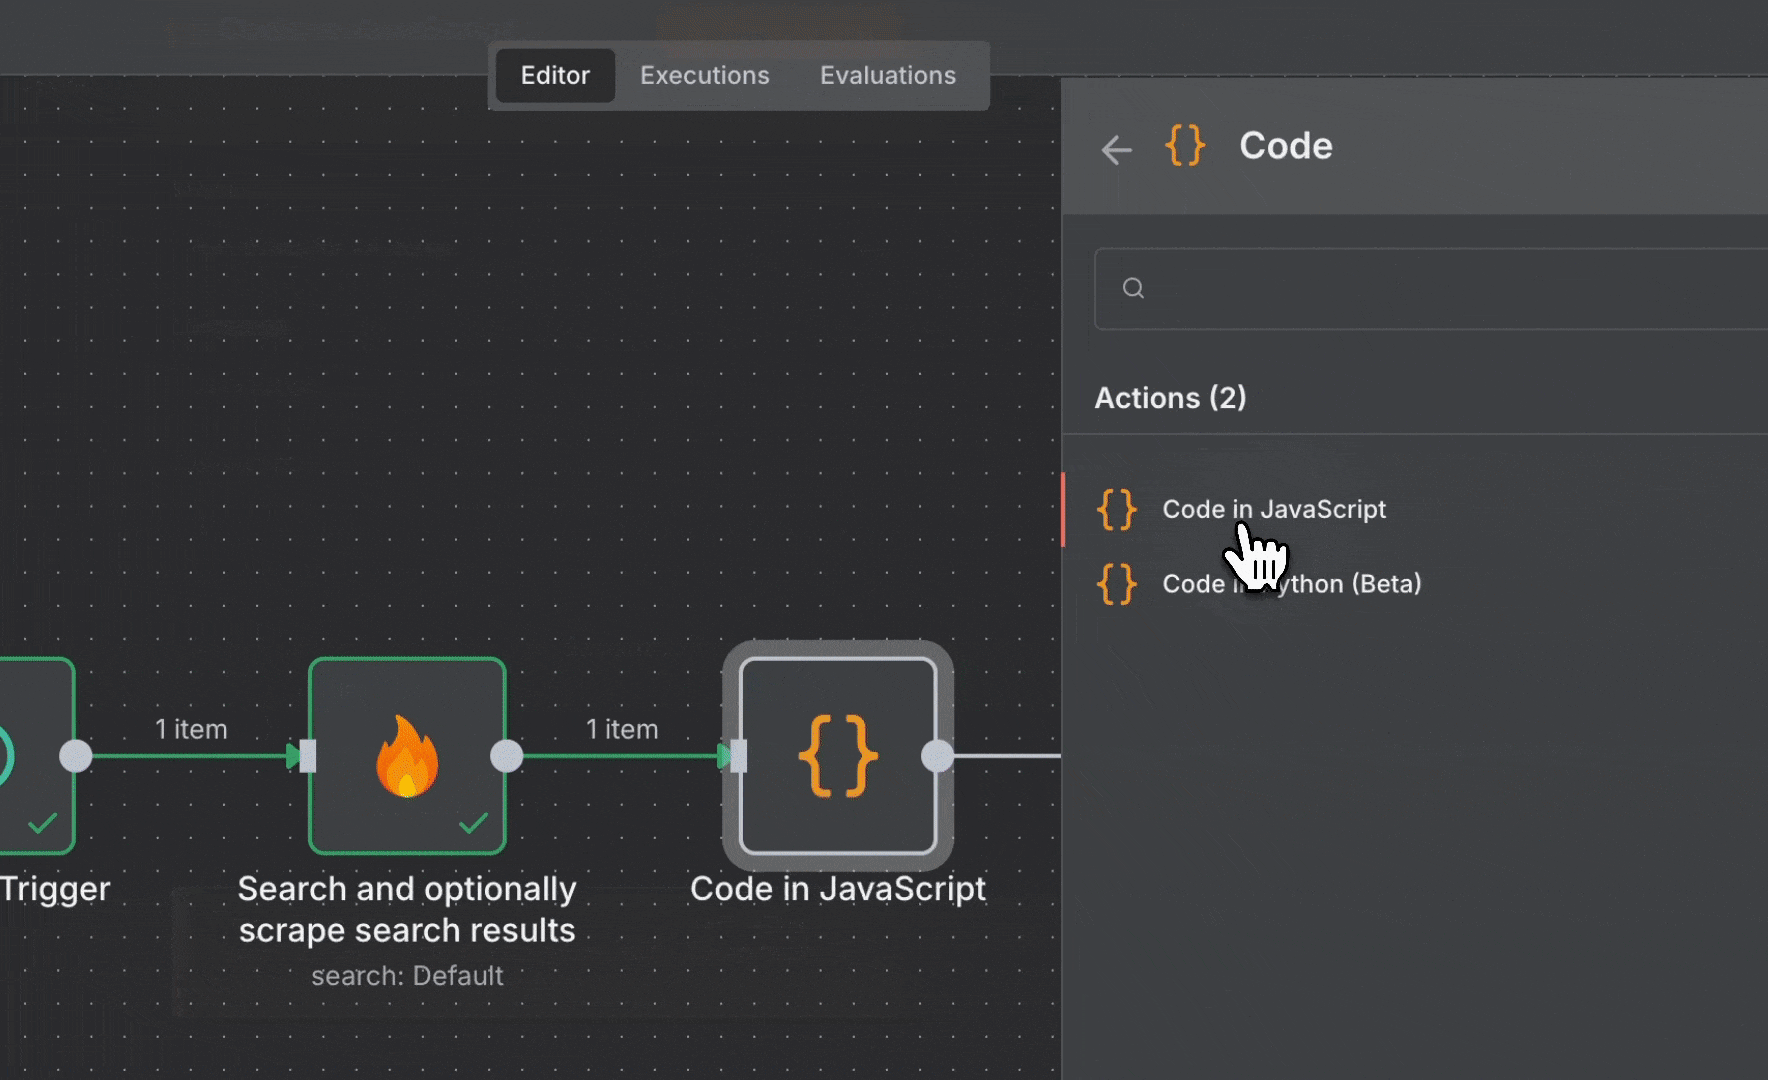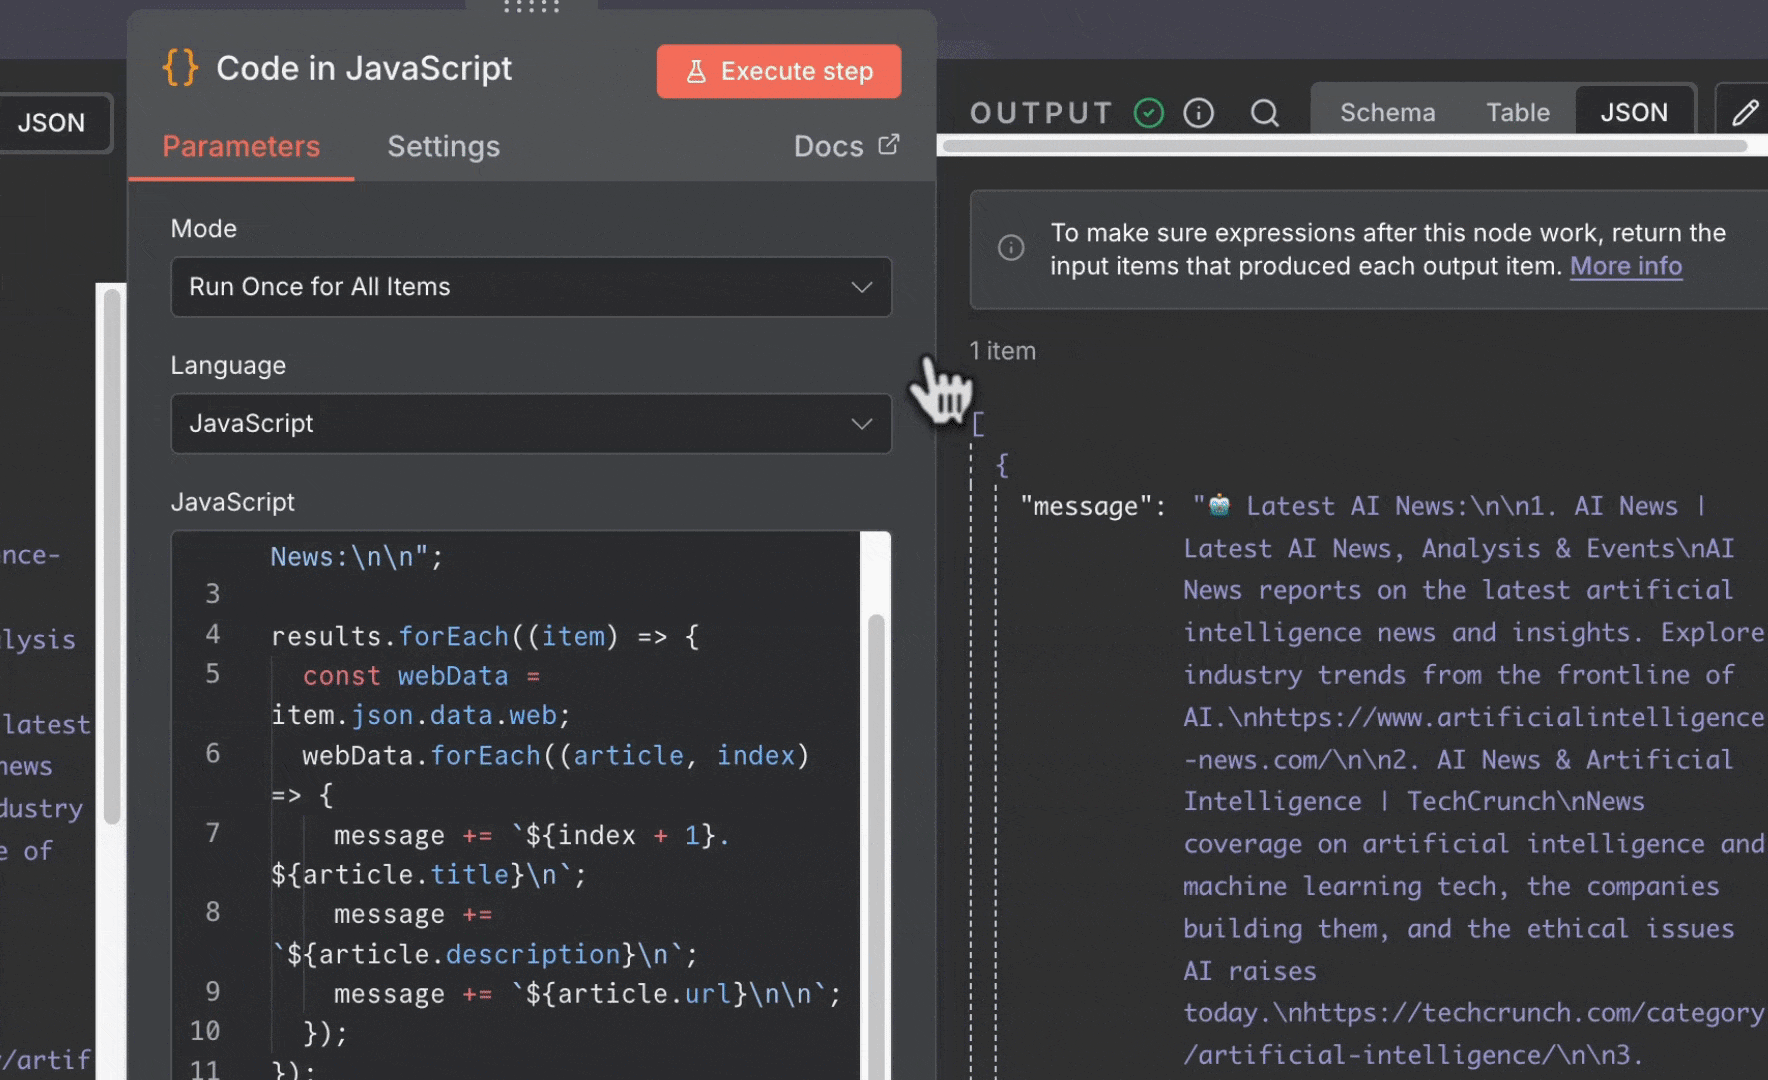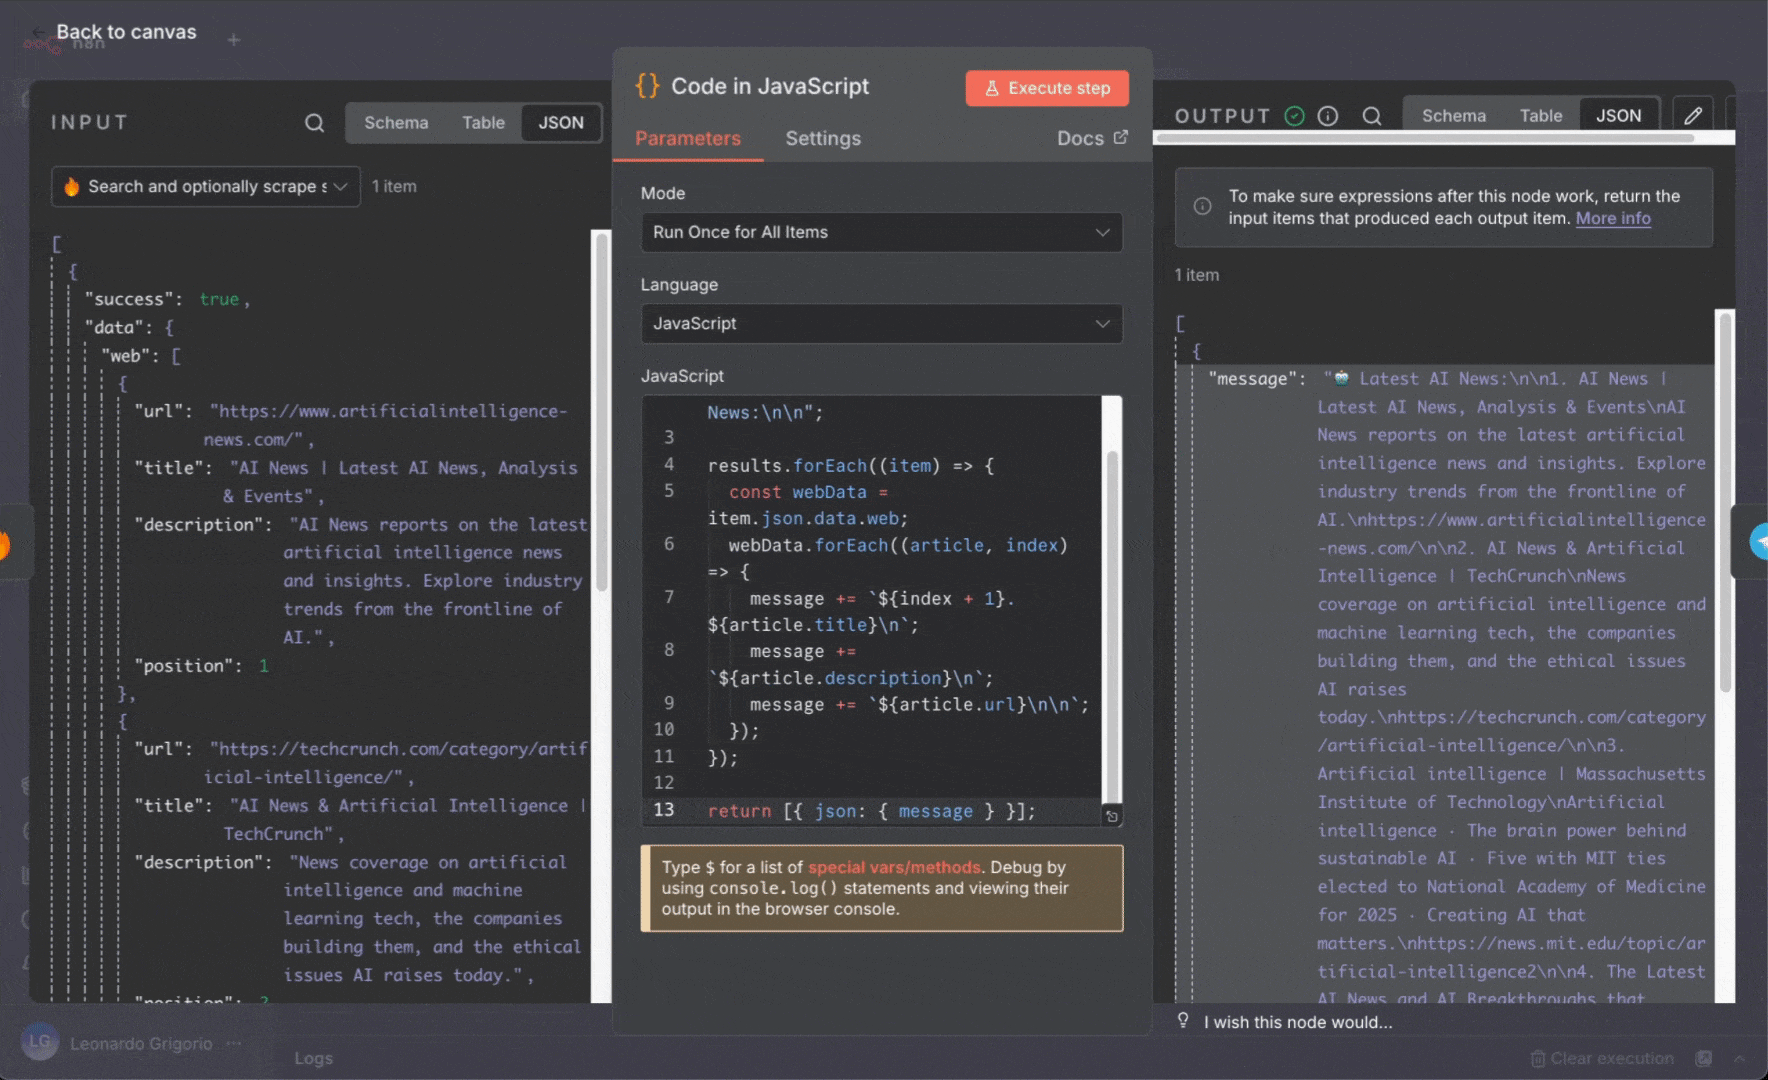
- 検索結果を整形するためのCodeノードを追加します:
- “Run Once for All Items”を選択します
- 次のコードを貼り付けます:
- Telegramノードを更新します (保存済みの認証情報を使用) :
- Text:Codeノードから
messageフィールドをドラッグ&ドロップします
- Text:Codeノードから

例 3: AI を活用したニュース要約
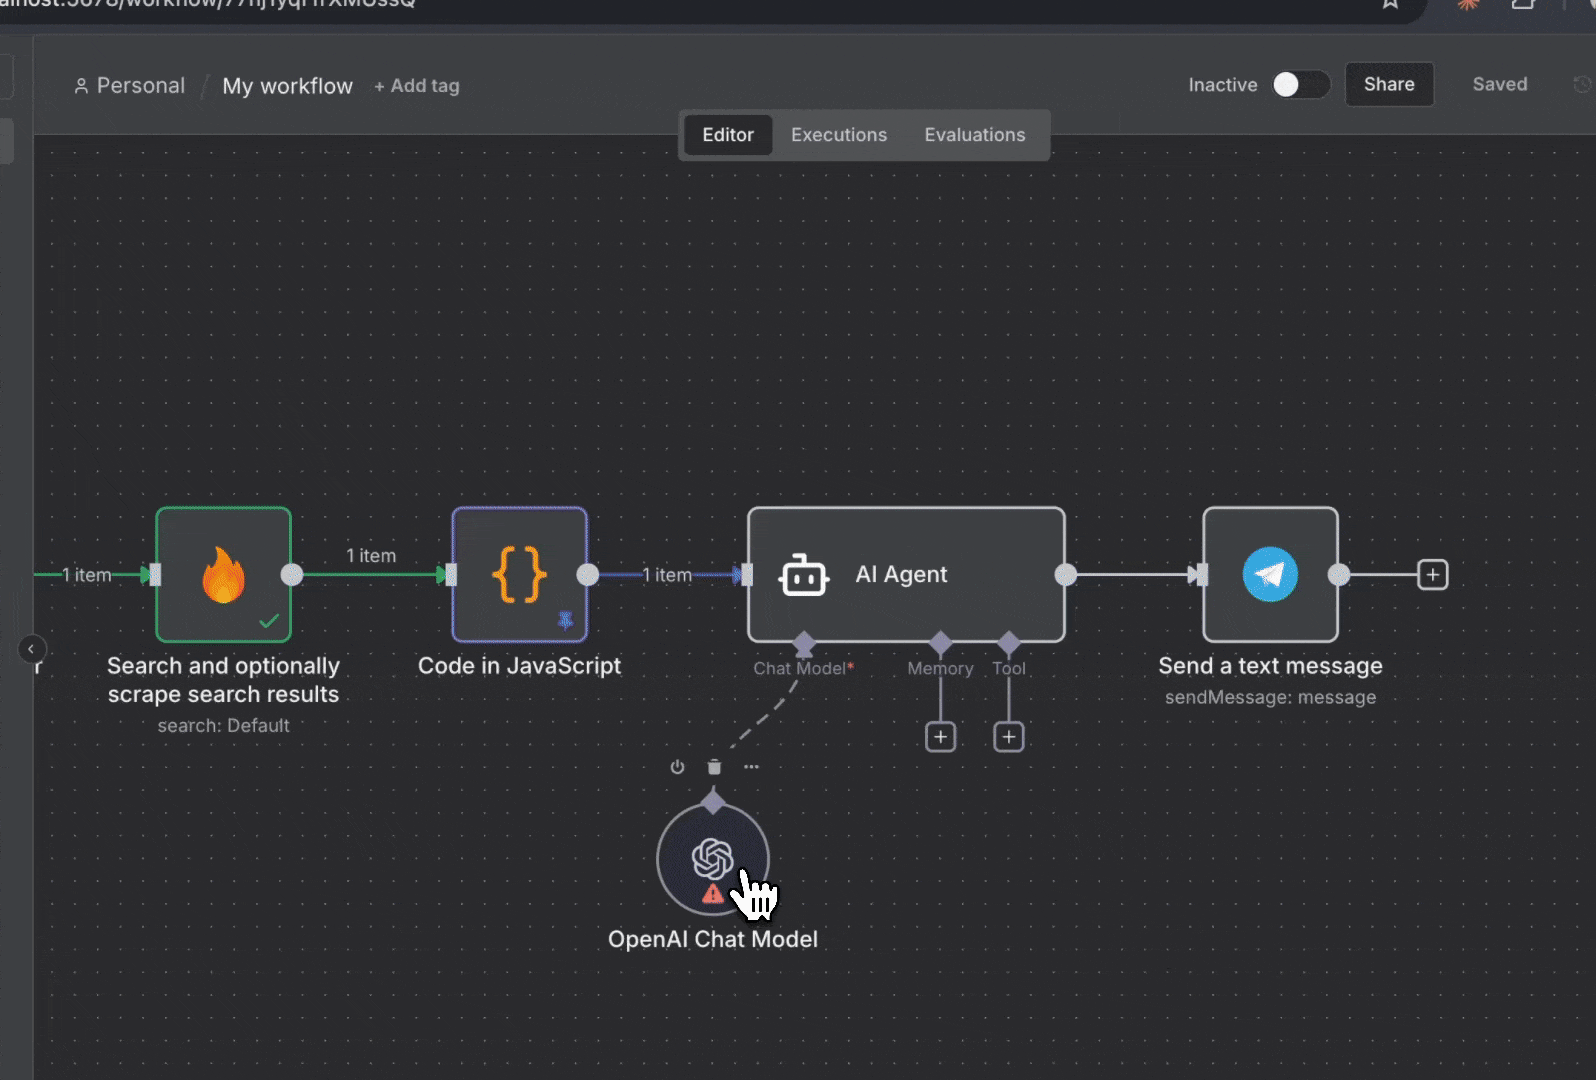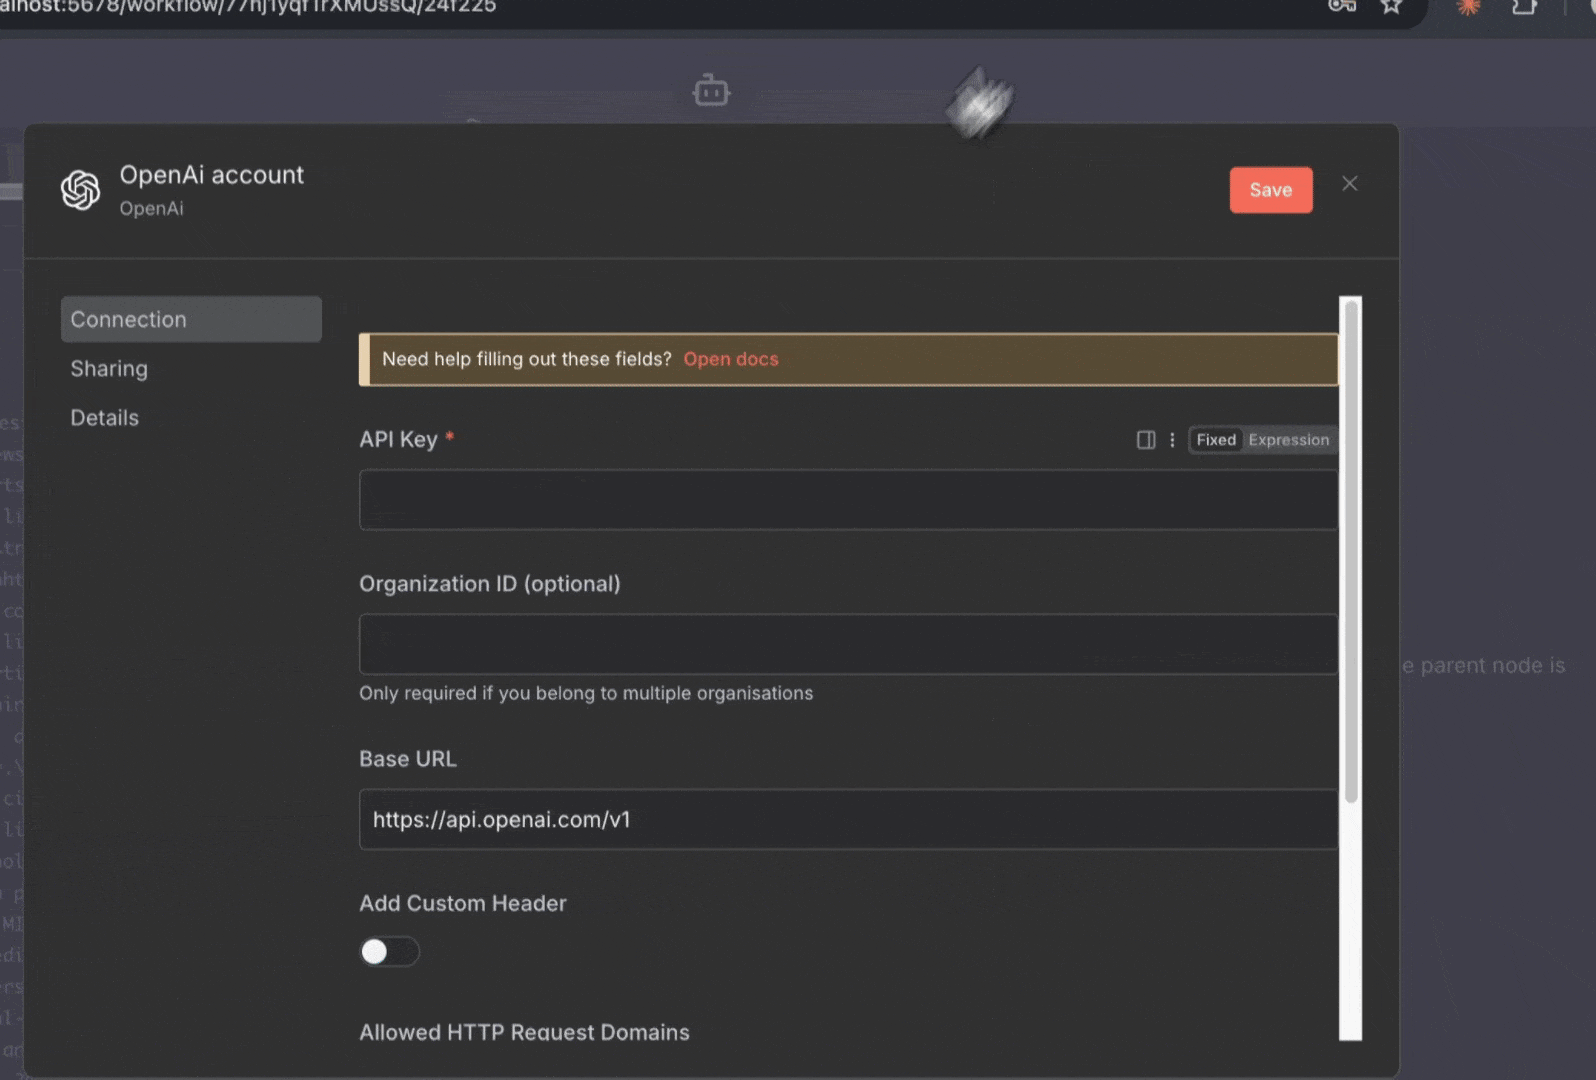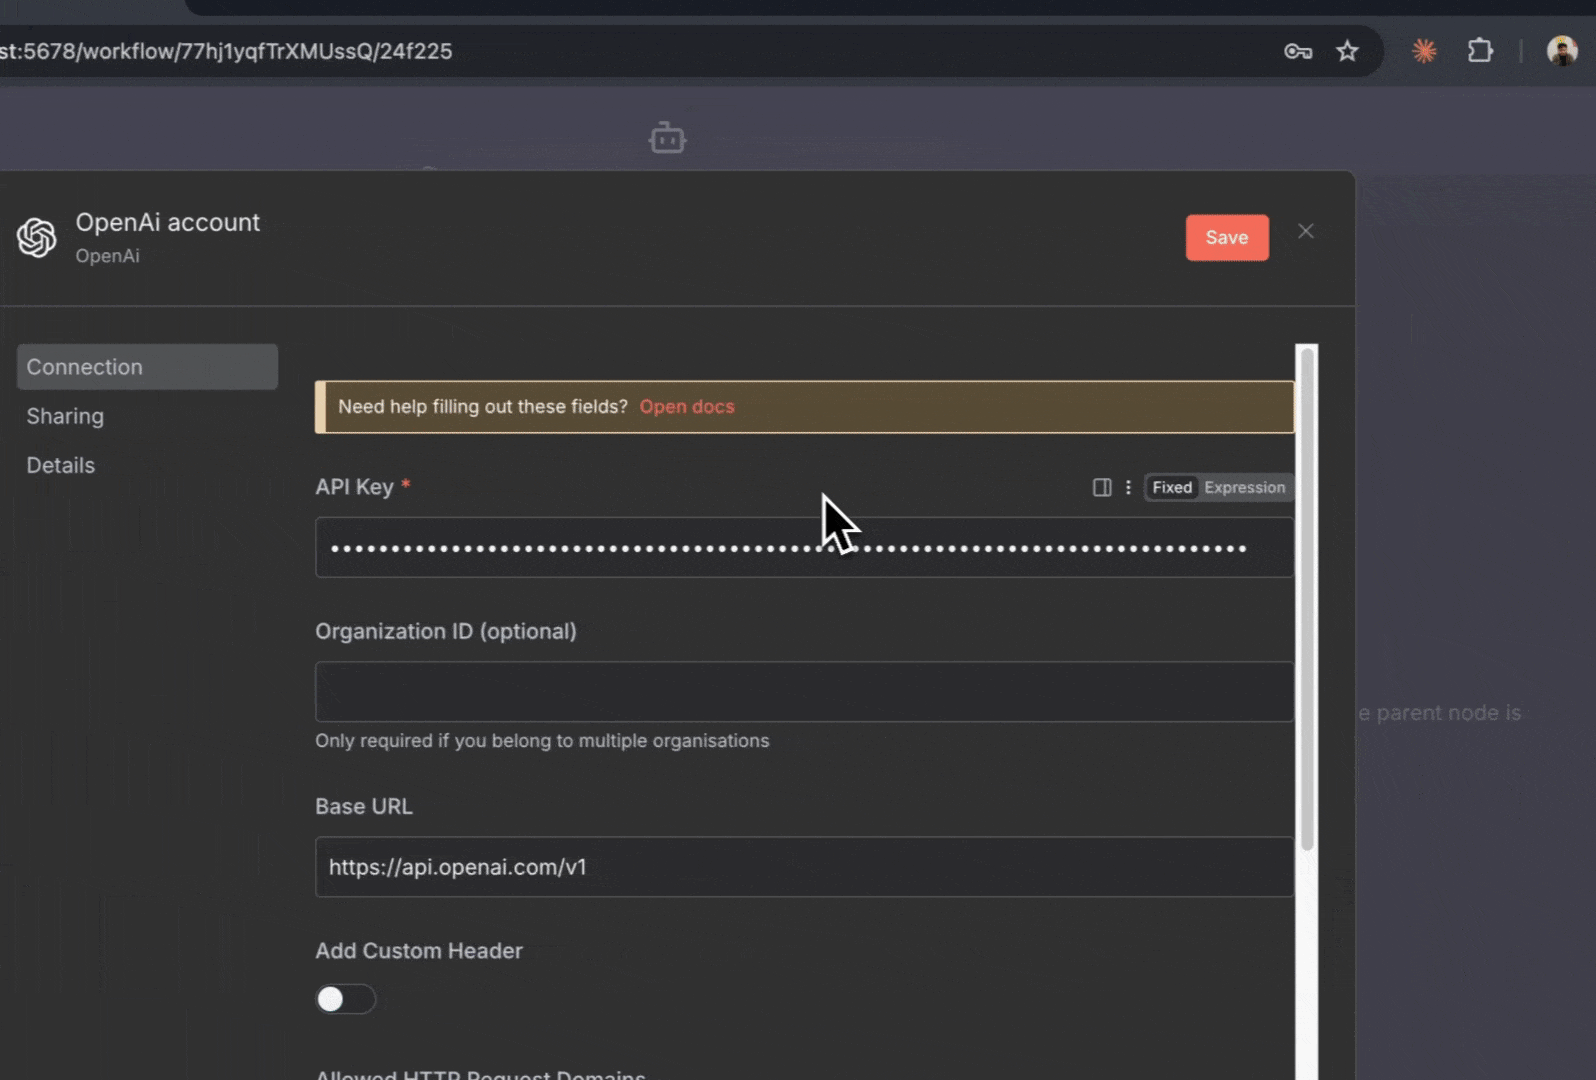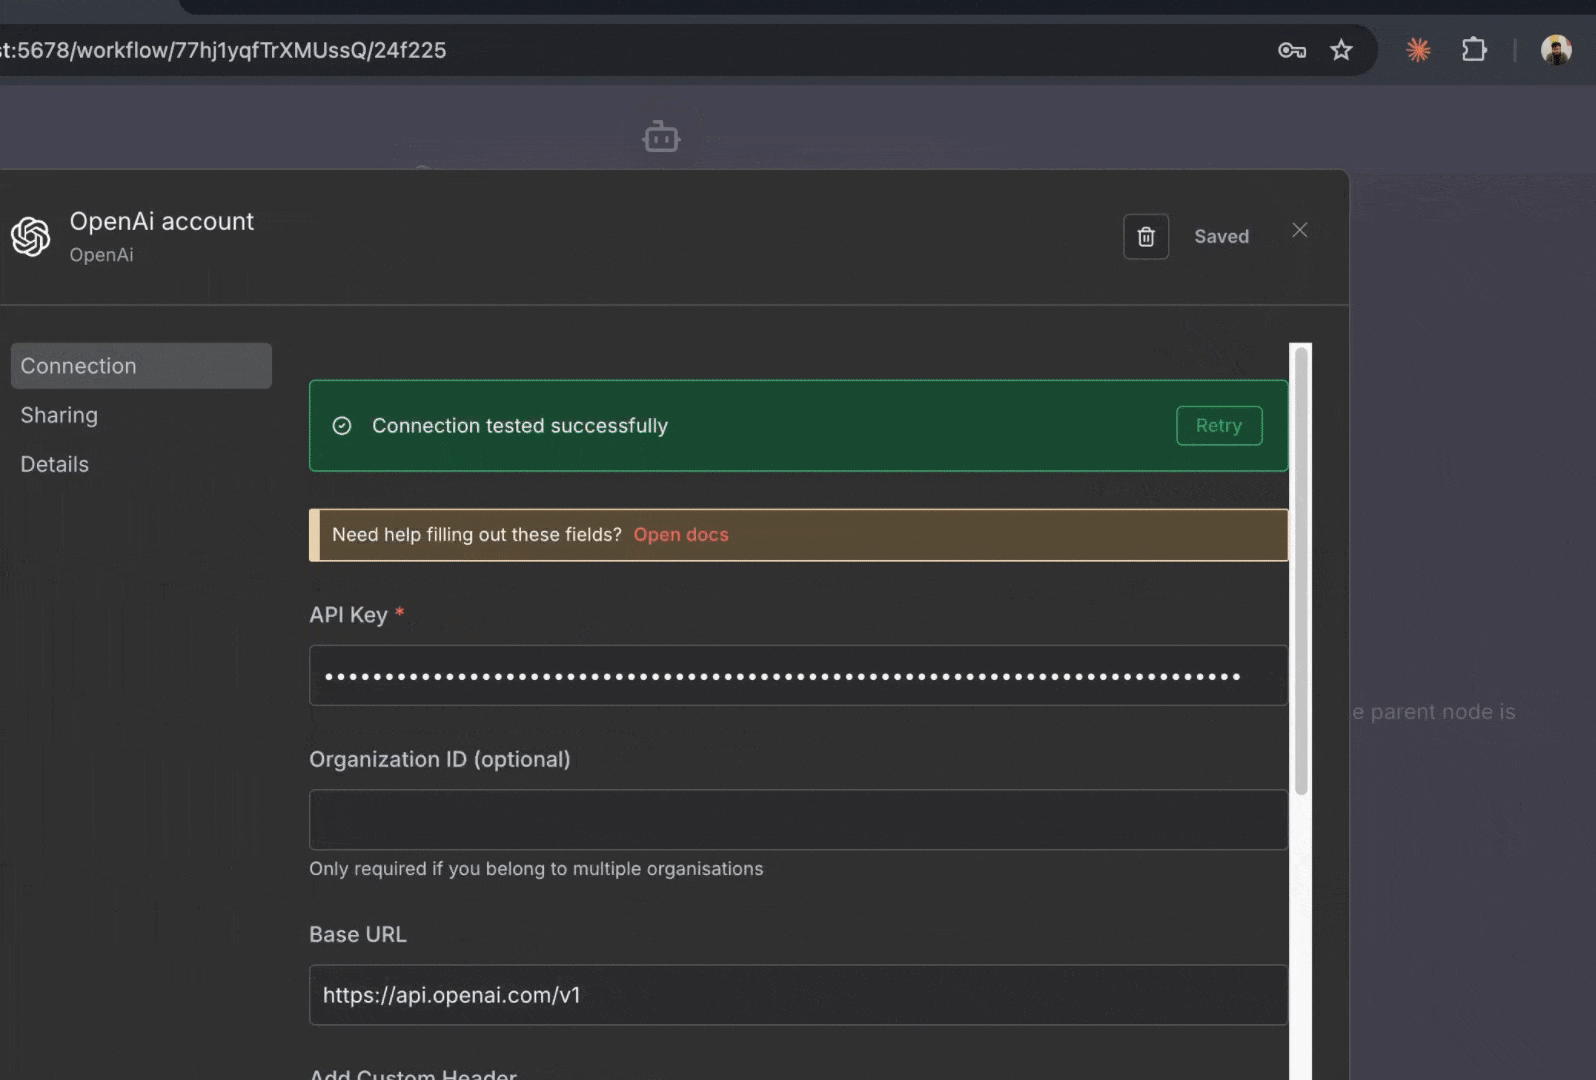
このワークフローでは、例 2 に AI を追加し、OpenAI を使用して最新の AI ニュースをインテリジェントに要約してから Telegram に送信します。 例 2 からの主な変更点:- OpenAI 認証情報の設定を追加
- Code と Telegram の間に AI Agent ノードを追加
- AI Agent がすべてのニュース記事をインテリジェントに分析・要約
- Telegram には生のニュース一覧ではなく、AI が生成した要約が送信される
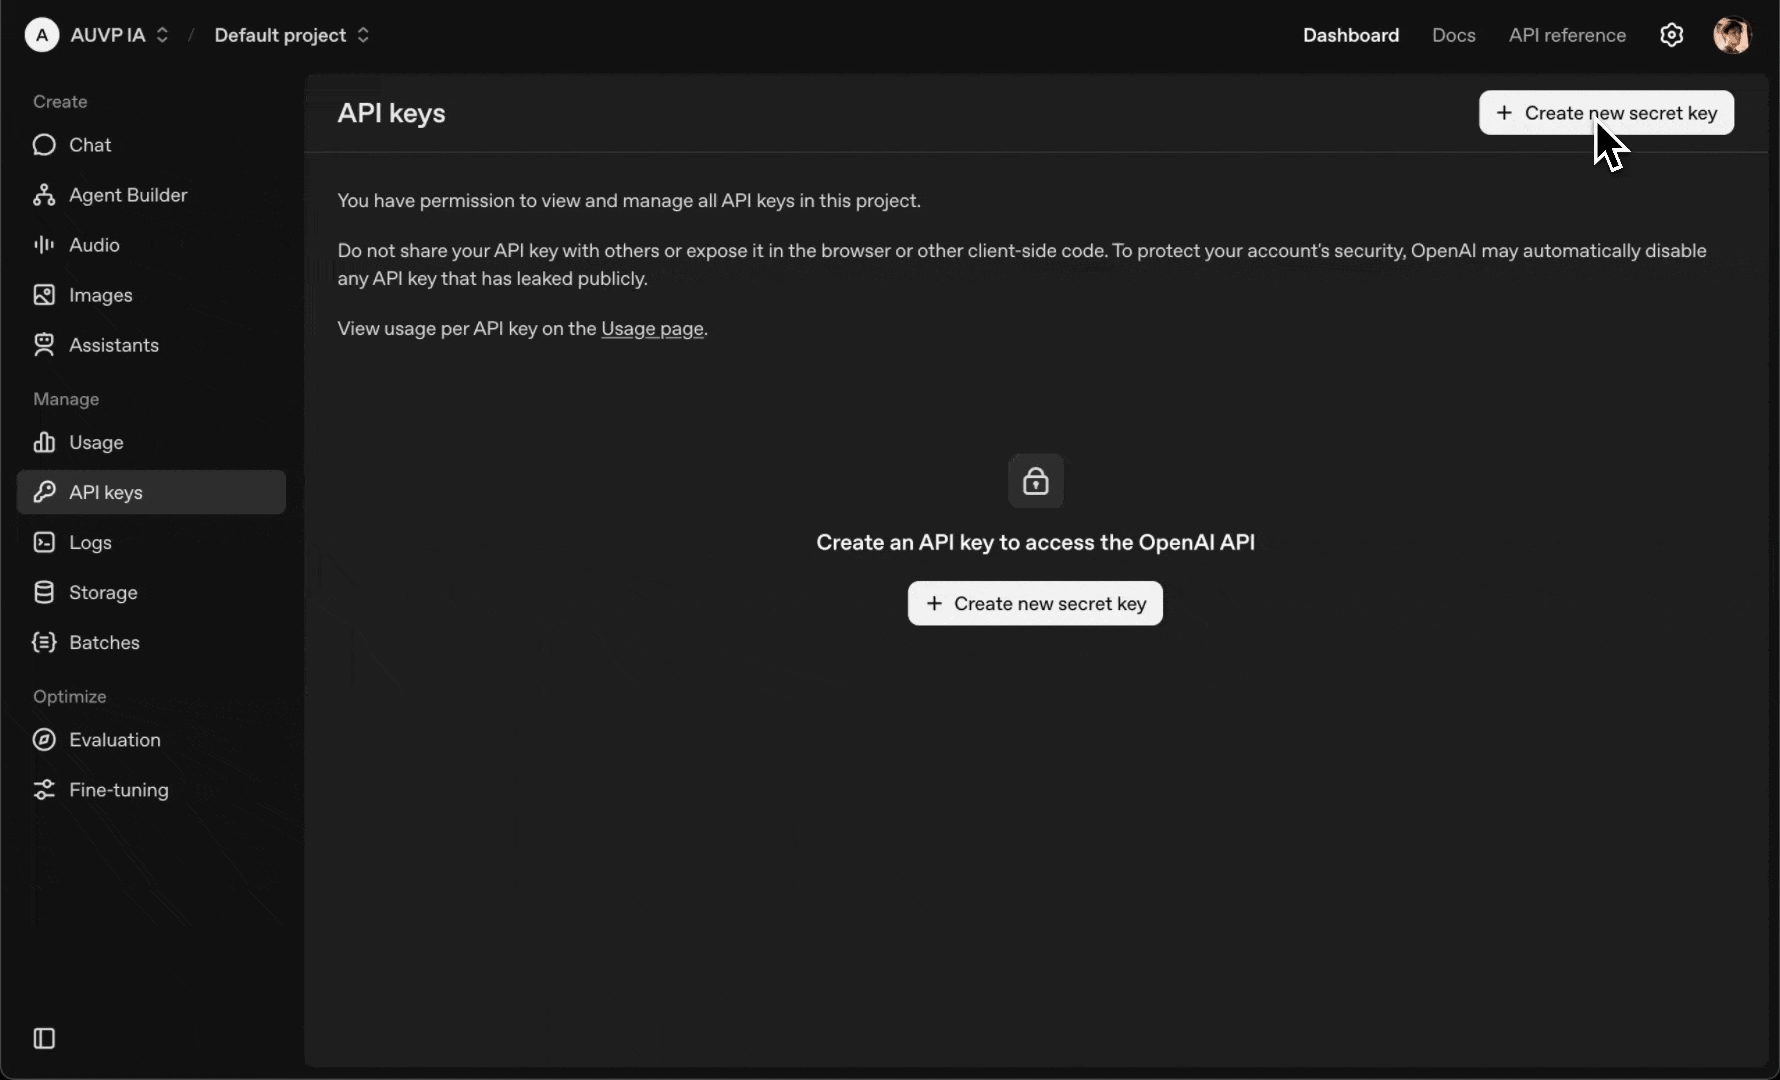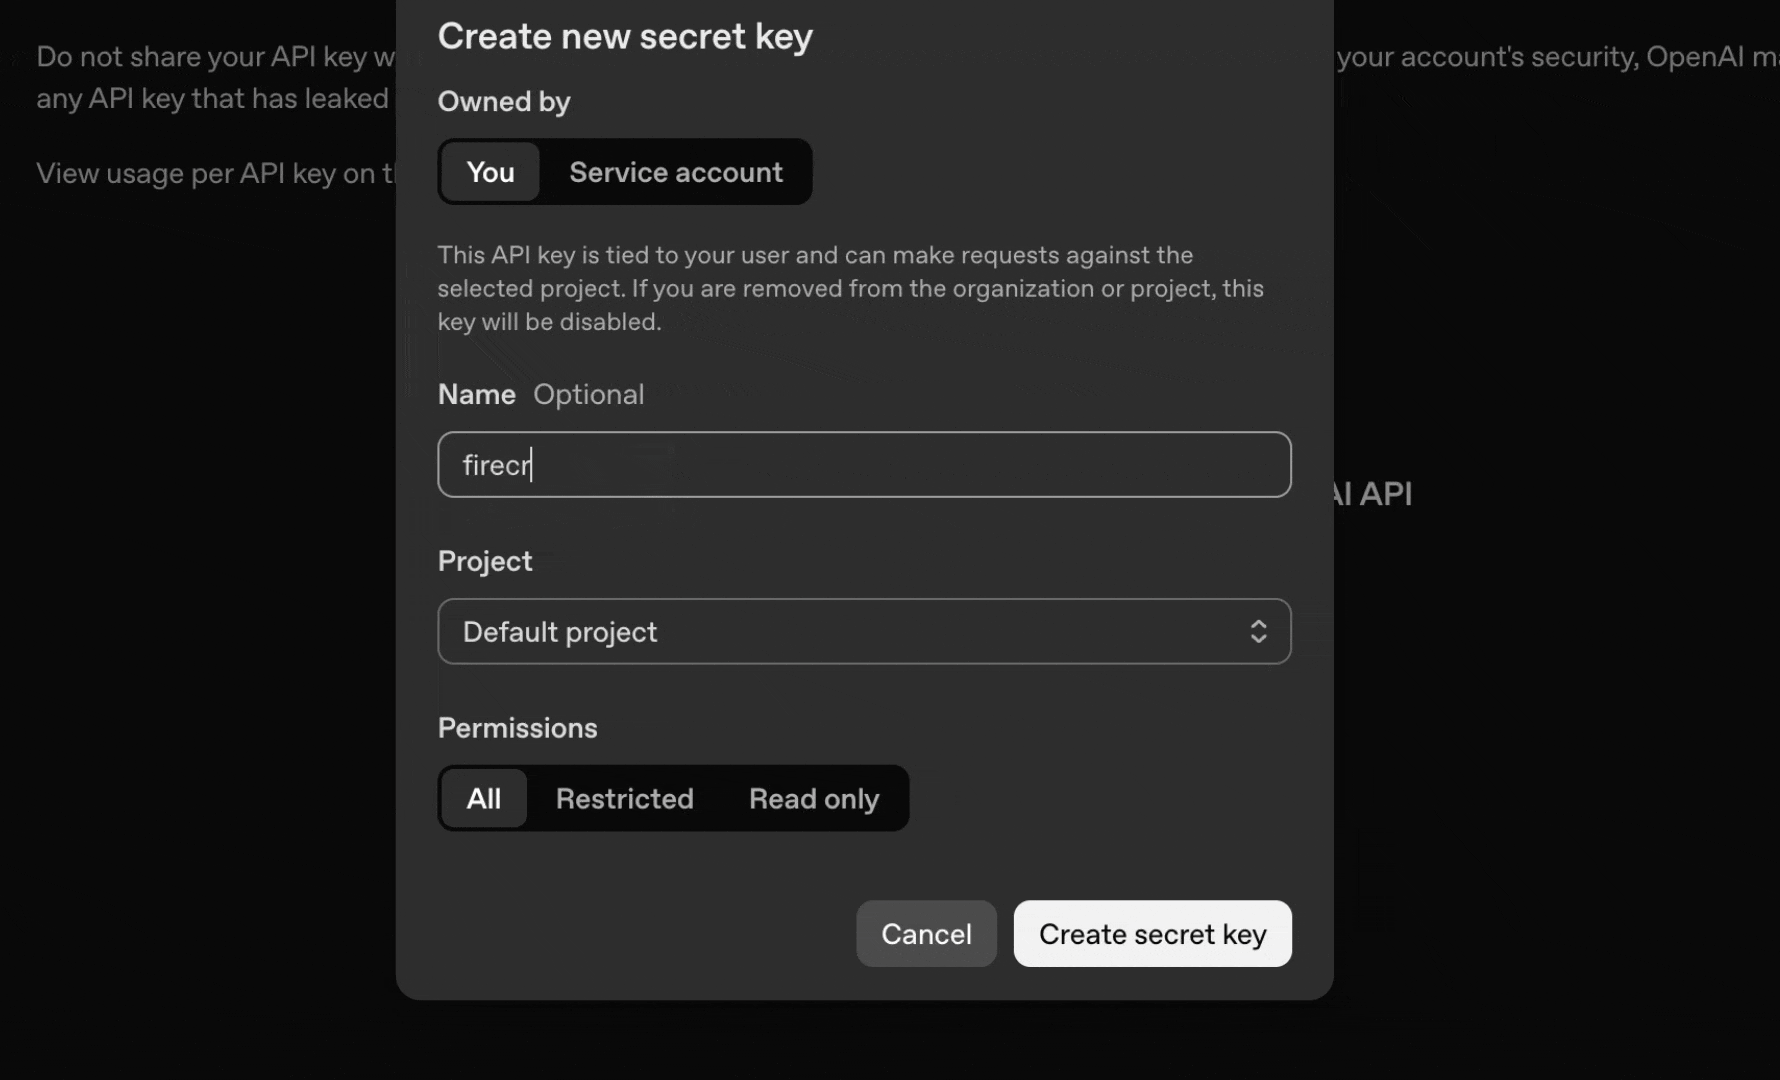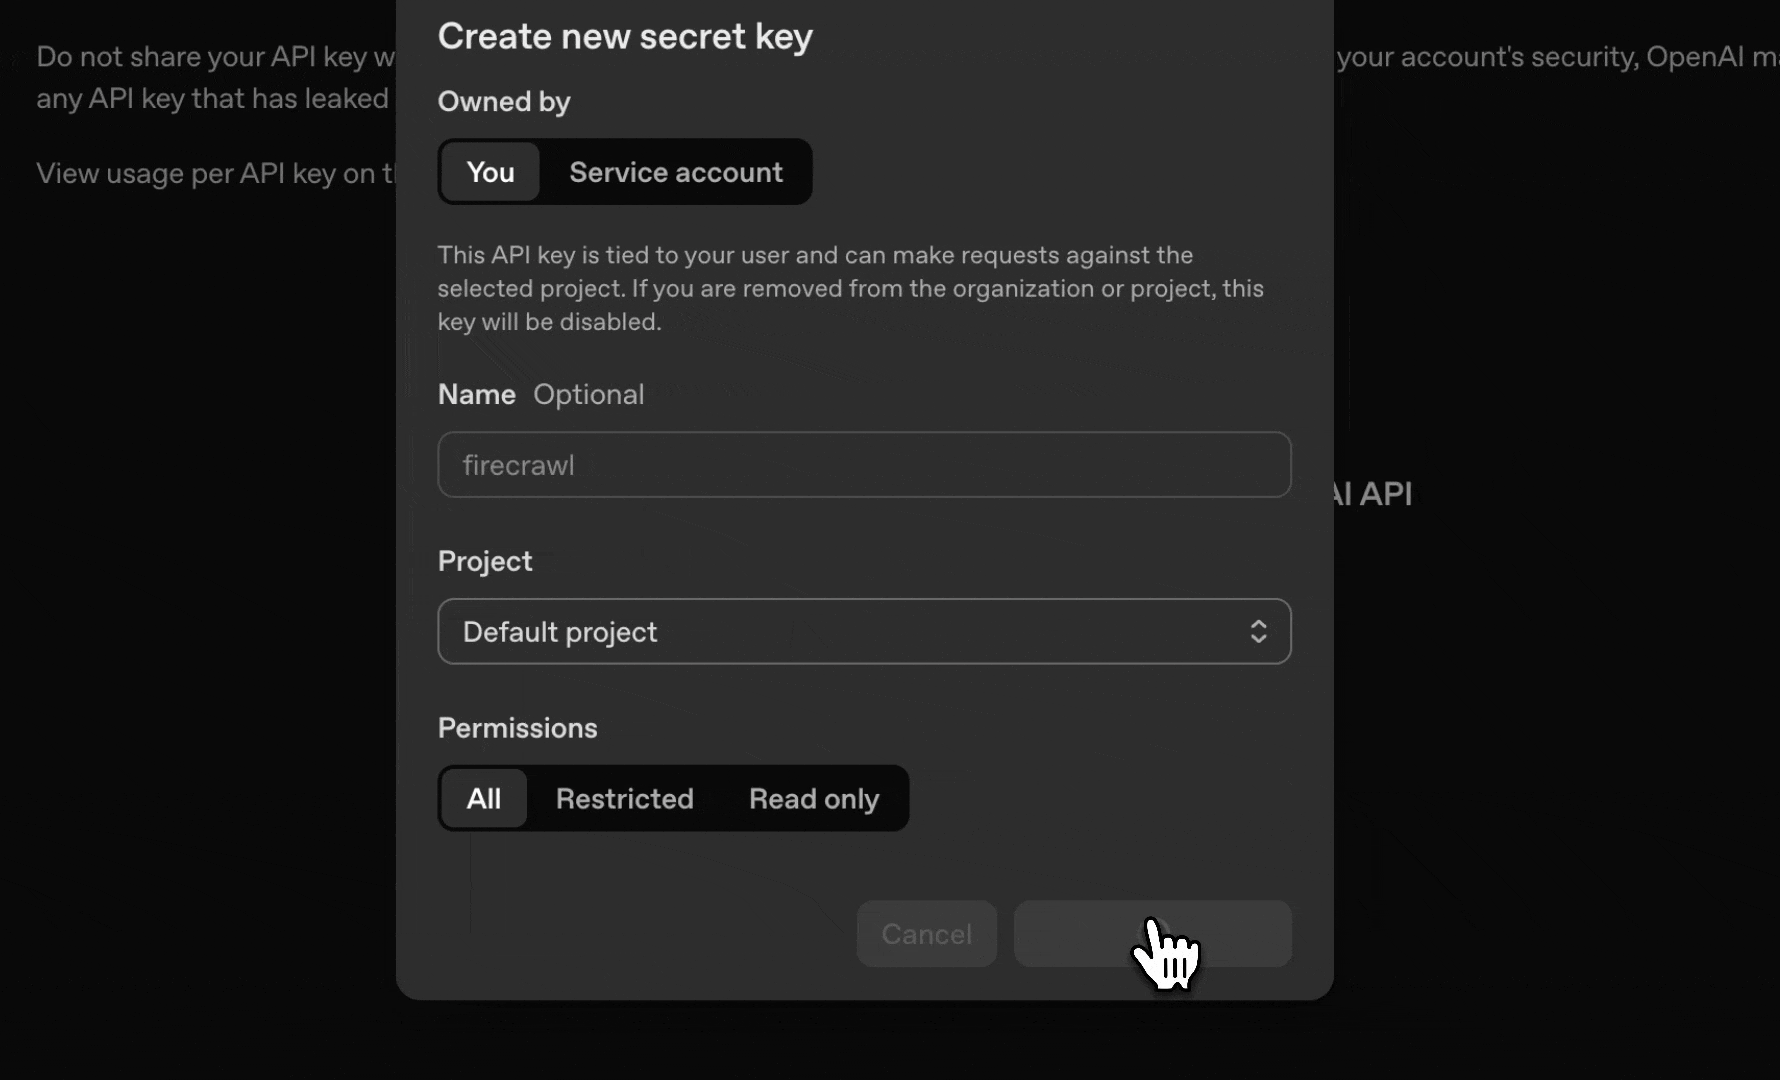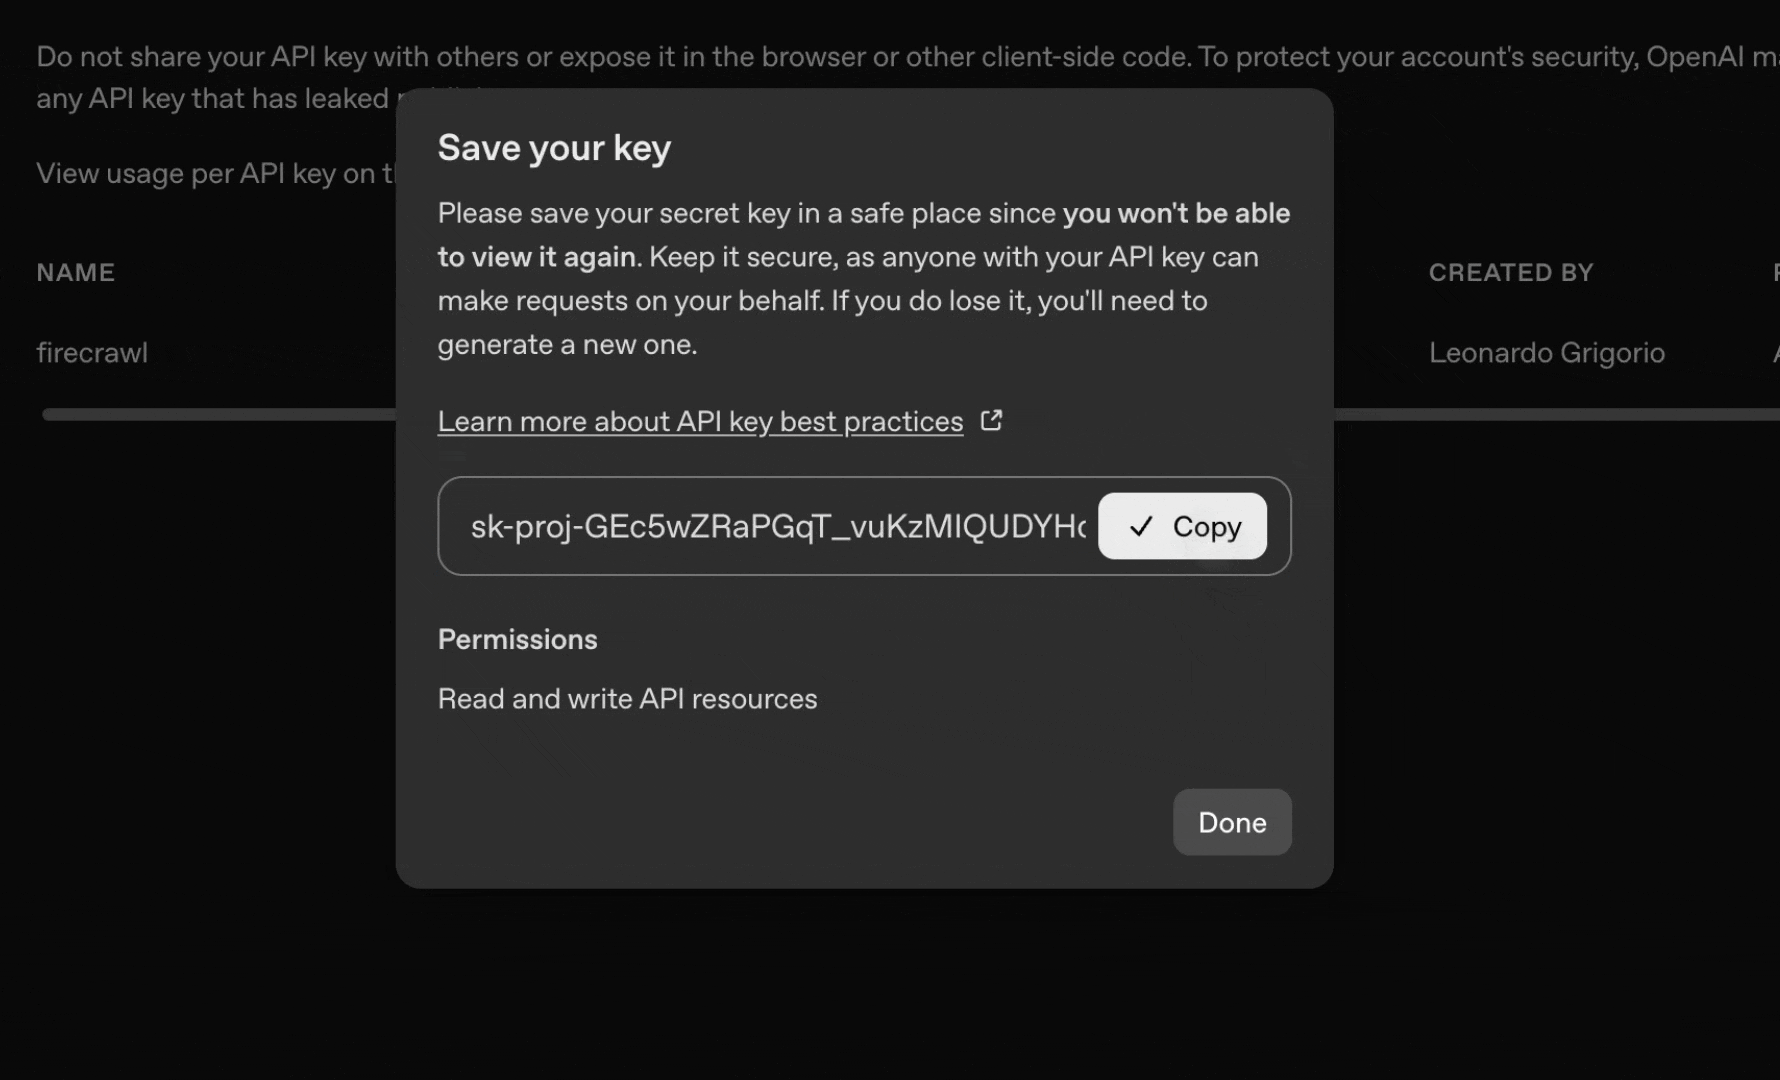
- OpenAI API キーを取得する:
- platform.openai.com/api-keys にアクセス
- サインインするか、アカウントを作成
- “Create new secret key” をクリック
- 名前を付ける (例: “n8n Integration”)
- API キーをすぐにコピーする (再度表示されることはありません)
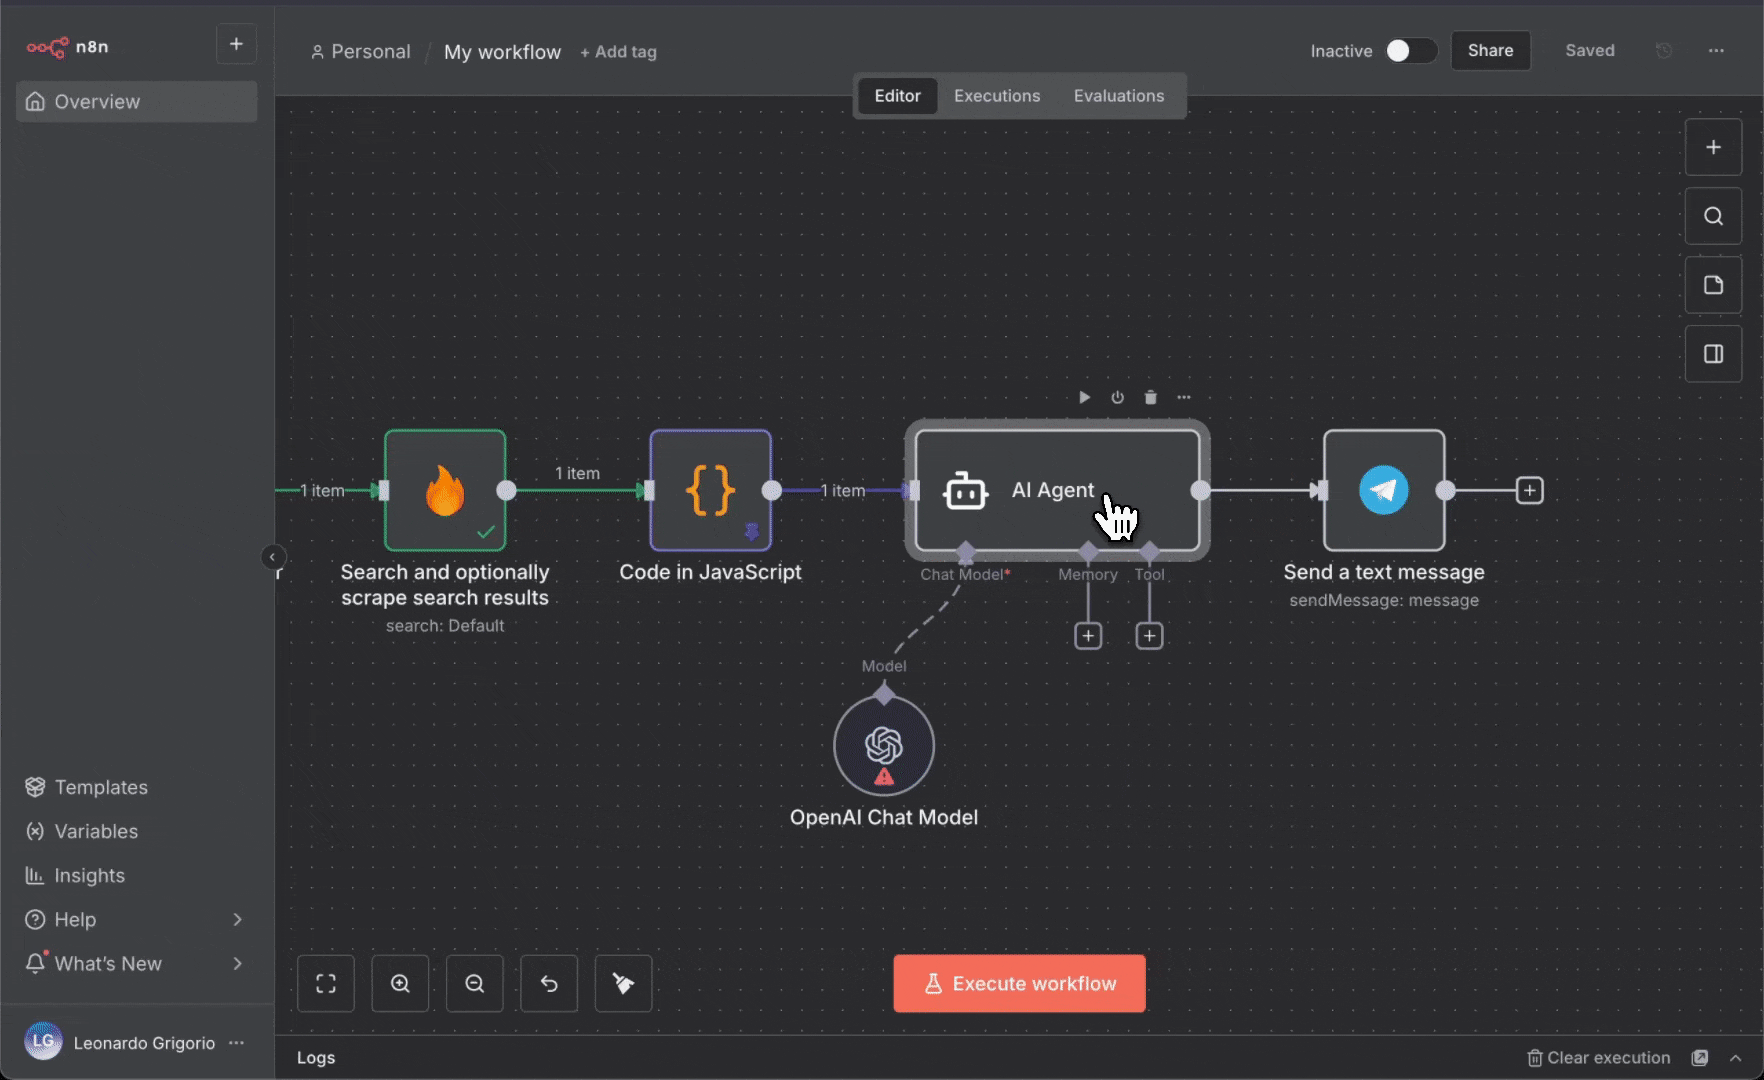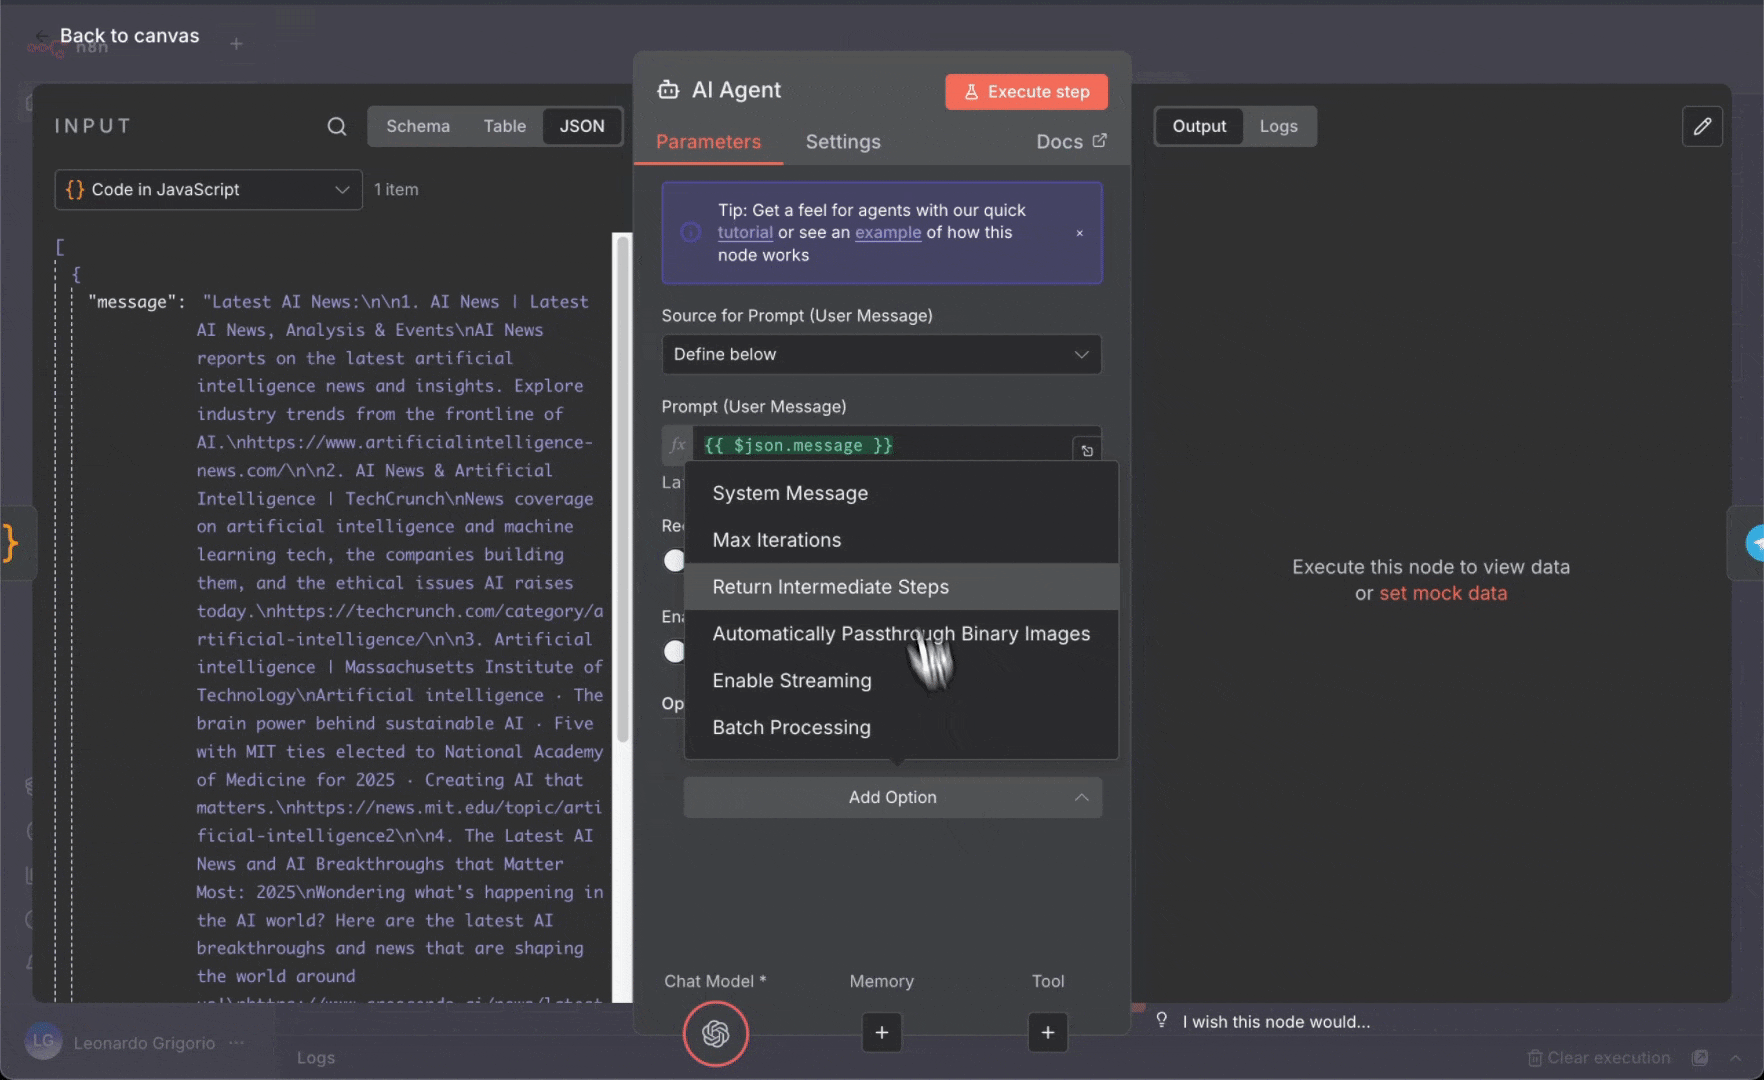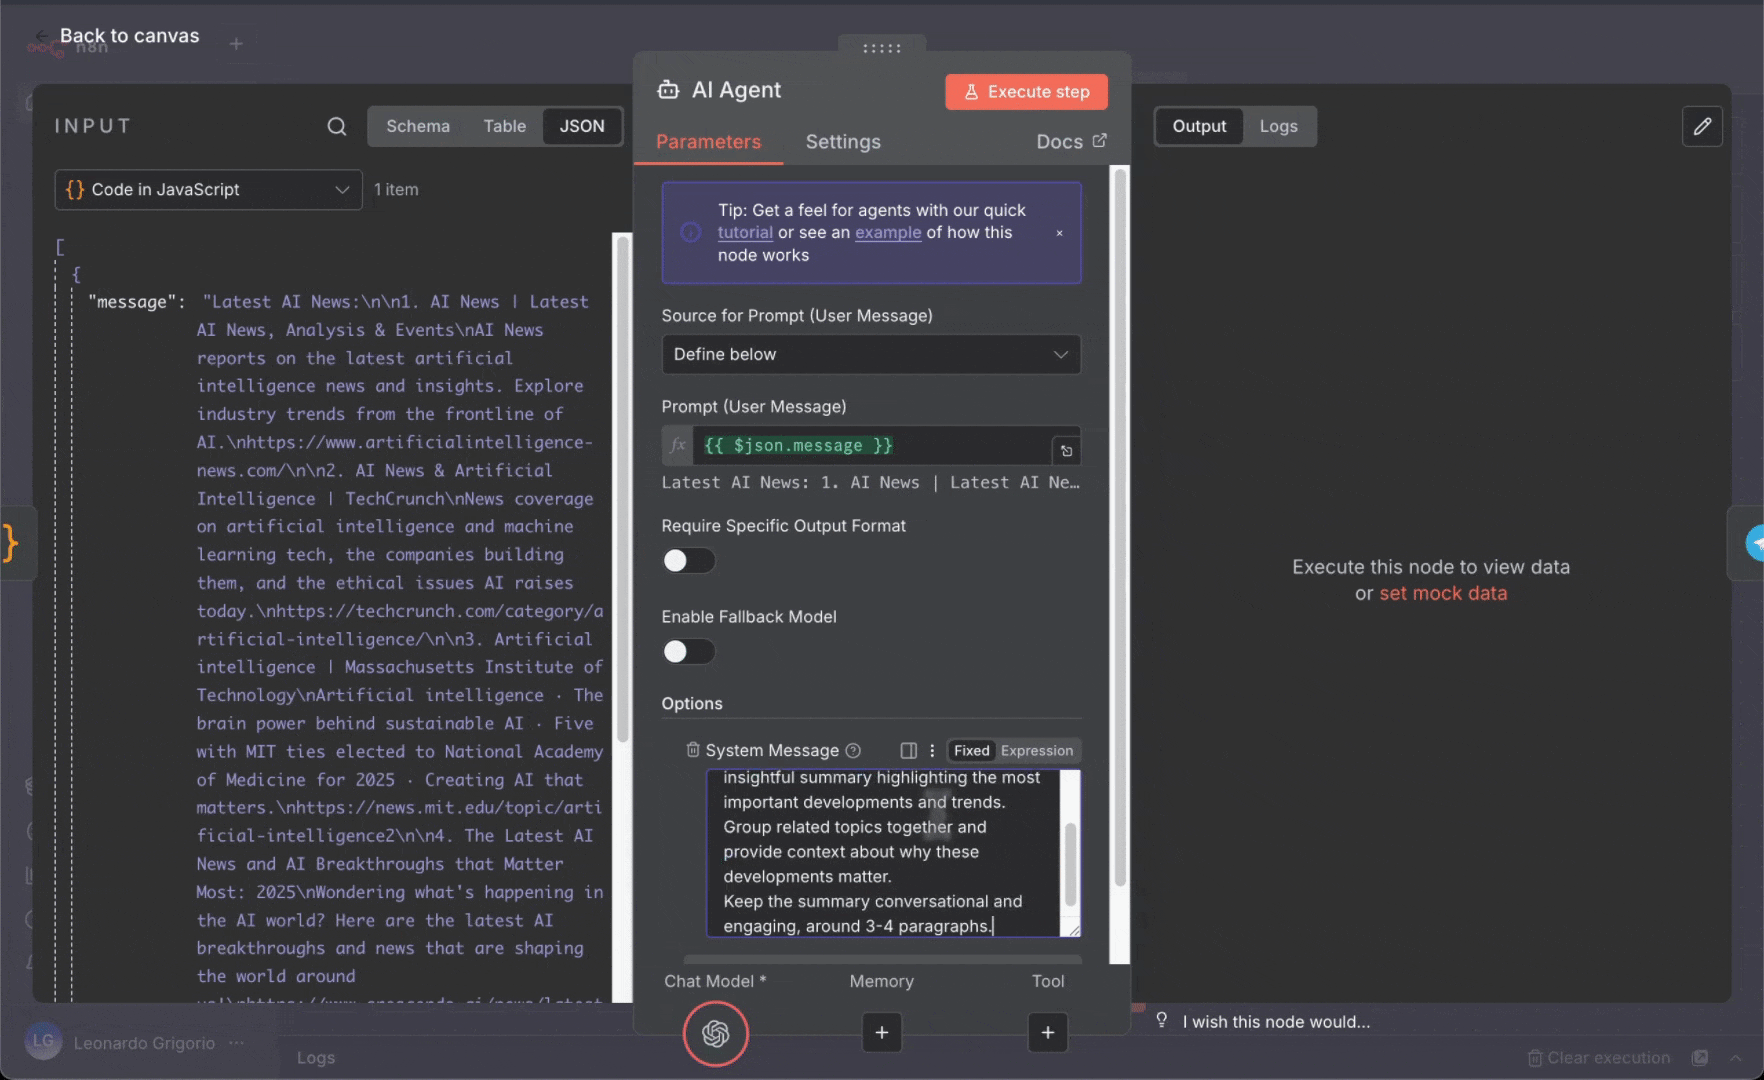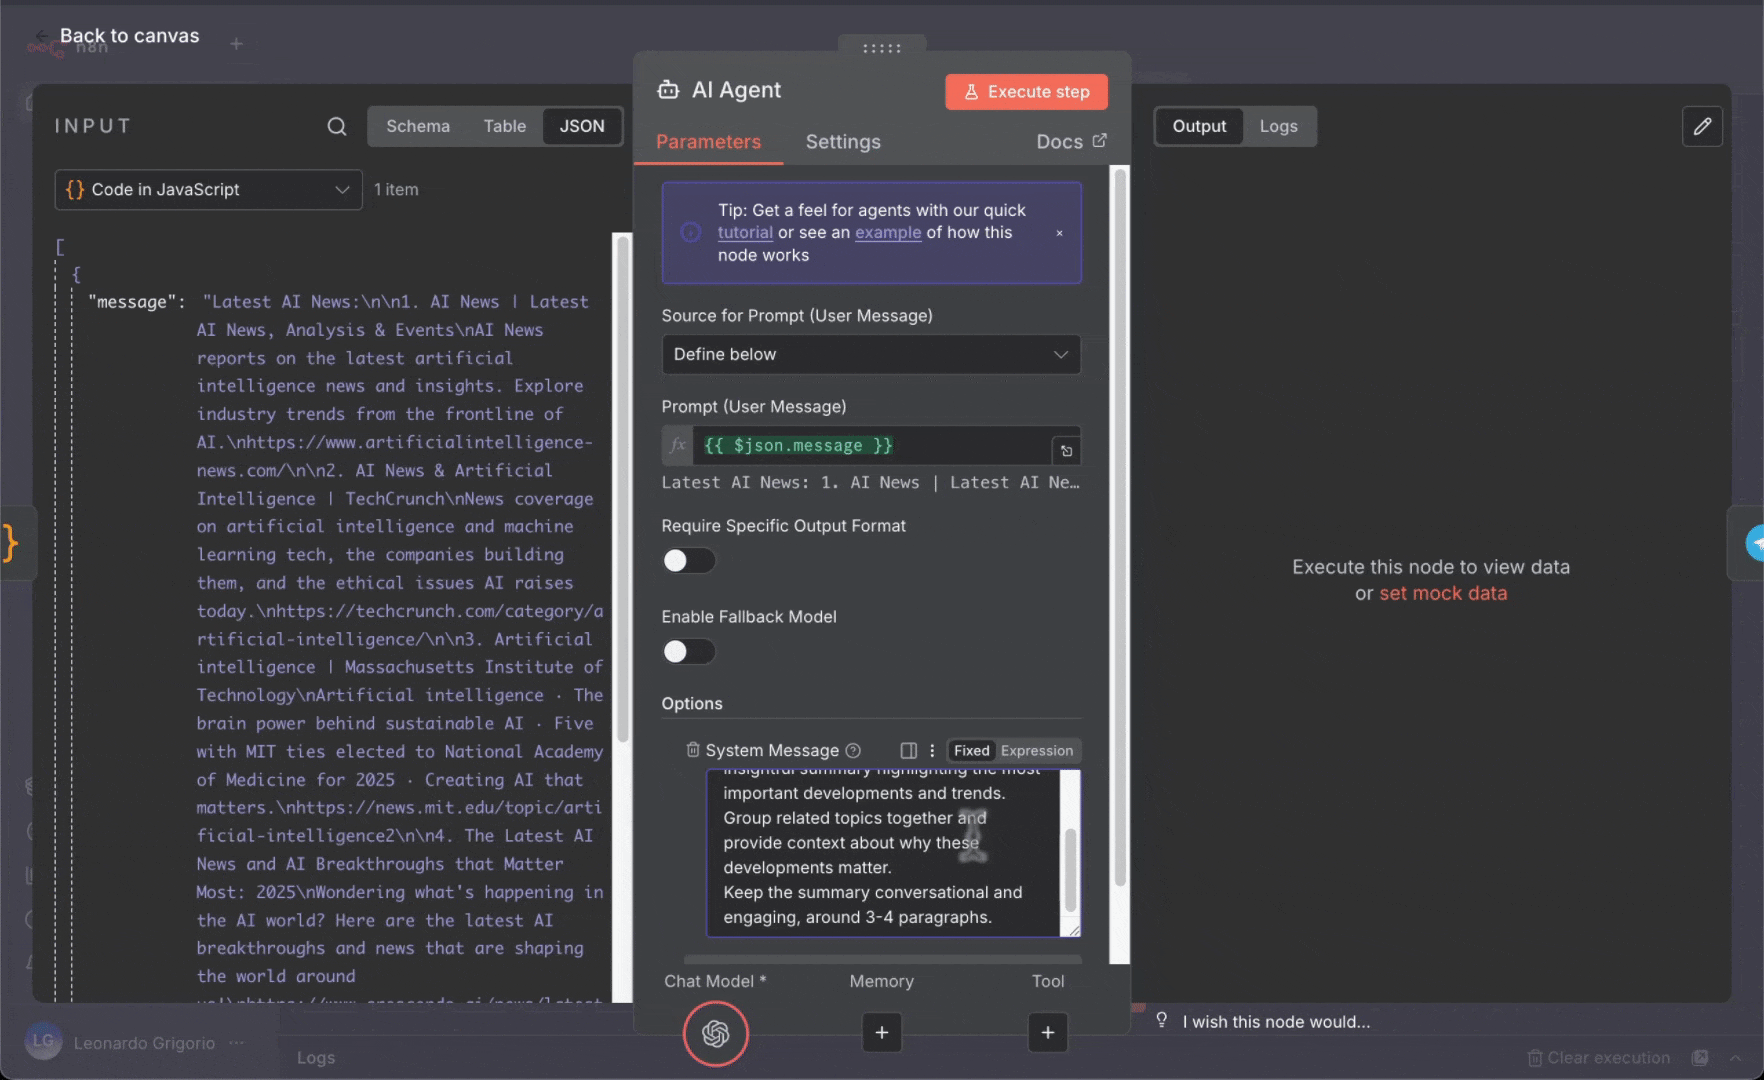
- AI Agent ノードを追加して接続する:
- Code ノードの後にある ”+” をクリック
- “Basic LLM Chain” または “AI Agent” を検索
- Code ノードの
messageフィールドを AI Agent の入力プロンプトフィールドにドラッグ - LLM プロバイダーとして OpenAI を選択

- OpenAI 認証情報を追加する:
- OpenAI の “Create New Credential” をクリック
- OpenAI API キーを貼り付け
- モデルを選択: gpt-5-mini (コスト効率重視) または gpt-5 (より高性能)
- “Save” をクリック
- AI Agent にシステムプロンプトを追加する:
- AI Agent ノードに、次のシステムプロンプトを追加します:
- Telegramノードを更新してテスト:
- Telegramノードを更新します:
- Text: AI Agentの出力 (生成された要約) をドラッグ&ドロップします
- Codeノードのmessageへの古いマッピングを削除します
- “Execute Workflow”をクリックしてテストします
- AIがすべてのニュース記事を分析し、要約を作成します
- TelegramでAIが生成した要約を確認します
- Telegramノードを更新します:

AI Agentは整形済みのすべてのニュース記事を受け取り、内容を要約します。これにより、トレンドや重要な動向をひと目で把握しやすくなります。
Firecrawlオペレーションを理解する
いくつかのワークフローを構築したので、n8nで利用できるFirecrawlの各オペレーションを見ていきましょう。Firecrawlノードでは、まずリソース (Scraping、Crawling、Map & Search、Agent、Interact、Browser、Account、またはExtract (Legacy)) を選択し、次にオペレーションを選択します。各オペレーションは、特定のウェブデータのユースケース向けに設計されています。URL をスクレイピング
リソース: スクレイピング。1つのWebページからコンテンツを抽出し、さまざまなフォーマットで返します。 機能:- 1つのURLをスクレイピング
- クリーンなMarkdown、HTML、AI生成の要約を返す
- JSON フォーマットでプロンプトまたはスキーマを指定し、構造化データを返す
- スクリーンショットを取得し、リンクを抽出可能
- 記事の抽出
- 商品ページの監視
- ブログ記事のスクレイピング
- ページ要約の生成
Interact
リソース: Interact。URL をスクレイピング の実行後も、引き続きページを操作できます。自然言語のプロンプト、または Playwright や Bash のコードを使用して、クリック、フォーム入力、ページ遷移などを行います。 オペレーション:- Execute Interaction: URL をスクレイピング の出力に含まれる
scrapeId(data.metadata.scrapeId) を使用して、スクレイピング済みのページに対してプロンプトまたはコードを実行します - Stop Interaction: 該当する
scrapeIdの Interactセッションを終了します - Get Interact Context: これらのオペレーションをツールとして呼び出す AIエージェント向けの使用方法を返します
scrapeId とプロンプトまたはコードだけです。Interact のリクエストボディには profile を追加しないでください。プロファイルはスクレイピングジョブから Interact に引き継がれます。
Cookie、localStorage などのブラウザの状態を保存するには、ワークフローの最後に Stop Interaction を実行します。以降のワークフロー実行で既存のプロファイルを読み込むだけの場合は、Scrape ステップのプロファイル設定で Save Changes をオフにしてください。
インストール済みの Firecrawl n8n ノードで URL をスクレイピング オペレーションに Profile が表示されない場合は、Firecrawl n8n ノードを最新バージョンに更新してください。また、同じ profile オブジェクトを Additional Fields > Custom Properties (JSON) で渡すこともできます:
ウェブを検索
リソース: Map & Search。ウェブ検索を実行し、必要に応じてコンテンツをスクレイピングした検索結果を返します。 機能:- ウェブ、ニュース、画像を検索
- タイトル、説明、URLを返す
- 必要に応じて検索結果の全文コンテンツをスクレイピング
- リサーチの自動化
- ニュースのモニタリング
- トレンドの発見
- 関連コンテンツの検索
Web サイトをクロールする
リソース: Crawling。Web サイト内の複数ページを再帰的に検出し、スクレイピングします。 機能:- リンクを自動的にたどる
- 1 回のジョブで複数ページをスクレイピングする
- URL をパターンで絞り込める
- クロールジョブ ID を返す (スクレイピング済みページを読み取るには、Get Crawl Status を設定した 2 つ目の Firecrawlノードを追加する)
- ドキュメント全体の抽出
- サイトのアーカイブ
- 複数ページにまたがるデータ収集
Web サイトをマップ
リソース: Map & Search。コンテンツをスクレイピングせずに、Web サイト内で見つかった URL を返します。 機能:- サイト内のリンクを検出
- 整理された URL リストを返す
- 高速かつ軽量
- URL のディスカバリー
- サイトマップの生成
- 大規模なクロールの計画
URL をバッチスクレイピング
リソース: スクレイピング。1 つの job で複数の URL を並列にスクレイピングします。 機能概要:- URL のリストを一括処理し、すべての URL に同じスクレイピングのオプションを適用します
- ループで個別に処理するよりも効率的です
- バッチのジョブ ID を返します。Get Batch Scrape Status を追加すると、すべての結果をまとめて取得できます
- URL リストの処理
- 大量のデータ収集
- 大規模なスクレイピングプロジェクト
Agent
リソース: Agent。AIエージェントを使用して、自然言語のプロンプトに基づき Web サイトを自律的に閲覧し、データを抽出します。 機能概要:- 必要なデータを記述したプロンプトに加え、任意で URL と JSONスキーマを指定できます
- AIエージェントが自律的にページを巡回し、情報を抽出します
- Extract Data With AI Agent (結果を待機) と Start AI Agent Job (Async) (ジョブ ID を即座に返す) の2種類のオペレーションがあります
- 非同期オペレーションを使用する場合は、Get Agent Status で結果をポーリングします
- プロンプトに基づく、複数ページにまたがる複雑なデータ収集
- ページの正確な構造がわからない場合の情報抽出
- 複数ページの巡回が必要な調査タスク
- Extract Data With AI Agent は、ジョブの開始から結果の待機までを1ステップで行います。ほとんどのユースケースではこれが最もシンプルです。Max Wait Time パラメータで、ノードがタイムアウトするまでポーリングを続ける時間を指定します (デフォルト: 300秒、最大: 600秒) 。エージェントジョブがこの時間を超えると、ノードは
jobIdとともにtimeoutステータスを返します。ただし、Firecrawl 側ではジョブが引き続き実行され、完了する場合があります。その ID を Get Agent Status に渡すか、10分を超える可能性のあるジョブには非同期オペレーションを使用してください。 - Start AI Agent Job (Async) はジョブ ID を即座に返します。ジョブの完了後に結果を取得するには、Get Agent Status オペレーションを設定した2つ目のFirecrawlノードを追加します。
構造化データを抽出 (レガシー)
リソース: Extract (Legacy)。AI を使用して、プロンプトまたはスキーマに基づき複数の URL から構造化された情報を抽出します。結果は Get Extract Status で読み取ります。 このリソースはレガシーの/extract エンドポイントを呼び出します。新しいワークフローでは、代わりに Agent を使用してください。対象のページがすでにわかっている場合は、URL をスクレイピング を JSON フォーマットで使用してください。
ブラウザサンドボックス
リソース: Browser。コードで制御可能な永続的ブラウザセッションを提供します。単一のセッション内で、複数ステップのブラウザ自動化を実行できます。 オペレーション:- Create Browser Session: 新しいブラウザセッションを開始し、その
idを返します - Execute Browser Code: セッション内でNode (Playwright)、Python、またはBashコードを実行します。作成ステップで取得した
idをSession IDとして使用します - Get Many Browser Sessions: アクティブまたは破棄済みのセッションを一覧表示します
- Delete Browser Session: 不要になったセッションを破棄します
- Get Browser Context: これらのオペレーションをツールとして呼び出すAIエージェント向けに、使用方法と有効なセッションを返します
- ページをまたいで状態を維持する必要がある複数ステップのブラウザワークフロー
- ステップ数が事前にわからない動的なページナビゲーション
- 実行をまたいでCookieとlocalStorageを保持するために、永続的なブラウザプロファイルを使用するワークフロー
idを、後続の各実行または削除ステップに渡します。n8nのLoop Over Itemsノードを使用して動的なページリストを反復処理し、同じセッション内で各ページに対して実行を呼び出します。
ブラウザサンドボックス機能の詳細については、ブラウザサンドボックスのドキュメントを参照してください。
アカウント
リソース:アカウント。Team のクレジット使用量、トークン使用量、キューのステータスを取得します。大規模な job を実行する前に、ワークフロー内で残りのクレジットを確認できます。ワークフローテンプレートと例
ゼロから構築する代わりに、あらかじめ用意されたテンプレートを使って始められます。n8nコミュニティでは、コピーしてカスタマイズできるFirecrawlワークフローが数多く作成されています。注目のテンプレート
n8n 完全チュートリアル
Firecrawl と n8n を使って、Web にアクセスできる AI チャットボットを構築
本番環境向けワークフロー 8 選
リード生成や価格監視などにすぐ使えるテンプレート
Supabase pgvector RAG パイプライン
ページをスクレイピングして埋め込みを生成し、RAG 用に Supabase pgvector に保存
AI によるリードエンリッチメント
企業の Web サイトをスクレイピングし、構造化されたビジネスシグナルを抽出
Pinecone RAG パイプライン
ページをスクレイピングして埋め込みを生成し、RAG 用に Pinecone に保存
n8n コミュニティワークフロー
Firecrawl を使用した数百のワークフローを閲覧
公式 n8n 連携
公式の連携ドキュメントを表示
テンプレートをインポートする方法
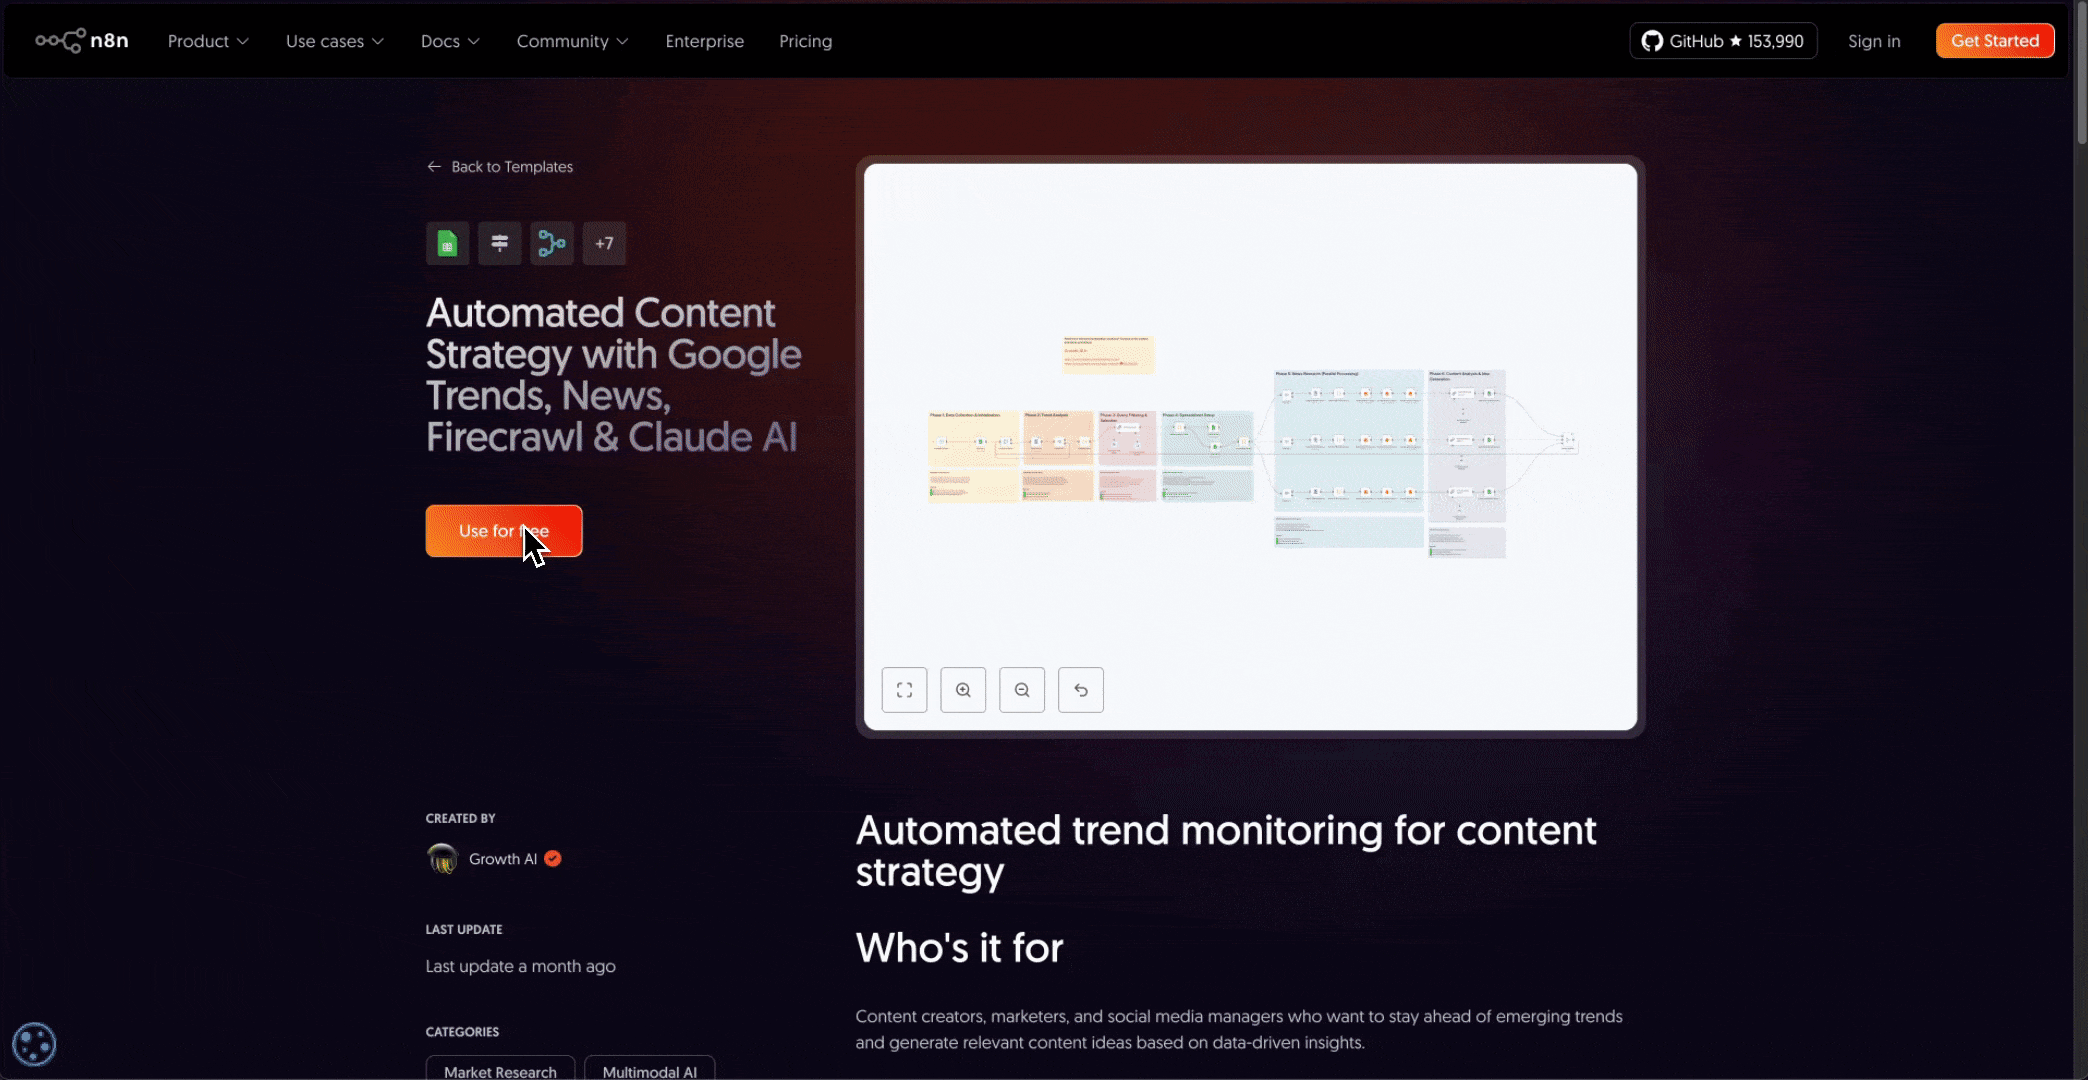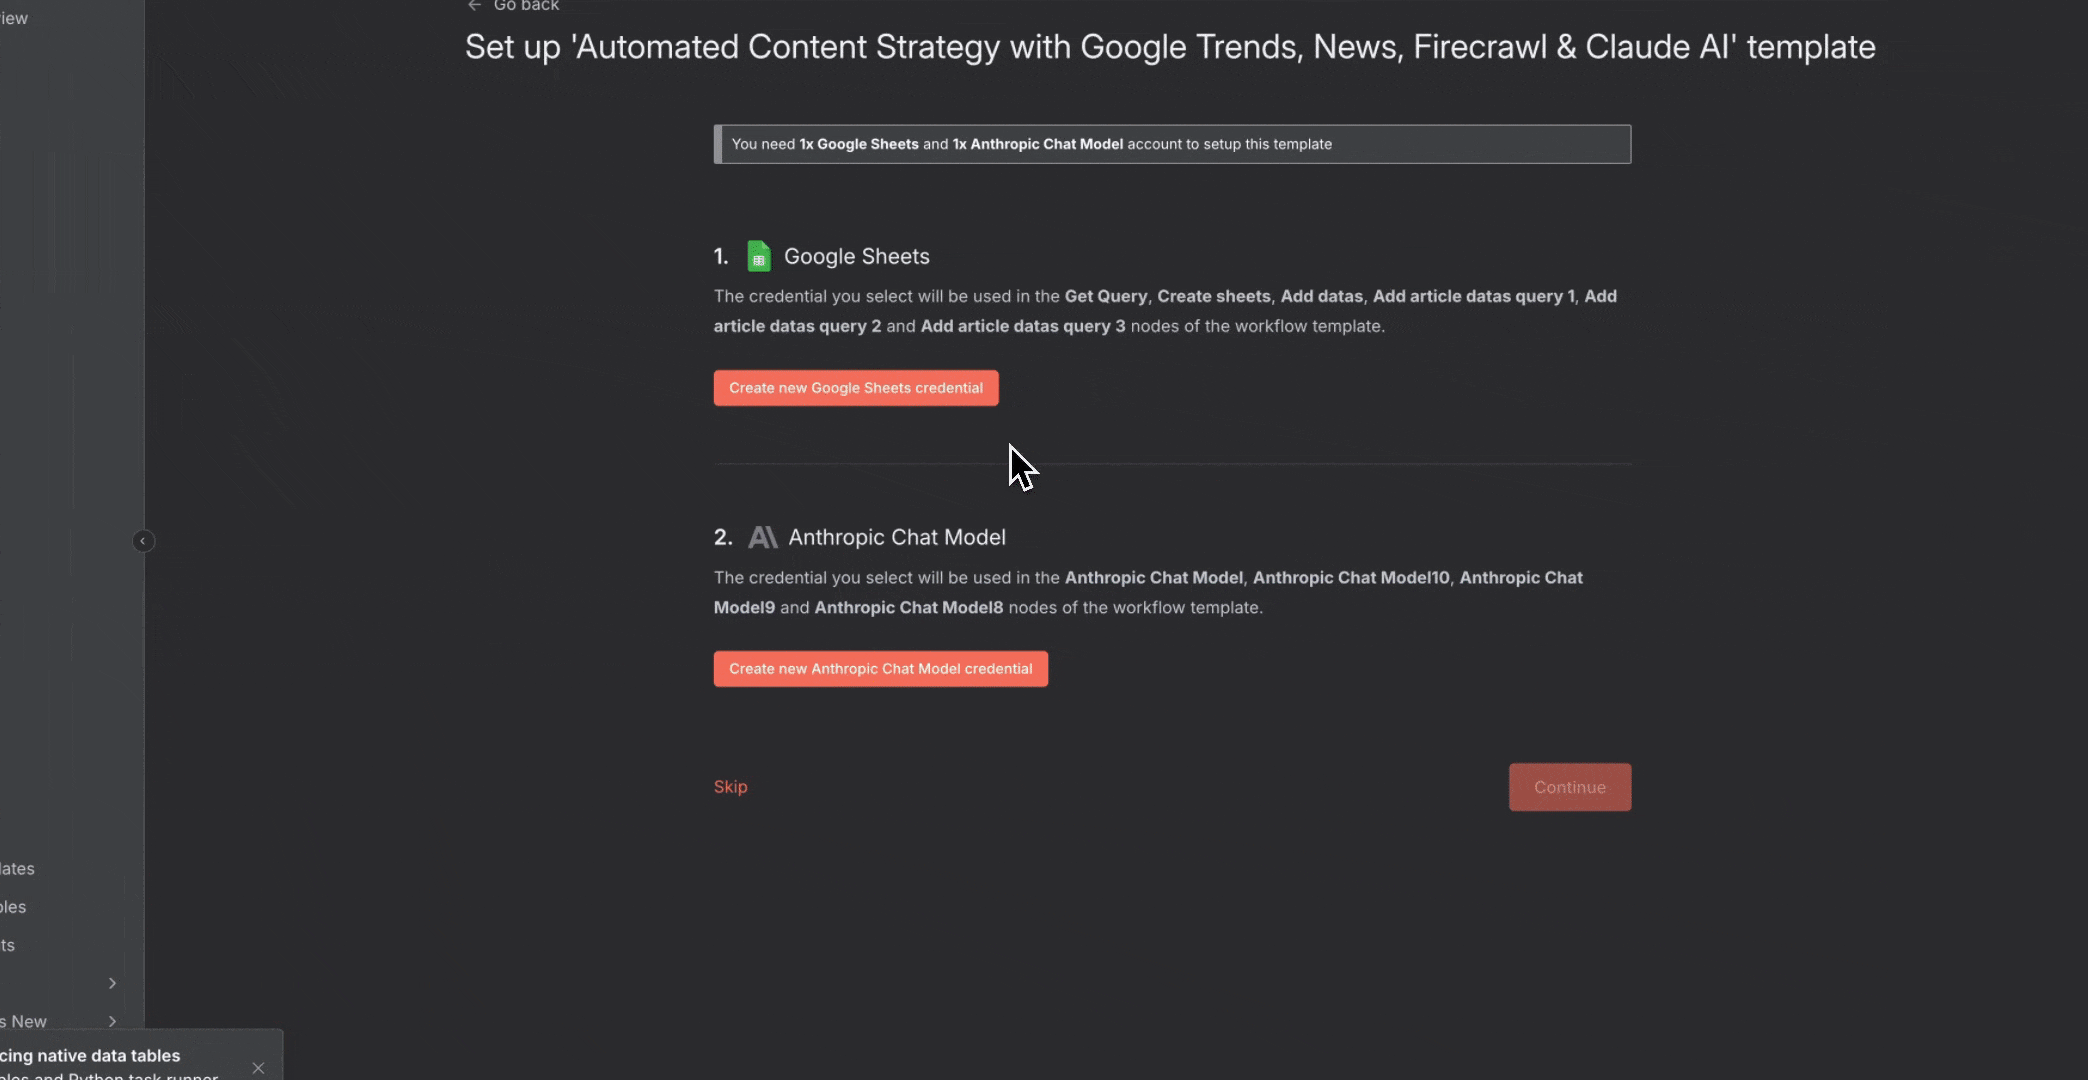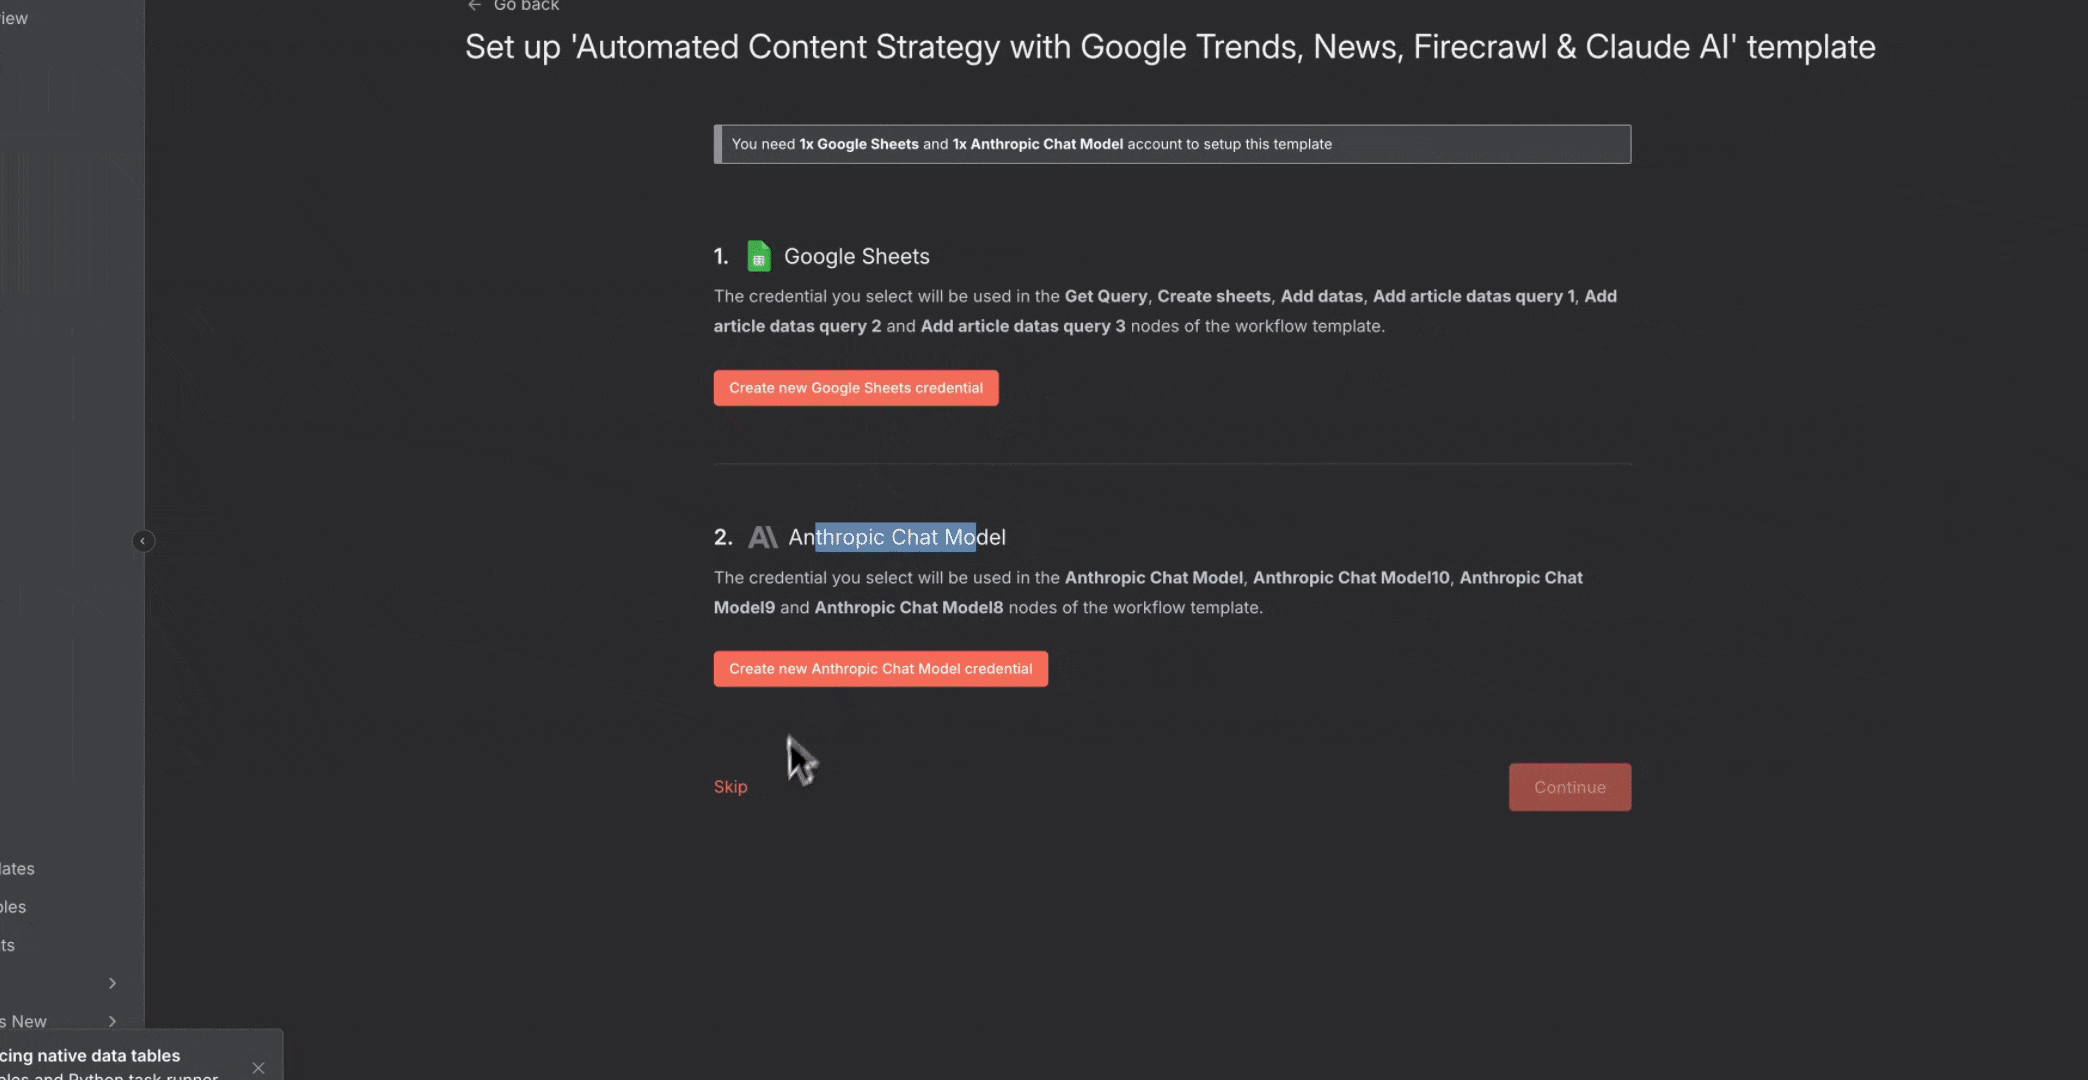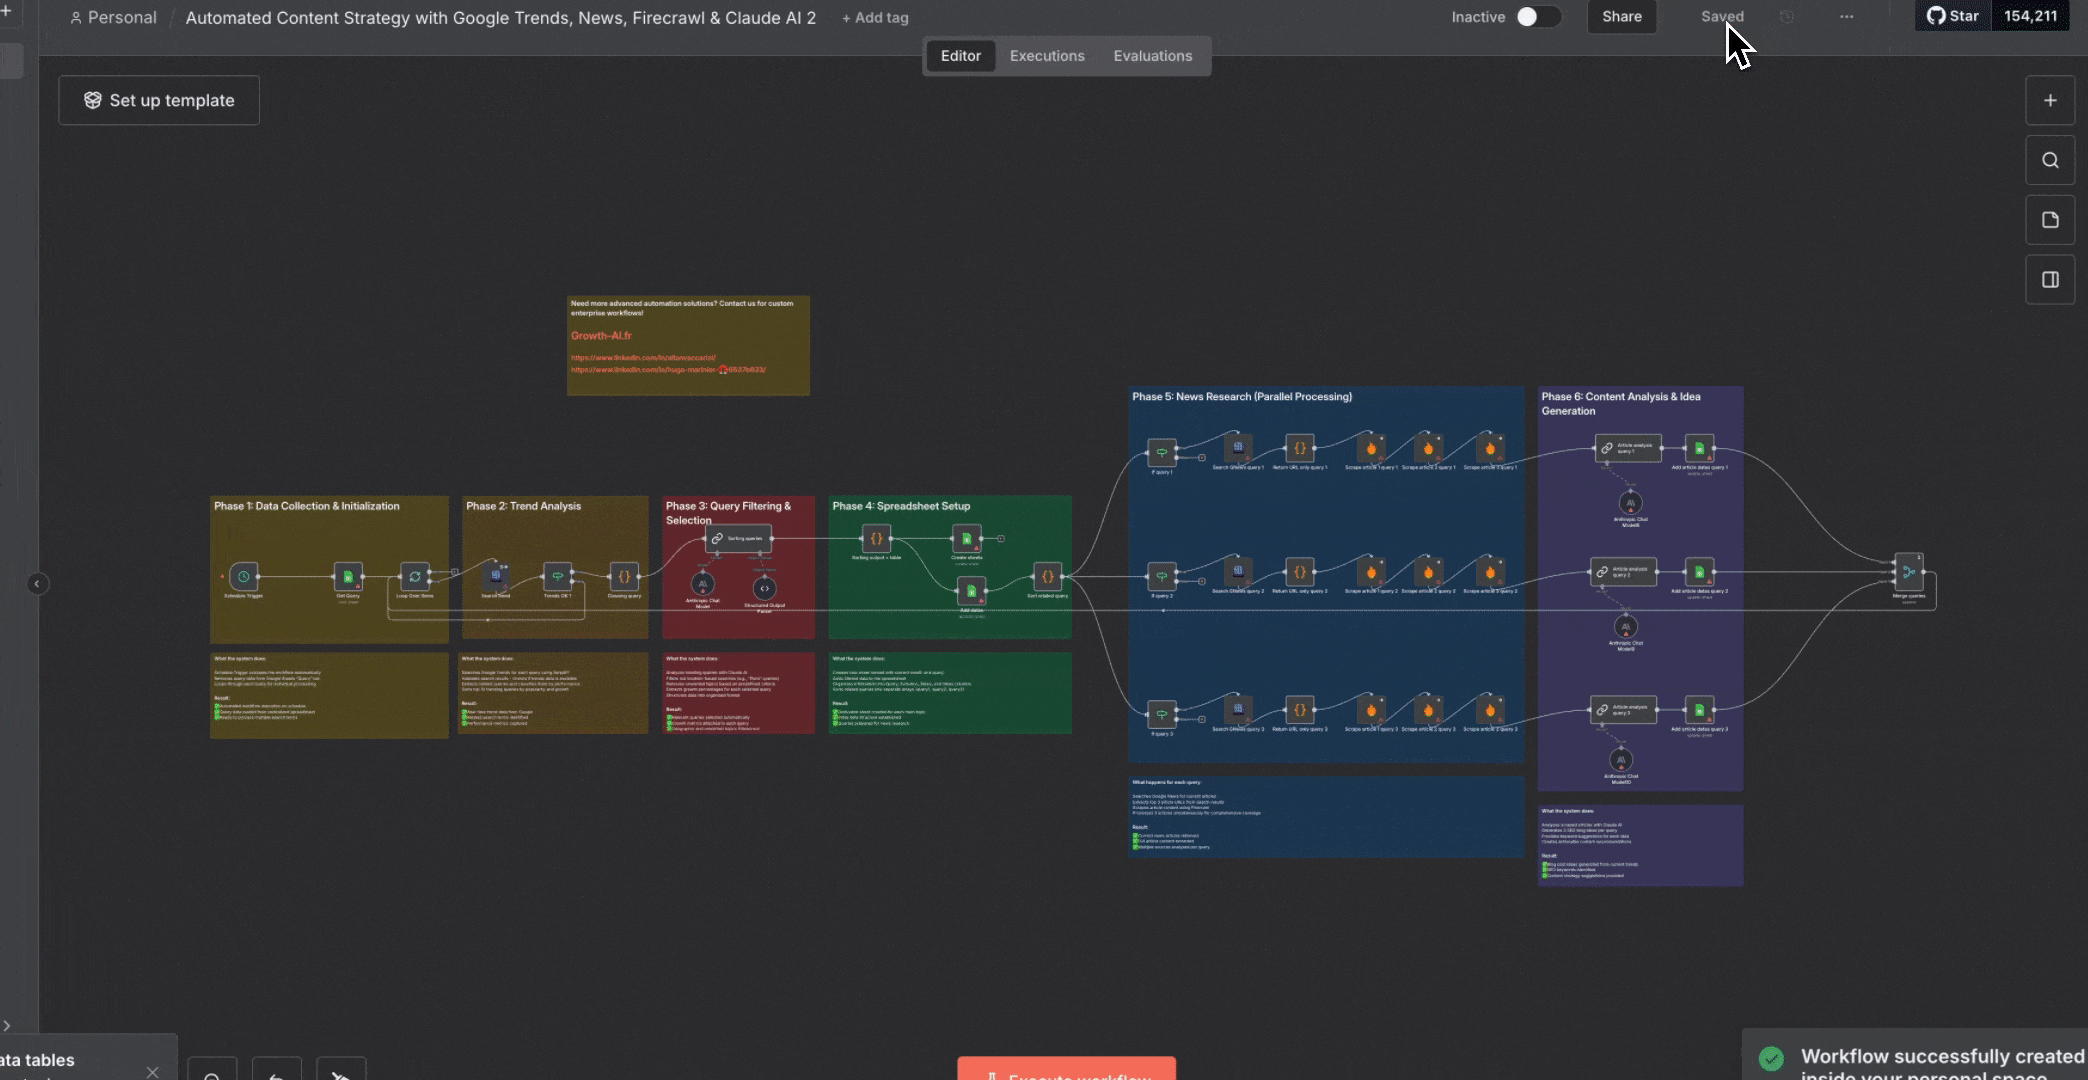
n8nコミュニティのテンプレートを使用するには:- ワークフローテンプレートのリンクをクリックします
- テンプレートページで「Import template to localhost:5678 self-hosted instance」ボタンをクリックします
- n8nインスタンスでワークフローが開きます
- 各ノードの認証情報を設定します
- ユースケースに合わせて設定をカスタマイズします
- ワークフローを有効化します
ベストプラクティス
信頼性が高く効率的なワークフローを構築するために、以下のガイドラインに従ってください:テストとデバッグ
- スケジュールを有効にする前に、必ずワークフローを手動でテストしてください
- “Execute Workflow” ボタンを使用して、フロー全体をテストします
- 各ノードの出力データを確認して、正しさを検証します
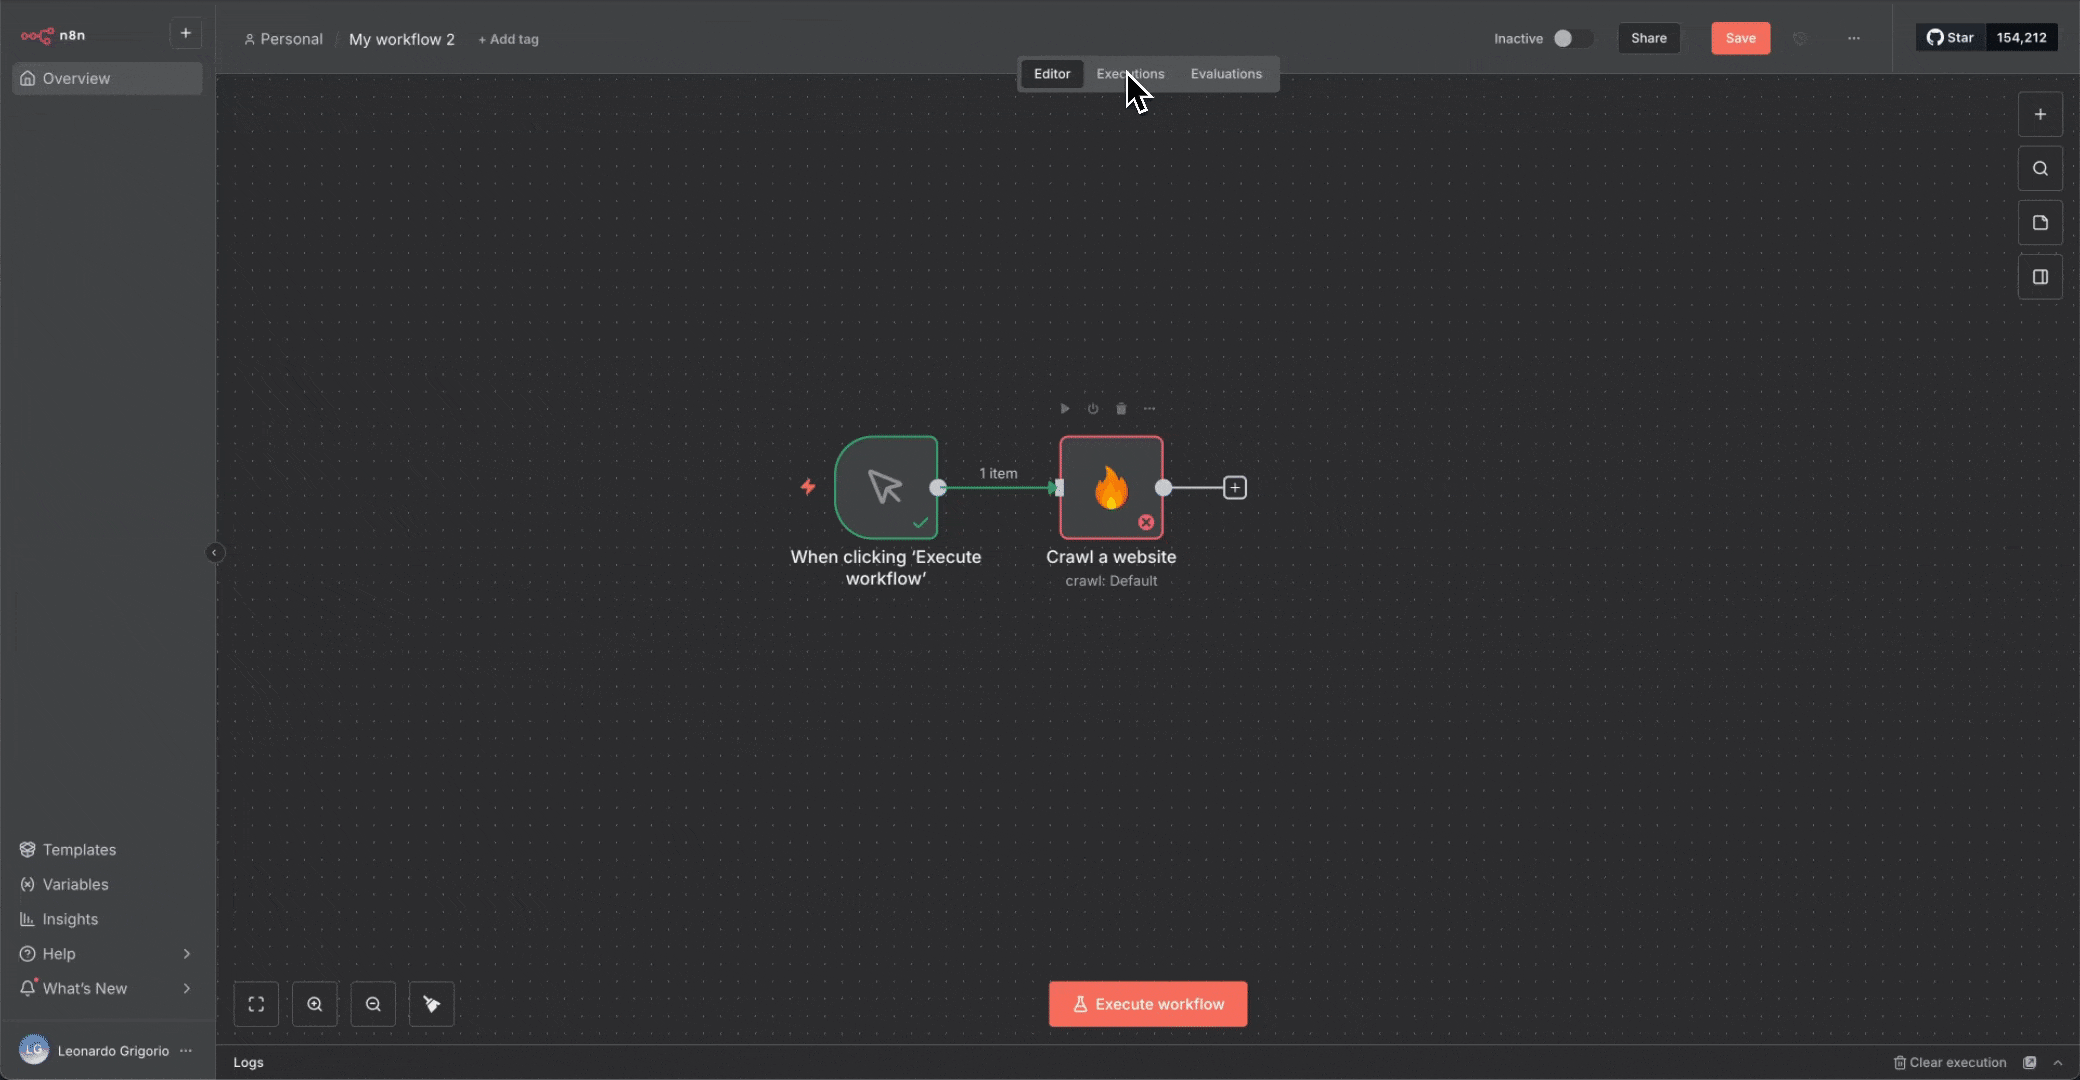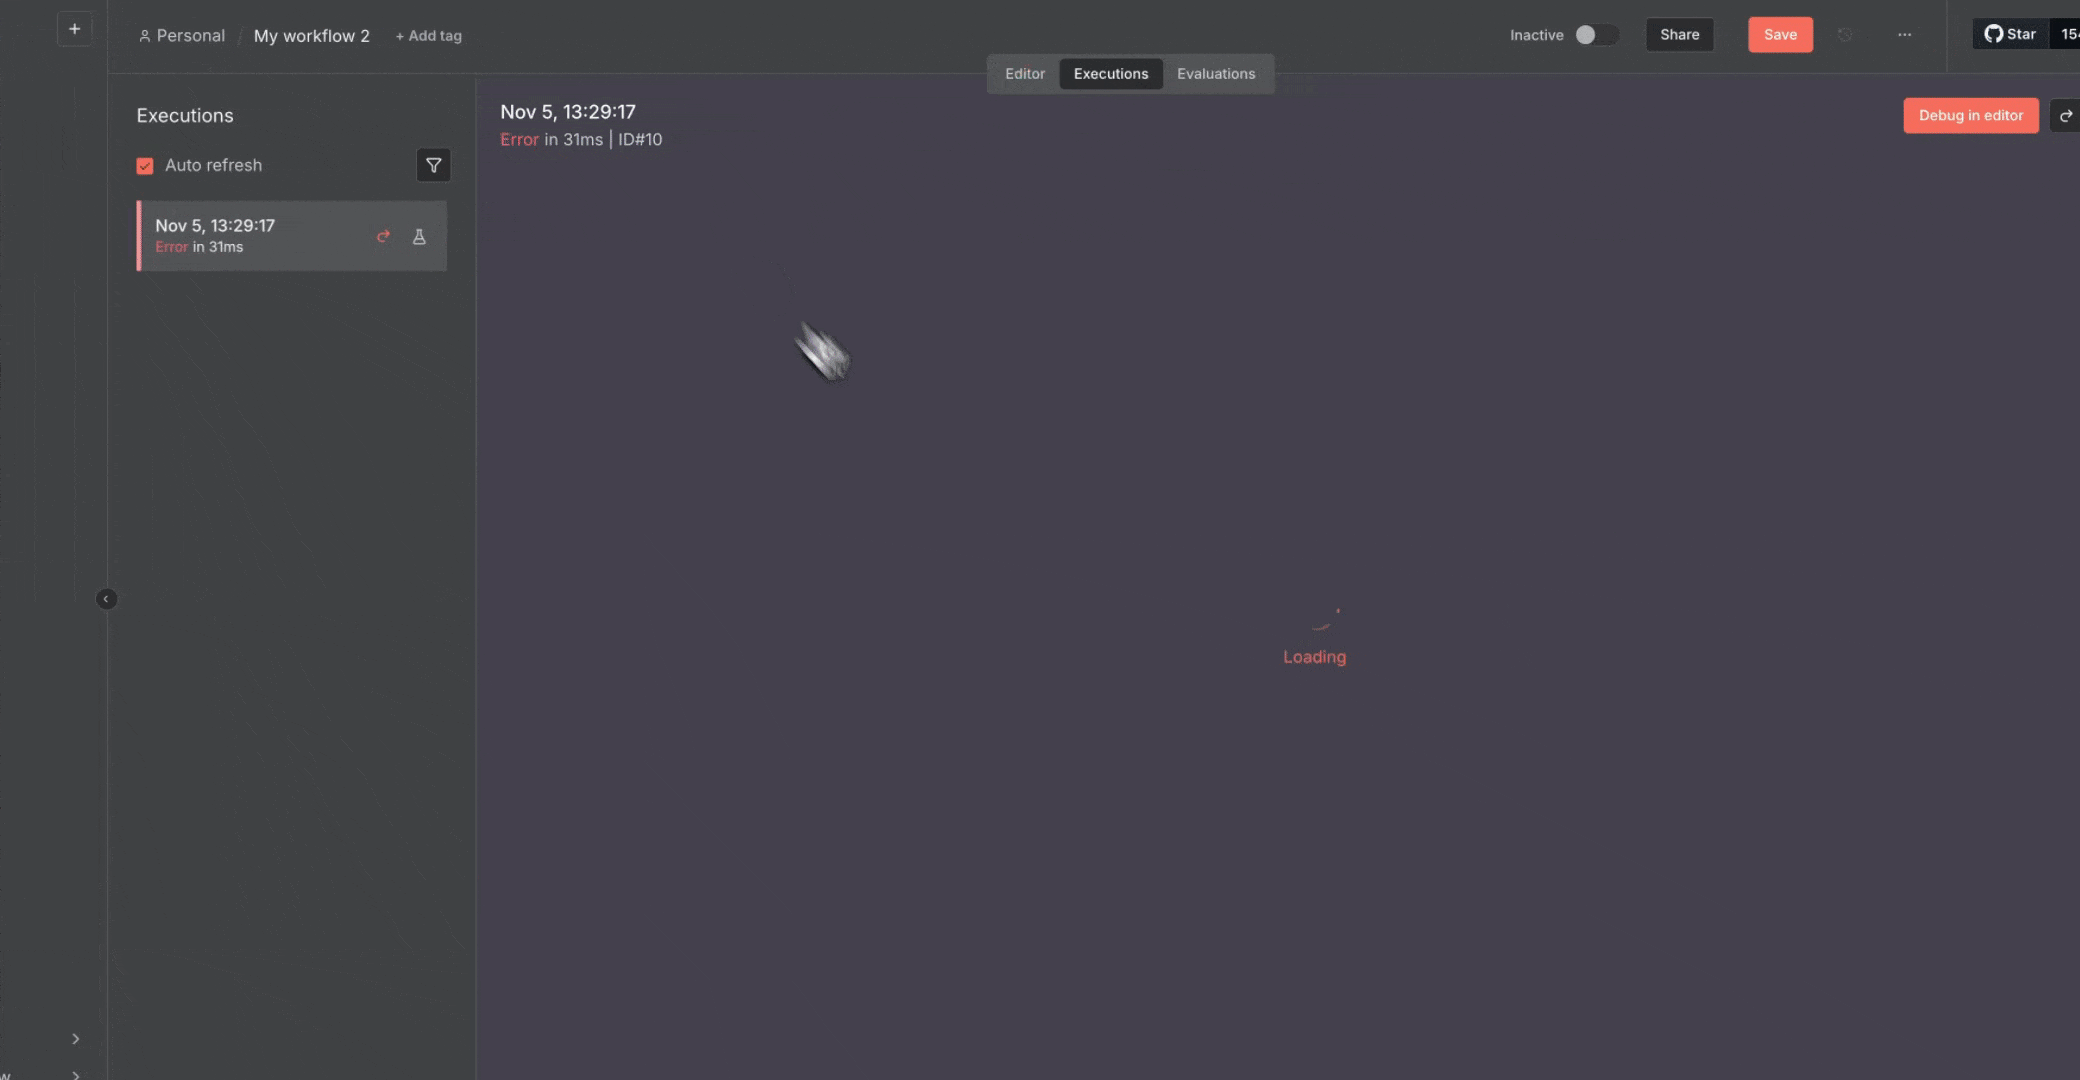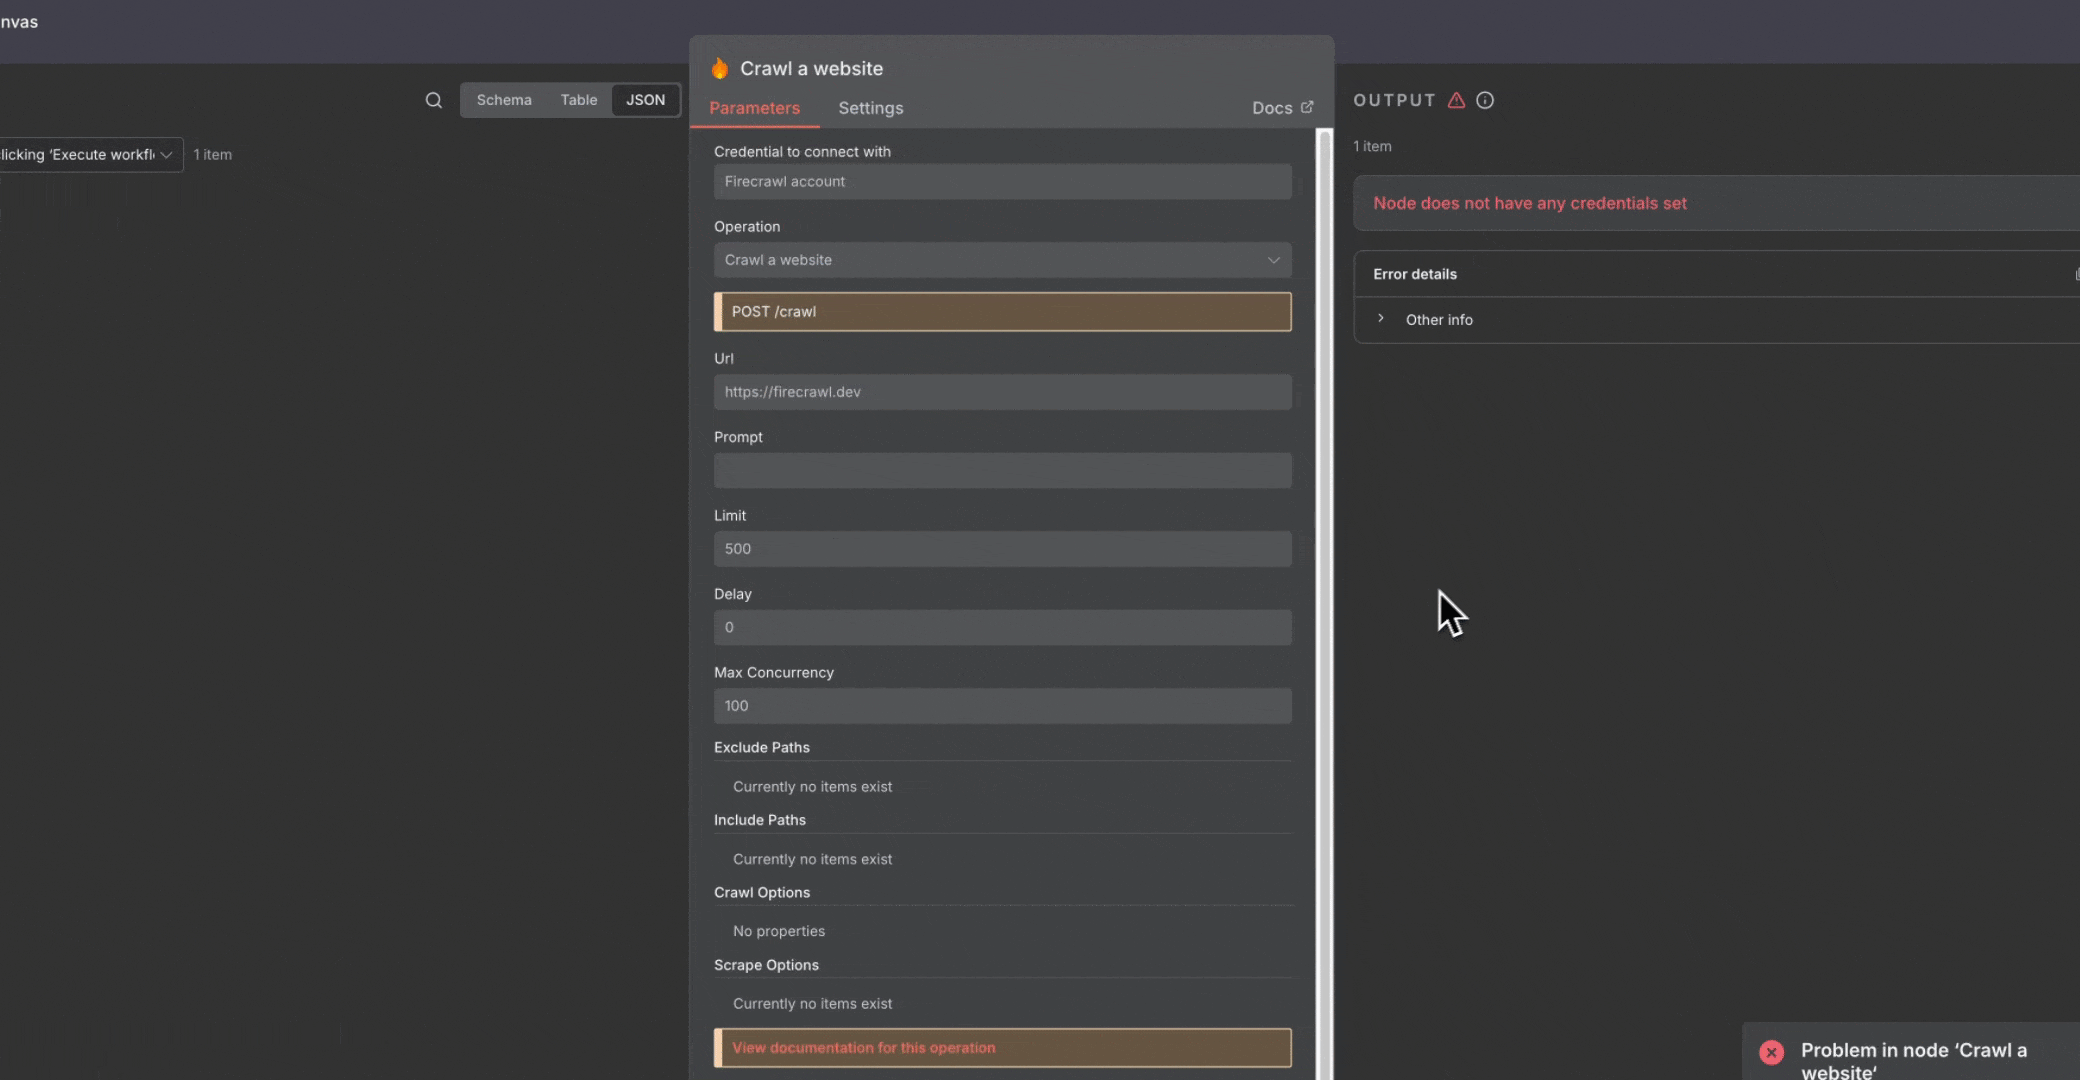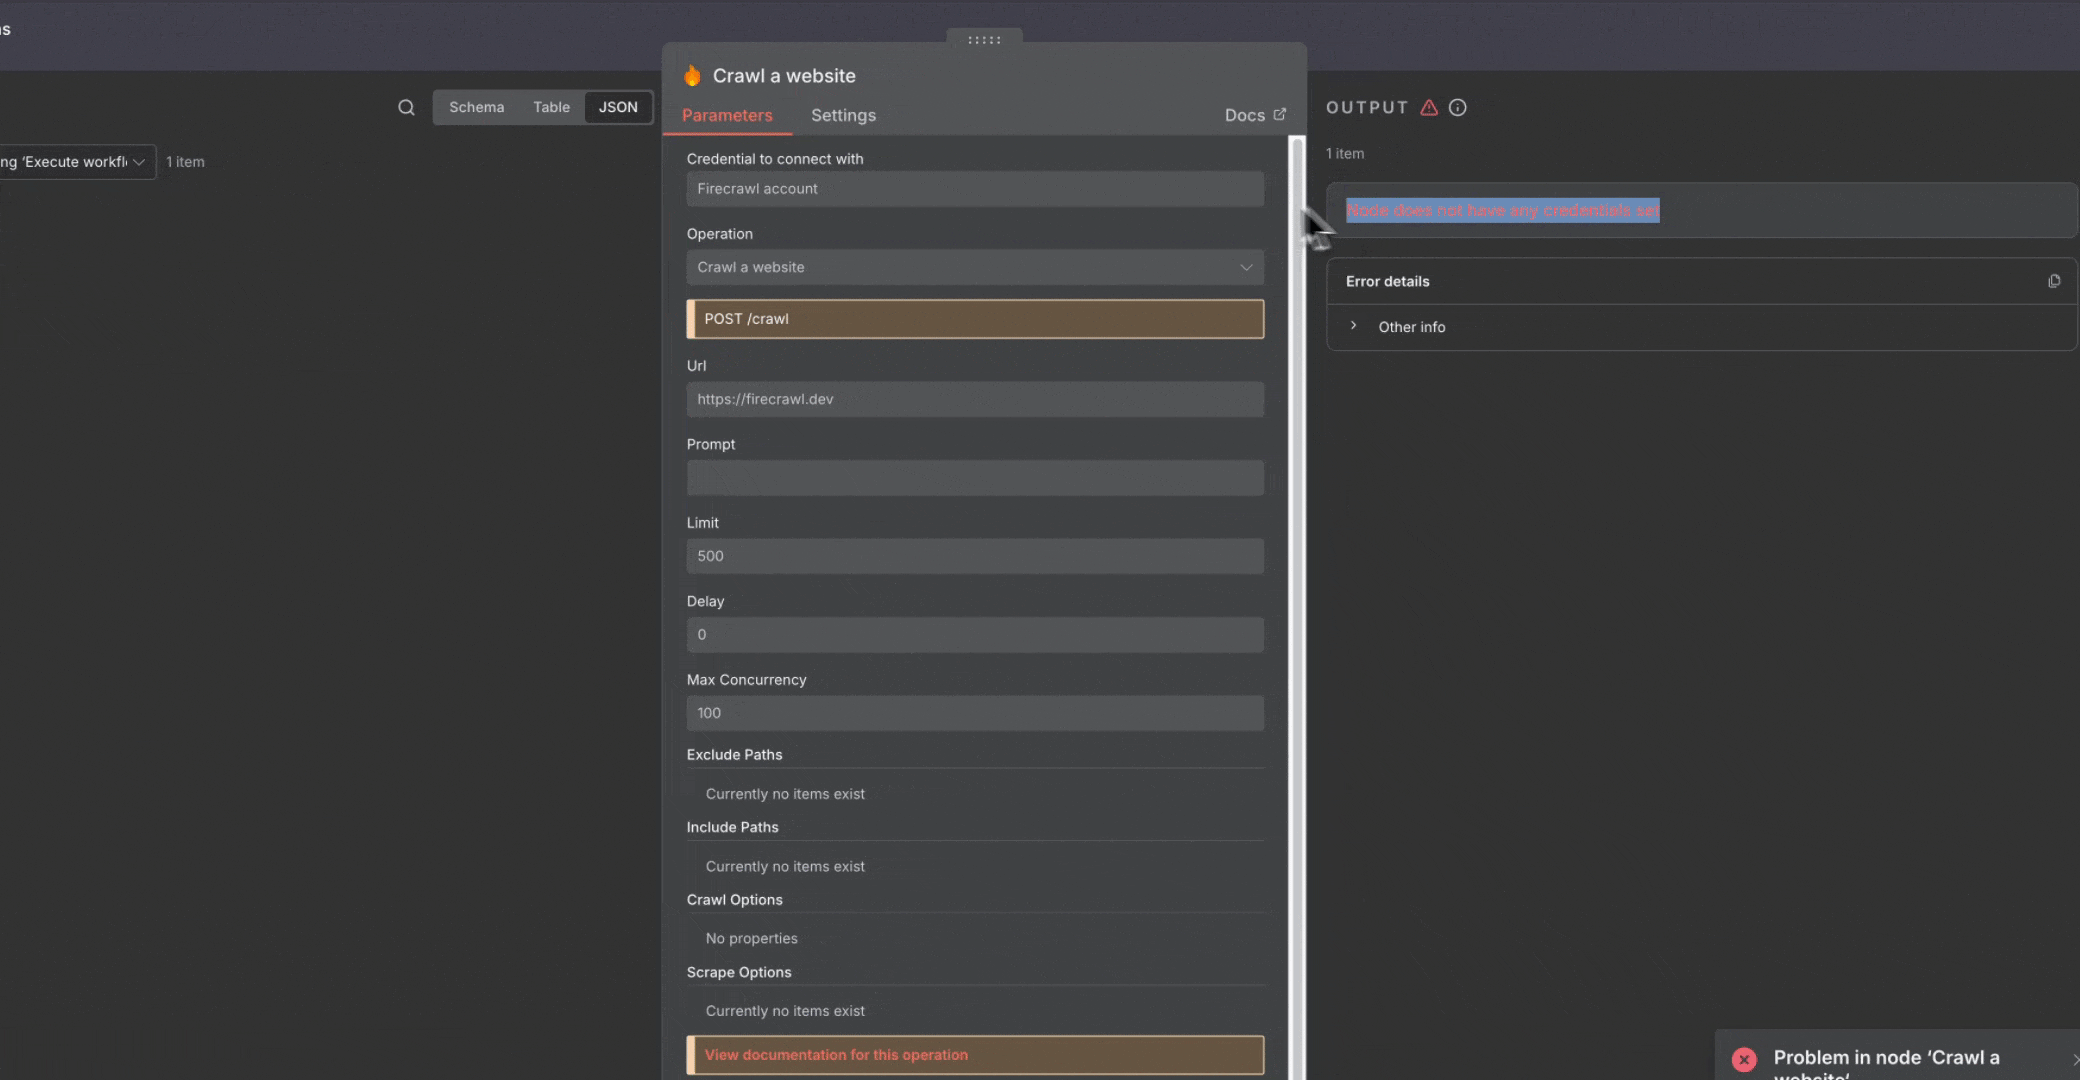
- “Executions” タブで過去の実行を確認し、問題をデバッグします
エラーハンドリング
- Error Triggerノードを追加して、失敗を検知・処理します
- ワークフローの失敗時に通知を設定します
- 重要度の低いノードには「Continue On Fail」設定を使用します
- ワークフローの実行状況を定期的に監視します
パフォーマンスの最適化
- 複数の URL を処理する場合は、ループではなくバッチスクレイプを使用する
- 対象サイトに過度な負荷をかけないよう、適切なレート制限を設定する
- 不要なリクエストを減らすため、可能な場合はデータをキャッシュする
- 負荷の高いワークフローはオフピークの時間帯にスケジュールする
セキュリティ
- ワークフローの構成にAPIキーを含めないでください
- n8nの認証情報システムを使用して認証情報を安全に保存してください
- ワークフローを公開する際は注意してください
- 対象のWebサイトの利用規約およびrobots.txtに従ってください
次のステップ
Firecrawl と n8n を使ったWebスクレイピング自動化の基本を学びました。さらに学習を進めるには、次の方法があります。高度な機能を試す
- リアルタイムのデータ処理に向けたwebhookの構成を確認する
- プロンプトとスキーマを使ったAIによる抽出を試す
- 分岐ロジックを含む複雑なマルチステップワークフローを構築する
コミュニティに参加
- Firecrawl Discord - Firecrawl のサポートを受けたり、Web スクレイピングについて話し合ったりできます
- n8n Community Forum - ワークフローの自動化について質問する
- ワークフローを共有し、他のユーザーの知見を学ぶ
推奨される学習パス
- このガイドのワークフロー例を実践する
- コミュニティライブラリのテンプレートをカスタマイズする
- 実際の業務課題を解決するワークフローを構築する
- Firecrawl の高度なオペレーションを試す
- 他のユーザーの役に立つ独自のテンプレートを提供する
お困りですか? 行き詰まったり質問があったりする場合は、Firecrawl と n8n のコミュニティが活発で頼りになります。自動化を構築する際は、遠慮なくアドバイスを求めてください。