

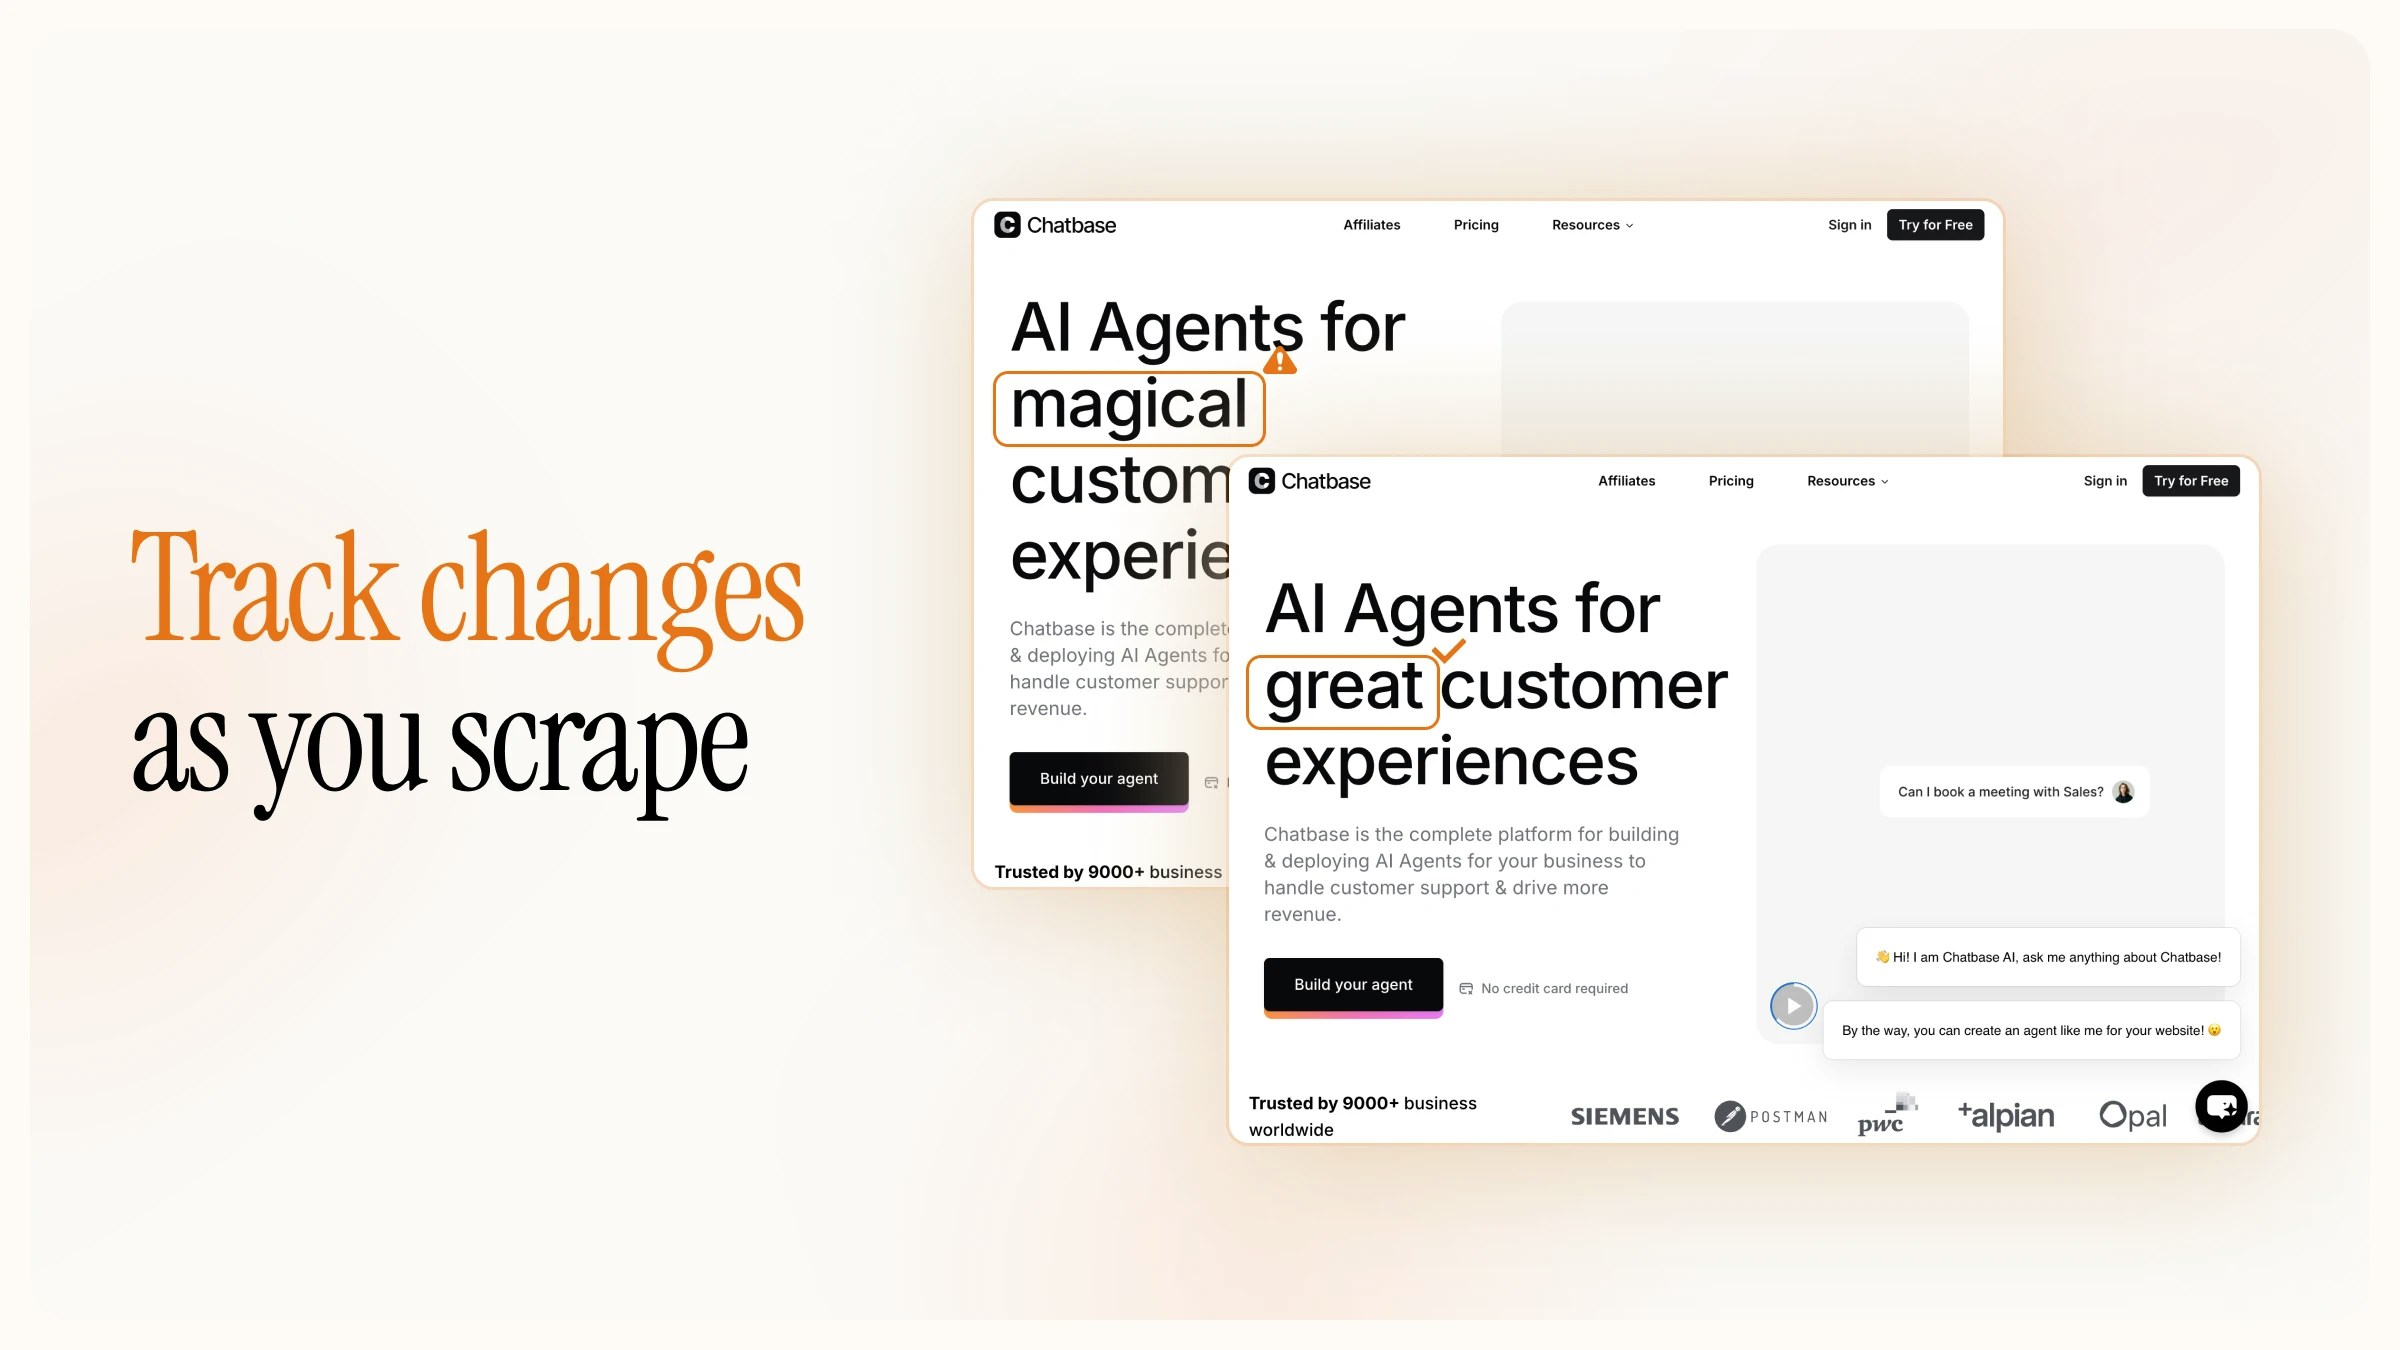
changeTracking a tu array de formats para detectar si una página es nueva, no ha cambiado o se ha modificado y, opcionalmente, obtener un diff estructurado de lo que cambió.
- Funciona con
/scrape,/crawly/batch/scrape - Dos modos de diff:
git-diffpara cambios a nivel de línea yjsonpara comparación a nivel de campo - Acotado a tu equipo y, opcionalmente, a una etiqueta que especifiques
/scrape por tu cuenta con un temporizador.
Cómo funciona
Cada extracción conchangeTracking habilitado almacena una captura y la compara con la captura anterior para esa URL. Las capturas se almacenan de forma persistente y no caducan, por lo que las comparaciones se mantienen precisas sin importar cuánto tiempo haya pasado entre extracciones.
La respuesta incluye estos campos en el objeto
changeTracking:
Uso básico
Incluye tantomarkdown como changeTracking en el array formats. El formato markdown es obligatorio porque el seguimiento de cambios compara las páginas según su contenido en markdown.
Respuesta
En el primer scraping,changeStatus es "new" y previousScrapeAt es null:
changeStatus indica si el contenido ha cambiado:
Modo git-diff
El modogit-diff retorna cambios línea por línea en un formato similar a git diff. Pasa un objeto dentro del array formats con modes: ["git-diff"]:
Respuesta
El objetodiff contiene tanto un diff en texto plano como una representación JSON estructurada:
diff.json contiene:
files: matriz de archivos modificados (generalmente uno por página web)chunks: secciones de cambios dentro de un archivochanges: cambios de líneas individuales contype("add","del"o"normal"), número de línea (ln) ycontent
Modo JSON
El modojson extrae campos específicos tanto de la versión actual como de la versión anterior de la página usando un esquema que defines. Esto es útil para hacer un seguimiento de cambios en datos estructurados como precios, niveles de stock o metadatos sin tener que analizar un diff completo.
Pasa modes: ["json"] con un schema que defina los campos a extraer:
Respuesta
Cada campo del esquema se devuelve con valoresprevious y current:
prompt opcional para guiar la extracción mediante el LLM junto con el esquema.
El modo JSON usa extracción con LLM y cuesta 5 créditos por página. El seguimiento básico de cambios y el modo
git-diff no tienen costo adicional.Uso de etiquetas
De forma predeterminada, el seguimiento de cambios se compara con el scrape más reciente de la misma URL realizado por tu equipo. Las etiquetas te permiten mantener historiales de seguimiento independientes para la misma URL, lo cual es útil cuando supervisas la misma página en diferentes intervalos o en distintos contextos.Rastreo con seguimiento de cambios
Añade seguimiento de cambios a las operaciones de rastreo para supervisar un sitio completo en busca de cambios. Pasa el formatochangeTracking dentro de scrapeOptions:
Extracción por lotes con seguimiento de cambios
Usa batch scrape para supervisar un conjunto específico de URL:Programar el seguimiento de cambios
Tarea cron
Crea un script que haga scraping de una URL y notifique cuando haya cambios:check-pricing.sh
crontab -e:
Planificadores en la nube y sin servidor
- AWS: regla de EventBridge que invoca una función Lambda
- GCP: Cloud Scheduler que invoca una Cloud Function
- Vercel / Netlify: funciones serverless activadas mediante cron
- GitHub Actions: flujos de trabajo programados con los desencadenadores
scheduleycron
Automatización de flujos de trabajo
Plataformas sin código como n8n, Zapier y Make pueden llamar periódicamente a la API de Firecrawl y enrutar los resultados a Slack, correo electrónico o bases de datos. Consulta las guías sobre automatización de flujos de trabajo.Webhooks
Para operaciones asíncronas comocrawl y batch scrape, usa webhooks para recibir resultados de seguimiento de cambios a medida que llegan en lugar de hacer polling.
crawl.page incluye el objeto changeTracking para cada página:
Referencia de configuración
changeTracking:
Modelos de datos
Detalles importantes
- Retención de snapshots: Los snapshots se almacenan de forma persistente y no caducan. Una extracción realizada meses después de la anterior seguirá comparándose correctamente con el snapshot anterior.
- Alcance: Las comparaciones se limitan a tu equipo. La primera extracción de cualquier URL devuelve
"new", incluso si otros usuarios ya la han extraído. - Coincidencia de URL: Las extracciones anteriores se asocian por la URL de origen exacta, el ID de equipo, el formato
markdowny latag. Mantén las URLs consistentes entre extracciones. - Consistencia de parámetros: Usar configuraciones diferentes de
includeTags,excludeTagsuonlyMainContenten extracciones de la misma URL produce comparaciones poco fiables. - Algoritmo de comparación: El algoritmo es resistente a cambios en espacios en blanco y en el orden del contenido. Se ignoran las URLs de origen de iframes para manejar la aleatorización de captcha/antibot.
- Caché: Las solicitudes con
changeTrackingomiten la caché del índice. Se ignora el parámetromaxAge. - Manejo de errores: Supervisa el campo
warningen las respuestas y contempla el caso en que el objetochangeTrackingpueda estar ausente (esto puede ocurrir si la consulta a la base de datos para la extracción previa excede el tiempo de espera).
Facturación
¿Eres un agente de IA que necesita una clave de API de Firecrawl? Consulta firecrawl.dev/agent-onboarding/SKILL.md para ver las instrucciones de onboarding automatizado.